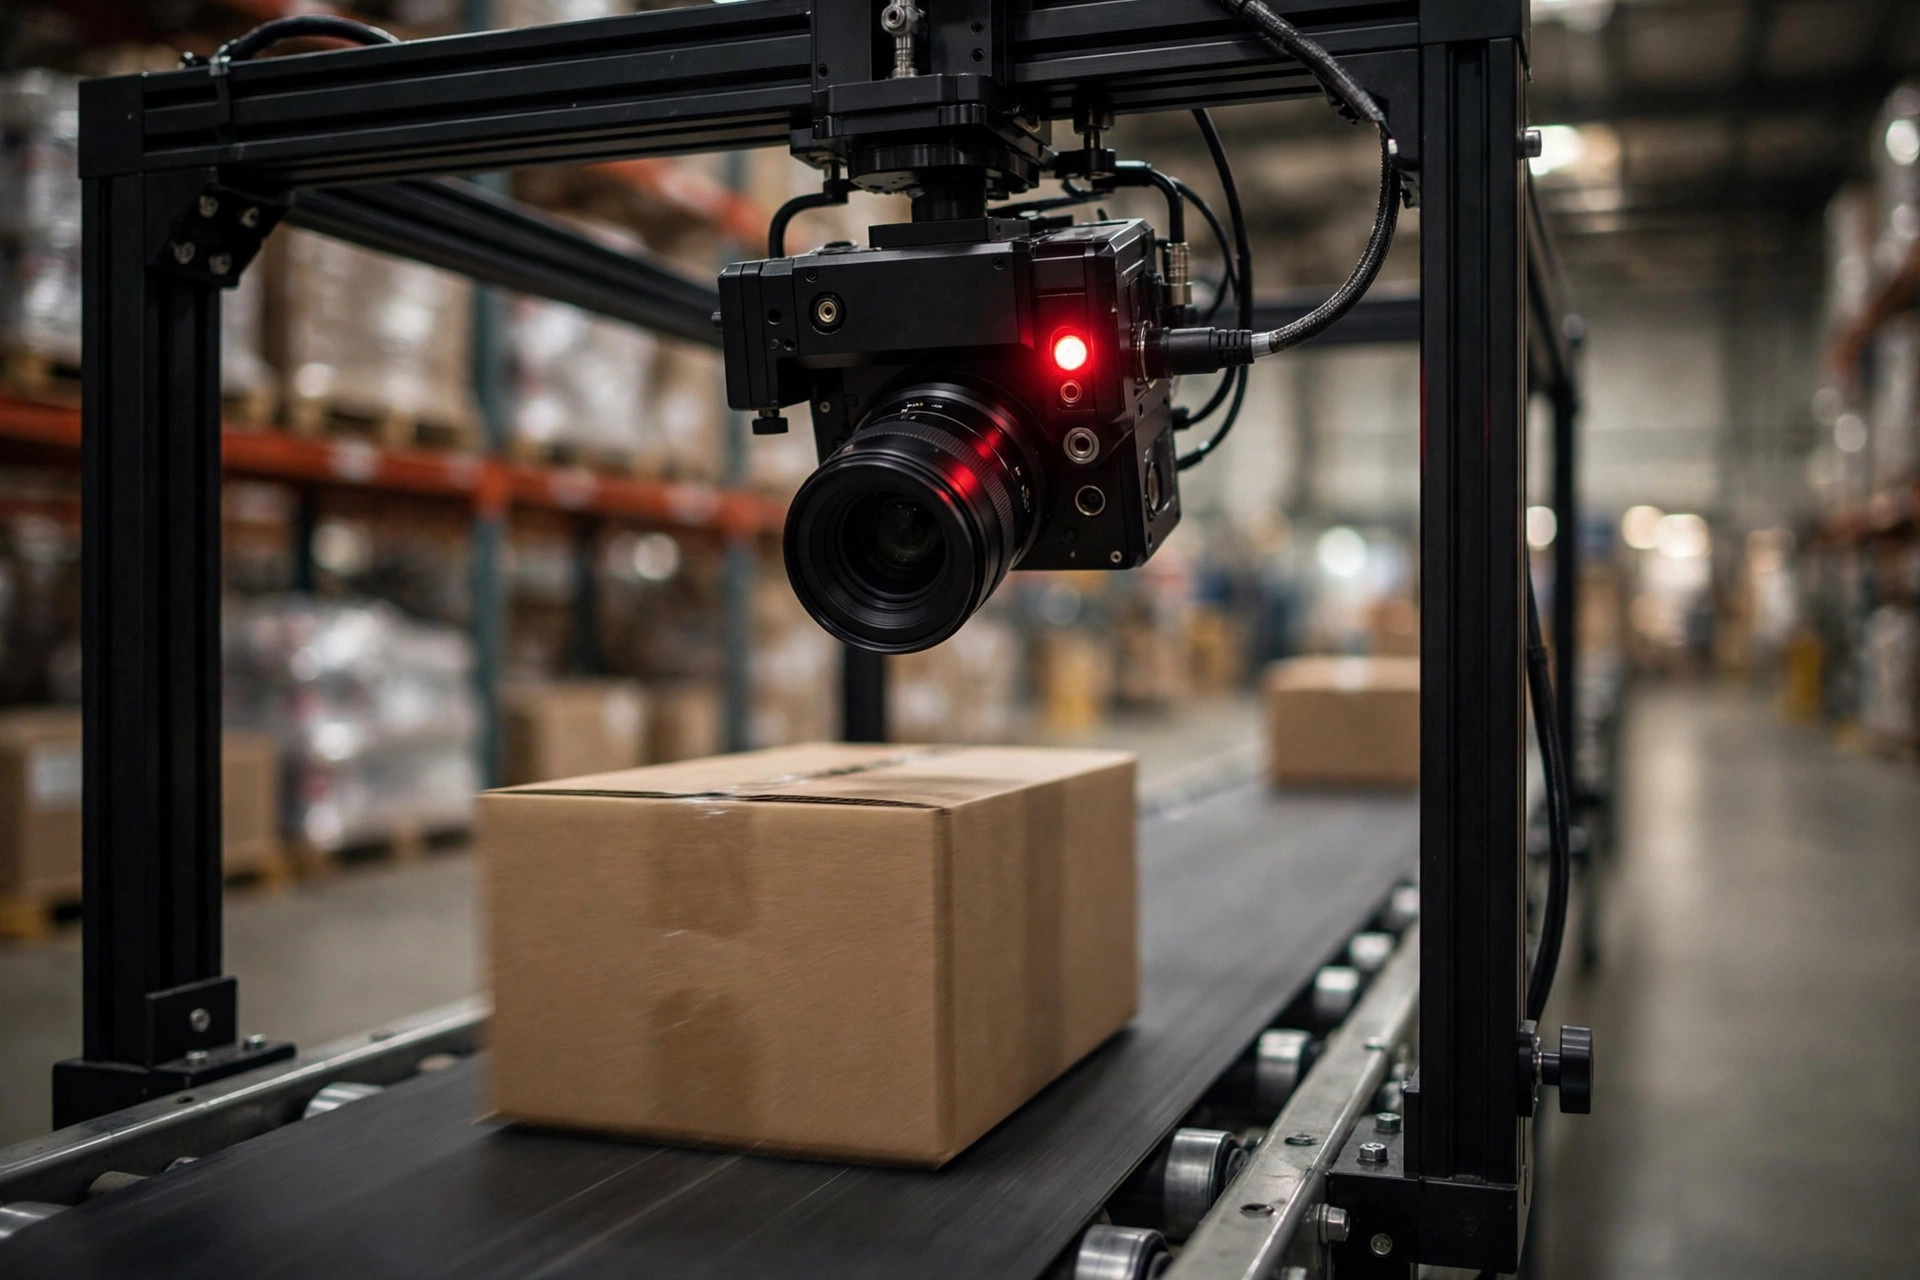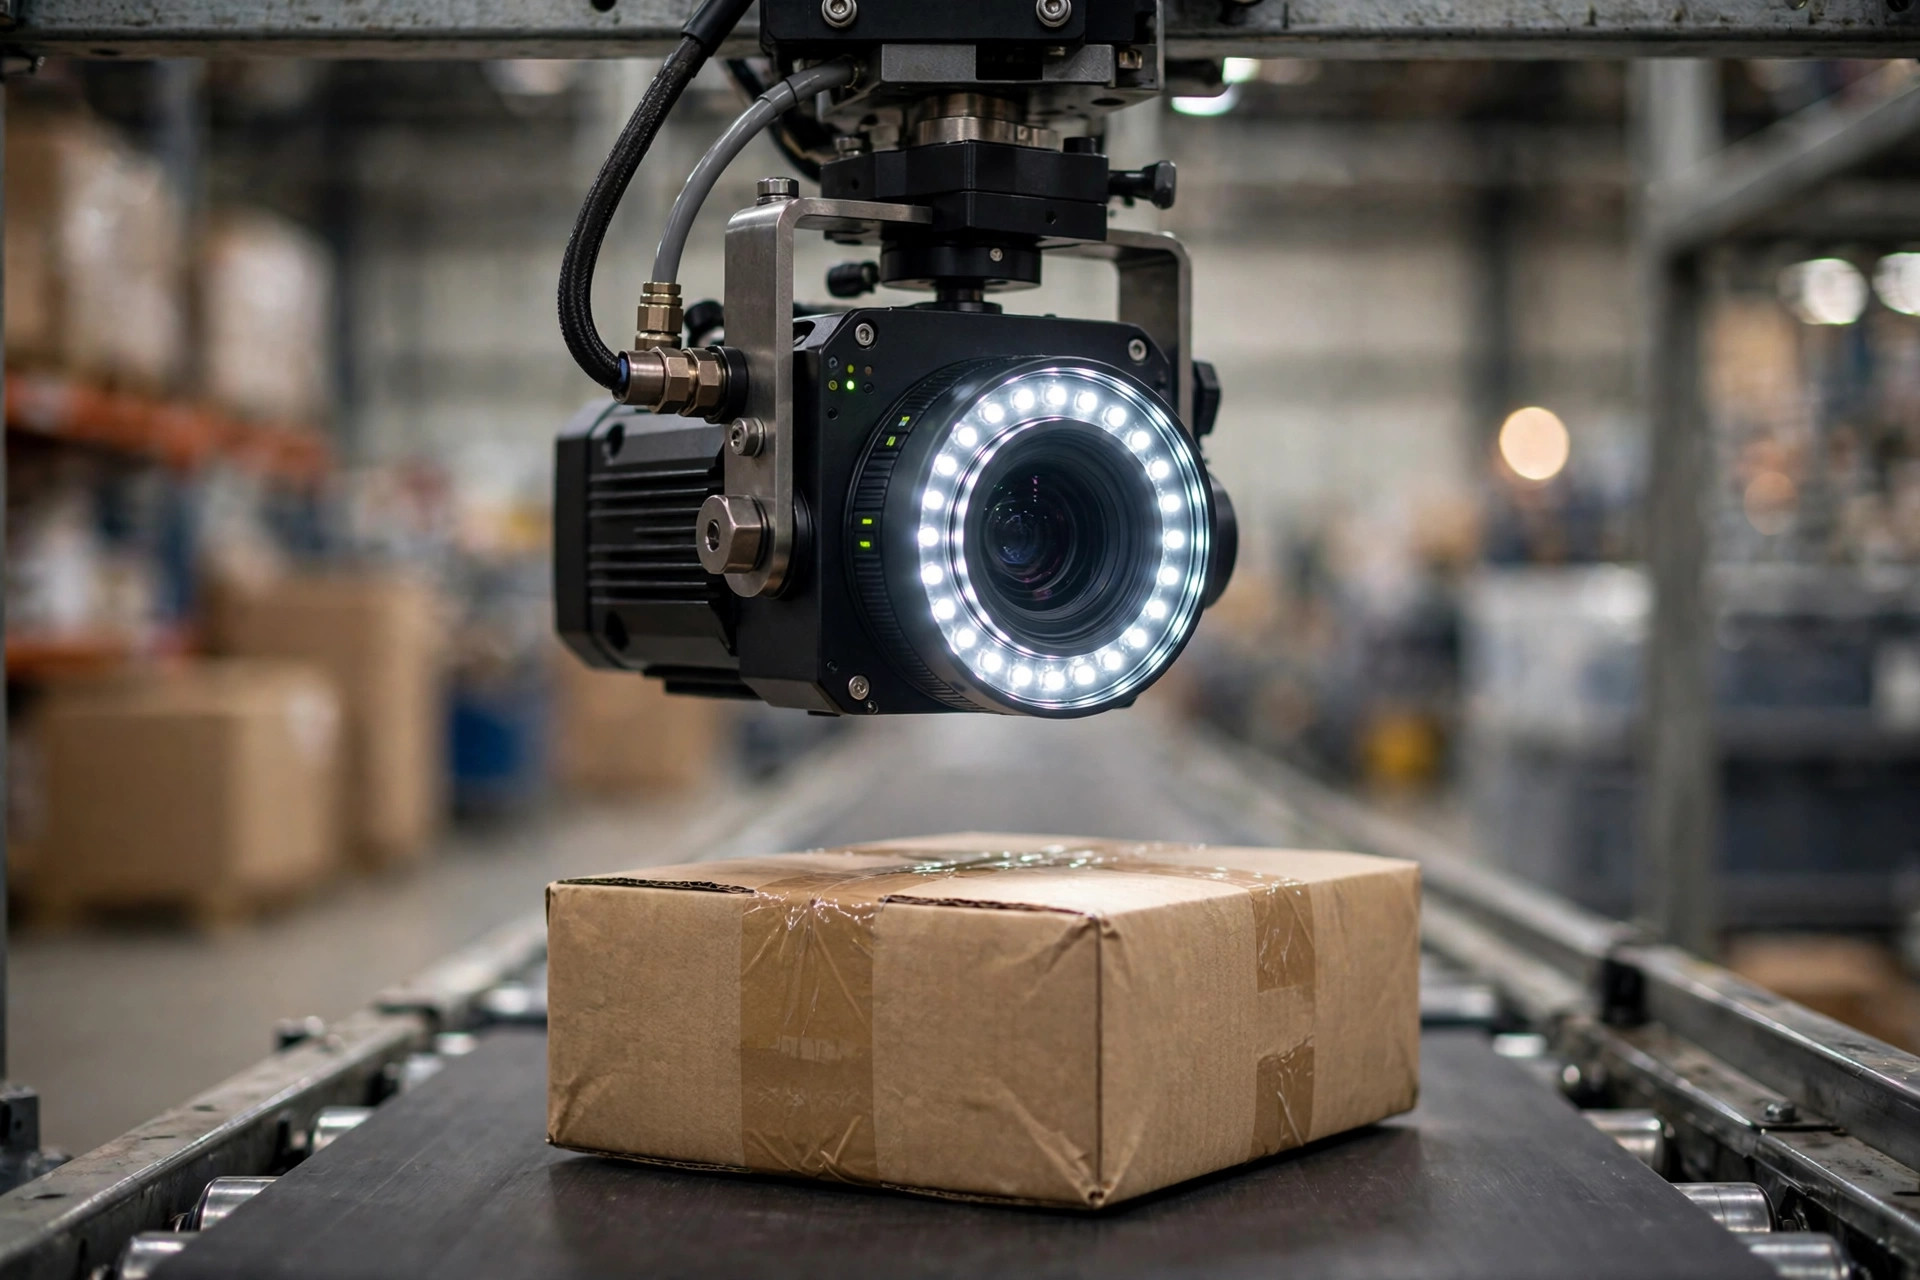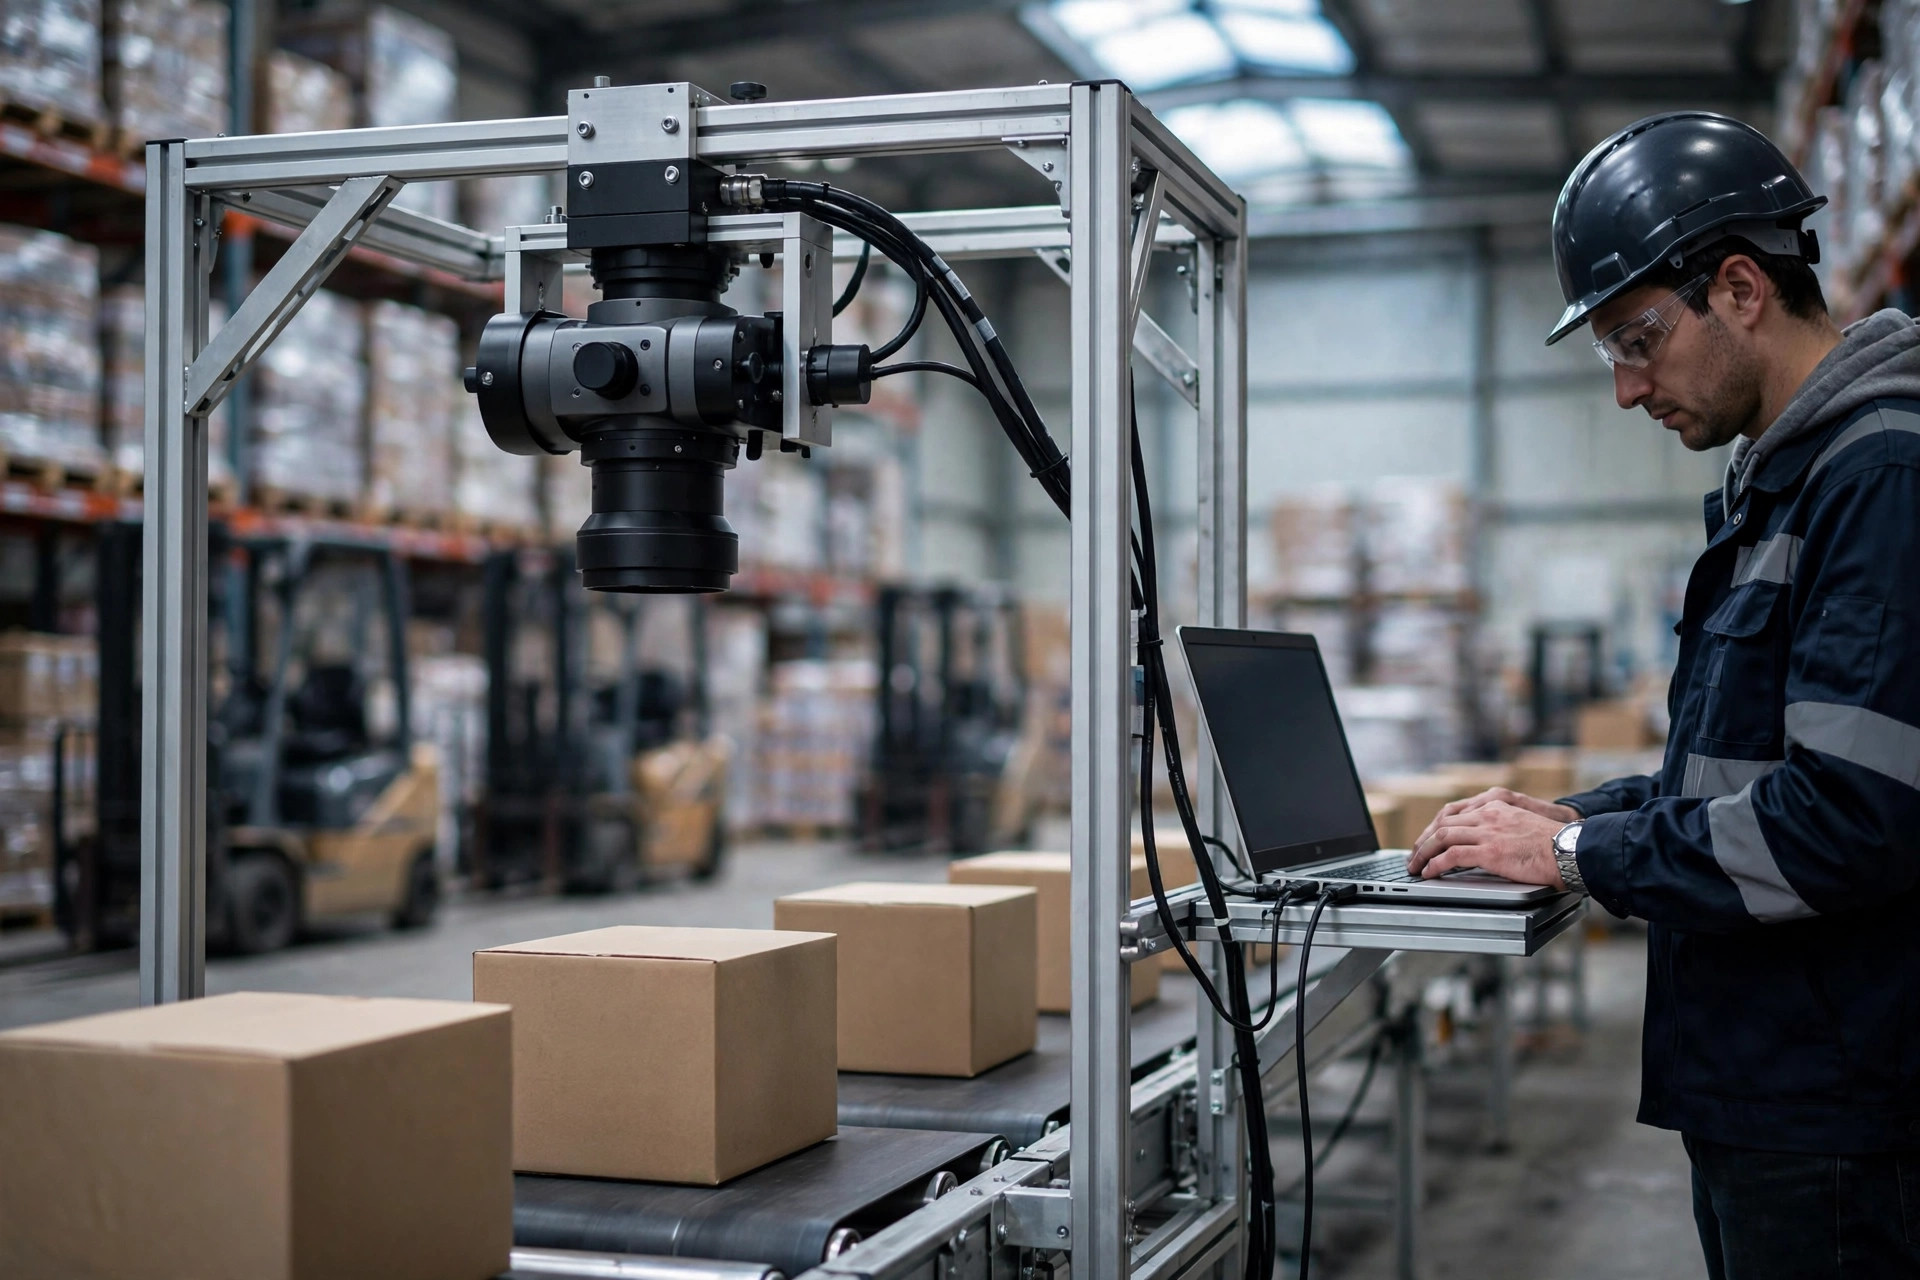
En 2023 trabajé con un almacén de devoluciones que quería un sistema de visión en su línea de auditoría para detectar cajas dañadas. Las cuentas eran simples: una caja dañada enviada a un cliente significaba una reclamación más el flete de devolución — suficiente para pagar varias cámaras industriales. El proyecto pasó todas las revisiones y luego se atascó en algo que nadie había previsto. Ni el algoritmo. Ni las especificaciones de las cámaras. No podíamos reunir los datos de entrenamiento.
Después de meses de espera, teníamos unas pocas docenas de fotos reales de cajas dañadas. Peor aún: eran casi idénticas — la misma esquina aplastada, las mismas dos cintas transportadoras, las mismas luces del techo. Entrenamos el modelo de todos modos. En su primera semana en producción, marcó cajas en perfecto estado como dañadas, y las falsas alarmas se acumularon hasta que los operarios desactivaron las alertas. Ese proyecto me enseñó una regla que sigo usando: el primer día de cualquier proyecto de visión, pregunta de dónde vienen los datos antes de elegir la cámara.
Por qué el defecto se niega a ser fotografiado
Empecemos por la verdad incómoda. Daños, fugas, cajas mal etiquetadas, cinta despegada — estos son eventos raros por diseño en cualquier almacén bien gestionado. Una línea de auditoría de alto volumen mueve decenas de miles de unidades al día mientras mantiene su tasa de daños en fracciones bajas de un porcentaje. Reunir unos miles de fotos de "dañadas" significa acampar junto a la cinta durante meses, y no puedes cambiar de estación, reiluminar el techo ni cambiar de proveedor de cajas a mitad de la recolección sin alterar tu distribución de datos.
Incluso cuando por fin consigues las fotos, el etiquetado es un pozo sin fondo. El daño no tiene verdad objetiva: ¿cuánto tiene que estar aplastada una esquina para que cuente? ¿La cinta despegada dos milímetros clasifica una caja? Tres etiquetadores anotarán la misma imagen de tres maneras distintas. Y luego está el asesino silencioso de la captura real: la cobertura de escena. Iluminación, ángulo de cámara, velocidad de la cinta, antigüedad de la caja — las combinaciones son infinitas. Tus fotos siempre describirán "esta estación, el trimestre pasado", y el modelo sentirá nostalgia en cuanto entre en producción.
Para cuando tu conjunto de datos real por fin es lo bastante grande, la ventana del proyecto suele haberse cerrado. Ese es el círculo mortal de la visión en almacenes: los lugares que más necesitan el modelo son exactamente los que no pueden producir los datos.
Tres formas de fabricar datos
Si los defectos reales no vienen a ti, constrúyelos tú. Tres enfoques funcionan de verdad, y cada uno tiene su propio carácter.
El primero es el renderizado de simulación 3D. Modela una caja en 3D, programa la profundidad de la abolladura, la ubicación de los desgarros y los patrones de manchas, y luego aleatoriza a voluntad la posición de la cámara, la iluminación y el fondo. Cada imagen renderizada trae anotaciones gratis — el renderizador ve la escena desde una vista de dios, así que las cajas delimitadoras (bounding boxes), las máscaras de segmentación y los mapas de profundidad salen directos del grafo de escena con cero coste de etiquetado. Las herramientas están maduras: BlenderProc, de código abierto por Denninger y colegas del Centro Aeroespacial Alemán DLR en 2019 (arXiv:1911.01911), construido sobre la idea de que el renderizado fotorrealista reduce la brecha sim-to-real; Omniverse Replicator de NVIDIA, cuyo propósito declarado es generar datos sintéticos etiquetados a escala para inspección visual y robótica; y el paquete Perception de Unity, diseñado específicamente para producir conjuntos de datos sintéticos con anotaciones de verdad objetiva.
El segundo enfoque es la aleatorización de dominio, y su lógica va al revés: no persigas el realismo, persigue el caos. El artículo fundacional de Tobin y colegas en 2017 (arXiv:1703.06907) aleatorizó texturas, iluminación y posiciones de cámara con tanta agresividad que el mundo real empezó a parecer solo una variación aleatoria más. Su modelo localizó objetos en escenas reales con precisión de 1.5 centímetros. Mi opinión de campo: las escenas de cintas con fondos fijos son ideales para este truco, porque no necesitas que la simulación parezca real — necesitas que parezca variada.
La tercera ruta son los modelos generativos. Alimenta tus pocas docenas de fotos reales de daños a un GAN o un modelo de difusión y deja que sueñe más variantes. Esta me genera escepticismo. Los modelos generativos alucinan con total confianza, inventando patrones de daño que violan la física. Un modelo entrenado con esas fantasías aprende rasgos falsos y falla en producción de todos modos. Mi veredicto: los modelos generativos están bien como aliado de aumento de datos — cambios de brillo, sustitución de fondos — pero no les pidas que inventen nuevas categorías de defectos de la nada.
La simulación no es una bala de plata
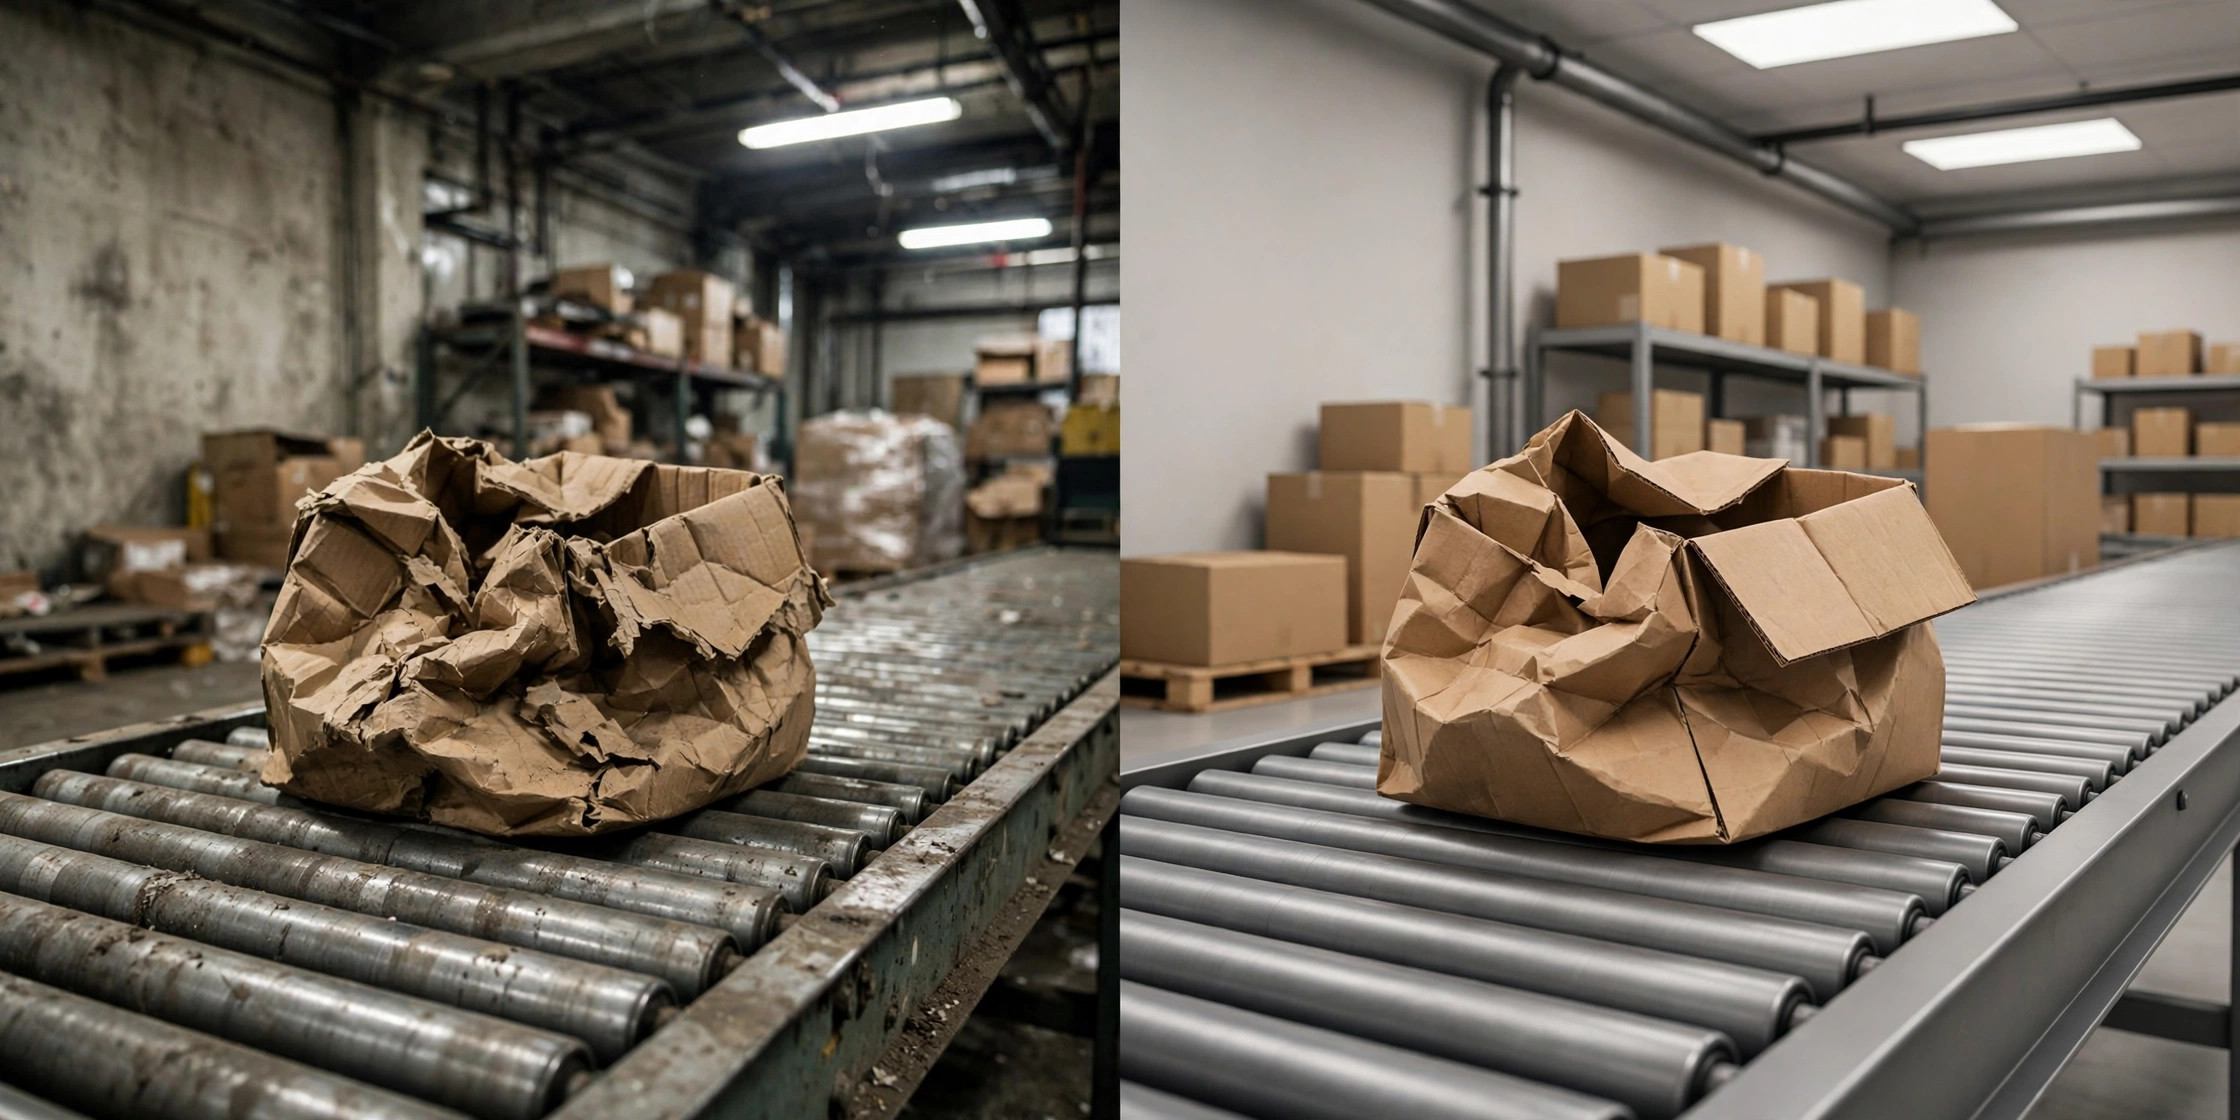
Mira la imagen de arriba: una caja dañada real fotografiada en un almacén, junto a su gemela renderizada en 3D. Si tus ojos detectan la diferencia, el modelo la siente diez veces más.
La brecha sim-to-real es real. Por convincente que sea la iluminación renderizada, las simulaciones suelen omitir el ruido del sensor, la distorsión de la lente y el desenfoque de movimiento de una cinta a toda velocidad. La trampa más sutil: los defectos sintéticos tienden a verse demasiado limpios, demasiado de libro, mientras que el daño real es sucio, aleatorio e irracional. Una frontera de decisión aprendida con datos limpios colapsa en cuanto toca el barro del mundo real.
La solución es una palabra: híbrido. Entrena con datos sintéticos para la cobertura, para que el modelo haya visto suficientes formas de defecto; calibra con datos reales, para que la frontera de decisión vuelva a la realidad. Después, cierra el ciclo: sigue alimentando el conjunto de entrenamiento con los falsos positivos y las omisiones de producción. Los datos sintéticos te llevan de cero a uno; los datos reales te llevan de "funciona" a "funciona bien". Ninguno sustituye al otro.
Cuándo saltarse los datos sintéticos
Los datos sintéticos son potentes, pero algunos trabajos son más rápidos con una simple cámara.
Sáltate la simulación cuando el defecto sea fácil de escenificar. Las cajas mal etiquetadas, por ejemplo: imprime un lote de etiquetas, pégalas, y puedes disparar cientos de fotos en una tarde con el ángulo y la iluminación que quieras. Las horas que un artista 3D dedica a construir la escena cubrirían tres sesiones de rodaje completas.
Sáltatela cuando nadie en el equipo hable el idioma del pipeline 3D. Modelado, materiales, iluminación, pipeline de renderizado — cada uno es un oficio en sí mismo. Las cotizaciones de modelado externo suelen superar el coste de disparar más etiquetar, y tras dos o tres rondas de revisiones el proyecto está muerto.
Por último, haz las cuentas de coste. La captura real es coste lineal: una foto más, una anotación más, un dólar más. La simulación es coste fijo: la parte cara es construir la escena, y después cada imagen adicional cuesta casi nada. La regla de decisión es clara: cuanto mayor sea el volumen que necesites y más raro el defecto, más ganan los datos sintéticos. Volumen pequeño, fácil de escenificar — coge la cámara y dispara.
Tu lista de verificación para mañana por la mañana
Si vas a arrancar un proyecto de visión en almacenes mañana, haz esto en orden y no te saltes pasos:
- Cuenta tus muestras primero. Enumera cada clase de defecto que necesitas detectar y cuenta las fotos reales que tienes de cada una. Toda clase que no llene un conjunto de validación va directa a la columna de "debe usar datos sintéticos".
- Monta la cámara primero. Instálala en la posición final de despliegue y déjala funcionando una semana. Guarda ese flujo de datos reales ahora — es el capital que gastarás en la calibración después.
- Prueba las herramientas primero. Consigue un equipo con GPU, ejecuta el ejemplo oficial de BlenderProc de principio a fin y renderiza tu primer lote de imágenes autoanotadas. Si no consigues que eso funcione, no estás listo para construir tu propio pipeline de simulación.
- Haz una comparativa primero. Entrena un modelo pequeño con datos sintéticos para preentrenar más datos reales para afinar, y otro solo con datos reales. Compara las tasas de falsos positivos y omisiones, y deja que los números decidan.
- Habla de escala al final. Si los datos sintéticos ganan la comparativa, invierte en la escena de simulación completa. Si pierden, vuelve a disparar y no pelees con las herramientas.
Mi veredicto es directo: los datos sintéticos no son una bala de plata, pero son la palanca más infravalorada de la visión en almacenes. Bien usados, comprimen el "esperar los datos" de meses a semanas. Mal usados, son un juguete caro. Lo que separa ambos casos nunca es la fe en la tecnología — es la comparativa sentada en tu escritorio.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.