Un sistema de optimización de rutas de picking que promete recortar la distancia caminada en una quinta parte entra en producción, y tres meses después los pickers siguen caminando sus rutas de siempre. Esto no es un problema de personas. Es una brecha entre dos definiciones distintas de "óptimo" — la del algoritmo y la de la planta — y la tecnología, madura como ya es, nunca ha sido la parte que se atasca. La parte que se atasca es la adopción.
Consideremos primero el fenómeno. En 2024, un almacén de comercio electrónico de 30,000 metros cuadrados en el este de China implantó un sistema de optimización de rutas de picking con IA que calculaba las secuencias de picking en tiempo real según el perfil de los pedidos, con una reducción teórica del 15–20% en la distancia caminada por picker. Los números del panel en el primer mes se veían preciosos. El supervisor de planta, sin embargo, notó algo más: los pickers incumplían en silencio — asentían ante el sistema mientras sus pies seguían las rutas de siempre. Tres meses después, una encuesta anónima reveló que más de la mitad admitía desviarse "a menudo" de la secuencia recomendada.
El mismo guion se repitió en la primera mitad de 2025, esta vez en un centro de distribución regional de una cadena minorista que probaba el enrutamiento dinámico con IA. El sistema recomendaba un atajo por la zona de staging que eliminaría un largo rodeo. Los pickers lo rechazaron en bloque y caminaron el camino largo. La razón era mundana: la zona de staging estaba perpetuamente abarrotada de mercancía entrante a la espera de ubicación, y un carro simplemente no podía pasar. El algoritmo leía un plano de planta; los pickers leían la realidad.
Los datos sugieren que no es una anécdota aislada. En mi revisión de una docena de proyectos de enrutamiento inteligente reportados públicamente entre 2024–2025, casi todos los casos que divulgaron resultados reales mencionaban alguna versión de "desviación en la ejecución de primera línea". Los reportajes del sector del mismo período siguen citando una cifra muy conocida: el picking suele representar aproximadamente la mitad del costo laboral de un almacén, que es precisamente por qué es el segmento que los proveedores de automatización más quieren conquistar — y el más difícil de conquistar. La oferta tecnológica se acelera: los algoritmos de planificación de rutas, los gemelos digitales y el posicionamiento en interiores han madurado en los últimos años. Pero la curva de adopción del lado de la demanda corre notablemente más plana de lo que sugieren las narrativas de los proveedores.
¿Por qué persiste esta brecha de "preciso pero no usado"? Yo la atribuiría a tres capas de causas, cada una más cercana a la raíz que la anterior.
La primera capa es la desalineación de incentivos, y es la más comúnmente pasada por alto. En muchos almacenes, los pickers cobran a destajo. La función objetivo del picker es unidades preparadas por hora; la función objetivo de la IA es distancia total minimizada. Estos dos objetivos divergen con frecuencia: tomar un circuito algo más largo que permite al picker agarrar dos artículos extra en una pasada y ahorrarse una curva es mejor negocio para el picker, aunque el sistema lo registre como una desviación. Cuando el algoritmo y el humano optimizan contra KPIs distintos, ignorar al algoritmo es un comportamiento racional, no pereza.
La segunda capa es el déficit de confianza. El algoritmo no puede ver las condiciones transitorias de la planta: dónde están apiladas las cabeceras promocionales de hoy, qué pasillo está resbaladizo y conviene evitar, qué puerta de muelle está bloqueada por mercancía a la espera de ubicación. Nada de eso vive en el sistema; todo eso vive en la cabeza de los pickers. Basta un "seguí al sistema y me topé con un callejón sin salida" para resquebrajar la confianza — y la confianza, una vez resquebrajada, tarda docenas de éxitos en reconstruirse. Las autopsias de implantaciones fallidas siguen convergiendo en el mismo detalle faltante: el sistema no daba a los pickers ningún canal para reportar excepciones de campo. Cuando una ruta es intransitable, la opción es forzar el paso o desviarse en silencio, y con el tiempo, todos se desvían en silencio.
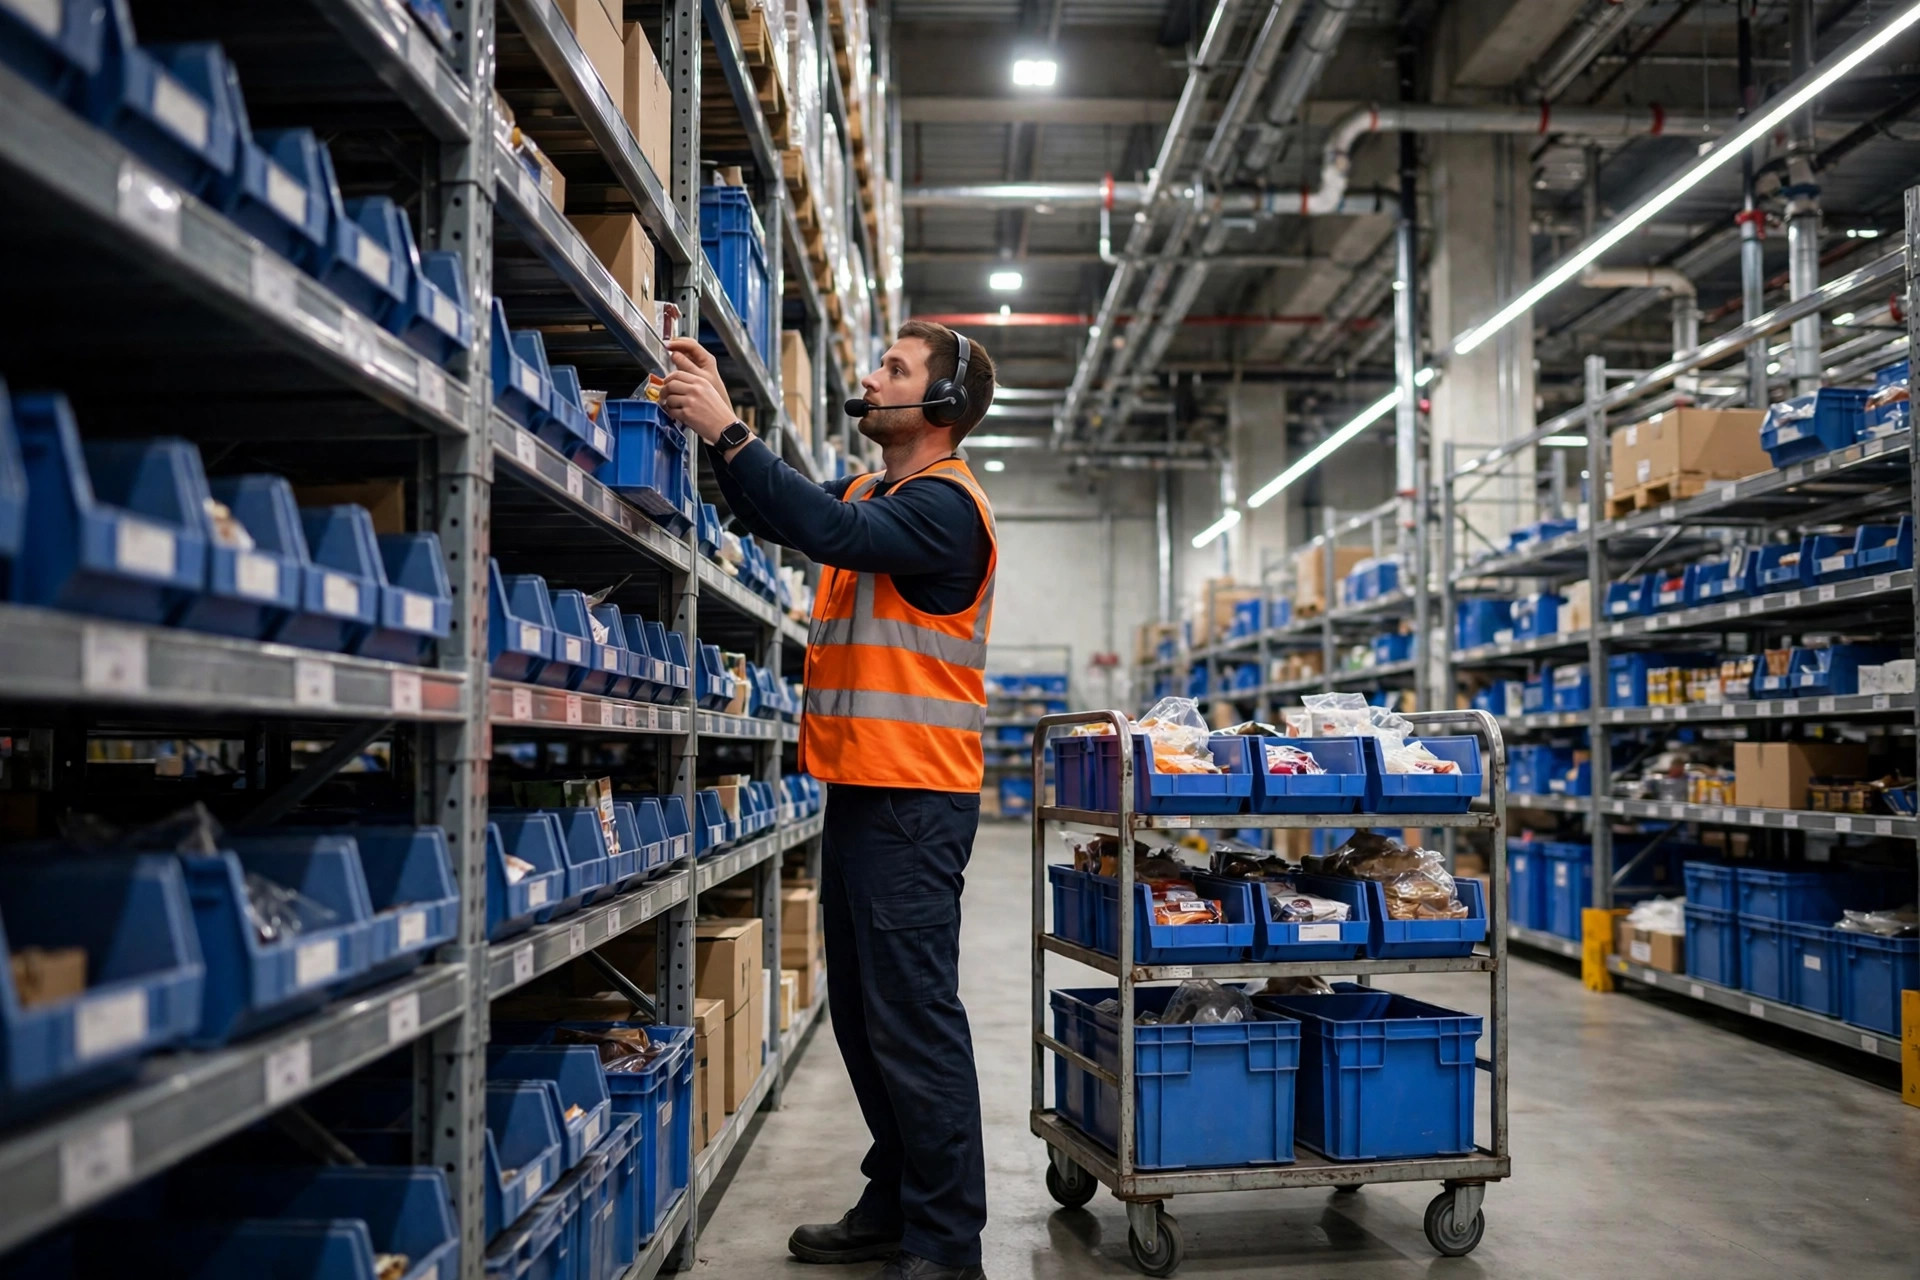
La tercera capa, y la fundamental, es la calidad de los datos. La optimización de rutas de picking es, en esencia, un sistema de "basura entra, basura sale". Si los datos maestros de ubicaciones están mal — el sistema dice que el SKU A está en B-03 mientras físicamente está en C-11 — entonces hasta una ruta matemáticamente perfecta es el camino más corto sobre el mapa equivocado. En varios proyectos que he seguido, los malos resultados de enrutamiento, al excavar una capa más abajo, casi siempre exponían problemas de datos maestros: variaciones de conteo cíclico persistentemente por encima de unos pocos puntos porcentuales, cambios de ubicación nunca registrados, slotting de SKUs nuevos hecho por conocimiento tribal. Los algoritmos no pueden arreglar problemas de datos. Solo pueden amplificarlos.
Esto lleva a una conclusión contraintuitiva que vale la pena decir en voz alta: el camino más corto no es el picking más rápido, y ciertamente no es el camino que un picker recorrerá de buena gana. Los algoritmos optimizan la distancia euclidiana; los pickers optimizan el gasto de energía y la comodidad ergonómica — una curva menos, una subida menos, evitar un pasillo congestionado. Factores que pesan casi cero en la fórmula de distancia pesan mucho en la decisión humana. Un motor de enrutamiento fluido en geometría pero analfabeto en ergonomía le suena a un picker como teoría divorciada de la práctica — y la teoría se vota en contra con los pies.
Entonces, ¿qué debería responder un equipo antes de lanzar un proyecto de optimización de rutas de picking que de verdad quiera que funcione? El análisis anterior sugiere tres preguntas obligatorias. Primera, ¿cuál es la precisión real de tus datos maestros de ubicaciones — se han reducido las variaciones de conteo cíclico a una banda aceptable? No hables de algoritmos sobre cimientos temblorosos. Segunda, ¿el esquema de compensación de los pickers está de acuerdo con el objetivo del sistema, o los dos KPIs están peleando? KPIs desalineados garantizan una ejecución descontada. Tercera, ¿el sistema cierra el ciclo sobre las excepciones de campo — puede un picker marcar "esta ruta está bloqueada" con un toque y hacer que el algoritmo aprenda de ello? Un sistema inteligente sin canal de retroalimentación es un sistema de lazo abierto, y los sistemas de lazo abierto derivan en entornos complejos. Eso no es una hipótesis; es teoría de control.
Mirando hacia 2026–2028, mi lectura de la trayectoria tecnológica es que la industria pasará de calcular la ruta más corta a calcular la más aceptable. Tres observaciones lo respaldan: primera, los proveedores líderes han empezado a comercializar enrutamiento "consciente del factor humano" que modela factores ergonómicos explícitamente en la función objetivo; segunda, la difusión de wearables y posicionamiento en interiores está dando a los sistemas sus primeros conjuntos de datos reales sobre cómo caminan realmente los pickers — los algoritmos por fin pueden aprender las rutas reveladas en lugar de las prescritas; tercera, los gemelos digitales están haciendo legibles por máquina los estados transitorios de la planta, de modo que una zona de staging congestionada quizá ya no tenga que vivir solo en la memoria de alguien. El cronograma, hay que admitirlo, depende de los costos del hardware de posicionamiento en interiores — si no bajan en tres años, la era de la "ruta más aceptable" podría llegar más tarde de lo esperado.
Cierro con una pregunta abierta en lugar de un veredicto. Cuando los algoritmos por fin aprendan a pensar como pickers veteranos — esquivando la congestión, favoreciendo lo ergonómico, conservando energía — la siguiente pregunta podría ser si el enrutamiento de picking necesita una única respuesta "óptima". Quizá el sistema del futuro ofrezca varias rutas con distintos compromisos y devuelva la elección final a la persona en la planta. La mejor relación entre tecnología y personas, me parece, nunca fue sobre quién manda a quién.
Por Dr. Chen, investigador de la cadena de suministro
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.