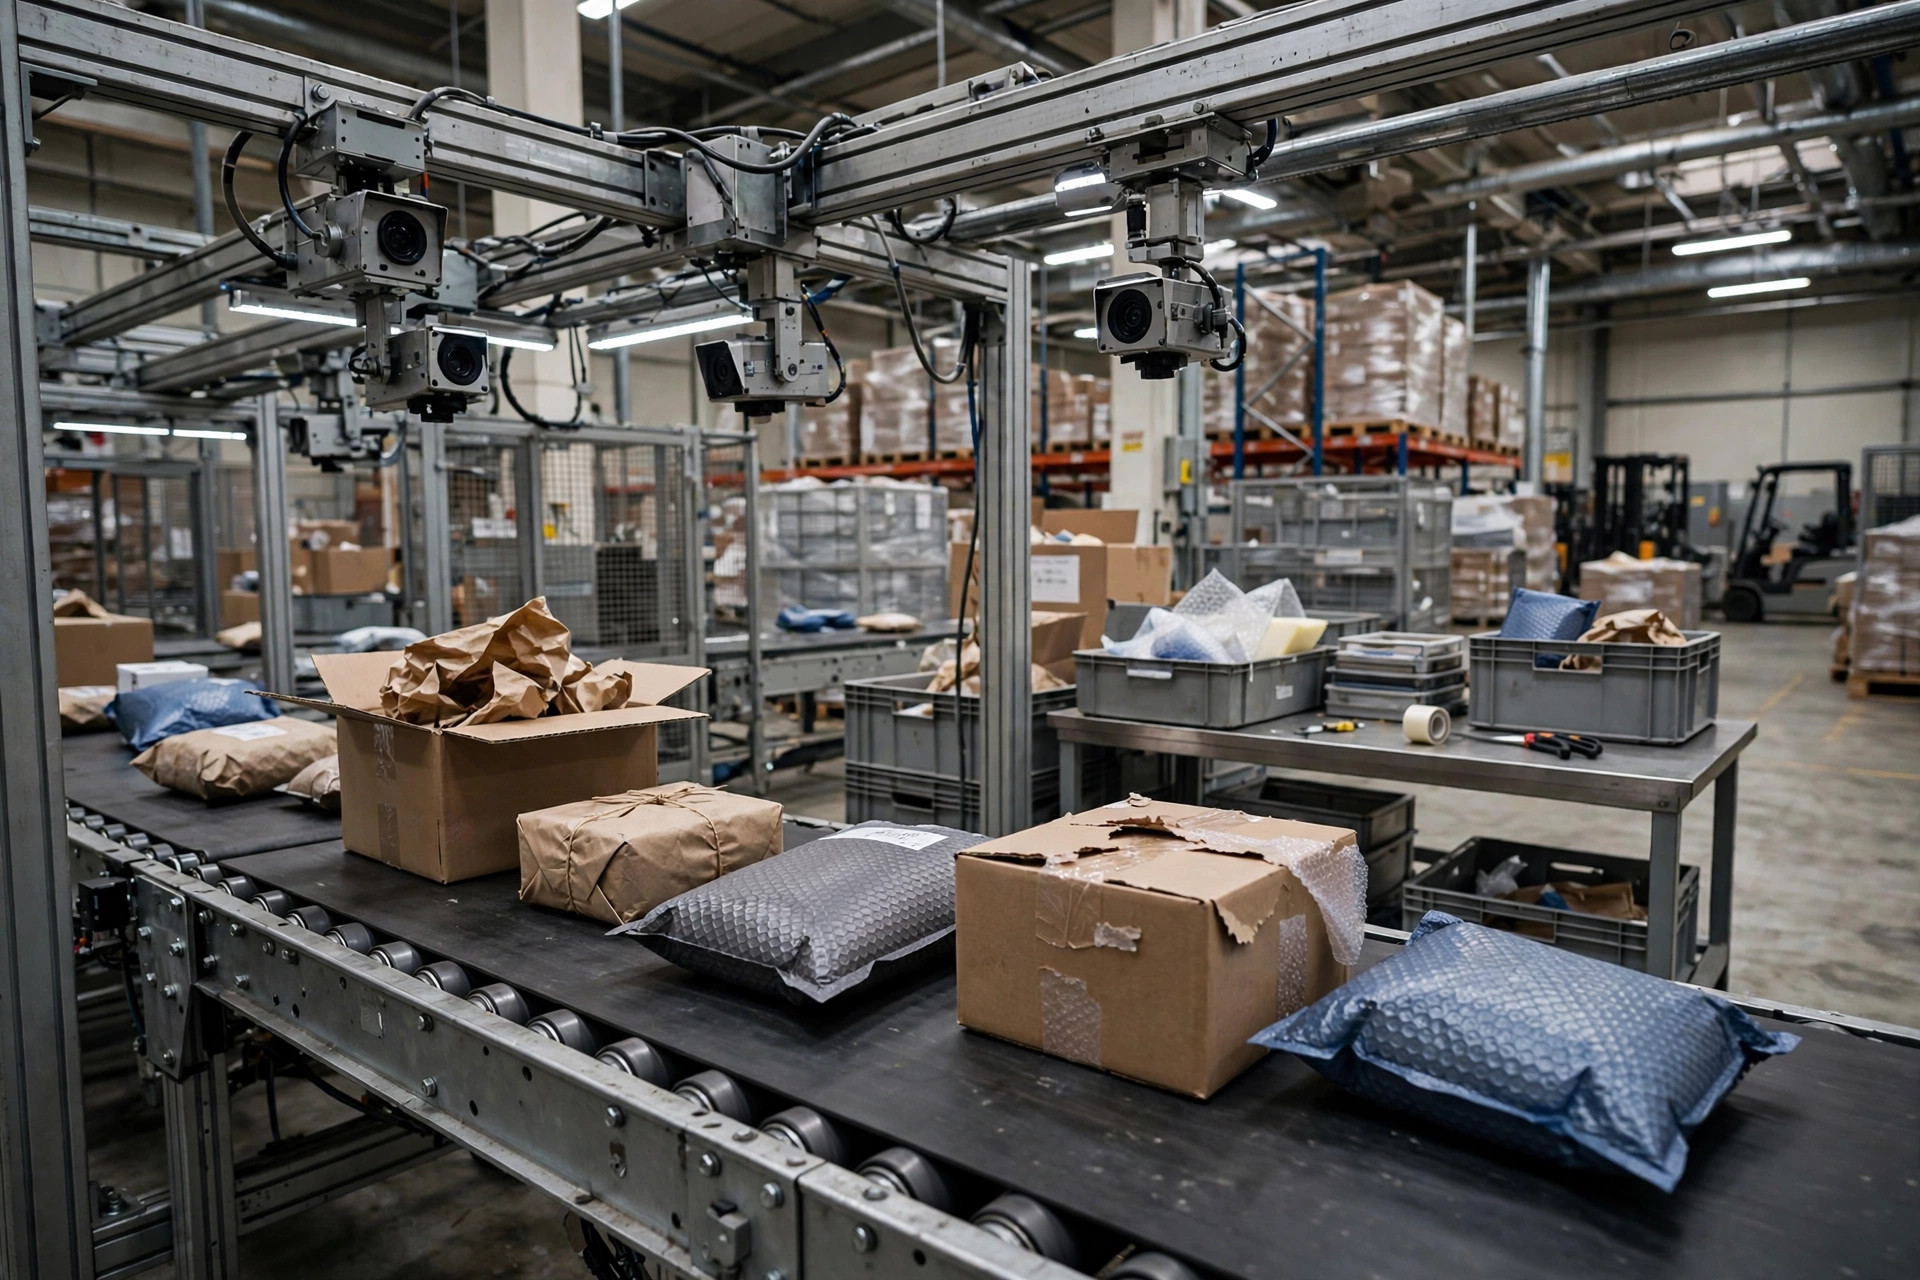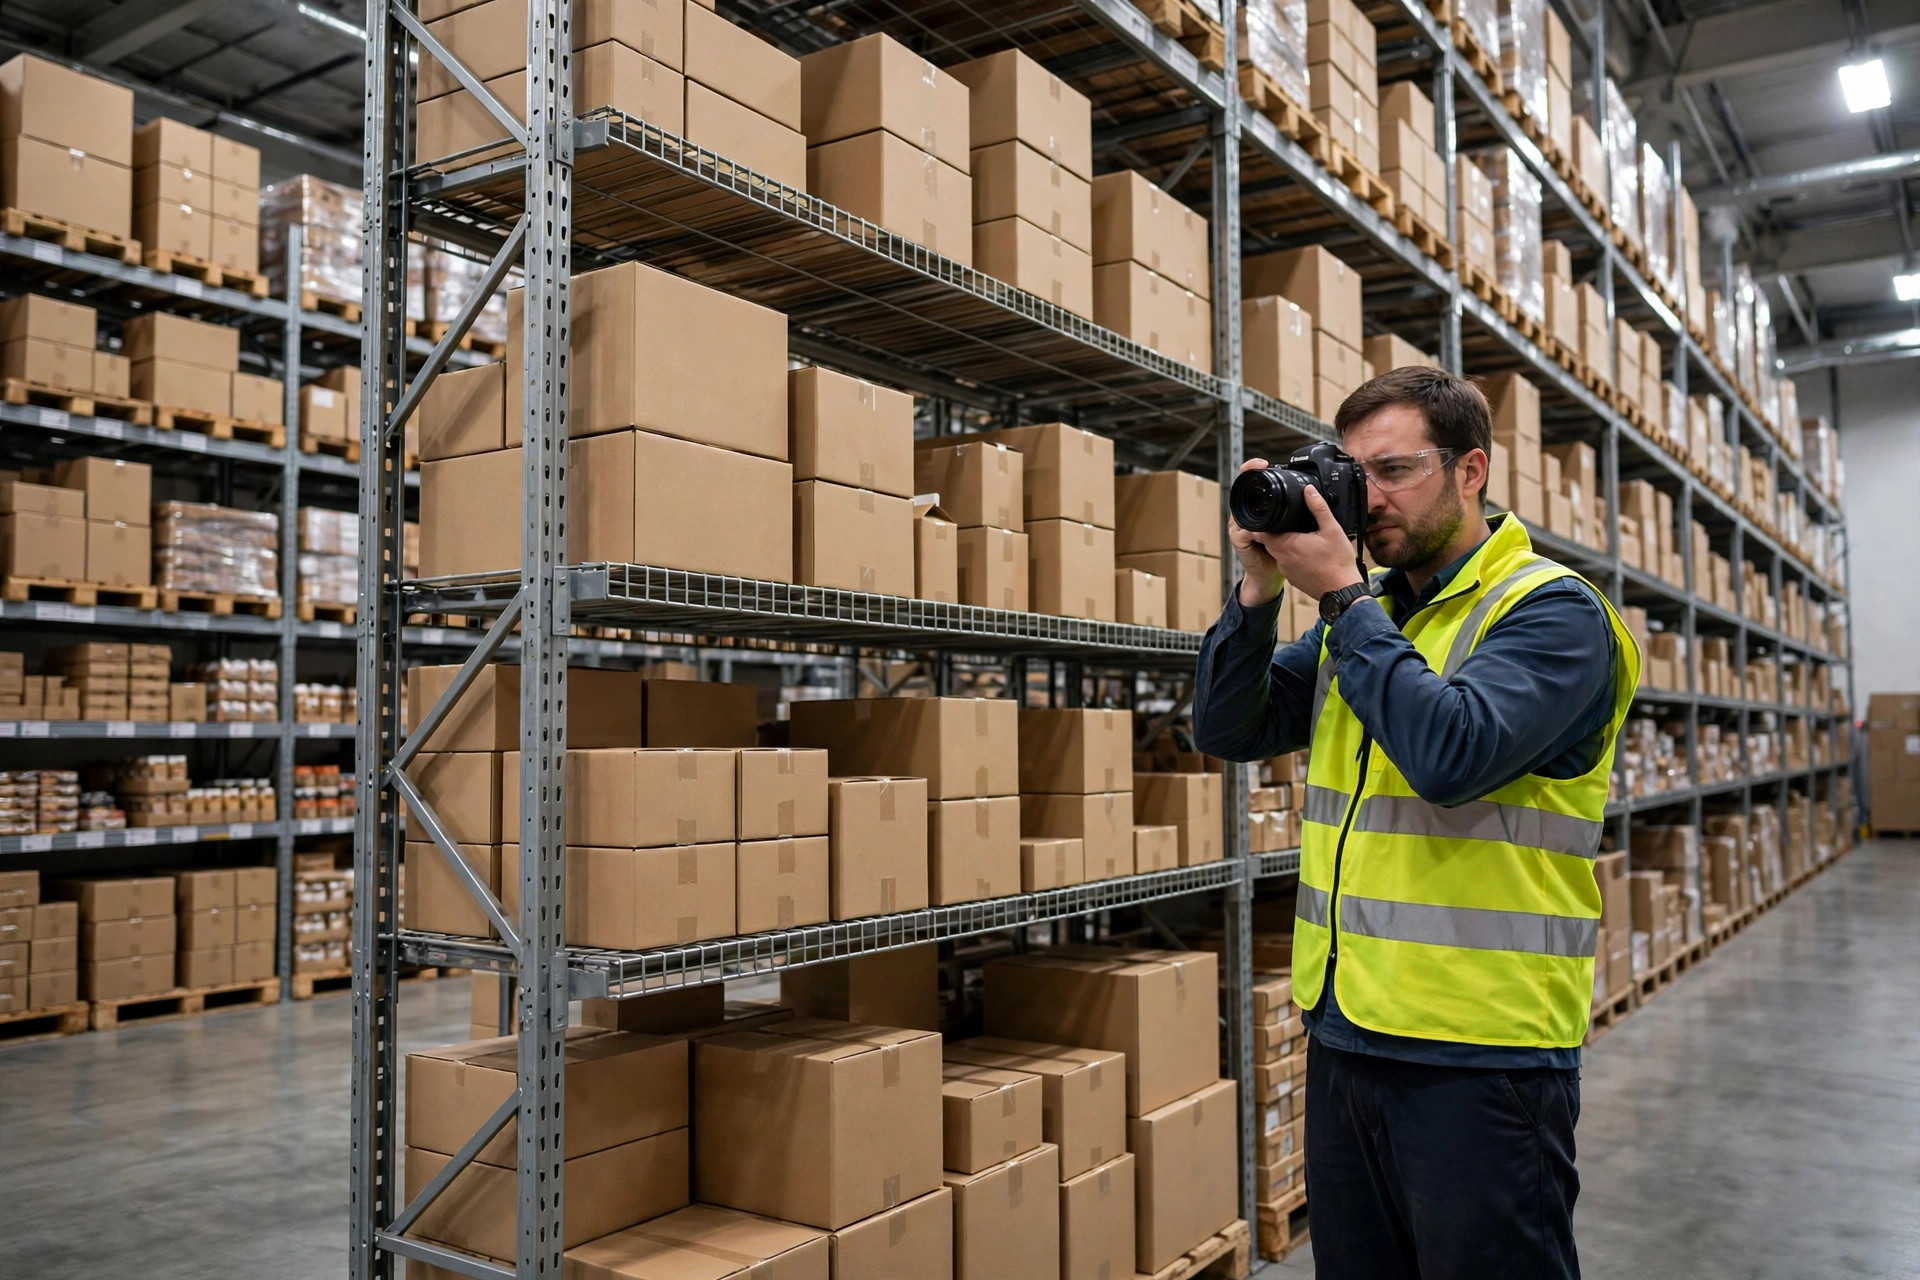
Un gerente de almacén en Inland Empire me contó una historia el año pasado a la que sigo volviendo. Su equipo pasó tres meses fotografiando y etiquetando más de diez mil imágenes de SKU y entrenó un modelo de visión para la verificación de picking. La primera semana en producción, la precisión parecía excelente. Luego llegó el cambio de empaque de temporada — algunos SKUs principales recibieron nuevos diseños con colores dominantes distintos — y la precisión se desplomó. El modelo terminó siendo peor que las revisiones manuales que reemplazó. Deberían haber visto las caras del equipo del proyecto.
No fue un caso aislado. Cuando los almacenes intentan entrenar sus propios modelos de visión, el punto de falla casi nunca es el algoritmo — los modelos de código abierto abundan y la calidad es bastante parecida. El punto de falla son los datos: cuántas fotos, tomadas cómo, etiquetadas cómo. Vamos a desmenuzarlo.
No necesitas más fotos. Necesitas más variedad
El instinto es acumular volumen: diez mil fotos deberían bastar. A medias.
Los modelos no sufren de "muy poco". Sufren de "muy sesgado". Diez mil fotos de la misma estación, la misma cámara, la misma luz de las 10 a.m. le enseñan al modelo una sola cosa, y la foto número cien mil le enseña lo mismo otra vez. Lo que realmente determina si tus datos bastan es cuántos tipos de variación cubren. Antes de disparar una sola foto, clava una lista de verificación de variaciones en la pared:
Iluminación. Los fluorescentes del almacén y el sol de la tarde que entra sesgado por las puertas del muelle son dos colores completamente distintos. Toma fotos de los mismos SKUs por la mañana y por la tarde. Los tubos viejos con la temperatura de color corrida también cuentan.
Ángulo. La cámara sobre la estación de verificación está fija, pero las cajas no: de lado, de pie, boca abajo, medio fuera de cuadro. No tomes solo la pose ensayada — captura la forma en que un conductor de montacargas realmente deja caer una caja.
Fondo. Cintas transportadoras, huecos entre tarimas, reflejos del piso — cuanto más desordenado el fondo, más tiene que aprender el modelo a ignorarlo. Rota por dos o tres estaciones en lugar de exprimir una sola.
Estado del empaque. Aquí es donde muere la precisión. Cajas aplastadas, manchadas de agua, medio envueltas en film estirable, cubiertas de calcomanías promocionales — más el empaque rediseñado que llega cada temporada. ¿Ese distribuidor del que hablé? Su conjunto de entrenamiento tenía cero ejemplos del empaque nuevo. El modelo nunca lo había visto, así que adivinó.
Toma una ronda, marca lo que cubriste, vuelve por lo que falte. Eso supera siempre a tomar diez mil fotos a ciegas. Una cosa más: clasifica tus SKUs según la frecuencia con que cambian de empaque. Las piezas industriales que se ven igual durante años se pueden fotografiar una vez y dejar en paz. Los alimentos y productos de consumo que se reempacan unas cuantas veces al año necesitan la recolección de datos como un hábito recurrente, no como un proyecto único.
Empieza con cuadros, no con polígonos
La segunda trampa es el etiquetado. Muchos equipos saltan directo a la segmentación de instancias porque "más preciso debe ser mejor". Mi consejo: que funcione primero un modelo de cuadros delimitadores.
Los cuadros son muchísimo más rápidos de etiquetar — un anotador entrenado puede hacer cientos en una mañana (estimación ilustrativa). Dibujar polígonos toma varias veces más tiempo y es más difícil mantenerlo consistente. Y los cuadros ya resuelven la mayoría de los trabajos de almacén: identificación de SKU, detección de cajas vacías, si una tarima está cargada, si hay un objeto extraño en la cinta. La segmentación se gana su lugar solo cuando necesitas medición precisa (digamos, estimar dimensiones de cajas para el peso dimensional) o cuando la oclusión es tan grave que un cuadro no puede enmarcar el objeto de todos modos.
La calidad del etiquetado supera a la cantidad, y no está ni cerca. Unos cuantos cientos de imágenes donde dos anotadores discrepan sobre lo que cuenta como "dañado" le enseñan ruido al modelo. Antes de empezar a etiquetar, escribe una especificación de media página: qué cuenta como dañado, qué cuenta como bien, si etiquetar objetos ocluidos más de la mitad. Luego haz que dos personas etiqueten el mismo lote de unas cuantas docenas de imágenes (ilustrativo). Donde discrepen, corrige la especificación. No escales hasta que estén mayormente de acuerdo.
¿Tercerizar o etiquetar en casa? Depende de la fase. Las plataformas de etiquetado (Labelbox, Roboflow y similares) suben el volumen rápido, pero no conocen tu negocio — no reconocerán que un "nuevo diseño de empaque" o una "calcomanía promocional" es un cambio relevante. Tu propia gente etiqueta despacio, pero vive en el almacén y detecta anomalías de un vistazo. Lo que yo hago: etiqueto el primer lote de casos difíciles en casa para fijar el estándar, tercerizo el volumen rutinario y audito al menos uno de cada diez (tasa de auditoría ilustrativa) — un mal lote falla todo el lote.
Ajusta, no entrenes desde cero — y luego retroalimenta los casos difíciles
Aquí va el veredicto: la mayoría de los almacenes nunca necesita entrenar un modelo desde cero.
Los modelos preentrenados de código abierto — la familia YOLO de Ultralytics, preentrenada en conjuntos masivos de datos como COCO — ya han visto cientos de miles de objetos cotidianos. Tu trabajo es ajustar uno con tus SKUs para que aprenda tu empaque. Los datos necesarios para el ajuste fino son otro universo distinto al entrenamiento desde cero: normalmente unos cuantos cientos a unos cuantos miles de fotos bien cubiertas bastan para empezar (varía mucho según el SKU; pruébalo con tus propios datos). Entrenar desde cero es un deporte de laboratorio de investigación. Los almacenes no lo necesitan.
Tampoco fijes metas de precisión por capricho. En un rol de verificación, el modelo ayuda a la gente; no la reemplaza. Una meta sensata se ve como "reducir la carga de verificación manual a más de la mitad, con una tasa de fallos no peor que la línea base manual actual" (ilustrativo — fíjala contra tus propios números). Apunta a un mágico "99%" y te ahogarás en un ciclo interminable de recolección de datos.
La pieza más subestimada es lo que pasa después del lanzamiento. Llegan SKUs nuevos, los viejos se reempacan, suben calcomanías promocionales — la larga cola que tu conjunto de entrenamiento nunca vio, donde el modelo queda ciego. La solución es un ciclo, no un conjunto de datos más grande: después de salir en vivo, recupera automáticamente las fotos que el modelo falló o sobre las que dudó, haz que un humano las confirme, retroalimenta los casos difíciles confirmados al conjunto de entrenamiento y reentrena según un calendario. La frecuencia depende de qué tan rápido cambien tus SKUs: los alimentos y productos de consumo de alta rotación podrían necesitar reentrenamiento mensual o incluso quincenal; los productos industriales de cambio lento pueden ir trimestrales. El punto es que el ciclo siga girando — a mi amigo distribuidor le faltaba exactamente este ciclo.
Y una palabra honesta: si ni siquiera tienes un equipo de etiquetado, no hables de construir el tuyo. Hay servicios de verificación por visión por estación en el mercado — compra una estación, demuestra el valor y luego decide si construir. El mayor costo de un modelo casero nunca fueron las GPUs. Es la gente.
Lo que puedes hacer mañana: no inicies un proyecto todavía. Elige una estación de verificación de picking, dedica una tarde a fotografiar tus SKUs principales unas cuantas docenas de tomas cada uno (ilustrativo) en condiciones normales, con luz lateral, dañados y apilados — un par de cientos de fotos en total. Envíalas a una plataforma de etiquetado para un lote de prueba. Ponlo en vivo una semana y mira cómo le va en turnos reales. Si va bien, habla de expandir. Si no, sabrás exactamente dónde está el problema — y nueve de cada diez veces es variación no cubierta, no muy pocas fotos.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.