Imagina un almacén de devoluciones con 20,000 SKUs. El manual tradicional de visión por computadora dice: fotografía 500 imágenes de entrenamiento por SKU. Eso son 10 millones de imágenes. Te ahorro el trabajo de hacer ese cálculo: este camino no lleva a ninguna parte.
Últimamente, cada vez más operadores me preguntan por el few-shot learning, y el discurso es siempre el mismo: "Tenemos demasiados SKUs para el entrenamiento tradicional. Nos dicen que el few-shot solo necesita un puñado de imágenes por producto, ¿es esta nuestra salida?" Mi respuesta también es siempre la misma: sí, es una salida, para aproximadamente la mitad de tus casos de uso. Para la otra mitad, ni siquiera puede cruzar la puerta. Hoy trazo esa línea.
Few-shot, explicado de un tirón
El deep learning tradicional memoriza. Tiene que aprender cómo se ve cada SKU desde cero, lo que significa darle cientos o miles de imágenes por producto. El few-shot learning, en cambio, reconoce parecidos de familia. El modelo base ya ha visto decenas de millones de imágenes y ha aprendido la gramática general de la forma, el color y la textura. Le muestras de 3 a 5 fotos de cada SKU, e identifica los productos por similitud, más como reconocer a un primo que como recitar un libro de texto.
Esto no es ciencia nueva. Los investigadores llevan años en ello: el conjunto abierto SKU-110K contiene 11,743 imágenes, más de 1.7 millones de cajas anotadas y más de 110,000 SKUs únicos (CVPR 2019), y un artículo de 2024 llevó la clasificación one-shot de SKUs a partir de una sola imagen prototipo. Lo que ha cambiado es que los modelos base se volvieron lo bastante potentes en los últimos dos años como para hacerlo desplegable. La tecnología estaba lista; lo que faltaba era que los operadores supieran dónde pertenece.
Dónde el few-shot es suficiente
Mi prueba es sencilla. Dos preguntas: cuánto margen de error tienes y qué tan rápido cambia tu catálogo de SKUs.
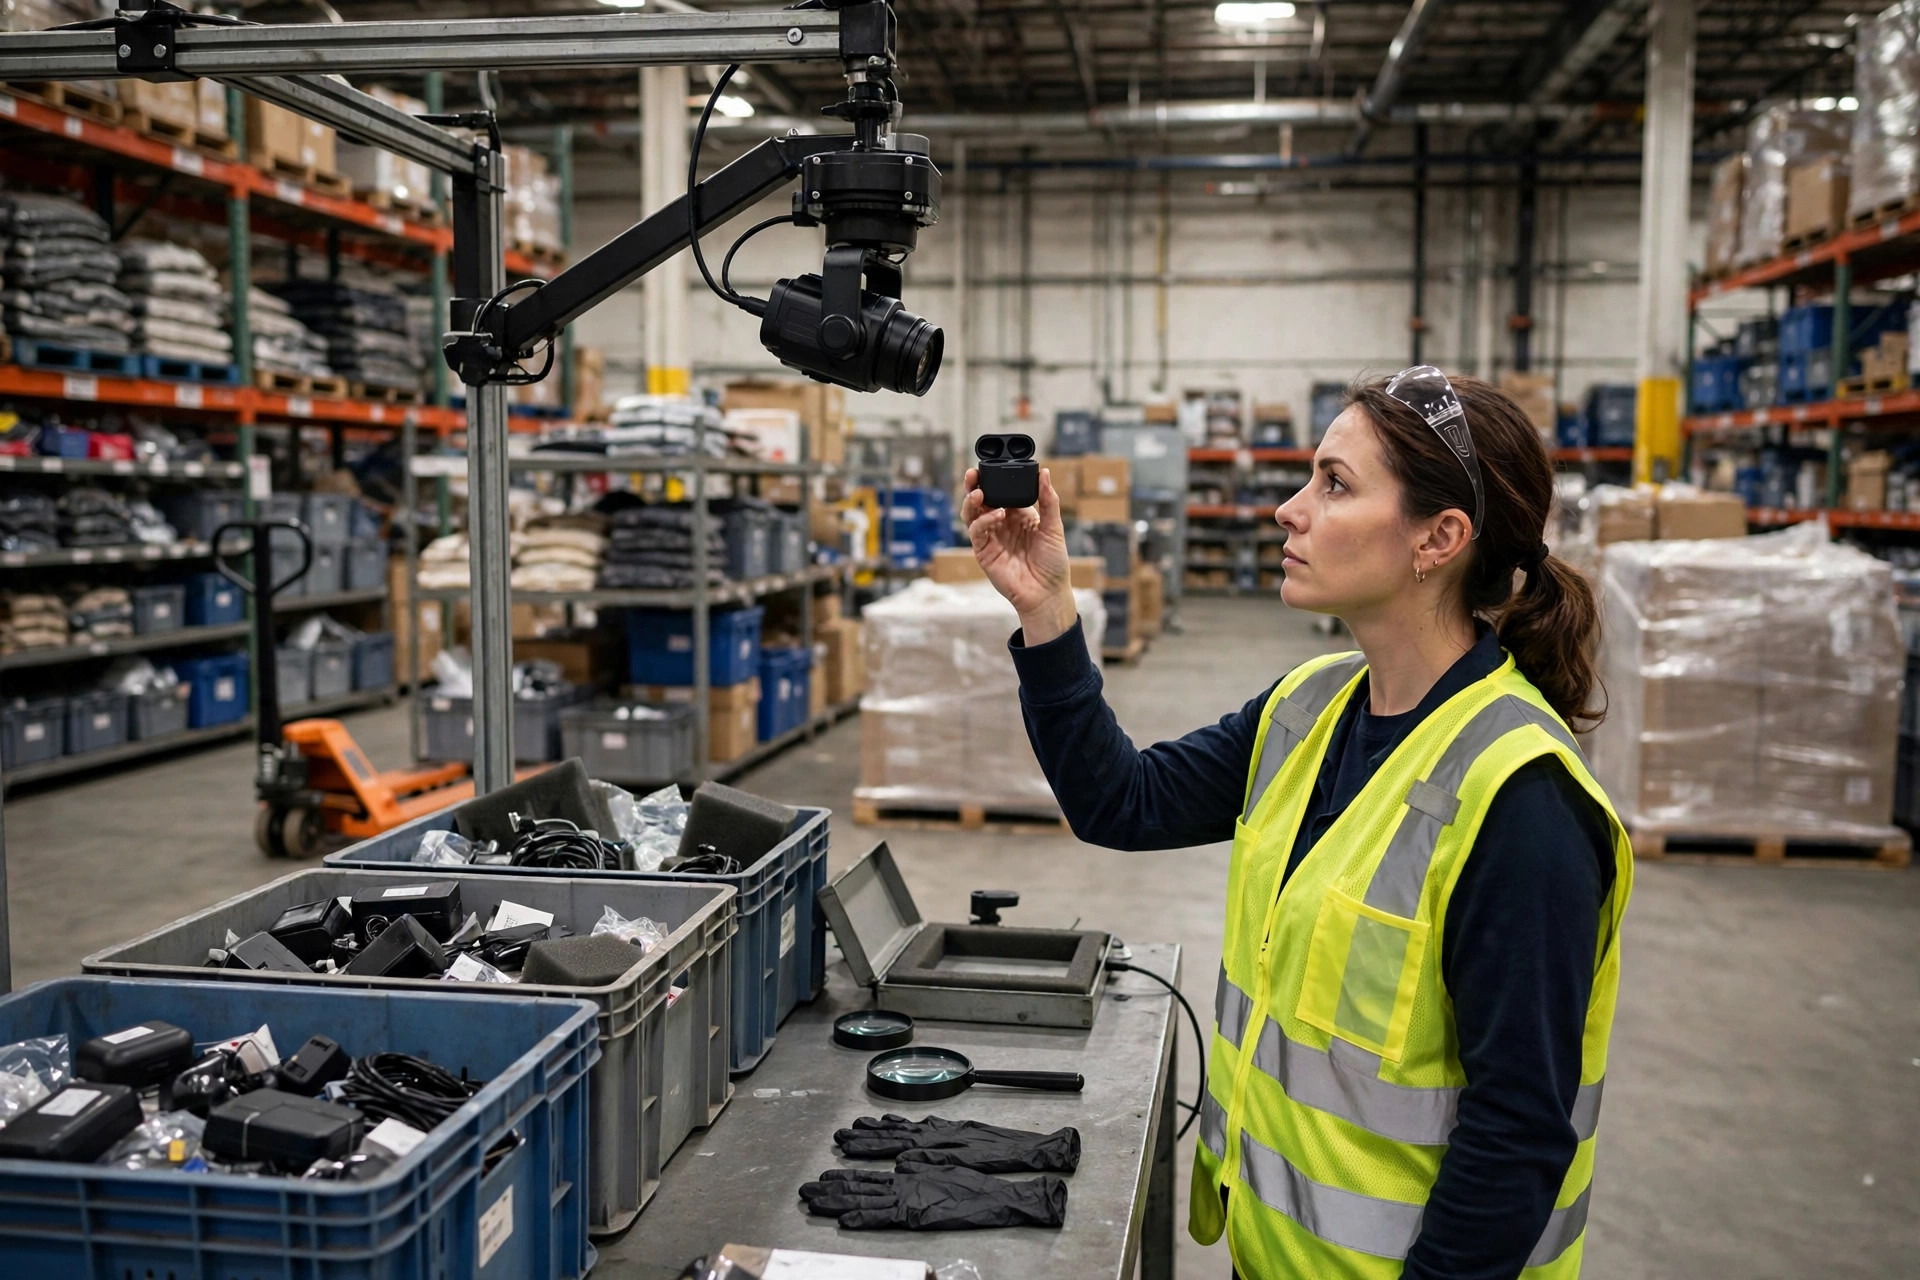
La inspección de devoluciones es el mejor ajuste que he visto. Los productos devueltos son una mezcla larga y desordenada: muchos SKUs venden unas pocas docenas de unidades al año, y nunca reunirás cientos de imágenes de entrenamiento para ellos. Un inspector sostiene el artículo frente a una cámara, el sistema identifica el SKU y muestra el registro del producto, y el inspector le da un vistazo para confirmarlo. ¿Se equivoca en uno? El humano lo corrige, la imagen vuelve como una nueva muestra, y el sistema se afina la próxima vez.
El otro ajuste es la clasificación visual como segunda opinión. Piensa en un almacén transfronterizo lleno de mercancía suelta sin código de barras, o cajas cuyas etiquetas se pegaron torcidas y no se escanean. La visión few-shot ofrece un candidato; una persona o un escáner de código de barras toma la decisión final. Nota la palabra "candidato": sugiere, no decide.
Lo que estos escenarios comparten: baja velocidad, bajo volumen, y una red de seguridad humana detrás del modelo. Cuantos más SKUs tengas, menos muestras recibe cada uno, más larga la cola: mayor es la ventaja del few-shot. En estos escenarios el enfoque tradicional no solo es caro, es inviable. Nadie va a fotografiar 500 imágenes para un SKU de cola larga que mueve 30 unidades al año.
Dónde debes mantenerte alejado
Primero, lo obvio: la clasificación de alta velocidad. Un sorter que empuja cientos de cajas por minuto exige una precisión de reconocimiento extremadamente alta (valídala con tus propios datos), y eso no lo consigues con un modelo que ha visto tres fotos de cada SKU. El enfoque honesto para líneas de alta velocidad es el entrenamiento etiquetado a gran escala, o saltarse la visión por completo en favor de códigos de barras combinados con sensores de peso y dimensiones. Cuanto más rápida la línea, menos espacio tiene el few-shot para respirar. Eso es física, no un problema de ajuste.
Segunda trampa: SKUs que se ven casi idénticos. Dos champús de la misma línea de marca, mismo empaque, que solo difieren en el tamaño de la botella impreso en letra pequeña: aquí es exactamente donde el reconocimiento por parecido de familia es más débil. He visto a un equipo quemar meses aquí: el modelo identificaba mal los productos con total confianza, los humanos tenían que revisar cada artículo, y la línea terminó más lenta que el trabajo puramente manual, más el costo del hardware.
Tercero: cualquier lugar donde las condiciones de imagen no se queden quietas. El piso del almacén no es un laboratorio. Una cámara sobre un transportador, una luz parpadeante, una caja inclinada, y la precisión se desploma. Con solo unas pocas muestras por SKU, una foto borrosa puede envenenar una quinta parte de tus datos de entrenamiento. Irónicamente, el few-shot exige una disciplina de captura más estricta que el entrenamiento completo, lo que nos lleva al despliegue.
Cómo desplegarlo: cuatro pasos
Paso uno: elige un modelo base; no entrenes desde cero. Los modelos base de visión abiertos y comerciales ya son lo bastante capaces. La verdadera pregunta es cuál rinde con imágenes de producto, no cuál lidera los benchmarks genéricos. Pasa tus propios productos por él durante dos semanas y mide tú mismo la precisión top-1. No confíes en la presentación del vendedor. Dos semanas de pruebas honestas son más baratas que seis meses de retrabajo.
Paso dos: fija una especificación de captura. Esta es la parte más subestimada de todo el proyecto. Posición de cámara fija, iluminación fija, fondo fijo, de 3 a 5 ángulos por SKU. Cada imagen tiene que contar. Imprime la especificación, lamínala, pégala en la mesa de inspección para que sobreviva a los cambios de turno y a las nuevas contrataciones.
Paso tres: construye el ciclo de casos difíciles. Todo lo que el modelo falla o marca con baja confianza entra a una cola de revisión; una vez que un humano confirma la etiqueta correcta, la imagen vuelve como una nueva muestra. Cuando este ciclo está en marcha, el modelo se potencia: mejora cuanto más lo usas. Esa es la mayor ventaja operativa del few-shot sobre el entrenamiento tradicional: agregar un nuevo SKU significa tomar unas fotos y salir en vivo en minutos, no reunir un conjunto de datos y reentrenar.
Paso cuatro: mantén al humano en el ciclo, permanentemente. Todo lo que esté por debajo de tu umbral de confianza va a revisión manual. Esta partida no es opcional. En un almacén, el mejor asiento de la IA siempre es el del copiloto; el volante queda en manos de las personas.
Las cuentas: tres enfoques lado a lado
Primero, el entrenamiento etiquetado completo. Las guías de precios de la industria sitúan la anotación básica de clasificación de imágenes alrededor de $0.03 a $0.10 por imagen (según la guía de costos de etiquetado de basic.ai). Suena barato, hasta que cuentas la recolección: fotografiar, organizar, control de calidad, control de versiones, todo mano de obra humana. 20,000 SKUs por 500 imágenes son 10 millones de imágenes. Esa factura de mano de obra aplasta a cualquier operación mediana. El entrenamiento completo solo tiene sentido donde los SKUs son pocos, estables, y las exigencias de precisión son extremas.
La ruta few-shot: de 3 a 5 imágenes por SKU convierten 20,000 SKUs en 60,000 a 100,000 imágenes, dos órdenes de magnitud menos. El costo de anotación básicamente desaparece, ya que el etiquetado ocurre naturalmente al momento de la captura. El gasto real es el trabajo inicial: validar un modelo base y hacer cumplir la especificación de captura. Inversión única, retornos crecientes.
Y la tercera ruta que la gente olvida: códigos de barras y reglas. Si tus productos llevan códigos de barras adecuados, simplemente escánéalos: la visión es puro sobrecosto. Mi consejo permanente a los clientes: si un escáner lo resuelve, no construyas visión; si una regla lo resuelve, no construyas aprendizaje. La IA no arregla las operaciones. Si tu maestro de SKUs es un desastre y las etiquetas van torcidas, arregla el proceso antes de hablar de IA. Ese orden no es negociable.
Por qué las devoluciones merecen su propia sección
La NRF y Happy Returns proyectan que las devoluciones del retail estadounidense en 2024 alcanzaron $890 billion, el 16.9% de las ventas anuales de los minoristas. El área de devoluciones es el rincón más desordenado de cualquier almacén: la mezcla de SKUs más salvaje, la mano de obra más cara, el proceso menos estandarizado. Los inspectores tienen que identificar el artículo, juzgar su condición, y decidir si vuelve a stock o se da de baja. De esos tres trabajos, la identificación es donde la visión few-shot se gana su lugar, porque los surtidos de devoluciones son de cola larga por naturaleza.
Una advertencia antes de emocionarte: identificar el SKU es solo la mitad del trabajo de inspección. Juzgar la condición, nuevo, ligeramente usado, dañado, sigue más allá de lo que los modelos few-shot actuales hacen de forma confiable, te diga lo que te diga el vendedor. Haz primero el reconocimiento de SKU, deja la calificación de condición a los humanos, y avánzalo en dos fases. No intentes tragártelo entero.
Una cosa que puedes hacer mañana
Si tienes una mesa de inspección de devoluciones, aquí va un experimento de una tarde: toma tus 50 SKUs devueltos más comunes, toma 5 ángulos de cada uno, y pásalos por un modelo base de visión abierto como prueba de recuperación por similitud. Revisa la precisión top-1. Cuesta casi nada, toma una tarde, y te dirá algo que ningún discurso de vendedor puede: si este camino realmente lleva a alguna parte para tu operación. Deja que los datos hablen.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.