Em 2023 trabalhei com um armazém de devoluções que queria um sistema de visão em sua linha de auditoria para detectar caixas danificadas. A conta era simples: uma caixa danificada enviada a um cliente significava uma reclamação mais o frete de devolução — o suficiente para pagar várias câmeras industriais. O projeto passou por todas as revisões e então travou em algo que ninguém tinha previsto. Nem o algoritmo. Nem as especificações das câmeras. Não conseguíamos reunir os dados de treinamento.
Depois de meses de espera, tínhamos algumas dezenas de fotos reais de caixas danificadas. Pior: eram quase idênticas — o mesmo canto amassado, as mesmas duas esteiras transportadoras, as mesmas luzes do teto. Treinamos o modelo mesmo assim. Na primeira semana em produção, ele sinalizou caixas em perfeito estado como danificadas, e os alarmes falsos se acumularam até que os operadores desligaram os alertas. Esse projeto me ensinou uma regra que uso até hoje: no primeiro dia de qualquer projeto de visão, pergunte de onde vêm os dados antes de escolher a câmera.
Por que o defeito se recusa a ser fotografado
Comecemos pela verdade desconfortável. Danos, vazamentos, caixas com etiqueta errada, fita descolando — são eventos raros por design em qualquer armazém bem gerenciado. Uma linha de auditoria de alto volume move dezenas de milhares de unidades por dia mantendo sua taxa de danos em frações baixas de um por cento. Coletar alguns milhares de fotos de "danificadas" significa acampar ao lado da esteira por meses, e você não pode trocar de estação, religar o teto nem trocar de fornecedor de caixas no meio da coleta sem deslocar sua distribuição de dados.
Mesmo quando você finalmente consegue as fotos, a rotulagem é um poço sem fundo. Dano não tem verdade objetiva: quanto um canto precisa estar amassado para contar? Fita descolada dois milímetros classifica uma caixa? Três rotuladores vão anotar a mesma imagem de três jeitos diferentes. E há o assassino silencioso da captura real: a cobertura de cena. Iluminação, ângulo da câmera, velocidade da esteira, idade da caixa — as combinações são infinitas. Suas fotos sempre vão descrever "esta estação, no trimestre passado", e o modelo vai sentir saudade de casa assim que entrar em produção.
Quando seu conjunto de dados reais finalmente fica grande o suficiente, a janela do projeto geralmente já fechou. Esse é o ciclo da morte da visão em armazéns: os lugares que mais precisam do modelo são exatamente os que não conseguem produzir os dados.
Três formas de fabricar dados
Se os defeitos reais não vêm até você, construa-os você mesmo. Três abordagens funcionam de verdade, e cada uma tem seu próprio temperamento.
A primeira é a renderização de simulação 3D. Modele uma caixa em 3D, programe a profundidade do amassado, o posicionamento dos rasgos e os padrões de manchas, e então aleatorize à vontade a posição da câmera, a iluminação e o fundo. Cada imagem renderizada vem com anotações grátis — o renderizador vê a cena de uma vista de deus, então bounding boxes, máscaras de segmentação e mapas de profundidade saem direto do grafo de cena com zero custo de rotulagem. O ferramental é maduro: BlenderProc, de código aberto por Denninger e colegas do Centro Aeroespacial Alemão DLR em 2019 (arXiv:1911.01911), construído sobre a ideia de que a renderização fotorrealista reduz a lacuna sim-to-real; o Omniverse Replicator da NVIDIA, cujo propósito declarado é gerar dados sintéticos rotulados em escala para inspeção visual e robótica; e o pacote Perception da Unity, projetado especificamente para produzir conjuntos de dados sintéticos com anotações de verdade objetiva.
A segunda abordagem é a aleatorização de domínio, e sua lógica funciona ao contrário: não persiga o realismo, persiga o caos. O artigo fundador de Tobin e colegas em 2017 (arXiv:1703.06907) aleatorizou texturas, iluminação e posições de câmera com tanta agressividade que o mundo real começou a parecer apenas mais uma variação aleatória. O modelo deles localizou objetos em cenas reais com precisão de 1.5 centímetro. Minha leitura de campo: cenas de esteira com fundo fixo são ideais para esse truque, porque você não precisa que a simulação pareça real — você precisa que ela pareça variada.
A terceira rota são os modelos generativos. Alimente suas poucas dezenas de fotos reais de danos a um GAN ou um modelo de difusão e deixe-o sonhar mais variantes. Sou cético quanto a essa. Modelos generativos alucinam com total confiança, inventando padrões de dano que violam a física. Um modelo treinado com essas fantasias aprende características falsas e falha em produção mesmo assim. Meu veredito: modelos generativos servem bem como aliado de aumento de dados — mudanças de brilho, trocas de fundo — mas não peça a eles que inventem novas categorias de defeito do nada.
A simulação não é bala de prata
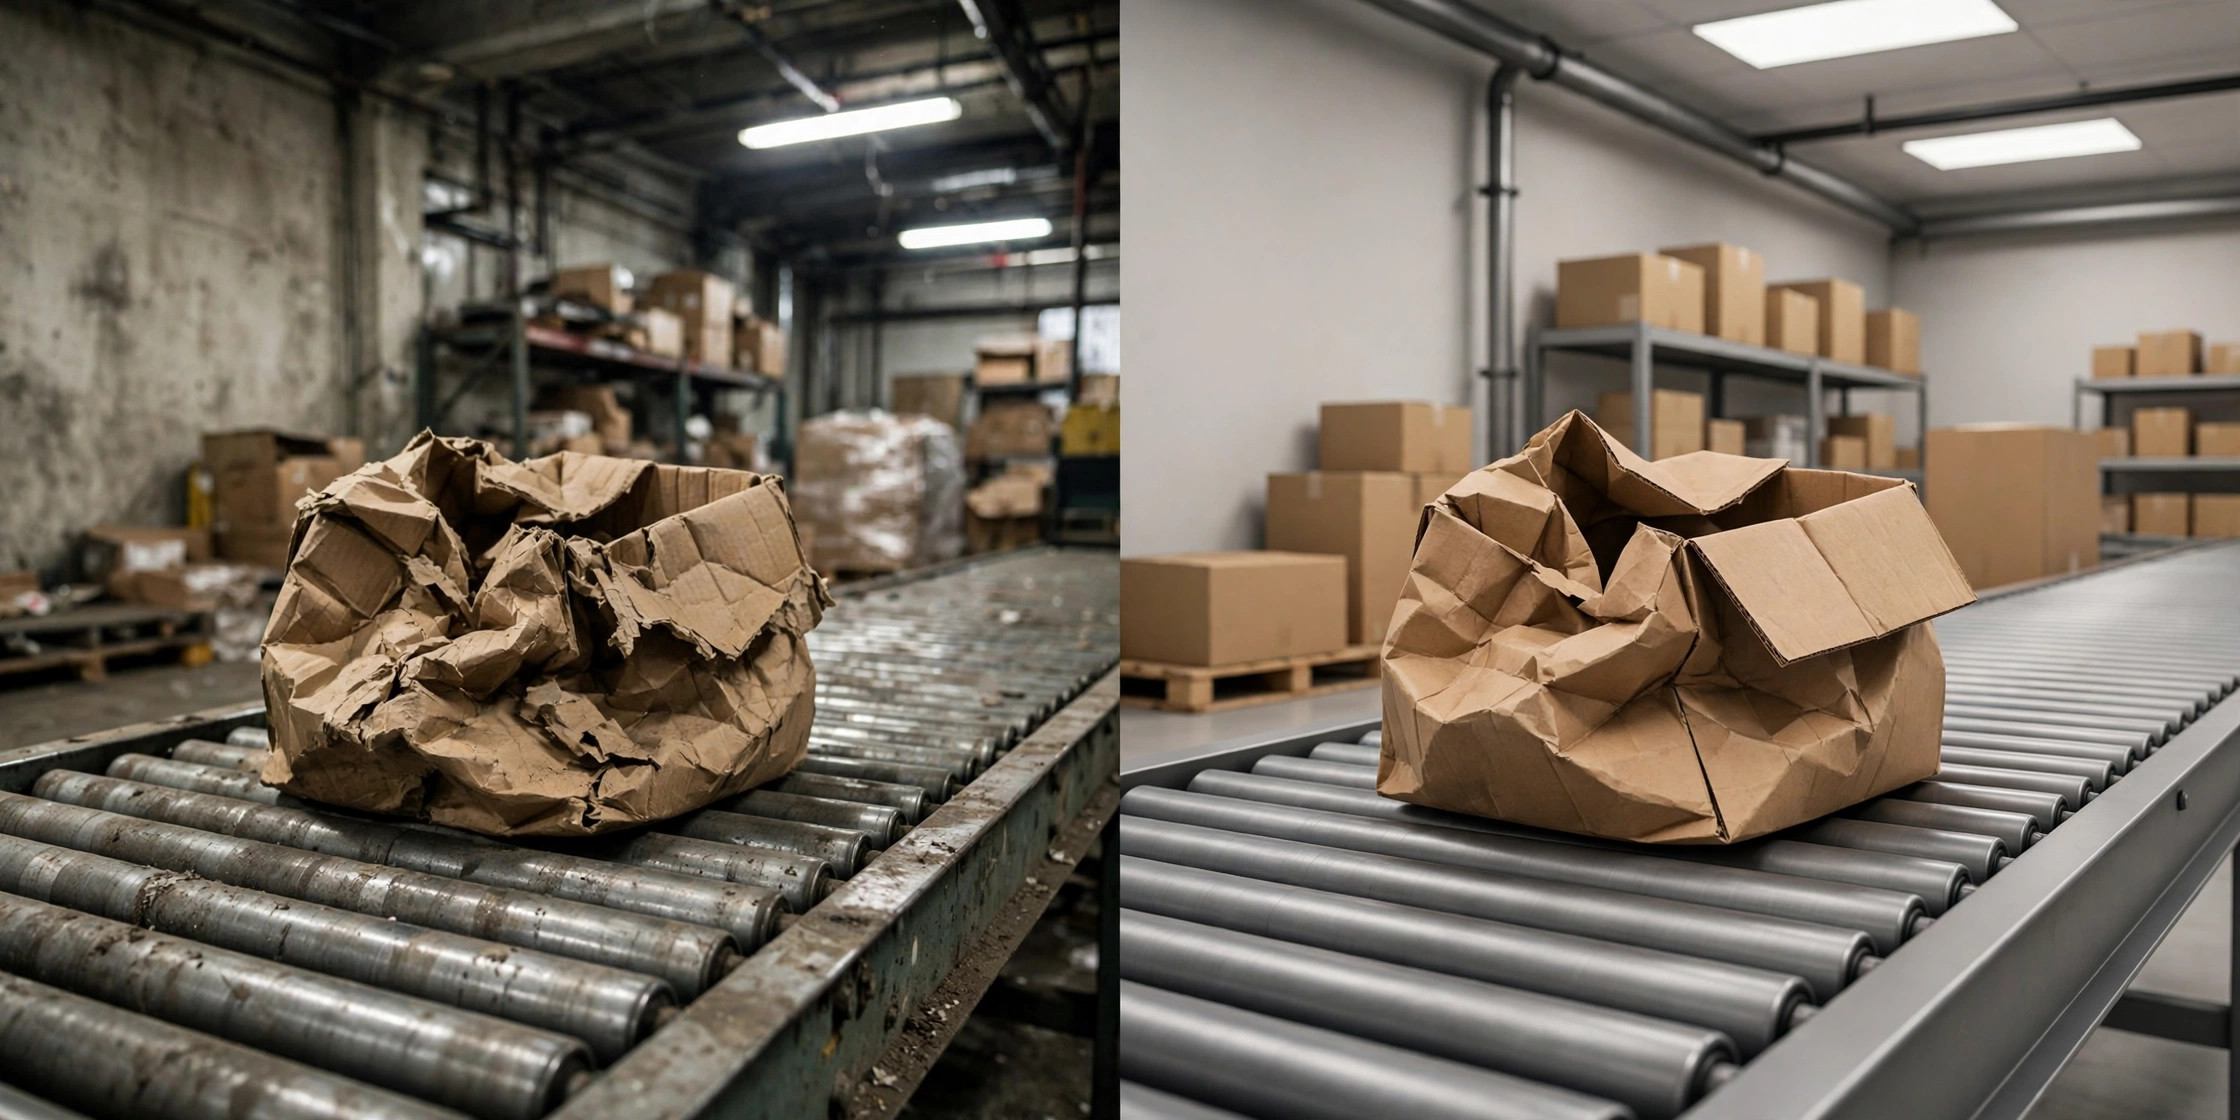
Olhe a imagem acima: uma caixa danificada real fotografada em um armazém, ao lado de sua gêmea renderizada em 3D. Se seus olhos conseguem notar a diferença, o modelo a sente dez vezes mais.
A lacuna sim-to-real é real. Por mais convincente que seja a iluminação renderizada, as simulações costumam pular o ruído do sensor, a distorção da lente e o desfoque de movimento de uma esteira a toda velocidade. A armadilha mais sorrateira: defeitos sintéticos tendem a parecer limpos demais, didáticos demais, enquanto o dano real é sujo, aleatório e irracional. Uma fronteira de decisão aprendida em dados limpos desmorona no momento em que encontra a lama do mundo real.
A correção é uma palavra: híbrido. Treine com dados sintéticos para cobertura, para que o modelo tenha visto formas de defeito suficientes; calibre com dados reais, para que a fronteira de decisão seja puxada de volta à realidade. Depois, feche o ciclo: continue alimentando o conjunto de treinamento com os falsos positivos e as falhas de produção. Dados sintéticos levam você de zero a um; dados reais levam você de "funciona" a "funciona bem". Nenhum substitui o outro.
Quando pular os dados sintéticos
Dados sintéticos são poderosos, mas alguns trabalhos saem mais rápido com uma câmera comum.
Pule a simulação quando o defeito for fácil de encenar. Caixas com etiqueta errada, por exemplo: imprima um lote de etiquetas, cole-as, e você pode tirar centenas de fotos em uma tarde com qualquer ângulo e iluminação que quiser. As horas que um artista 3D gasta construindo a cena cobririam três sessões completas de filmagem.
Pule-a quando ninguém na equipe fala a linguagem do pipeline 3D. Modelagem, materiais, iluminação, pipeline de renderização — cada um é um ofício por si só. Orçamentos de modelagem terceirizada costumam exceder o custo de fotografar mais rotular, e depois de duas ou três rodadas de revisões o projeto está morto.
Por fim, faça a conta de custo. A captura real é custo linear: mais uma foto, mais uma anotação, mais um dólar. A simulação é custo fixo: a parte cara é construir a cena, e depois cada imagem adicional custa quase nada. A regra de decisão é limpa: quanto maior o volume de que você precisa e mais raro o defeito, mais os dados sintéticos vencem. Volume pequeno, fácil de encenar — pegue a câmera e fotografe.
Seu checklist para amanhã de manhã
Se você vai começar um projeto de visão em armazém amanhã, faça isto em ordem e não pule etapas:
- Conte suas amostras primeiro. Liste cada classe de defeito que você precisa detectar e conte as fotos reais que você tem de cada uma. Qualquer classe que não preencha um conjunto de validação vai direto para a coluna de "deve usar dados sintéticos".
- Monte a câmera primeiro. Instale-a na posição final de implantação e deixe-a rodando por uma semana. Guarde esse fluxo de dados reais agora — é o capital que você vai gastar na calibração depois.
- Teste o ferramental primeiro. Consiga uma máquina com GPU, rode o exemplo oficial do BlenderProc de ponta a ponta e renderize seu primeiro lote de imagens autoanotadas. Se você não conseguir fazer isso funcionar, não está pronto para construir seu próprio pipeline de simulação.
- Faça uma comparação primeiro. Treine um modelo pequeno com dados sintéticos para pré-treino mais dados reais para ajuste fino, e outro só com dados reais. Compare as taxas de falsos positivos e falhas, e deixe os números decidirem.
- Fale de escala por último. Se o sintético vencer a comparação, invista na cena de simulação completa. Se perder, volte a fotografar e não brigue com o ferramental.
Meu veredito é direto: dados sintéticos não são bala de prata, mas são a alavanca mais subestimada da visão em armazéns. Bem usados, comprimem o "esperar pelos dados" de meses para semanas. Mal usados, são um brinquedo caro. O que separa os dois casos nunca é a fé na tecnologia — é a comparação sentada na sua mesa.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.