O mesmo algoritmo atingiu 99.2% no laboratório do fornecedor. Um mês no seu chão de armazém, está operando a 92%. Antes de acusar alguém de maquiar os números — essa diferença normalmente não é culpa do algoritmo. Seu armazém e o laboratório deles não são o mesmo mundo.
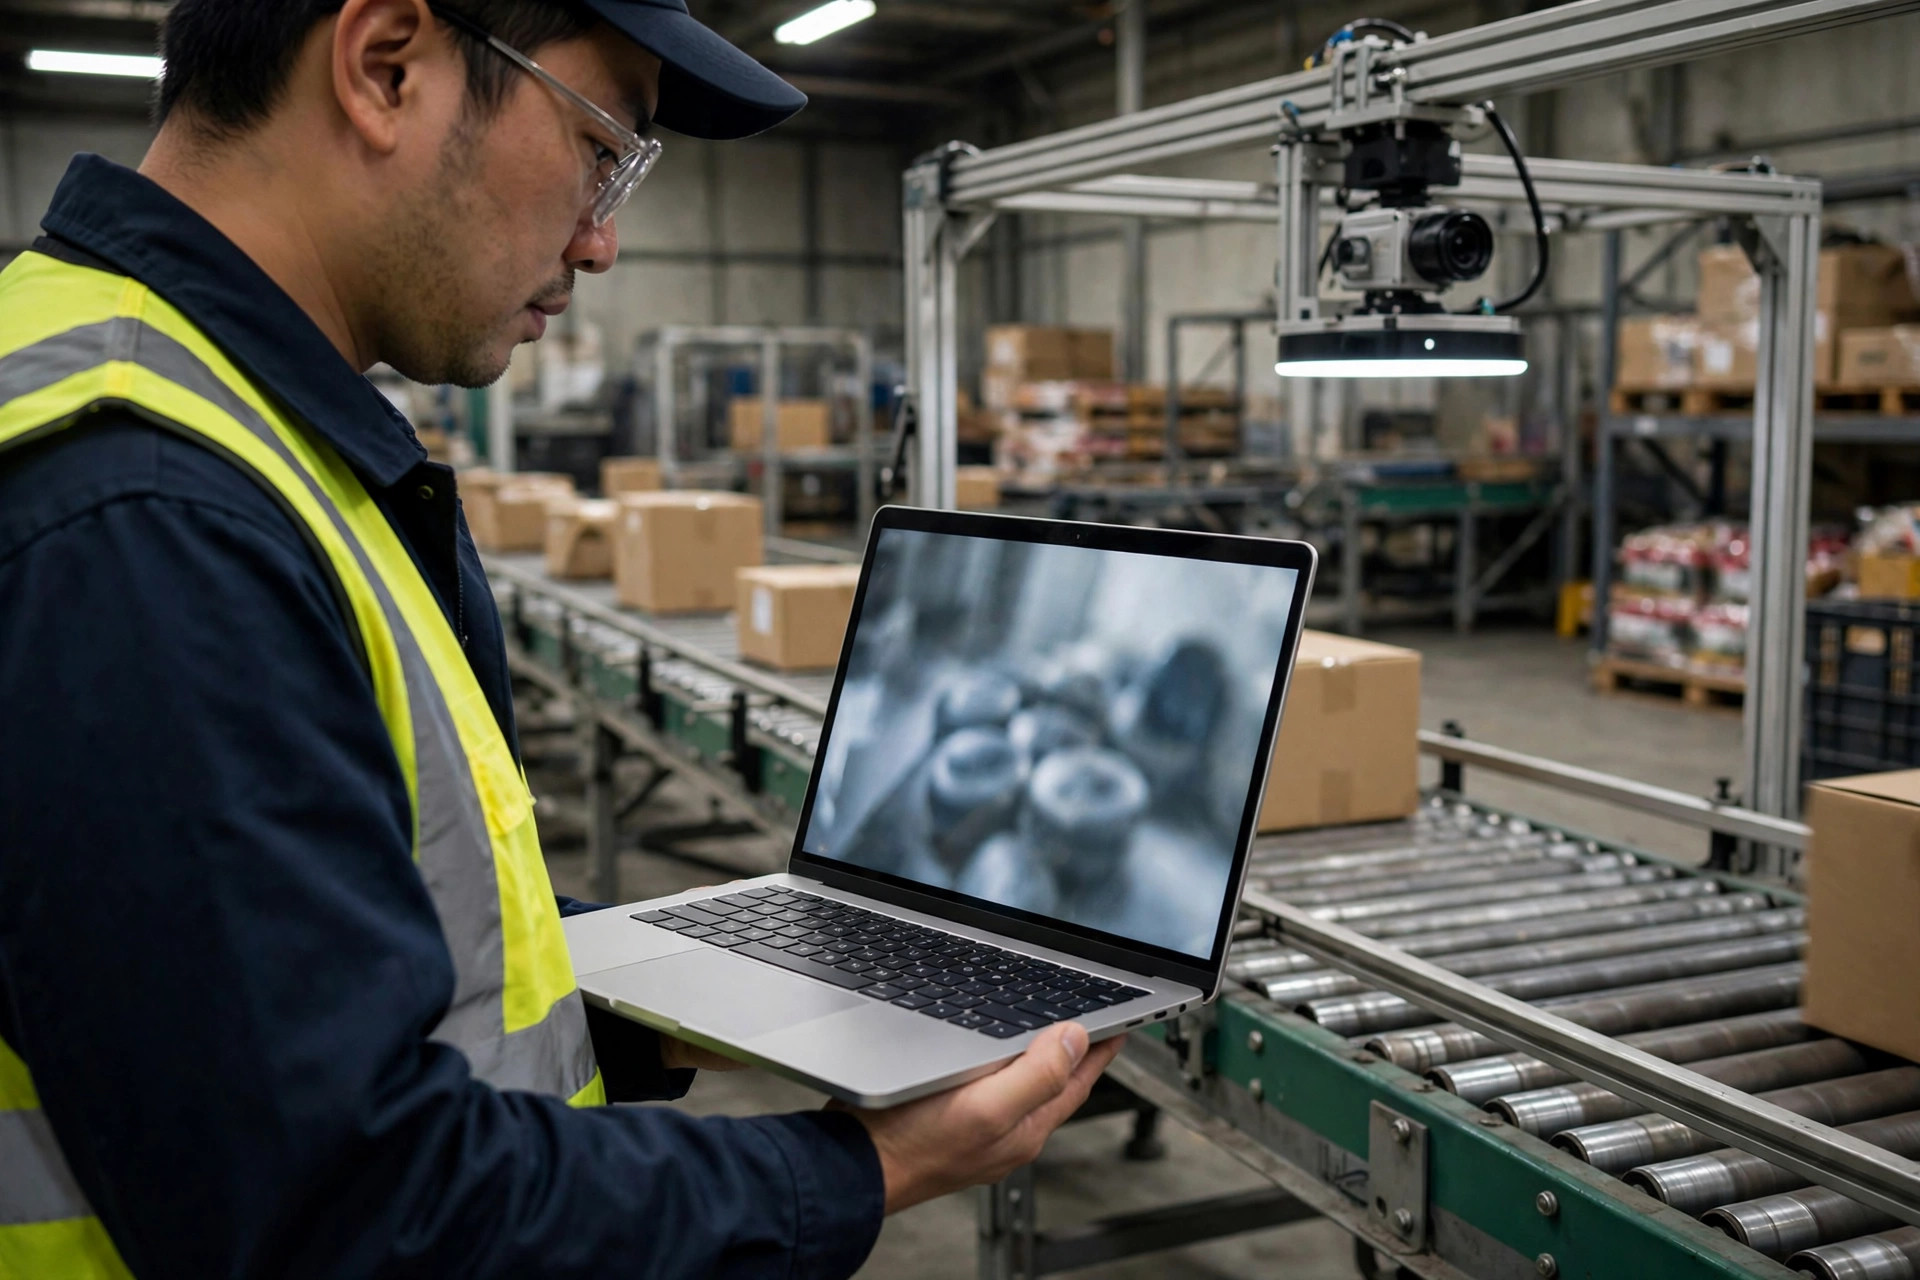
Como é o laboratório? Iluminação uniforme, fundos limpos, volumes bem apresentados, câmera parada. Como é o seu armazém? O reflexo da claraboia que muda da manhã para a tarde, metade dos tubos de uma luminária queimados, poeira em cada esteira, caixas amassadas no canto, fita refletindo sobre o código de barras, a mão de um operador bloqueando a câmera por um segundo. O algoritmo não mudou. O mundo mudou.
Então, para onde vão realmente esses sete pontos? Um por um.
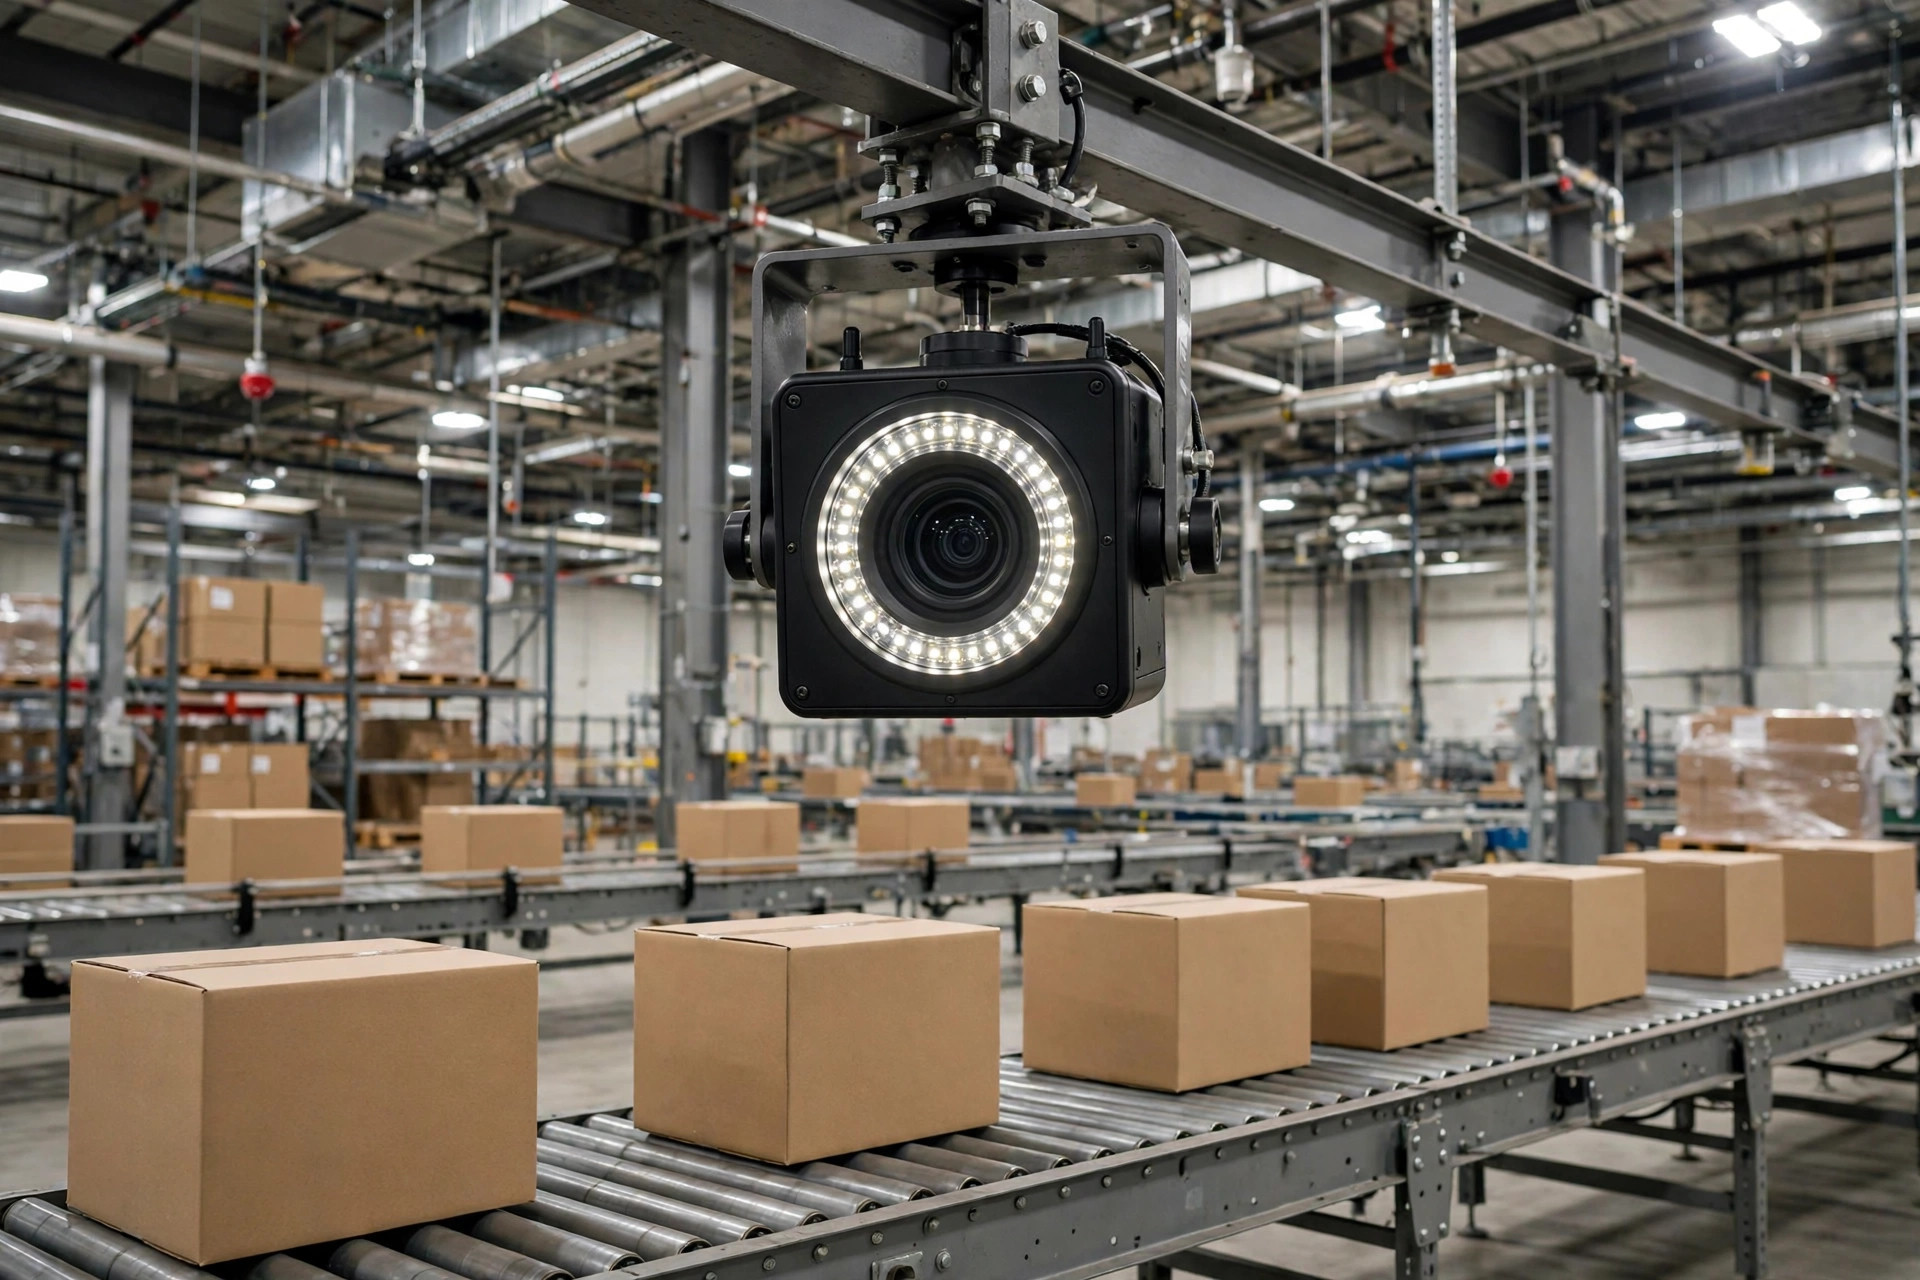
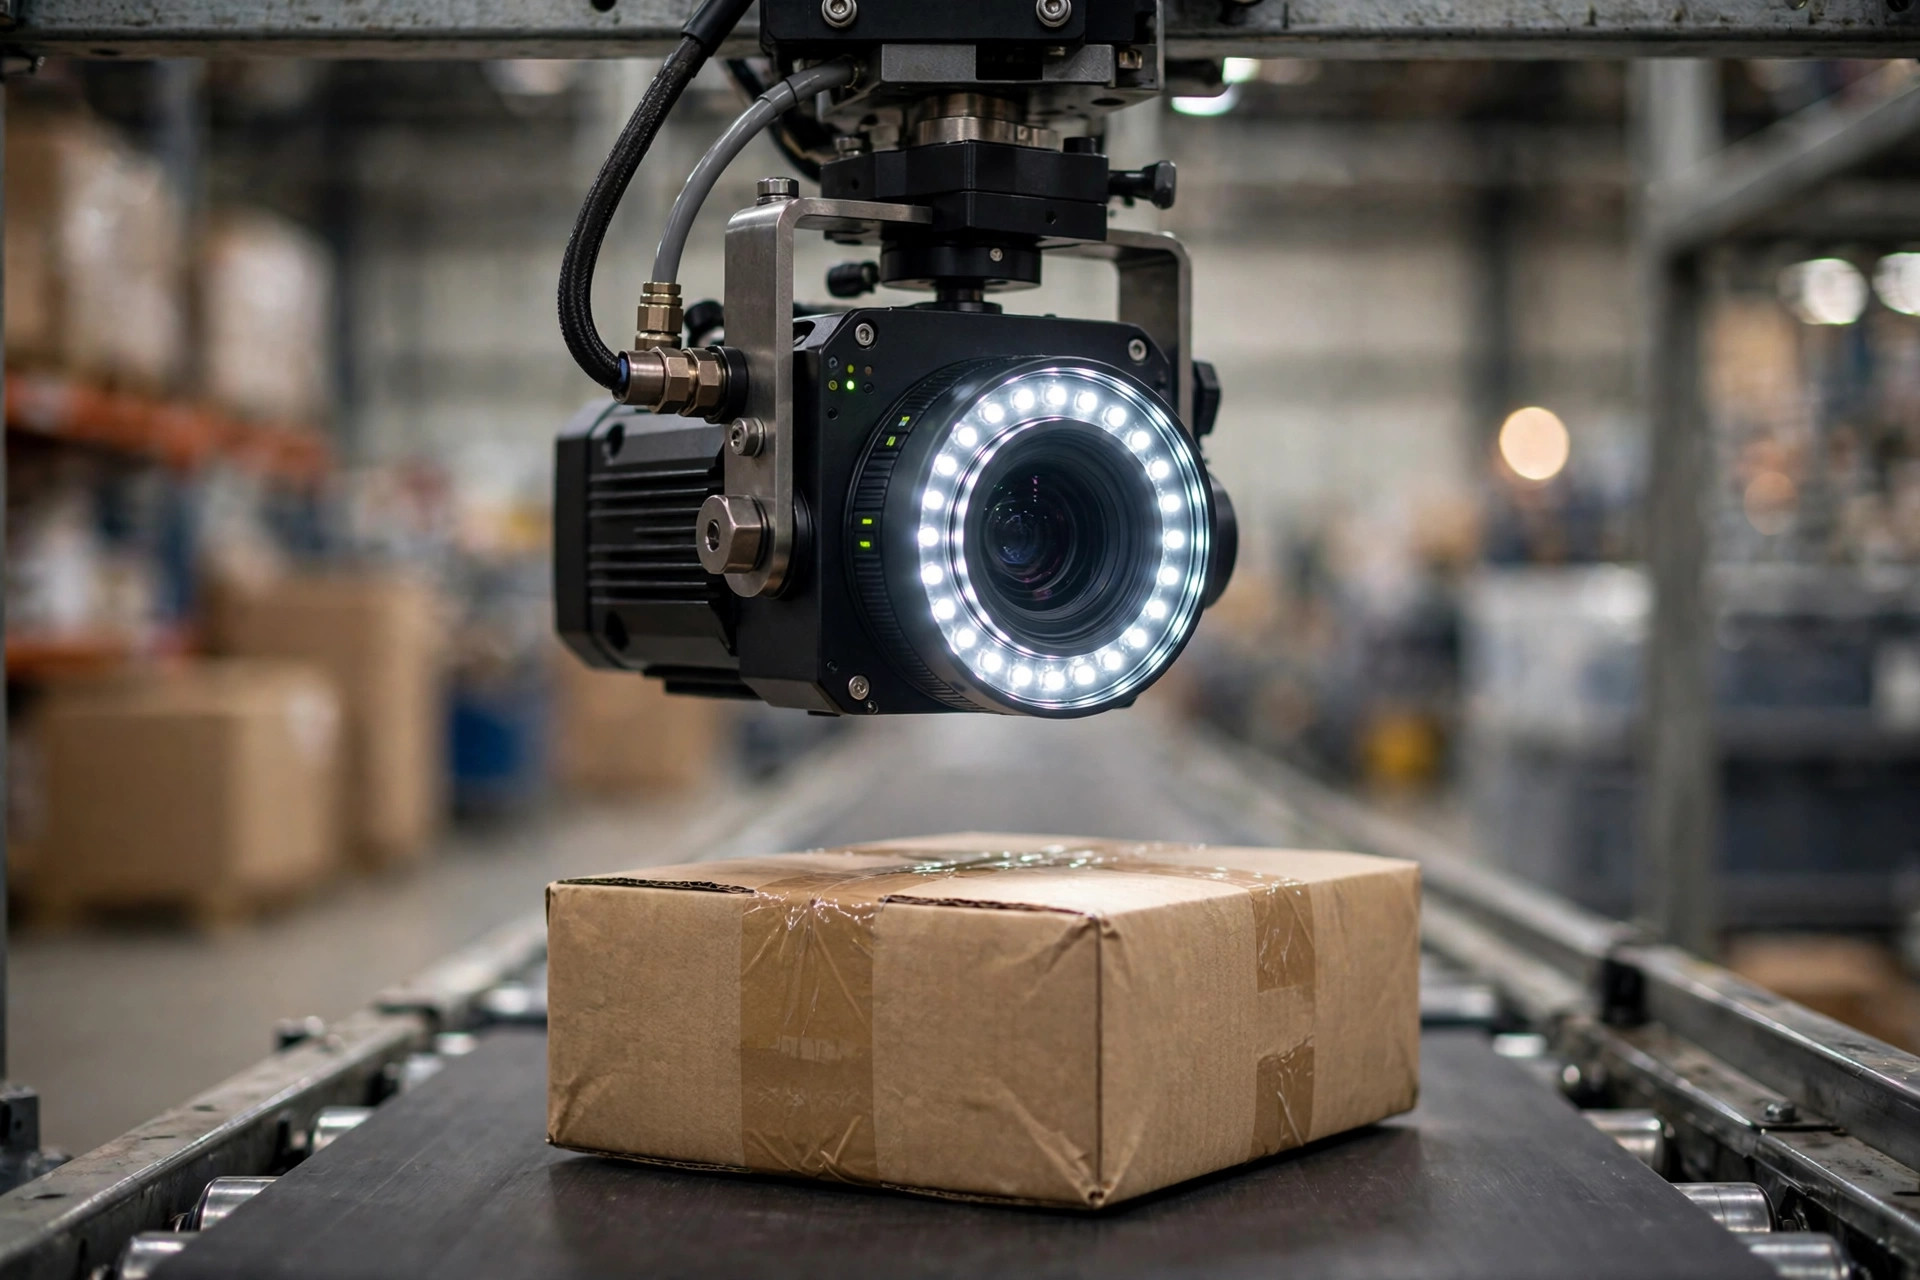
Por que a iluminação dói mais do que qualquer outra coisa? A luz do armazém é a variável mais irracional que existe. Uma esteira perto das janelas recebe luz frontal de manhã e contraluz à tarde; um dia nublado e um dia ensolarado são dois níveis de brilho totalmente diferentes. Sistemas de visão odeiam a deriva de iluminação — o modelo foi treinado com luz uniforme, e quando a luz muda, os recursos deixam de corresponder. A correção não é glamorosa, mas funciona: dê à câmera sua própria fonte de luz, uma luz anelar ou uma barra de luz, e tire a luz ambiente da equação. Não conte com o modelo para "se adaptar". Controlar a luz fisicamente supera qualquer algoritmo. Vi um projeto perder cinco pontos de precisão em dias chuvosos; depois que adicionaram uma luz anelar, a flutuação praticamente desapareceu.
A poeira é a variável que todo mundo esquece. É crônica — uma película se acumula na lente e na caixa de luz, e a qualidade da imagem se degrada um pouco a cada dia. A correção não é sofisticada: coloque a limpeza da lente na lista de verificação diária. Uma limpeza semanal rende mais do que uma melhoria no modelo.
E os próprios volumes? Os volumes do laboratório são novos, quadrados, etiquetas aplicadas retas. Volumes reais? Um canto amassado, uma etiqueta torta, fita refletindo sobre o código de barras, um saco de polietileno preto escondendo tudo. Deformação e reflexo são onde a IA de visão mais falha no armazém. Meu critério: para qualquer projeto de reconhecimento de volumes, pelo menos um terço dos dados de treinamento deveria ser de volumes feios — deformados, danificados, refletivos, manchados. Quanto mais feios, melhor. Um modelo treinado só com volumes bonitos vai falhar no primeiro dia. Ainda não vi exceção.
E a velocidade e a oclusão? A câmera do laboratório pode levar seu tempo; sua esteira não vai esperar. A velocidade da linha traz desfoque de movimento; um operador pegando um item traz oclusão. Não tente superar isso com algoritmos — projete ao redor. Dimensione a taxa de quadros e a exposição da câmera para a velocidade real da linha, e coloque um ponto de verificação humana nas estações críticas. Um sistema de visão no armazém é sempre uma ferramenta de produtividade, nunca um substituto para pessoas. Trate-o como substituto e você pagará a lição.
Por que os dados de treinamento têm que vir do chão real?
Este é o ponto que mais quero deixar claro. Projetos demais treinam com dados que o fornecedor filmou no próprio laboratório — ou "encenados" no seu armazém: escolhem uma hora bem iluminada, arrumam uns volumes limpos, capturam mil quadros, vão para casa e treinam. Isso produz um campeão de laboratório, e o primeiro dia nublado o expõe.
Faça direito: depois que as câmeras subirem, rode-as por duas semanas em modo só de coleta. Capture os três turnos, dias ensolarados e nublados, cada volume feio. Na rotulagem, priorize as amostras difíceis — as que o modelo errou ou pontuou com baixa confiança. Devolva-as ao treinamento, itere duas ou três rodadas, e é aí que a precisão no chão realmente sobe. Não há atalho. Pule esta etapa e 92% é o seu teto; nenhuma quantidade de ajuste de hiperparâmetros tira você dali.
Falsos positivos e falsos negativos custam o mesmo?
Antes de escrever os critérios de aceitação, esclareça uma coisa: o que custa mais — um falso positivo (sinalizar um volume bom) ou um falso negativo (deixar um ruim passar)? Em quase todos os cenários de armazém, o erro é mais caro. Um volume mal etiquetado que é enviado significa uma reclamação, uma devolução, um reenvio — dezenas de dólares no mínimo. Um falso alarme custa alguns segundos de revisão humana.
Portanto a aceitação não pode se apoiar em um único número de "precisão". Minha recomendação: pontue as taxas de falsos positivos e falsos negativos separadamente, e mantenha a taxa de erros em uma barra uma ordem de magnitude mais exigente. Ao assinar, não confie em um bonito "99% de precisão global". Faça três perguntas: qual foi a taxa de erros no seu conjunto de teste? O conjunto de teste era de dados reais do chão? Você vai colocar a composição do conjunto de teste no anexo do contrato? Essas três perguntas revelam rápido o verdadeiro nível do fornecedor.
O que acontece quando o sistema falha?
Por melhor que seja o sistema, projete para o dia em que ele não funcionar. Minhas três regras: tudo abaixo do limiar de confiança vai para um humano; se o sistema cair, um processo manual assume; nas estações críticas — verificação de saída, por exemplo — visão mais humano, cinto e suspensórios. Não ponha todos os ovos na mesma cesta. A IA compra eficiência, não imunidade. Quando algo dá errado, o chefe pergunta "como ninguém percebeu isso", não "qual era a precisão".
A lista de verificação de aceitação — percorra-a antes de assinar
- Composição do conjunto de teste: inclui amostras difíceis de condições reais do chão — deformadas, refletivas, ocluídas, com pouca luz — e em que proporção?
- Métricas separadas: quais são as taxas de falsos positivos e falsos negativos separadamente? A taxa de erros é mantida em uma barra mais exigente?
- Plano de iluminação: fonte de luz dedicada? Quem é responsável quando a luz ambiente muda?
- Velocidade compatível: a taxa de quadros e a exposição estão dimensionadas para a velocidade real da linha? A precisão se mantém em velocidade máxima?
- Ciclo de amostras difíceis: com que frequência as amostras mal classificadas retornam após o go-live? O ciclo de iteração está no SLA?
- Fluxo de contingência: qual é o limiar de confiança? Quem atende os casos abaixo do limiar? Qual é o plano manual quando o sistema está fora?
- Teste de aceitação: no seu armazém, com seus volumes, na sua velocidade de linha — rode um turno completo antes de assinar. Os números do laboratório não contam.
O 99% do laboratório é o teto do algoritmo. O 92% do chão é onde a engenharia começa. A diferença entre eles se fecha não com um algoritmo melhor, mas com uma engenharia melhor. Lembre-se disso quando assinar, e isso vai economizar dinheiro de verdade.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.