Imagine um armazém de devoluções com 20,000 SKUs. O manual tradicional de visão computacional diz: fotografe 500 imagens de treinamento por SKU. Isso dá 10 milhões de imagens. Vou poupar você do trabalho de fazer essa conta: esse caminho não leva a lugar nenhum.
Ultimamente, cada vez mais operadores têm me perguntado sobre few-shot learning, e o discurso é sempre o mesmo: "Temos SKUs demais para o treinamento tradicional. Dizem que o few-shot só precisa de um punhado de imagens por produto, essa é a nossa saída?" Minha resposta também é sempre a mesma: sim, é uma saída, para cerca de metade dos seus casos de uso. Para a outra metade, ela nem consegue passar pela porta. Hoje vou traçar essa linha.
Few-shot, explicado de uma vez
O deep learning tradicional memoriza. Ele precisa aprender como cada SKU se parece do zero, o que significa alimentá-lo com centenas ou milhares de imagens por produto. O few-shot learning reconhece semelhanças de família. O modelo base já viu dezenas de milhões de imagens e aprendeu a gramática geral de forma, cor e textura. Você mostra de 3 a 5 fotos de cada SKU, e ele identifica os produtos por similaridade, mais como reconhecer um primo do que como recitar um livro didático.
Isso não é ciência nova. Pesquisadores vêm trabalhando nisso há anos: o conjunto de dados aberto SKU-110K contém 11,743 imagens, mais de 1.7 milhão de caixas anotadas e mais de 110,000 SKUs únicos (CVPR 2019), e um artigo de 2024 levou a classificação one-shot de SKUs a partir de uma única imagem protótipo. O que mudou é que os modelos base ficaram fortes o suficiente nos últimos dois anos para tornar isso implantável. A tecnologia estava pronta; o que faltava era os operadores saberem onde ela pertence.
Onde o few-shot é bom o suficiente
Meu teste é simples. Duas perguntas: quanta margem de erro você tem, e quão rápido seu catálogo de SKUs muda?
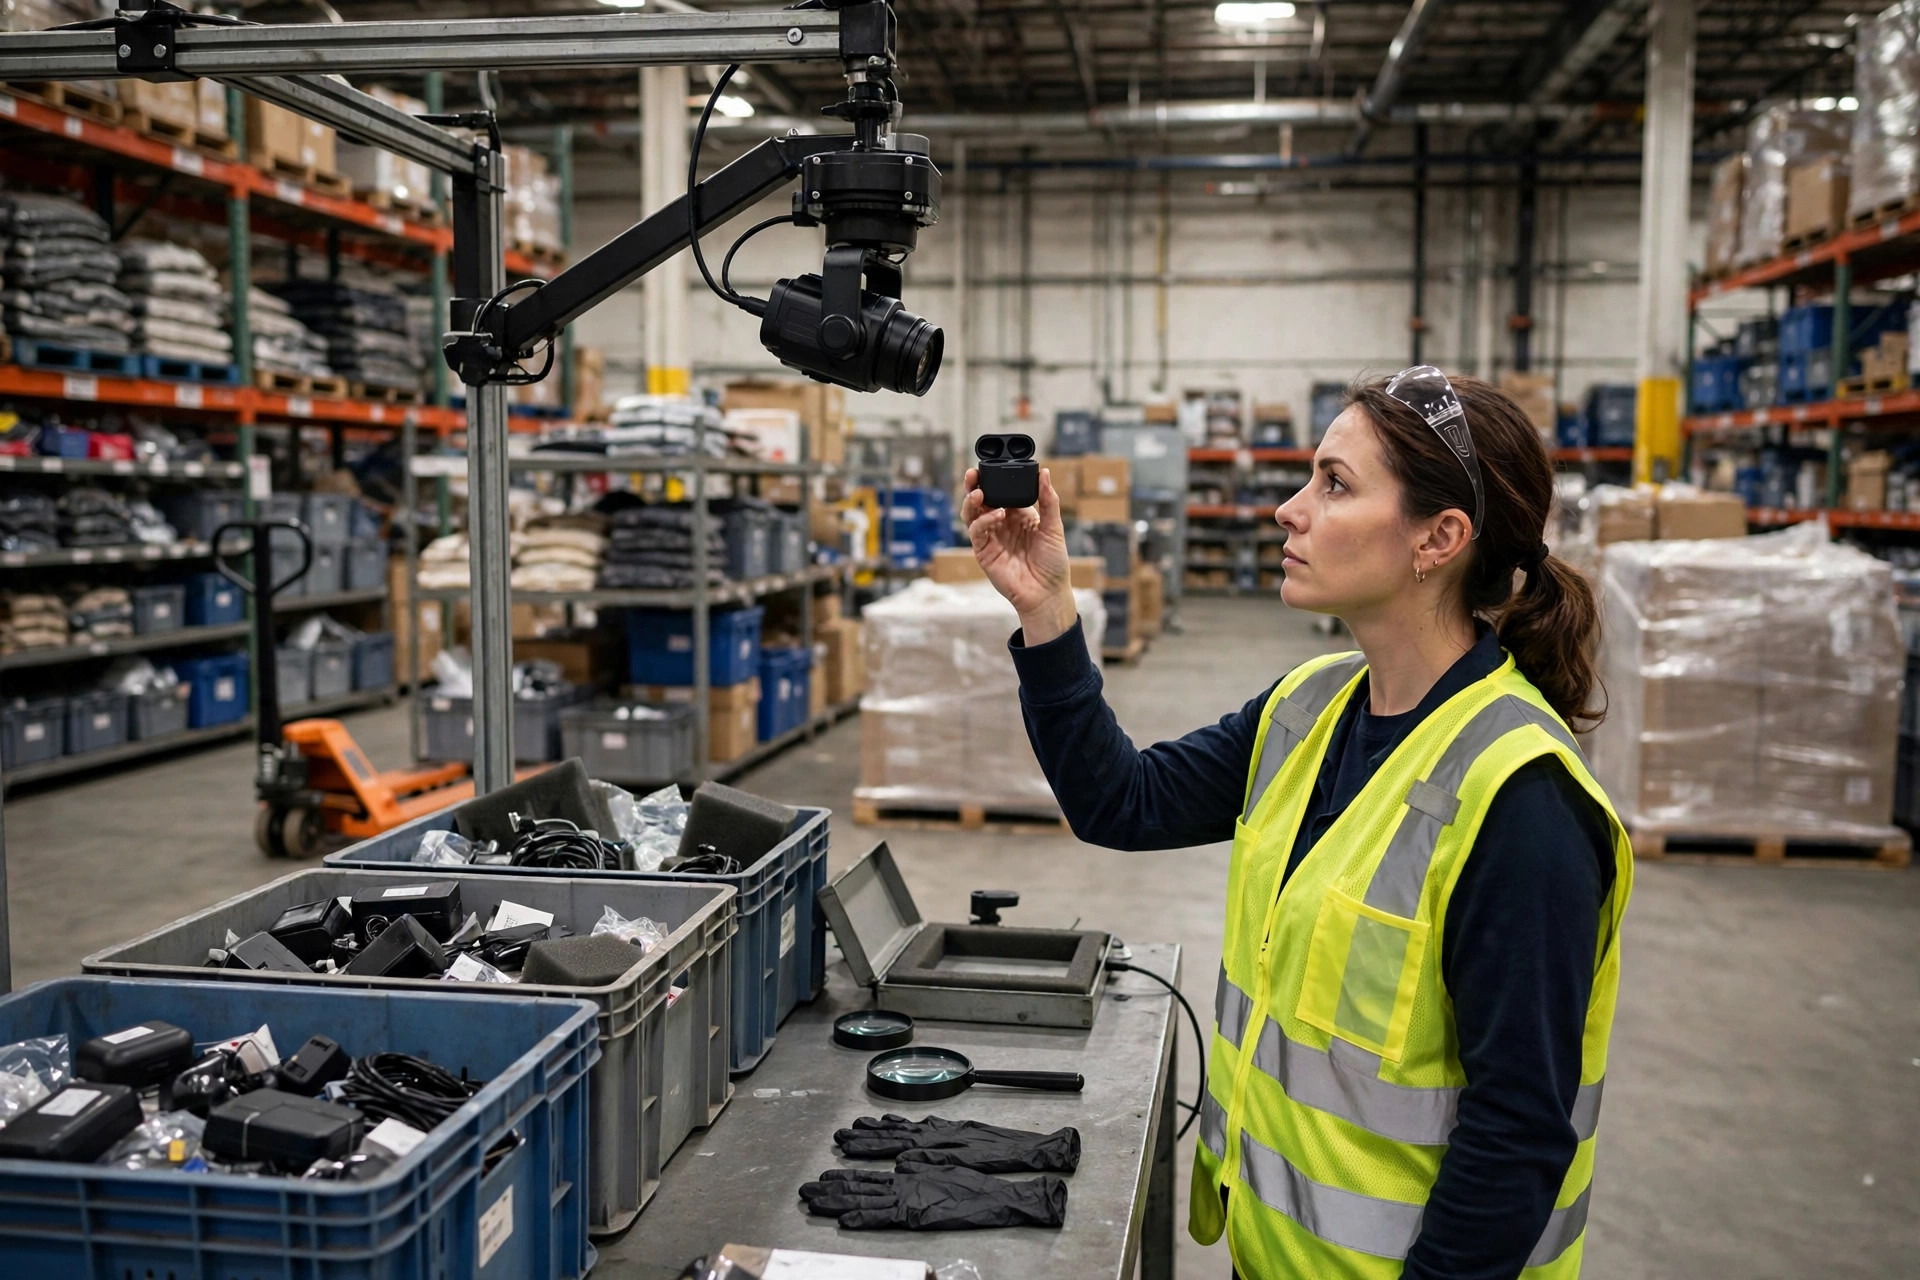
A inspeção de devoluções é o melhor caso que já vi. Produtos devolvidos são uma mistura long-tail bagunçada: muitos SKUs vendem algumas dezenas de unidades por ano, e você nunca vai reunir centenas de imagens de treinamento para eles. Um inspetor segura o item diante de uma câmera, o sistema identifica o SKU e mostra o registro do produto, e o inspetor dá uma olhada para confirmar. Errou um? O humano corrige, a imagem volta como uma nova amostra, e o sistema fica mais afiado na próxima vez.
O outro caso é a triagem visual como segunda opinião. Pense em um armazém transfronteiriço cheio de mercadorias a granel sem código de barras, ou caixas cujas etiquetas foram coladas tortas e não escaneiam. A visão few-shot oferece um candidato; uma pessoa ou uma leitura de código de barras toma a decisão final. Repare na palavra "candidato": ela sugere, não decide.
O que essas cenas têm em comum: baixa velocidade, baixo volume, e uma rede de segurança humana por trás do modelo. Quanto mais SKUs você tem, menos amostras cada um recebe, mais longa a cauda, maior a vantagem do few-shot. Nesses cenários, a abordagem tradicional não é apenas cara, é inviável. Ninguém vai fotografar 500 imagens para um SKU de cauda longa que movimenta 30 unidades por ano.
Onde você deve ficar longe
Primeiro, o óbvio: triagem de alta velocidade. Um sorter empurrando centenas de caixas por minuto exige precisão de reconhecimento extremamente alta (valide com seus próprios dados), e você não vai conseguir isso de um modelo que viu três fotos de cada SKU. A abordagem honesta para linhas de alta velocidade é o treinamento rotulado em larga escala, ou pular a visão inteiramente em favor de códigos de barras combinados com sensores de peso e dimensão. Quanto mais rápida a linha, menos espaço o few-shot tem para respirar. Isso é física, não um problema de ajuste.
Segunda armadilha: SKUs quase idênticos. Dois xampus da mesma linha de marca, mesma embalagem, diferindo apenas no tamanho da garrafa impresso em letras pequenas, é exatamente onde o reconhecimento por semelhança de família é mais fraco. Já vi uma equipe queimar meses aqui: o modelo identificava errado os produtos com total confiança, os humanos tinham que rechecar cada item, e a linha acabou mais lenta que o trabalho puramente manual, mais o custo do hardware.
Terceiro: qualquer lugar onde as condições de imagem não ficam paradas. O chão do armazém não é um laboratório. Uma câmera sobre um transportador, uma luz piscando, uma caixa inclinada, e a precisão despenca. Com apenas algumas amostras por SKU, uma foto borrada pode envenenar um quinto dos seus dados de treinamento. Ironicamente, o few-shot exige disciplina de captura mais rígida que o treinamento completo, o que nos leva à implantação.
Implantando: quatro passos
Passo um: escolha um modelo base; não treine do zero. Modelos base de visão abertos e comerciais já são todos capazes o suficiente. A verdadeira pergunta é qual deles performa em imagens de produto, não qual lidera os benchmarks genéricos. Passe suas próprias mercadorias por ele durante duas semanas e meça você mesmo a precisão top-1. Não confie no deck do fornecedor. Duas semanas de testes honestos são mais baratas que seis meses de retrabalho.
Passo dois: trave uma especificação de captura. Esta é a parte mais subestimada de todo o projeto. Posição de câmera fixa, iluminação fixa, fundo fixo, de 3 a 5 ângulos por SKU. Cada imagem tem que contar. Imprima a especificação, lamine, cole no banco de inspeção para que sobreviva às trocas de turno e aos novatos.
Passo três: construa o ciclo de casos difíceis. Tudo que o modelo erra ou sinaliza com baixa confiança entra numa fila de revisão; uma vez que um humano confirma o rótulo correto, a imagem volta como uma nova amostra. Quando esse ciclo está rodando, o modelo compõe: fica melhor quanto mais você o usa. Essa é a maior vantagem operacional do few-shot sobre o treinamento tradicional: adicionar um novo SKU significa tirar algumas fotos e entrar no ar em minutos, não reunir um conjunto de dados e retreinar.
Passo quatro: mantenha um humano no ciclo, permanentemente. Tudo abaixo do seu limiar de confiança vai para revisão manual. Este item não é opcional. Em um armazém, o melhor assento da IA é sempre o do copiloto; o volante fica com as pessoas.
As contas: três abordagens lado a lado
Primeiro, o treinamento totalmente rotulado. Guias de preços do setor colocam a anotação básica de classificação de imagens em torno de $0.03 a $0.10 por imagem (segundo o guia de custos de rotulagem da basic.ai). Parece barato, até você contar a coleta: fotografar, organizar, QA, controle de versão, tudo mão de obra humana. 20,000 SKUs vezes 500 imagens são 10 milhões de imagens. Essa conta de mão de obra esmaga qualquer operação de médio porte. O treinamento completo só faz sentido onde os SKUs são poucos, estáveis, e as exigências de precisão são extremas.
A rota few-shot: de 3 a 5 imagens por SKU transformam 20,000 SKUs em 60,000 a 100,000 imagens, duas ordens de magnitude a menos. O custo de anotação basicamente desaparece, já que a rotulagem acontece naturalmente no momento da captura. O gasto real é o trabalho inicial: validar um modelo base e fazer cumprir a especificação de captura. Investimento único, retornos compostos.
E a terceira rota que as pessoas esquecem: códigos de barras e regras. Se seus produtos carregam códigos de barras adequados, simplesmente escaneie-os: a visão é puro overhead. Meu conselho permanente aos clientes: se um scanner resolve, não construa visão; se uma regra resolve, não construa aprendizado. A IA não conserta operações. Se seu cadastro de SKUs é uma bagunça e as etiquetas vão tortas, conserte o processo antes de falar de IA. Essa ordem não é negociável.
Por que devoluções merecem sua própria seção
A NRF e a Happy Returns projetam as devoluções do varejo americano em 2024 em $890 billion, 16.9% das vendas anuais dos varejistas. A área de devoluções é o canto mais bagunçado de qualquer armazém: o mix de SKUs mais selvagem, a mão de obra mais cara, o processo menos padronizado. Os inspetores precisam identificar o item, julgar sua condição, e decidir se ele volta ao estoque ou é baixado. Desses três trabalhos, a identificação é onde a visão few-shot ganha seu lugar, porque os sortimentos de devoluções são long-tail por natureza.
Um aviso antes de você se animar: identificar o SKU é só metade do trabalho de inspeção. Julgar a condição, novo, levemente usado, danificado, ainda está além do que os modelos few-shot atuais fazem de forma confiável, diga o que disser o fornecedor. Faça primeiro o reconhecimento de SKU, deixe a classificação de condição para os humanos, e avance em duas fases. Não tente engolir tudo de uma vez.
Uma coisa que você pode fazer amanhã
Se você tem um banco de inspeção de devoluções, aqui vai um experimento de uma tarde: pegue seus 50 SKUs devolvidos mais comuns, fotografe 5 ângulos de cada um, e passe-os por um modelo base de visão aberto como teste de recuperação por similaridade. Verifique a precisão top-1. Custa quase nada, leva uma tarde, e vai te dizer algo que nenhum discurso de fornecedor pode: se esse caminho realmente leva a algum lugar para a sua operação. Deixe os dados falarem.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.