Um sistema de otimização de rotas de picking que promete cortar a distância percorrida em um quinto entra em operação, e três meses depois os separadores continuam percorrendo suas rotas antigas. Isso não é um problema de pessoas. É uma lacuna entre duas definições diferentes de "ótimo" — a do algoritmo e a do chão de fábrica — e a tecnologia, madura como já é, nunca foi a parte que trava. A parte que trava é a adoção.
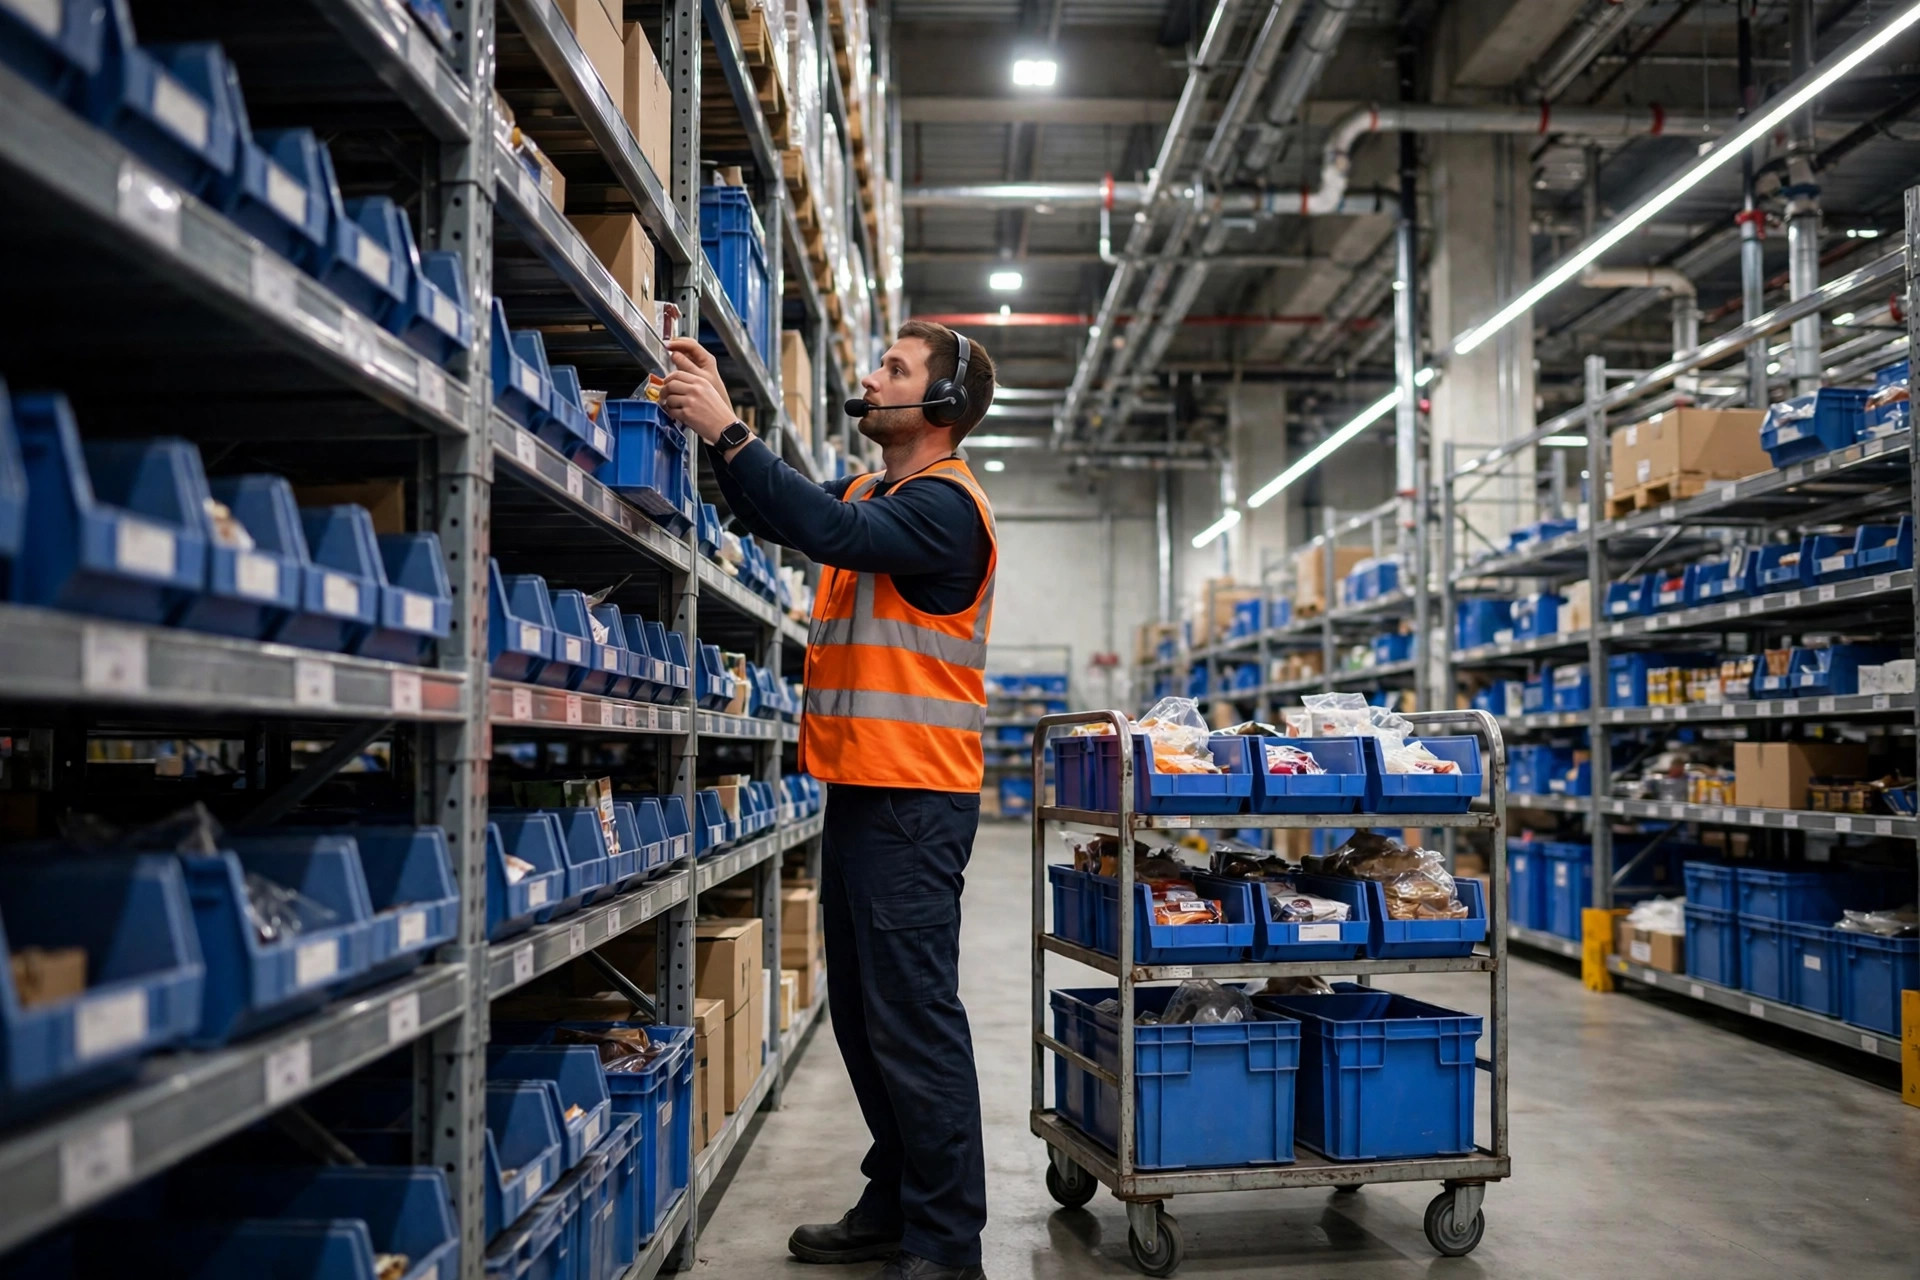
Consideremos primeiro o fenômeno. Em 2024, um armazém de e-commerce de 30,000 metros quadrados no leste da China implantou um sistema de otimização de rotas de picking com IA que calculava as sequências de picking em tempo real conforme o perfil dos pedidos, com uma redução teórica de 15–20% na distância percorrida por separador. Os números do painel no primeiro mês pareciam lindos. O supervisor de planta, porém, notou outra coisa: os separadores descumpriam em silêncio — concordavam com o sistema enquanto seus pés seguiam as rotas antigas. Três meses depois, uma pesquisa anônima revelou que mais da metade admitia desviar-se "frequentemente" da sequência recomendada.
O mesmo roteiro se repetiu na primeira metade de 2025, desta vez em um centro de distribuição regional de uma rede varejista que testava o roteamento dinâmico com IA. O sistema recomendava um atalho pela área de staging que eliminaria um longo desvio. Os separadores o recusaram em bloco e percorreram o caminho mais longo. O motivo era prosaico: a área de staging estava perpetuamente entulhada de mercadoria de entrada aguardando endereçamento, e um carrinho simplesmente não passava. O algoritmo lia uma planta baixa; os separadores liam a realidade.
Os dados sugerem que não se trata de uma anedota isolada. Na minha revisão de cerca de uma dúzia de projetos de roteamento inteligente relatados publicamente em 2024–2025, quase todos os casos que divulgaram resultados reais mencionavam alguma versão de "desvio na execução de linha de frente". As reportagens do setor do mesmo período continuam citando um número amplamente conhecido: o picking costuma responder por cerca de metade do custo de mão de obra de um armazém, que é precisamente por que é o segmento que os fornecedores de automação mais querem conquistar — e o mais difícil de conquistar. A oferta de tecnologia está acelerando: algoritmos de planejamento de rotas, gêmeos digitais e posicionamento interno amadureceram nos últimos anos. Mas a curva de adoção do lado da demanda corre visivelmente mais plana do que sugerem as narrativas dos fornecedores.
Por que persiste essa lacuna de "preciso, mas não usado"? Eu a atribuiria a três camadas de causas, cada uma mais próxima da raiz que a anterior.
A primeira camada é o desalinhamento de incentivos, e é a mais comumente negligenciada. Em muitos armazéns, os separadores recebem por peça. A função objetivo do separador é unidades separadas por hora; a função objetivo da IA é distância total minimizada. Esses dois objetivos divergem com frequência: fazer um circuito um pouco mais longo que permite ao separador pegar dois itens a mais em uma passada e pular uma curva é um negócio melhor para o separador, ainda que o sistema o registre como desvio. Quando o algoritmo e o humano otimizam contra KPIs diferentes, ignorar o algoritmo é um comportamento racional, não preguiça.
A segunda camada é o déficit de confiança. O algoritmo não enxerga as condições transitórias da planta: onde estão empilhadas as pontas de gôndola promocionais de hoje, qual corredor está escorregadio e deve ser evitado, qual doca está bloqueada por mercadoria aguardando endereçamento. Nada disso vive no sistema; tudo isso vive na cabeça dos separadores. Basta um "segui o sistema e dei de cara com um beco sem saída" para rachar a confiança — e a confiança, uma vez rachada, leva dezenas de sucessos para se reconstruir. As autópsias de implantações fracassadas continuam convergindo para o mesmo detalhe ausente: o sistema não dava aos separadores nenhum canal para relatar exceções de campo. Quando uma rota é intransitável, a escolha é forçar a passagem ou desviar em silêncio, e com o tempo, todos desviam em silêncio.
A terceira camada, e a fundamental, é a qualidade dos dados. A otimização de rotas de picking é, em essência, um sistema de "lixo entra, lixo sai". Se os dados mestres de endereços estiverem errados — o sistema diz que o SKU A está em B-03 enquanto fisicamente está em C-11 — então até uma rota matematicamente perfeita é o caminho mais curto no mapa errado. Em vários projetos que acompanhei, resultados ruins de roteamento, ao escavar uma camada abaixo, quase sempre expunham problemas de dados mestres: variações de inventário cíclico persistentemente acima de alguns pontos percentuais, mudanças de endereço nunca registradas, slotting de SKUs novos feito por conhecimento tribal. Algoritmos não consertam problemas de dados. Só os amplificam.
Isso leva a uma conclusão contraintuitiva que vale a pena declarar claramente: o caminho mais curto não é o picking mais rápido, e certamente não é o caminho que um separador percorrerá de bom grado. Algoritmos otimizam a distância euclidiana; separadores otimizam o gasto de energia e o conforto ergonômico — uma curva a menos, uma subida a menos, evitar um corredor congestionado. Fatores que têm peso quase zero na fórmula de distância têm peso pesado na decisão humana. Um motor de roteamento fluente em geometria, mas analfabeto em ergonomia, soa, para um separador, como teoria divorciada da prática — e a teoria é votada contra com os pés.
Então, o que uma equipe deve responder antes de lançar um projeto de otimização de rotas de picking que ela realmente queira que funcione? A análise acima sugere três perguntas obrigatórias. Primeira, qual é a precisão real dos seus dados mestres de endereços — as variações de inventário cíclico foram reduzidas a uma faixa aceitável? Não fale de algoritmos sobre fundações trêmulas. Segunda, o esquema de remuneração dos separadores concorda com o objetivo do sistema, ou os dois KPIs estão brigando? KPIs desalinhados garantem execução com desconto. Terceira, o sistema fecha o ciclo sobre as exceções de campo — um separador pode sinalizar "esta rota está bloqueada" com um toque e o algoritmo aprender com isso? Um sistema inteligente sem canal de feedback é um sistema de malha aberta, e sistemas de malha aberta derivam em ambientes complexos. Isso não é uma hipótese; é teoria de controle.
Olhando para 2026–2028, minha leitura da trajetória tecnológica é que o setor migrará do cálculo da rota mais curta para o cálculo da mais aceitável. Três observações sustentam isso: primeira, fornecedores líderes começaram a comercializar roteamento "human-aware" que modela fatores ergonômicos explicitamente na função objetivo; segunda, a disseminação de wearables e posicionamento interno está dando aos sistemas seus primeiros conjuntos de dados reais sobre como os separadores realmente andam — os algoritmos finalmente podem aprender as rotas reveladas em vez das prescritas; terceira, os gêmeos digitais estão tornando os estados transitórios da planta legíveis por máquina, de modo que uma área de staging congestionada talvez não precise mais viver apenas na memória de alguém. O cronograma, é preciso admitir, depende dos custos do hardware de posicionamento interno — se não caírem em três anos, a era da "rota mais aceitável" pode chegar mais tarde do que o esperado.
Fecho com uma pergunta aberta em vez de um veredito. Quando os algoritmos finalmente aprenderem a pensar como separadores veteranos — contornando o congestionamento, favorecendo o ergonômico, conservando energia — a próxima pergunta pode ser se o roteamento de picking precisa de uma única resposta "ótima". Talvez o sistema do futuro ofereça várias rotas com diferentes trade-offs e devolva a escolha final à pessoa na planta. A melhor relação entre tecnologia e pessoas, me parece, nunca foi sobre quem manda em quem.
Por Dr. Chen, pesquisador da cadeia de suprimentos
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.