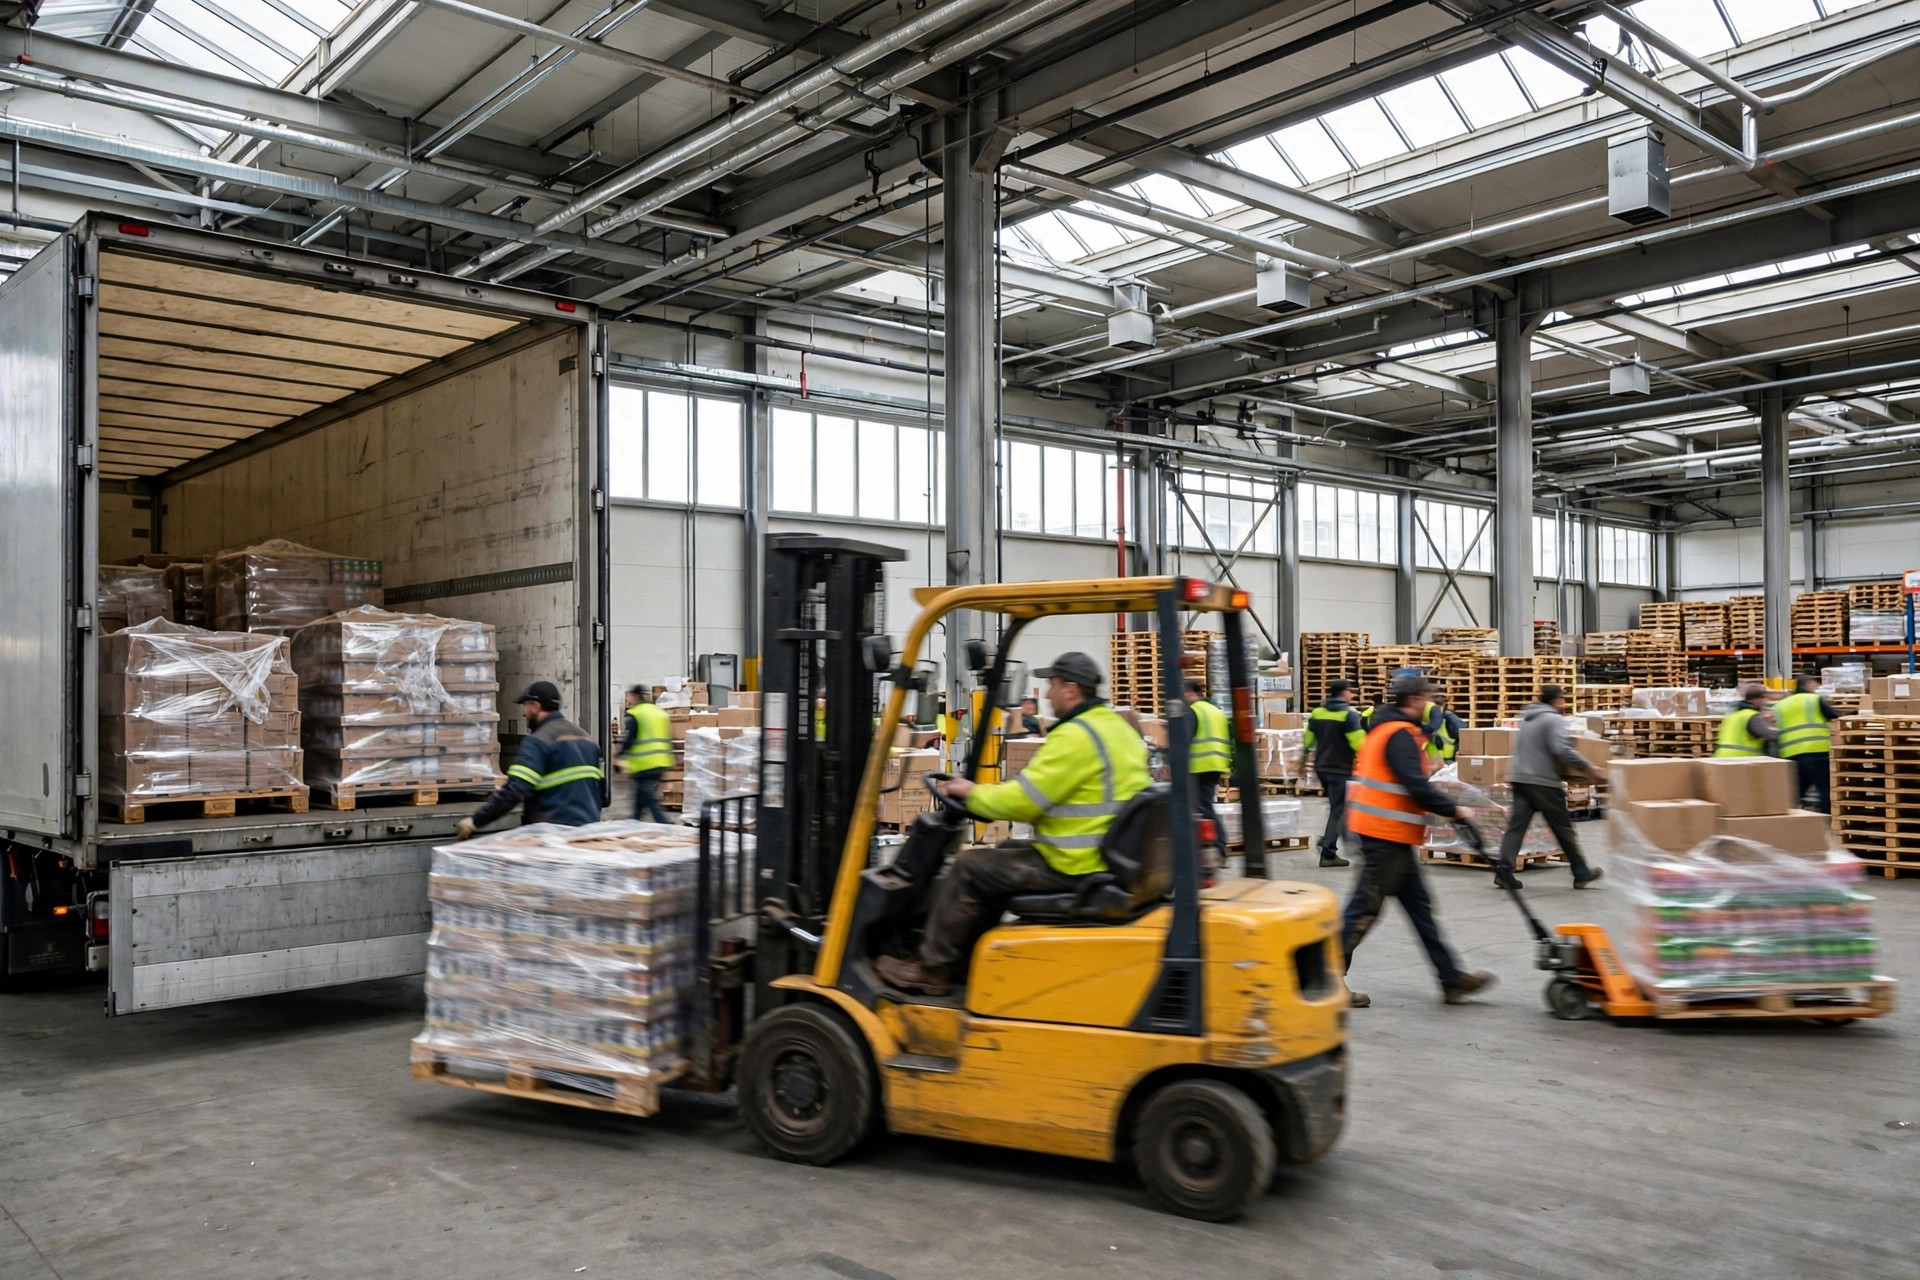
2024 年黑五当周,美国中西部一家 3PL 仓的复盘会上,运营总监说了句让我印象很深的话:"我们是被自己的波次计划打败的。"那一周的日均订单量是平时的三倍还多,WES 照惯例每 90 分钟释放一个波次,六个波次排得满满当当——但第三、四个波次里,拣选员在 A 区通道口排起了长队,集货墙前堆满了等复核的周转箱。事后复盘数据才发现,行走距离只比平时多了约一成,真正的杀手是波次之间的任务重叠与下游拥堵。这正是 AI 波次优化(AI wave optimization)这几年被反复提起的原因:它要解的从来不只是"怎么分单",而是一组在约束条件下相互牵制的决策。
拣选成本,决定了波次优化的权重
根据 2025 年发表在《Applied Sciences》上的一项仓储案例研究,订单拣选占仓库总运营成本的 50%~75%,占人工总工时的 55% 左右。这个数字在行业里被引用过很多次,口径虽有差异,但结论一致:拣选是仓库里最烧钱的环节,而波次划分直接决定了拣选任务的结构——谁在什么时候去哪个区、一次带多少单、走多远的路。
换句话说,波次优化不是"锦上添花"的算法玩具,它动的是仓库成本结构里最大的一块。这也是为什么过去三年,几乎所有主流 WES 厂商都把"智能分波"写进了产品路线图。但路线图是一回事,落地效果是另一回事,中间隔着的,是约束条件的复杂度。
AI 波次优化的算法逻辑:三代演进
要理解 AI 在这件事上到底在做什么,得先把"分波次"还原成一个优化问题。输入是待履行的订单池,输出是若干个波次(每个波次 = 一组订单 + 一个释放时间点),目标函数通常是在截单时间前完成全部订单的同时最小化总拣选行走距离或总人工耗时,而约束条件至少包括四类:截单时间与承运商取件窗口、库位分布与热区拥堵、可用人力与技能结构、设备节拍(输送线、分拣机、播种墙的单位时间处理能力)。
第一代是规则引擎:按截单时间硬切,按承运商、订单类型、优先级分堆。这是 2015 年之前绝大多数 WMS 的做法,本质上是人工经验的代码化,优点是可解释、可控,缺点是面对订单结构变化毫无弹性。
第二代是启发式优化与聚类:把库位热区相近的订单聚成一类(思路接近聚类算法),用旅行商问题的近似解法规划拣选路径,再用模拟退火或遗传算法在"波次大小"和"释放节奏"之间寻找近似最优。这是当前商用 WES 的主流做法,也是市面上大多数"AI 分波"产品的真实技术底座——名字里有 AI,内核多半是运筹学。
第三代是机器学习与强化学习:用历史数据预测订单到达节奏和单均拣选时长,再用强化学习动态决定"现在放波还是再等十分钟"。论文很多,落地很少,原因后面会讲。
一个反常识的判断:分单不是杠杆,放波时机才是
行业里谈 AI 波次优化,十篇有九篇在讲"怎么把单分得更准"——聚类更细、路径更短。但我在 2024 年底调研的一家美国中西部 3PL 仓(约 5 万平方米,主做家居品类)的经历,指向了另一个结论。
这家仓 2023 年旺季用的是固定 90 分钟波次,2024 年引入了一套带预测能力的分波模块。效果最显著的改进并不是"单分得更准",而是系统开始动态回答"这一波什么时候放":当预测到未来 30 分钟还会有大批量同承运商订单到达时,系统会主动推迟放波,把本可以分两次拣的单并成一次。据受访的运营负责人介绍,旺季期间拣选员人均行走距离下降了约两成,而其中超过一半的收益来自放波时机的调整,而非分单逻辑本身。
背后的逻辑并不复杂:波次划分本质上是一个时间维度上的决策,订单是陆续到达的,任何"分单"优化都建立在"等不等下一批单"这个先决判断之上。等,有并单收益,但压缩了履约时间;不等,时效安全,但可能多跑一趟。AI 的价值在于把这个 trade-off 从"凭感觉"变成"可计算"——基于到达预测和剩余产能,算出期望成本最低的放波点。
另一个 trade-off:拣得越快,堵得越狠
还有一个更扎心的现实。华东一家跨境电商仓在 2024 年旺季前把并单策略调得很激进:单波次订单量翻倍,拣选环节的人均效率确实上去了。但两周后,瓶颈转移到了下游——播种墙的复核工位前排起了 40 多分钟的队,集货区周转箱堆到需要临时借道。最后他们被迫回退到"松波次 + 预分播"的组合,整体出库时效反而比激进并单时更好。
这个案例说明了一个经常被算法厂商回避的事实:波次优化的目标函数如果只写"最小化拣选行走距离",解出来的方案很可能在系统层面是次优的。真正的约束在下游——复核、打包、集货、装车的能力上限。AI 分波模型必须把下游节拍作为硬约束吃进去,否则拣选环节省下的每一分钟,都会在集货区加倍还回去。这也是第二代算法在落地时最常见的翻车点:模型在仿真里很漂亮,一上生产就被现实的排队论教育。
落地之前:先看你的仓配不配
不是每个仓都值得上 AI 波次优化。下面这个框架,是我综合多家厂商的落地案例和公开研究报告后整理的,数字均为量级估计,仅供参考:
| 仓库类型 | 日均单量量级 | 建议策略 | 预期收益量级 | 数据门槛 |
|---|---|---|---|---|
| 微型仓(单区、SKU 不到 5000) | 2000 单以下 | 固定波次 + 人工经验 | AI 投入大概率为负收益 | 无需 |
| 中型单区仓 | 2000~10000 单 | 规则引擎 + 简单聚类 | 行走距离下降 5%~15% | 订单历史 6 个月以上 |
| 大型多区仓 | 10000 单以上 | 启发式优化 + 动态放波 | 行走距离下降 15%~25% | 订单、库位、人力三类数据齐备 |
| 自动化仓(含 AMR/分拣机) | 不限 | 与设备调度联合优化 | 系统级吞吐提升 | 实时设备数据流 |
需要特别说明的是第一行:对日均两三千单以下的小仓,AI 波次优化的 ROI 很可能是负的。原因不在算法,而在分母——数据清洗、系统对接、模型调优的固定成本摆在那里,而小仓的订单池太小,优化空间天然有限。先把 ABC 库位管理和固定波次纪律做好,收益更大。这是 AI 讲 ROI 不吹捧的第一条边界。
AI 波次优化的数据准备:三类数据,缺一不可
这也呼应了之前讨论过的那个判断:数据准备决定 AI 落地成败。波次优化需要的三类数据,每一类缺了都会让模型退化回规则引擎:
第一类是订单历史数据:至少 6~12 个月的订单明细,含下单时间、订单结构、承运商、优先级。这是预测订单到达节奏的燃料。很多仓的订单数据散落在 OMS 和 WMS 两套系统里,时间戳口径还不一致——这是最常见的坑。
第二类是库位与动销数据:每个 SKU 的库位坐标、历史拣选频次、上下架记录。没有准确的库位主数据,聚类算法分出来的"热区"就是错的。库位数据不准,是波次优化项目里排名第一的失败原因。
第三类是人力与节拍数据:各工序的标准工时、历史实际耗时、人员技能标签。没有它,模型算出的"最优波次"可能是一个现有团队根本执行不了的计划。
三类数据的共同要求是:实时、可回放、口径一致。"可回放"尤其关键——你需要能拿三个月前某一天的真实订单流,在新模型里重跑一遍,对比当时的实际执行效果。做不到这一点,任何"AI 提升百分之多少"的说法都无从验证。
趋势判断:2025—2027,三个变化
基于目前的落地节奏,我对未来两三年的判断是:
第一,第二代算法(启发式 + 聚类 + 动态放波)会成为主流 WES 的标配功能,而不是独立售卖的 AI 模块。分波能力正在从"差异化卖点"变成"入场券",时间点大概在 2026 年前后。
第二,第三代技术(强化学习动态调波)会在头部 3PL 和电商自营仓小范围验证,但大规模商用要等到数据基础设施跟上。算法已经不是瓶颈,瓶颈是实时、干净、可回放的数据流——这恰恰是大多数仓最缺的。
第三,波次优化会和下游调度(复核、打包、装车预约)合并成一个更大的优化问题。单独优化拣选环节的时代正在过去,系统级优化是下一个十年的主题。
一个开放式的问题
所以,真正值得问的可能不是"AI 能不能把波次分得更好"——从数学上看,答案几乎是肯定的。而是:你的仓,有没有把每一次分波、每一次放波的决策和结果,沉淀成结构化的数据?如果没有,那么无论算法进化到第几代,五年后你面对的仍将是同一个黑五——凭感觉分波,凭运气过峰。
作者:陈博士|供应链行业研究员