O WCS de um armazém disparava mais de 4,000 alarmes por dia. O técnico de manutenção simplesmente silenciou o som.
Era 2019, uma instalação automatizada de 300,000 pés quadrados nos subúrbios de Chicago que acabara de comissionar uma nova linha de classificação. O WCS (sistema de controle de armazém) gerenciava os transportadores, o escaneamento, as junções de indução e os desvios — centenas de sensores fotoelétricos, dezenas de motores, mais de cem nós de comunicação, cada um enviando um alarme à sala de controle a cada mudança de estado. Um sensor fotoelétrico cegado pela poeira: um alarme. Uma oscilação na corrente de um motor: um alarme. Um heartbeat de PLC chegando 200 milissegundos atrasado: um alarme. Mais de 4,000 por dia, mais do que qualquer tela conseguia exibir.
Alarmes demais, e as pessoas aprendem a ignorá-las. O perigo não são os alarmes falsos — é o alarme real enterrado entre 4,000 que ninguém vê. Aquele armazém depois teve um entupimento no classificador. O alarme tinha disparado 15 minutos antes. Ninguém na sala de controle percebeu, e metade da linha parou por 40 minutos. Eu estava no local naquele dia, e o líder de manutenção me disse: "Não é que eu não olhe. Olhar não adianta."
Isso é uma enxurrada de alarmes. Não se resolve adicionando pessoas. Resolve-se com priorização e convergência de causas raiz.
Esqueça cinco níveis. Três bastam.
Muitos fornecedores de WCS vêm com quatro ou cinco níveis de severidade: crítico, maior, menor, aviso, info. Parece preciso. Na prática, ninguém no turno lembra a diferença entre cinco níveis, então tudo é tratado como um só.
Eu uso três:
Fatal: para a linha ou afeta a segurança. Disparo por sobrecarga do motor, parada de emergência acionada, cortina de luz de segurança bloqueada, comunicação do PLC principal perdida. Estes recebem som, um pop-up em tela grande, e se ninguém reconhecer em 15 minutos, uma chamada telefônica automática. Minha regra: mais de 3 alarmes fatais em um dia significa que o equipamento tem um problema, não o sistema de alarmes.
Impacta a produção: a linha funciona, mas mais devagar. Um canal cheio com redirecionamento automático, taxa de escaneamento caindo abaixo de 95%, uma seção de transportador operando degradada. Estes vão para a tela da sala de controle e o telefone de plantão — sem sirene. O turno deve atendê-los ou documentá-los em uma hora.
Informativo: só registro, não incomoda ninguém. Um único disparo errôneo de sensor fotoelétrico, uma reconexão bem-sucedida de nó de comunicação, uma breve oscilação na corrente de um motor. Este nível é mais de 90% do volume total. Seu único valor é a análise pós-incidente. Nunca deve aparecer na tela de ninguém.
Meu único teste de severidade: se ninguém olhar este alarme, ele vira um problema de dinheiro em duas horas? Sim — os dois níveis superiores. Não — informativo.
Naquela instalação de Chicago, passamos duas semanas reclassificando os mais de 4,000 alarmes contra esse padrão. Resultado: 11 fatais, 87 impactando a produção e mais de 3,900 informativos. O técnico ligou o som de volta — porque agora cada alarme que soava valia a pena se levantar.
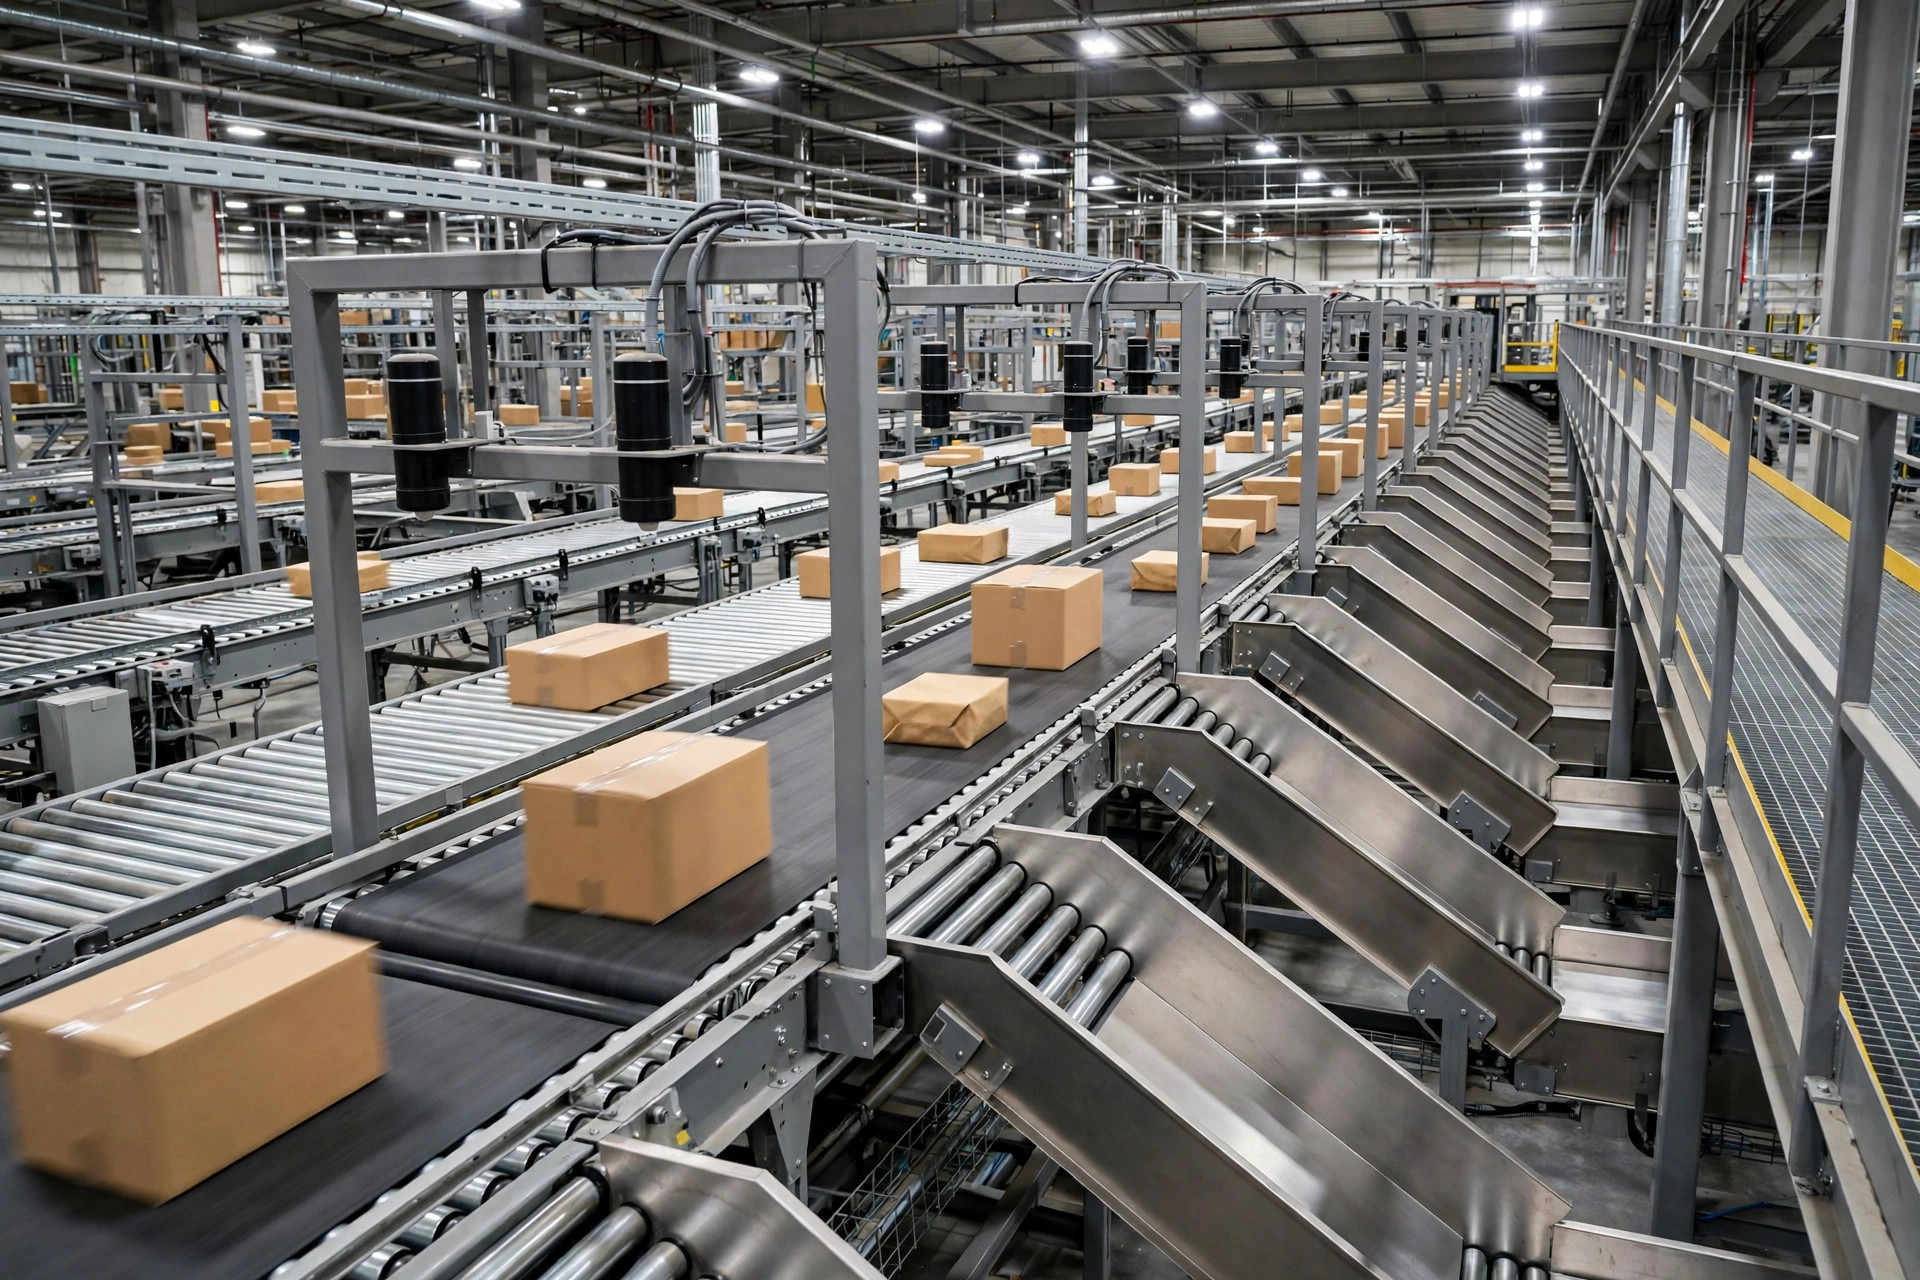
Cinco alarmes, um sensor fotoelétrico torto
A priorização resolve o "não dá para ler todas". A convergência resolve o "não dá para consertar todas".
Num turno da noite, a sala de controle acendeu com mais de 200 alarmes em uma hora: falhas de escaneamento na zona A, tempos limite de junção na zona B, sobrecargas de motores na zona C, instabilidade de comunicação na zona D, pacotes retidos na zona E. Dois técnicos correram a noite toda. A linha seguia capengando. Ao amanhecer, caminhei pelo piso e encontrei os cinco tipos de alarme apontando para um único ponto: um sensor fotoelétrico no ponto de junção 3, entortado 3 milímetros por um pallet. Olho torto, tempo de escaneamento errado; tempo errado, junções caóticas; junções caóticas, motores forçados; motores forçados, comunicação instável. Um parafuso solto, 200 alarmes.
Essa é a verdade mais comum sobre alarmes WCS: alarmes disparam por dispositivo, mas falhas se propagam ao longo de uma cadeia causal. Um alarme corresponde a um dispositivo, mas uma falha detona uma série de alarmes em cadeia.
Meu método de convergência é grosseiro, mas funciona: antes do fim de cada turno, agrupe os alarmes do dia por localização do equipamento mais janela de tempo. Três ou mais tipos de alarme diferentes na mesma área em dez minutos — não os conserte um por um. Vá olhar aquela área. Provavelmente é uma única causa raiz. Também pedi à manutenção que construísse uma "árvore genealógica de alarmes": qual sensor fotoelétrico torto produz quais alarmes derivados. Depois de três meses, a equipe do turno conseguia adivinhar a causa raiz só pela combinação de alarmes. O tempo médio de localização caiu de 40 minutos para menos de 10.
E uma regra dura: o mesmo dispositivo que dispare mais de 20 alarmes informativos em 24 horas escala automaticamente para impacta a produção. Um sensor fotoelétrico que falha uma vez é poeira. Que falha diariamente está solto ou morrendo. Não deixe o "informativo" virar uma condição crônica.
O MTTR só significa algo depois da priorização
O MTTR (tempo médio de reparo) é um KPI em muitos armazéns, mas antes da priorização de alarmes, o número é ficção. Com 3,900 informativos misturados em 4,000 alarmes, o MTTR parece ótimo — porque os informativos são "resolvidos" rápido (uma olhada e descartados). Quando algo real quebra, o MTTR não diz nada.
Depois da priorização, acompanhe o MTTR separadamente: fatal sozinho, impacta a produção sozinho, informativo de jeito nenhum. No local de Chicago, o MTTR combinado antes da priorização era de 22 minutos — parecia bom. Depois de separar, o MTTR real de alarmes fatais acabou sendo de 55 minutos, porque ninguém estava vendo esses alarmes prontamente em primeiro lugar. Três meses depois da priorização, o MTTR fatal estava abaixo de 15 minutos. A equipe não ficou mais rápida. Os alarmes finalmente chegavam às pessoas certas.
Para a ligação alarme-MTTR, faço exatamente três coisas: alarmes fatais criam automaticamente uma ordem de serviço e iniciam um cronômetro; alarmes que impactam a produção escalam automaticamente quando não tratados após sua janela; e toda segunda-feira coloco as contagens e os MTTRs dos três níveis lado a lado — se as contagens sobem enquanto o MTTR fica estável, os limiares de severidade provavelmente afrouxaram.
Lista inicial: cinco coisas para a primeira semana
Se seu WCS está se afogando em alarmes, pule o grande projeto. Faça estas cinco primeiro:
- Exporte os alarmes dos últimos 7 dias, ordenados por contagem. As 20 principais fontes de alarmes geralmente representam 80% do volume. Ataque essas primeiro para a vitória mais rápida.
- Implemente primeiro o "informativo vai só para o registro". É a jogada de maior ROI que existe — um dia para limpar as telas. Nota: você está silenciando o envio, não o registro. Guarde cada log.
- Dê aos alarmes fatais um caminho real de escalonamento. Som mais tela grande mais chamada telefônica automática após 15 minutos sem reconhecimento. Priorização sem escalonamento é decoração.
- Inicie a árvore genealógica de alarmes. Comece com as 5 combinações de alarmes mais comuns, expanda para 20 em um mês. É o ativo de conhecimento mais valioso que sua equipe de manutenção terá.
- Revise semanalmente as 10 principais fontes de alarmes. O mesmo sensor fotoelétrico na lista duas semanas seguidas não está "dando alarme falso" — precisa de substituição. Quinze minutos, só o top 10, só ações.
Um julgamento para fechar: a enxurrada de alarmes WCS nunca é um problema de tecnologia. É um problema de gestão. De 4,000 alarmes, 3,900 são o sistema falando consigo mesmo e 100 estão dizendo a verdade. Seu trabalho não é fazer o sistema falar menos — é fazer a verdade ser ouvida.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.