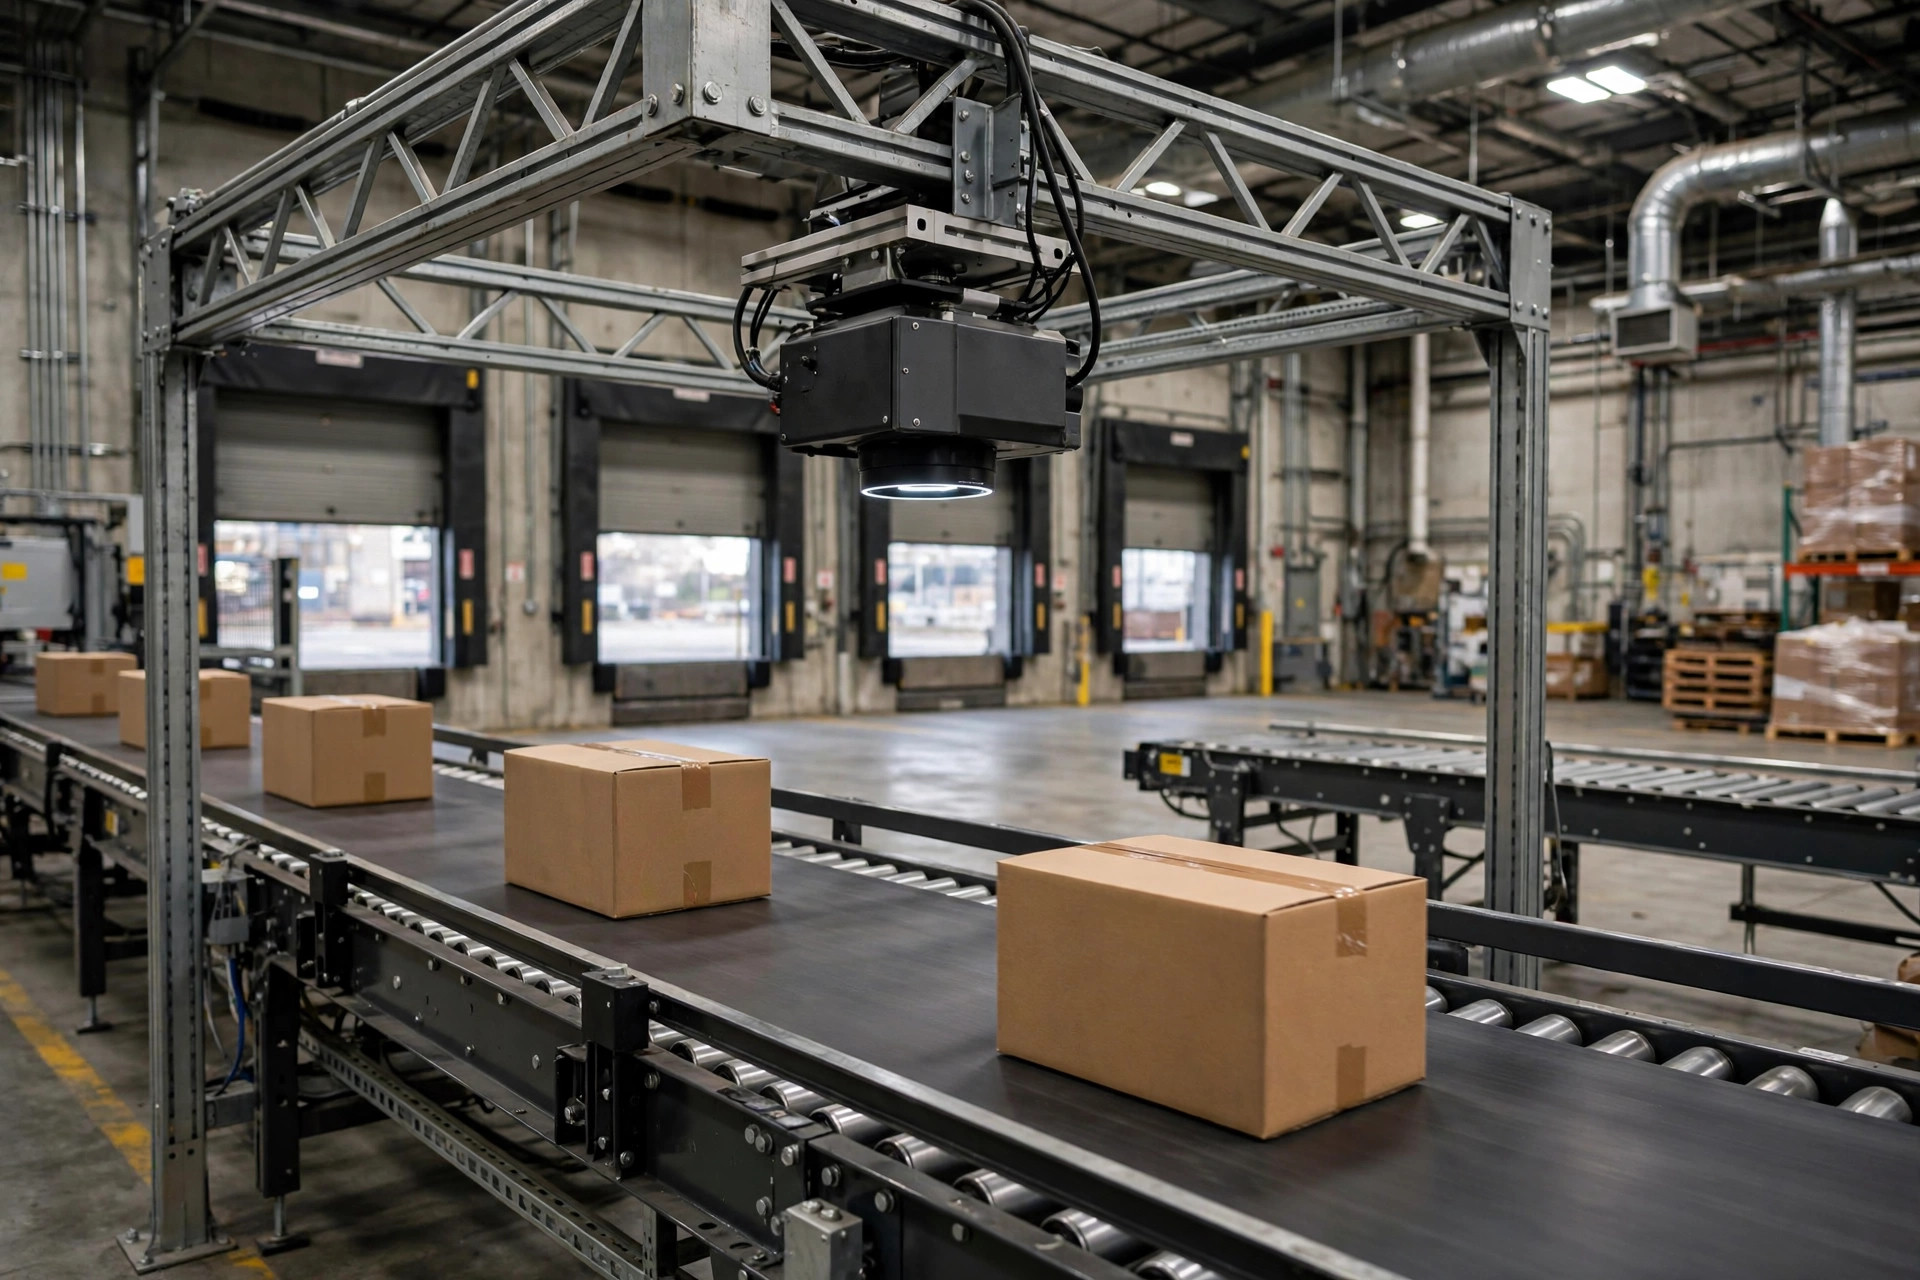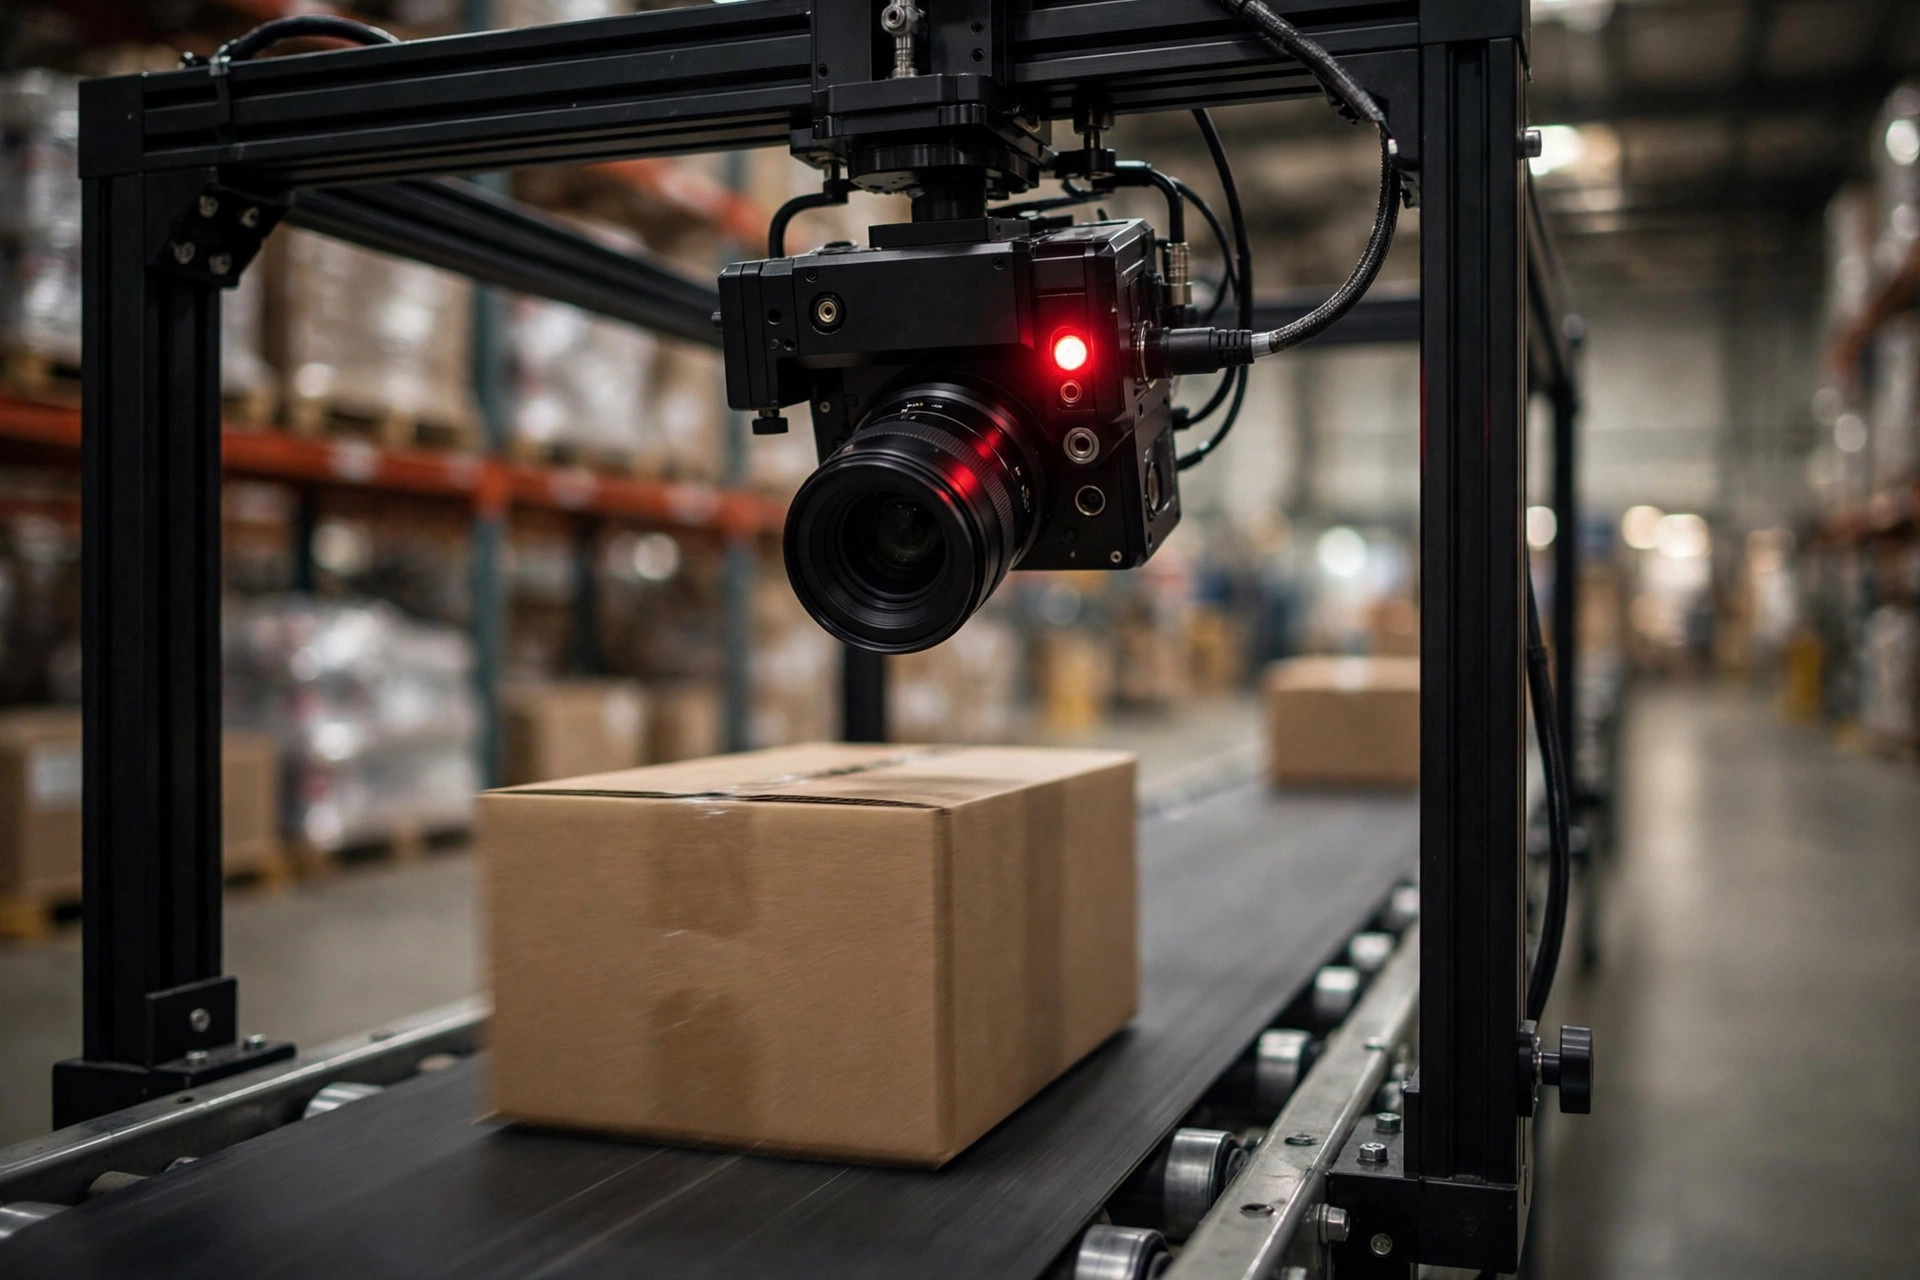
No ano passado eu estava num armazém de acessórios 3C observando um sistema de visão novinho no transportador. O trabalho dele: ler as etiquetas de SKU nas caixas e substituir o escaneamento manual. A demo estava ótima. Aí lançaram produtos novos, e na primeira semana o sistema classificou com confiança todos os 37 novos SKUs como antigos. As câmeras estavam boas. O algoritmo estava bom. O modelo simplesmente nunca tinha visto aqueles rostos — e escolheu mesmo assim a categoria antiga "mais próxima".
Esse é o defeito fatal dos classificadores clássicos: eles só podem escolher entre categorias que lhes ensinaram. Coloque uma pergunta nunca vista no exame e eles ainda assim vão escrever uma resposta. O aprendizado few-shot existe para corrigir exatamente isso.
O que ele realmente está aprendendo
Um classificador de imagens tradicional memoriza como cada categoria se parece. Mostre a ele milhares de fotos do produto A e ele lembra o rosto de A; mostre uma imagem nova e ele pergunta: parece mais com A, B ou C? Note o "ou" — ele assume que a resposta tem que ser uma das categorias conhecidas. Um SKU novo, por mais distinto que seja, é forçado a caber em algum balde velho. Foi assim que 37 novos SKUs morreram na primeira semana.
O aprendizado few-shot inverte a lógica: em vez de memorizar "quem é este", ele aprende "se isto se parece". Durante o treinamento, o modelo aprende a transformar uma imagem numa sequência de números — um embedding. Imagens de aparência similar ganham números próximos; as de aparência diferente, números distantes. No go-live, chega um SKU novo, você fotografa de 5 a 20 fotos de referência, e o sistema lembra onde esses números ficam. Cada imagem nova depois disso é julgada pela distância: a referência mais próxima ganha a etiqueta.
A analogia humana: um classificador clássico é uma prova sem consulta — só testado no que estudou. O aprendizado few-shot é como reconhecer um estranho — ver um rosto duas vezes, lembrar, identificar na multidão na próxima vez. Não precisa saber o nome nem a profissão da pessoa. Lembrar o rosto basta.
Uma implementação comum, a rede prototípica, é ainda mais literal: tira a média das poucas fotos de referência de cada categoria num "rosto médio", e atribui cada imagem nova à média mais próxima. Simples de implementar, e suficiente para muitos trabalhos de armazém.
Onde brilha — e onde não
Comecemos por onde brilha. SKUs que se parecem claramente diferentes entre si — embalagens de cores diferentes, tamanhos de caixa diferentes, produtos fisicamente distintos — são o seu terreno. Lança um SKU novo, a operação tira uma dúzia de fotos e sobe, e está funcionando em meia hora. Sem ciclo de etiquetagem e retreinamento de duas semanas.
Embalagem estável também ajuda. Alguns consumíveis mantêm a mesma embalagem por anos; fotografe as referências uma vez e elas servem por muito tempo.
Agora as zonas proibidas. Primeira: vestuário com o mesmo modelo em cinco cores. Visualmente quase idêntico exceto pela cor, distinguido na prática por etiquetas penduradas e etiquetas de lavagem — invisíveis para uma câmera em velocidade de transportador. Forçar só produz erros confiantes. Escaneie o código de barras e siga.
Segunda: embalagem transparente ou refletiva. Mude a iluminação e o "rosto" muda; as distâncias de embedding desmoronam. A menos que seu controle de iluminação seja de grau industrial, não espere que funcione.
Terceira: catálogos girando centenas de SKUs por mês. Cada SKU novo precisa de fotos de referência tiradas, revisadas e arquivadas — isso é trabalho sustentado. Deixe a biblioteca de referências apodrecer e a acurácia decai em silêncio num trimestre, e você nem vai saber.
Três armadilhas na implantação
Armadilha um: referências tiradas "limpas" demais. O pessoal faz a operação posar produtos no escritório — fundo branco, ângulo frontal, luz perfeita. Aí o transportador serve imagens inclinadas, borradas, com sombras e nada combina. Tire as referências no transportador de verdade, sob luz de verdade, em velocidade de verdade: de 8 a 12 tomadas por SKU, múltiplos ângulos, um pouco de inclinação, e inclua também embalagem suja e danificada. Quanto mais próximas as referências estiverem das condições de combate, melhor funciona.
Armadilha dois: sem opção de "não sei". Por mais longe que esteja a distância, o sistema ainda escolhe a mais próxima — sempre tem uma resposta. Você precisa de um limiar de distância: além dele, a imagem é declarada desconhecida e encaminhada a um humano. Esse limiar não é intuição; passe duas semanas de dados reais por ele e encontre onde as falsas aceitações e as falsas rejeições se equilibram.
Armadilha três: nunca precificar o custo de uma má identificação. Uma má identificação custa o frete do envio errado mais a viagem de volta mais o tempo do atendimento ao cliente. Uma revisão humana custa alguns segundos de trabalho. Seu trabalho é encontrar o rigor de limiar que minimiza o custo total. Essa conta é diferente para cada armazém — não copie os parâmetros de outro.
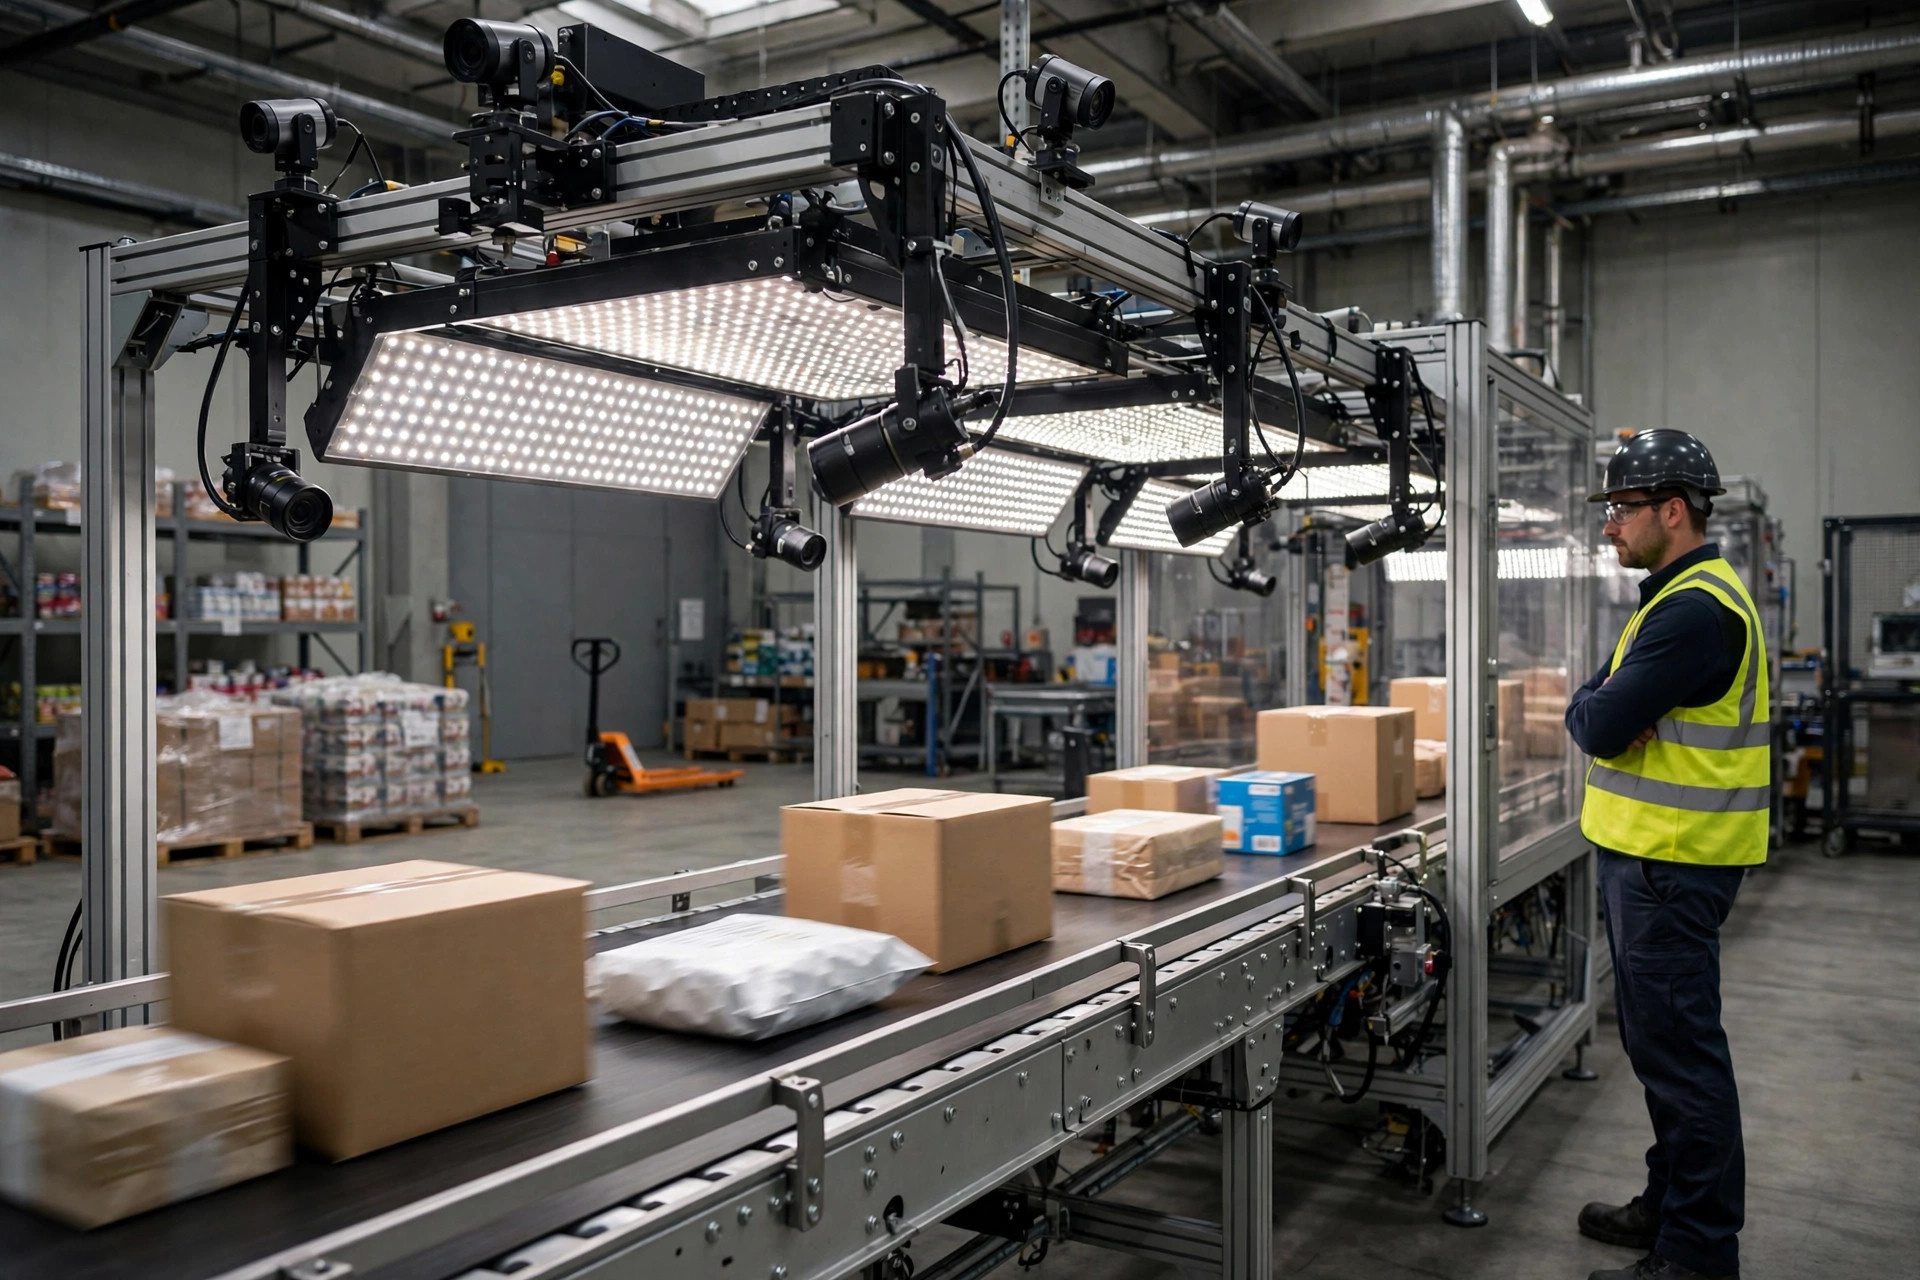
Uma nota de hardware: não economize na câmera. Uma câmera industrial como a Basler ace combinada com iluminação LED estável produz imagens muito mais consistentes que uma webcam genérica. O aprendizado few-shot é sensível à consistência de imagem; economizar alguns milhares de dólares no início e perder cinco pontos de acurácia depois é o pior negócio.
Um lançamento de quatro semanas que funciona
Semana um: tire referências no transportador, em luz de verdade, em velocidade de verdade. Inclua os casos difíceis — inclinados, meio ocultos, embalagem amassada. A qualidade de referência põe o teto; não apresse esta semana.
Semana dois: fixe o limiar. Passe duas semanas de dados históricos por ele e encontre o ponto de equilíbrio entre falsas aceitações e rejeições. Puxe para mais revisão humana, não menos — um envio errado custa dezenas de vezes o que custa uma revisão.
Semana três: pilote num transportador, ou em 20 SKUs. Revise cada má identificação diariamente e troque as referências ruins. Você vai descobrir pares de SKU que "parecem diferentes mas na verdade não" — cuide deles agora.
Semana quatro: escale, e trave o processo de manutenção — quem fotografa SKUs novos, com que frequência as referências antigas são revisadas, com que frequência o limiar é reajustado. Um sistema sem processo de manutenção vai decair em três meses. Garantido.
O que perguntar ao fornecedor
A demo de todo fornecedor de visão parece incrível. Antes de assinar, faça cinco perguntas.
Uma: quanto tempo leva para um SKU novo entrar em produção? Se a resposta for "retreinar o modelo, duas semanas", é um classificador clássico fantasiado de few-shot. Few-shot de verdade significa adicionar referências, não retreinar — meia hora, não duas semanas.
Duas: quais são a taxa de má identificação e a taxa de "não sei", separadamente? Quem citar só a acurácia está escondendo algo. 99% de acurácia com 30% encaminhado a humanos significa que um terço do trabalho continua manual.
Três: como lida com a deriva de iluminação? Peça para baixarem pela metade as luzes da sala de demo e rodarem de novo. Muitos sistemas tiram 99% sob luz de showroom e caem para 90% quando metade dos tubos do armazém envelheceu.
Quatro: quantas categorias de SKU a biblioteca de referências pode conter? Algumas configurações de recuperação de embeddings ficam muito lentas passando de alguns milhares de categorias. Se seu catálogo anda na casa dos cinco dígitos, pergunte agora.
Cinco: roda offline? Edge ou nuvem? Um transportador move dezenas de caixas por minuto; um soluço de rede numa configuração de nuvem para a linha toda. Para trabalho de armazém, só recomendo implantação edge.
Qualquer fornecedor que responda às cinco de forma limpa merece uma conversa de preço. Quem não conseguir — por mais polida que seja a demo — está vendendo uma peça de feira, não uma ferramenta de produção. A tecnologia não é mágica. Usá-la no lugar certo, sim.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.