No outono passado, passei metade de uma tarde ao lado de um classificador em um armazém 3PL em Dongguan, observando o contador de leituras incorretas de códigos de barras subir. A linha não estava correndo particularmente rápido. Os pacotes passavam um após o outro, e aproximadamente 1 em cada 20 ou 30 era desviado para a via de exceções. 2 pessoas nessa via trabalhavam sem parar: escanear à mão, reetiquetar e devolver o pacote à linha. Todo o tempo de ciclo que o classificador havia economizado, a via de exceções devorava de volta. É assim que uma leitura incorreta de código de barras no classificador de armazém geralmente se parece na vida real. A máquina não está quebrada. O ângulo do código de barras, o posicionamento da etiqueta, a velocidade da esteira, a iluminação e a poeira se uniram para fechar a janela de leitura.
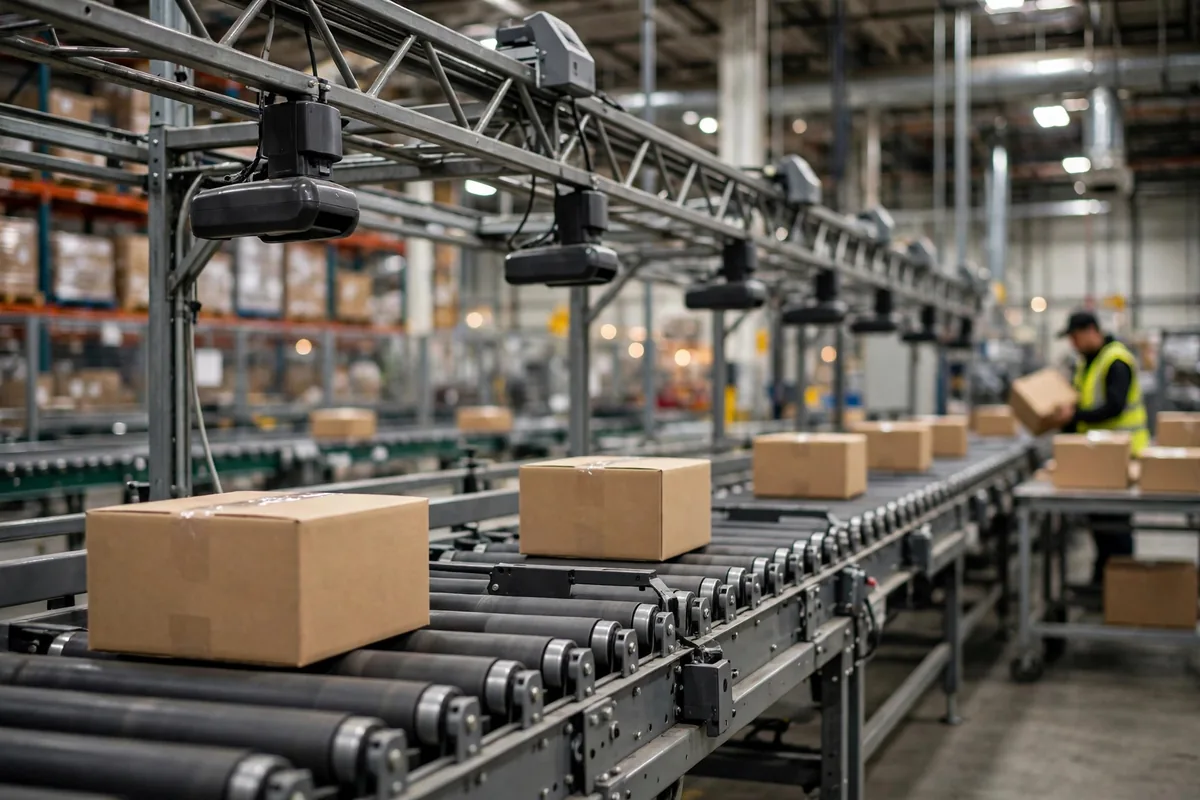
Pense assim: o scanner e o código de barras têm um encontro marcado. O código de barras precisa aparecer no momento certo, no ângulo certo, e permanecer tempo suficiente para o scanner reconhecê-lo. Se qualquer um desses fatores falhar — atrasado, inclinado, sujo — o encontro fracassa. Em um classificador, esse encontro precisa acontecer várias vezes por segundo, então a margem de erro é muito menor do que em um escaneamento manual.
Por que uma leitura incorreta de código de barras no classificador raramente é um só problema
As leituras incorretas raramente são causadas por um único fator. Na minha experiência, 4 variáveis importam, e elas se arrastam mutuamente: o ângulo do código de barras, o posicionamento da etiqueta, a velocidade da esteira e o ambiente. O ângulo é o que a maioria das pessoas mais subestima. Uma etiqueta está na lateral de um pacote, o pacote gira alguns graus na esteira, e de repente o scanner não está mais olhando para um código de barras plano, mas para um código achatado e inclinado. Um scanner a laser tolera muito menos inclinação do que um leitor baseado em câmera. É como tentar ler um livro segurado de lado: as palavras são as mesmas, mas reconhecê-las exige muito mais esforço.
O posicionamento da etiqueta é a segunda armadilha. Uma etiqueta colada atravessando a aba de uma caixa, sobre uma emenda de fita ou ao redor de um canto curvo chega enrugada ou rasgada antes de o scanner vê-la. Nenhuma correção de ângulo resolve isso. Na unidade de Dongguan, as piores leituras incorretas vinham de caixas de formatos irregulares: as etiquetas estavam coladas baixas na lateral, e a borda da esteira continuava dobrando a parte inferior da etiqueta enquanto os pacotes avançavam. Isso não se corrige ajustando os parâmetros do scanner. Corrige-se voltando ao padrão de etiquetagem.
A velocidade é a terceira variável, e ela multiplica o ângulo em vez de somar-se a ele. Quanto mais rápida a esteira, menos tempo o código de barras passa dentro da janela de leitura, então uma pequena inclinação que seria perdoada em baixa velocidade se torna uma falha em alta velocidade. A mesma inclinação de cerca de 15 graus pode ter 2 ou 3 tentativas em baixa velocidade e apenas 1 chance fugaz em alta velocidade. A iluminação e a poeira são os últimos cúmplices: a luz do teto projeta um ponto brilhante de reflexo sobre uma etiqueta laminada, e a poeira embaça lentamente a janela do scanner. Ambos chegam de mansinho: a taxa de leituras incorretas parece boa hoje e dobra na semana que vem.
Esse avanço sorrateiro é exatamente o motivo pelo qual a manutenção importa mais do que a maioria pensa. Voltarei a isso, porque a correção mais barata de toda essa história é um pano de limpeza e um hábito semanal.
A matriz ângulo-velocidade: decida o que corrigir primeiro
A pior maneira de diagnosticar leituras incorretas é mudar tudo de uma vez. Minha ordem habitual é: primeiro as etiquetas, depois o ângulo, depois a velocidade, e só então a seleção do scanner. Essa ordem não é um palpite; está ordenada pelo custo de reparo, do mais barato ao mais caro. Corrigir o padrão de etiquetagem não custa quase nada. Corrigir o ângulo leva meio dia. Reduzir a velocidade da linha custa produtividade. Substituir o scanner custa mais.
Esta é a estrutura de ângulo por velocidade que desenho para os clientes. Os números são magnitudes típicas — consulte sempre o manual do fabricante do equipamento para a sua própria máquina:
| Velocidade da esteira (faixa típica) | Inclinação pequena (dentro de cerca de 10 graus) | Inclinação média (cerca de 10–25 graus) | Inclinação grande (acima de cerca de 25 graus) |
|---|---|---|---|
| Baixa (cerca de 1 m/s) | Geralmente lê de forma confiável | Leituras incorretas ocasionais; verifique a etiquetagem | Leituras incorretas perceptíveis; corrija primeiro o ângulo |
| Média (cerca de 1–2 m/s) | Leituras incorretas ocasionais; verifique a iluminação e a poeira | As leituras incorretas aumentam; ajuste o ângulo e a velocidade juntos | Não force; reduza a inclinação antes de falar de velocidade |
| Alta (acima de cerca de 2 m/s) | Depende de um leitor de câmera e de uma boa etiquetagem | As leituras incorretas disparam; reduza a velocidade ou corrija a etiquetagem | Refaça primeiro a etiquetagem e a orientação dos pacotes |
A parte contraintuitiva desta tabela é a que a maioria dos armazéns entende ao contrário: em uma linha de alta velocidade, a correção mais barata muitas vezes não é um scanner mais caro. É reduzir um pouco a velocidade, ou endireitar a forma como os pacotes entram na linha. Nenhum scanner, por mais caro que seja, pode devolver os milissegundos extras de que um código de barras precisa dentro da janela de leitura. E, no entanto, continuo vendo unidades fazerem o inverso: compram primeiro o scanner caro, a taxa de leituras incorretas cai um pouco, e as etiquetas continuam coladas atravessando a aba de uma caixa.
Um segundo caso mostra o mesmo ponto por outro ângulo. No início deste ano, um armazém de comércio eletrônico em Ontario, Califórnia, viu sua taxa de leituras incorretas do classificador disparar pouco antes da alta temporada. Os scanners estavam bons, a velocidade não havia mudado. O culpado acabou sendo um novo lote de etiquetas laminadas: a luz do teto batia nelas e devolvia o reflexo diretamente ao leitor. A correção foi quase constrangedoramente barata: inclinar a luz acima do scanner, adicionar uma pequena proteção, e a taxa de leituras incorretas voltou ao normal no mesmo dia. A lição que tiro desse caso é simples: quando as leituras incorretas disparam, pergunte o que mudou mais recentemente. Um novo material de etiqueta, um novo tamanho de caixa, uma luz movida — qualquer um desses pode derrubar o equilíbrio que você tinha.
O custo real de uma leitura incorreta está na via de exceções
As pessoas geralmente medem as leituras incorretas apenas pela taxa de leituras incorretas, e esse é o número errado a acompanhar. O custo real está na via de exceções. Um pacote mal lido precisa ser retirado, escaneado à mão, avaliado e devolvido à linha — um processo que leva várias vezes mais tempo do que uma classificação normal. Pior, quando os pacotes mal lidos se acumulam na via de exceções, começam a sufocar a linha principal, e a produtividade efetiva cai junto.
Quando faço as contas para um cliente, uso 1 número: a mão de obra de tratamento de exceções consumida por cada 100 pacotes mal lidos. Se a via de exceções está queimando 1 ou 2 horas extras por dia com leituras incorretas, esse custo por pacote já pode superar o que você perde ao reduzir um pouco a velocidade da linha. Esse é o teste que deixo para as pessoas — e é a forma como julgo quase qualquer gasto com automação. Uma leitura incorreta de código de barras no classificador de armazém vale a pena ser corrigida, e vale a pena ser corrigida até certo nível, quando a mão de obra que ela consome na via de exceções, convertida em dinheiro, já supera o custo da correção. Se sim, corrija. Se não, conviva com ela por enquanto e gaste o dinheiro primeiro nas coisas gratuitas, como o padrão de etiquetagem.
Agora a armadilha da manutenção, porque é aqui que o dinheiro vaza silenciosamente. Não espere o alarme de leituras incorretas para limpar a janela do scanner. A poeira se acumula lentamente, e a taxa de leituras incorretas também; quando você percebe, a via de exceções já trabalha horas extras há 2 semanas. Minha regra é colocar 3 tarefas de 10 minutos em uma rotina semanal: limpar a janela do scanner, verificar a iluminação e conferir por amostragem o posicionamento das etiquetas. 10 minutos por semana superam um incidente na alta temporada.
A seleção do scanner segue a mesma lógica. Um leitor a laser é mais barato, mas estreito na tolerância de ângulo; um leitor de câmera custa mais, mas lida com etiquetas inclinadas e alta velocidade com muito mais folga. Escolha pelo grau real de desordem na orientação dos seus pacotes, não pela proposta que parece melhor. E seja direto sobre uma pseudonecessidade que ouço constantemente: uma unidade com caixas majoritariamente uniformes e etiquetas organizadas não precisa da matriz de câmeras de ponta só porque o folheto diz "zero leituras incorretas". Zero leituras incorretas é um número de marketing, não de engenharia. Compre a tolerância de que seus pacotes realmente precisam.
Uma leitura incorreta do classificador não é um mistério. São 4 números — ângulo, velocidade, etiquetagem e ambiente — que precisam se equilibrar. Endireite primeiro a etiqueta e seja honesto com o ângulo, depois fale de velocidade e scanners. Quando essa equação se equilibra, a taxa de leituras incorretas cai sozinha.
Por Da Liu, Engenheiro de Automação Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.