Fico com o lado da edge desta vez — com uma condição. É preciso separar a sua IA em dois tipos: a que "vigia a estrada" e a que "lê a sorte".
Vigiar a estrada não pode esperar um único milissegundo. Ler a sorte pode levar uma hora e ninguém morre. Essa linha é exatamente onde edge e nuvem se dividem. Nos últimos dois anos vi armazéns queimarem dinheiro dos dois lados: jogando tudo na nuvem e depois vendo toda a linha de separação parar no momento em que a rede espirra; ou comprando um servidor GPU no primeiro dia para rodar um modelo de relatórios que só precisa rodar uma vez por dia.
Onde implantar a inferência se resume a três forças em conflito: latência, largura de banda e custo. O caso de uso mais sensível a qualquer uma delas decide onde a inferência deve morar.
Tudo que se mede em milissegundos pertence à edge
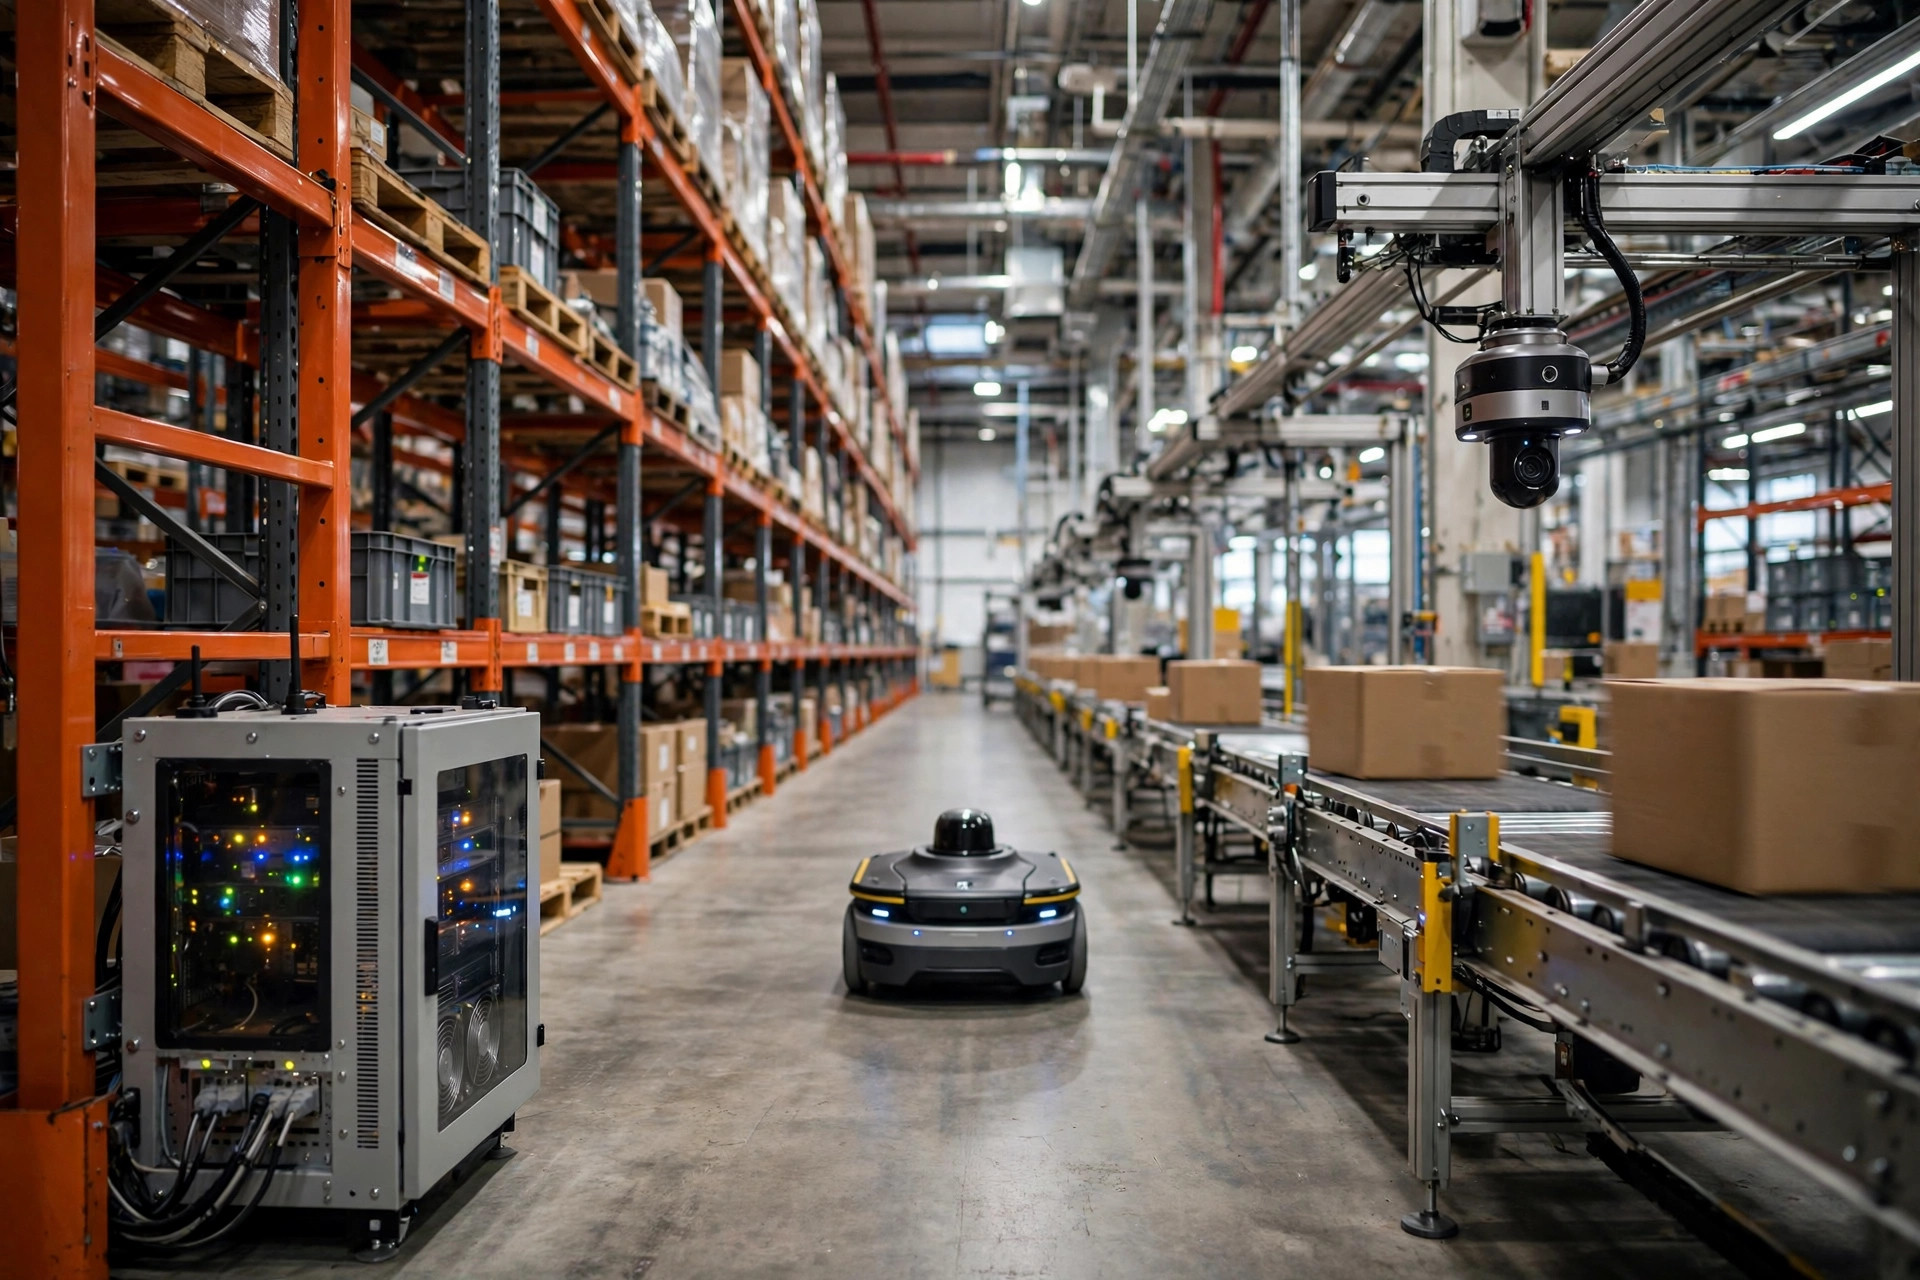
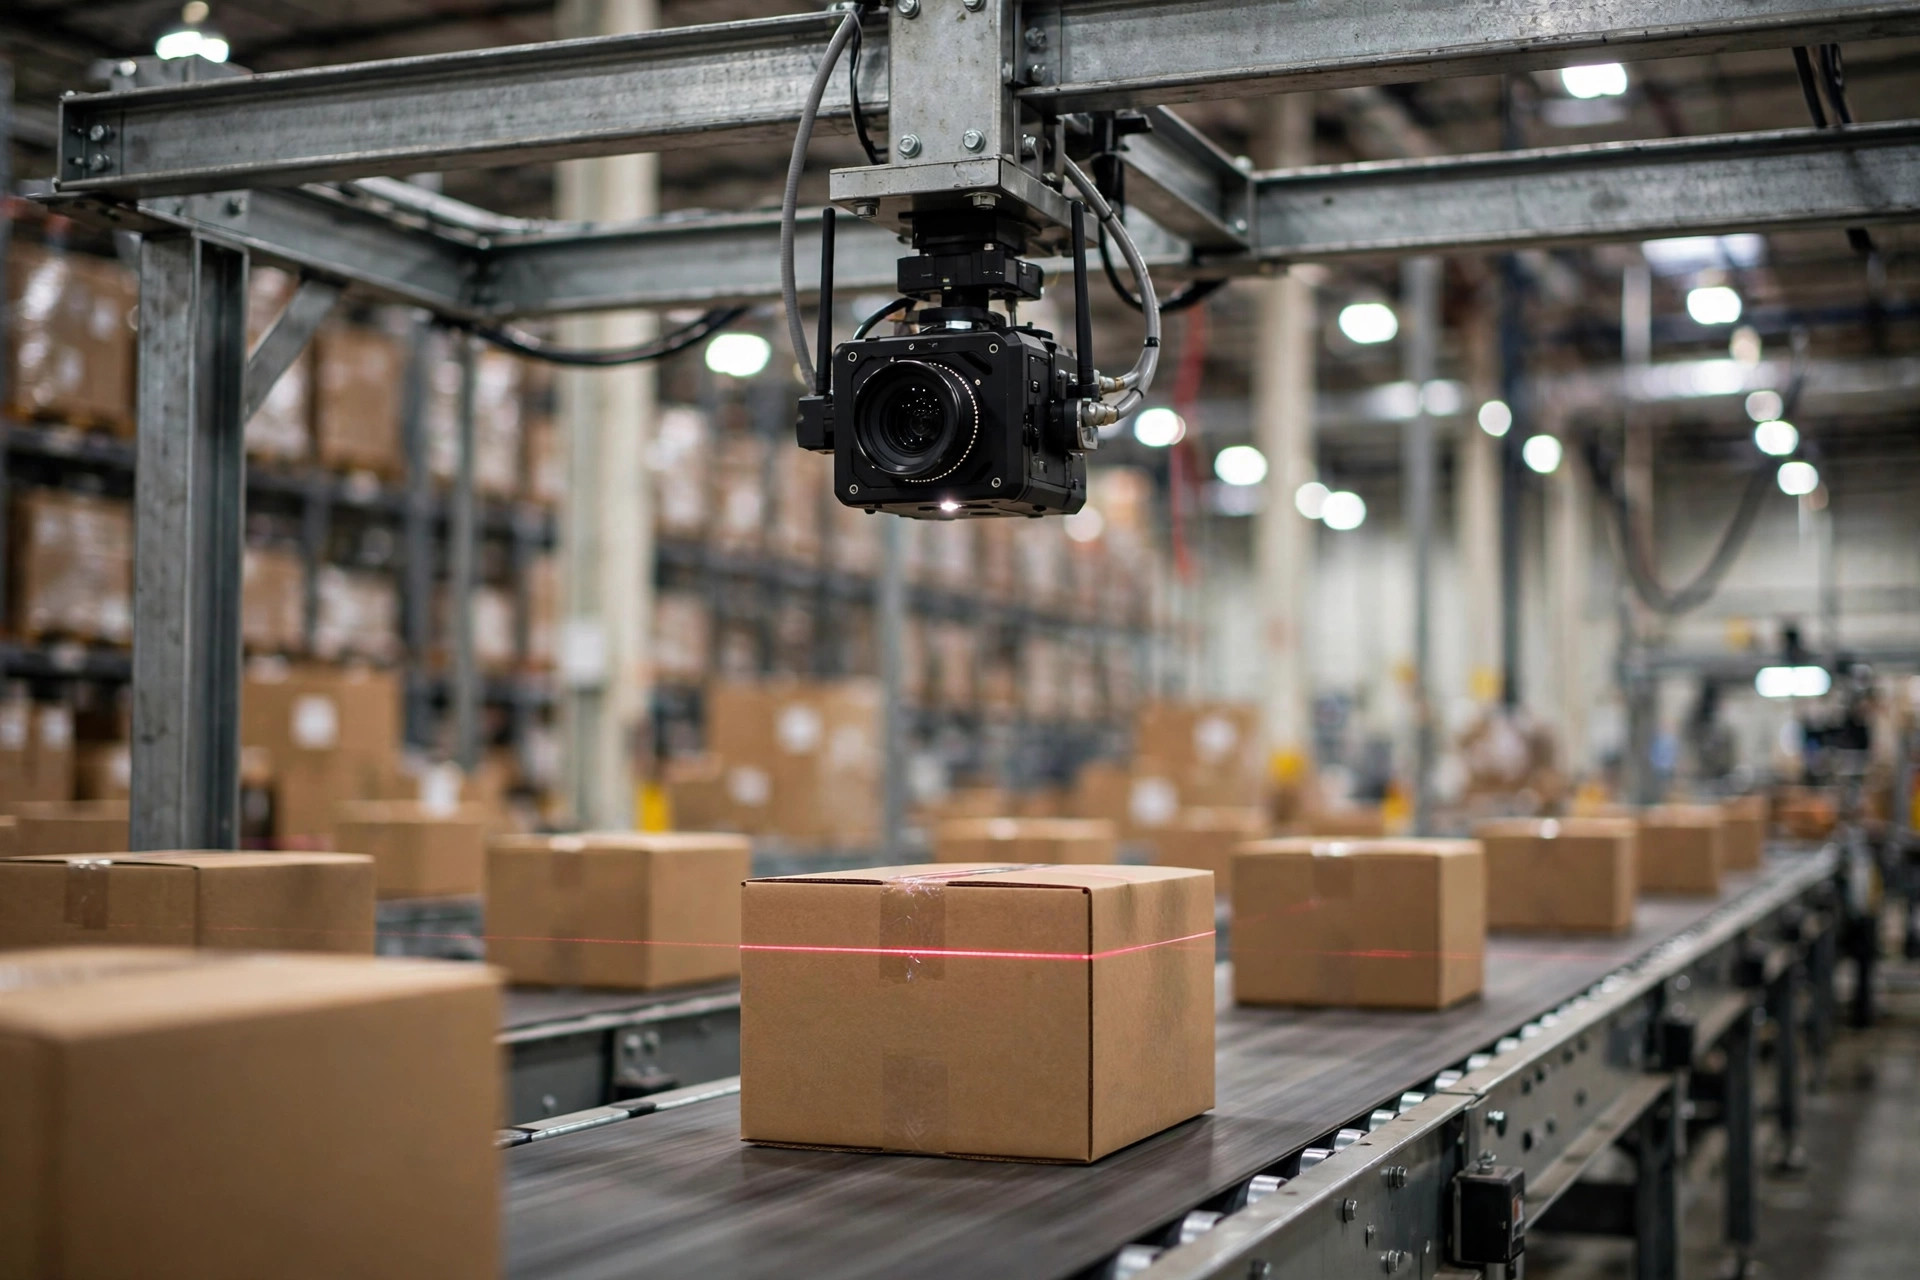
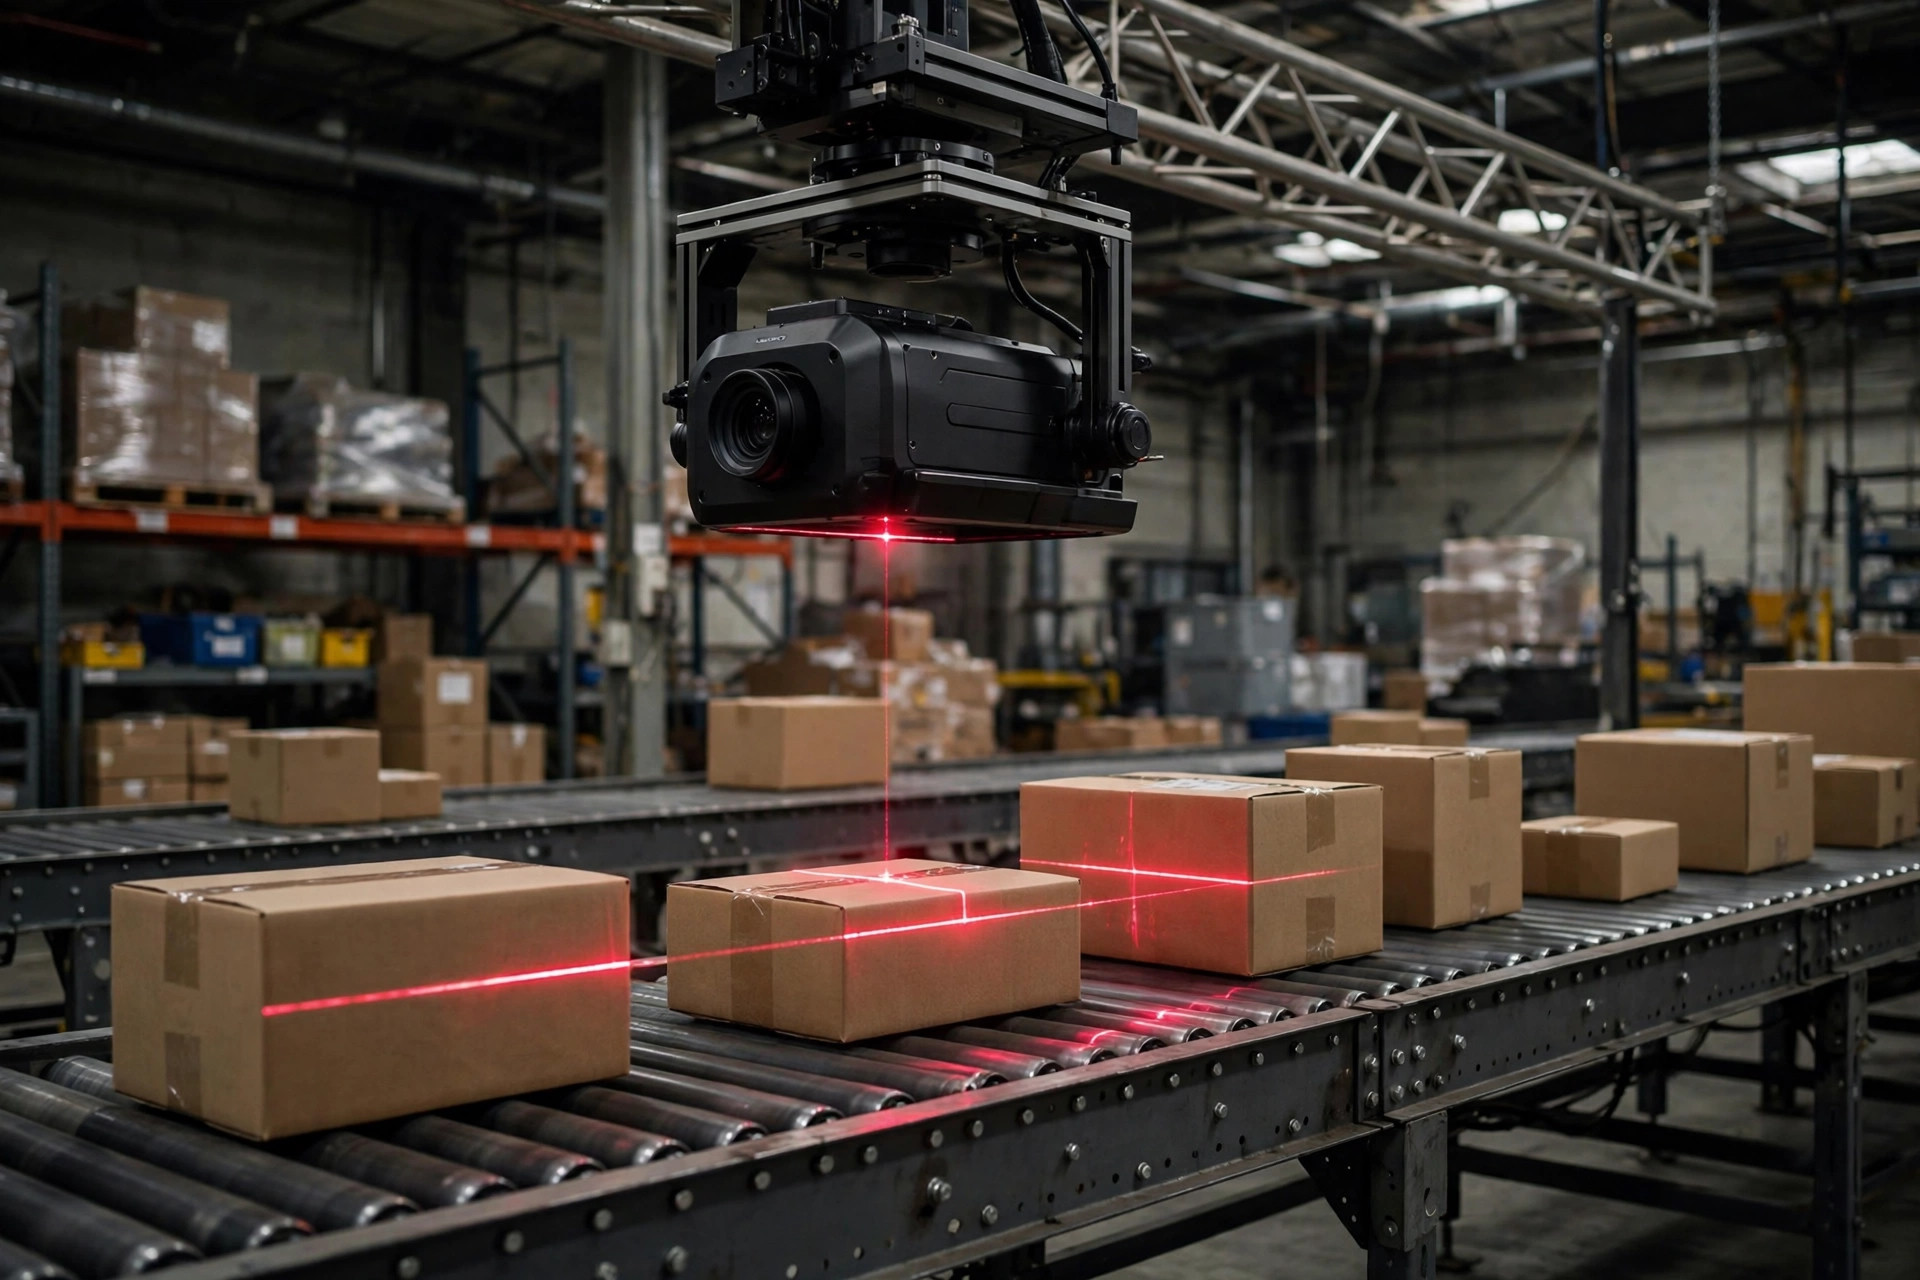
Comecemos pelos vigias da estrada: inspeção por visão, desvio de obstáculos de AMRs, pick-and-place robótico. O fio comum é um ciclo fechado medido em milissegundos. Uma linha de separação movimenta bem mais de cem pacotes por minuto; uma caixa fica no campo de visão da câmera por um piscar de olhos, e o resultado do reconhecimento tem que voltar em dezenas de milissegundos. Uma ida e volta à nuvem leva facilmente centenas de milissegundos — quando a resposta chega, a caixa já passou do ponto de desvio e o braço empurrador não tem mais o que mirar.
Depois vem a conta da largura de banda. Uma única câmera de visão transmitindo imagens brutas o dia todo gera dezenas de gigabytes por dia. Multiplique por algumas estações e seus custos mensais de uplink deixam de ser erro de arredondamento. E redes de armazém não se parecem em nada com redes de escritório: pontos mortos de Wi-Fi, sinal bloqueado por estruturas de aço, empilhadeiras mastigando cabos como evento diário. Apostar a inferência em tempo real nessa cadeia é entregar o uptime da sua linha à sorte.
Vi o contraexemplo num 3PL em Ontario, Califórnia, no ano passado: as câmeras de código de barras dele rodavam o reconhecimento na nuvem. Uma tarde a rede oscilou e toda a linha caiu para reescaneamentos manuais. Era só uma troca de ponto de acesso para manutenção — quatro horas com o throughput caído quase um terço. O dono me disse depois, com total sinceridade, que cada dólar economizado em servidores foi direto para o pagamento de horas extras.
O desvio de obstáculos dos AMRs é ainda mais extremo. O veículo está em movimento, uma pessoa aparece na frente dele, e a inferência fundida de lidar mais visão tem que se completar localmente e emitir um comando de freio em dezenas de milissegundos. Se essa decisão esperasse pela nuvem, o veículo já teria passado por cima da pessoa. É por isso que todo fabricante sério de AMR roda os modelos de desvio a bordo — não é uma preferência tecnológica, é física.
A regra para esta categoria é de uma linha: se o resultado da inferência aciona diretamente uma ação física, ele roda na edge. E "a linha continua rodando quando a rede morre" entra nos critérios de aceitação.
O que pode esperar sai mais barato na nuvem
A outra categoria são os leitores da sorte: previsão de demanda, sugestões de reposição, cálculos de estoque de segurança, relatórios operacionais mensais. Esses modelos rodam uma vez e suas respostas continuam válidas por um dia ou uma semana — alguns minutos de atraso não mudam nada. A verdadeira vantagem da nuvem aqui não é a computação barata; é que você não precisa possuir computação nenhuma. Sem máquinas para comprar, sem calor para gerenciar, sem chamadas às 2 da manhã por causa de uma caixa morta.
A segunda vantagem da nuvem é o treinamento. Treinar devora dados históricos, e o histórico do armazém já vive na nuvem: o banco de dados do WMS, o histórico de pedidos, os registros de mão de obra. Treinar e iterar lá em cima é o ajuste natural. O dispositivo de edge tem exatamente um trabalho: baixar o modelo treinado, executar a inferência e buscar novas versões na nuvem conforme um cronograma.
A arquitetura híbrida que vejo funcionar em campo — e a que eu entregaria a qualquer armazém pequeno ou médio como modelo inicial — é esta: a edge faz a inferência em tempo real com cache local para operar de forma autônoma quando a rede cai; a nuvem faz o treinamento, a distribuição de modelos e a análise global. Escrevam a divisão do trabalho e não deixem nenhum dos lados tomar o trabalho do outro. Implantem as atualizações de modelo em etapas: a nova versão em uma estação primeiro, uma semana de operação limpa, depois para toda a frota. Nunca façam uma "atualização de todo o armazém com um clique" — quando quebra, o armazém inteiro quebra junto.
E façam o teste de aceitação físico: no dia do go-live, puxem o cabo de rede e observem o que acontece. Se a linha para, a arquitetura é decoração, por mais bonitos que tenham sido os slides do fornecedor.
Armazéns pequenos: esqueçam o servidor GPU, comecem com um PC industrial
Agora o dinheiro. As pessoas ouvem "inferência de IA" e imaginam um rack de servidores GPU custando dezenas de milhares de dólares. Vou dizer algo impopular: nove em cada dez armazéns pequenos não precisam de um.
Uma única estação de inspeção por visão roda confortavelmente num dispositivo de edge da classe do Jetson Orin Nano da NVIDIA — a versão de 8 GB lançada em 2023, dezenas de watts de consumo, cabe dentro de um painel elétrico. Um PC industrial com GPU, na faixa de poucos milhares de dólares, pode atender duas ou três estações. Comecem por aí: provem o ROI em uma ou duas estações — reduzam a taxa de falhas das reinspeções manuais, ou eliminem as paradas por lentidão na linha de separação. Quando a conta fechar, então falem em expandir estações, e depois em servidores.
Um detalhe ambiental constantemente ignorado: poeira e calor. Armazéns atingem altas temperaturas no verão e a poeira chega a todo lugar; hardware de consumo jogado nesse ambiente não sobrevive a uma temporada de pico. Ao escolher hardware de edge, ampla faixa de temperatura operacional, design sem ventoinha e resistência à poeira são requisitos duros — não comprem apenas pelas especificações de computação. Essa é outra razão pela qual recomendo começar com um PC industrial: ele é construído para exatamente este ambiente.
Para quem são realmente os servidores GPU? Operações que rodam dezenas de estações ao mesmo tempo, ou equipes que treinam seus próprios modelos. Se o seu armazém ainda não chegou lá, comprar um significa pagar a conta de luz de uma sala de máquinas — e financiar a comissão de vendas do fornecedor.
Meu veredito é direto: separem seus casos de uso primeiro em vigias da estrada e leitores da sorte — edge para os primeiros, nuvem para os segundos. Comecem o hardware com um único PC industrial, provem uma estação, e depois expandam. Da próxima vez que um fornecedor de IA fizer a apresentação, façam três perguntas: onde a inferência roda, a linha para quando a rede morre, e com que frequência os modelos são atualizados? Se não conseguirem responder essas três, podem fechar a apresentação.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.