
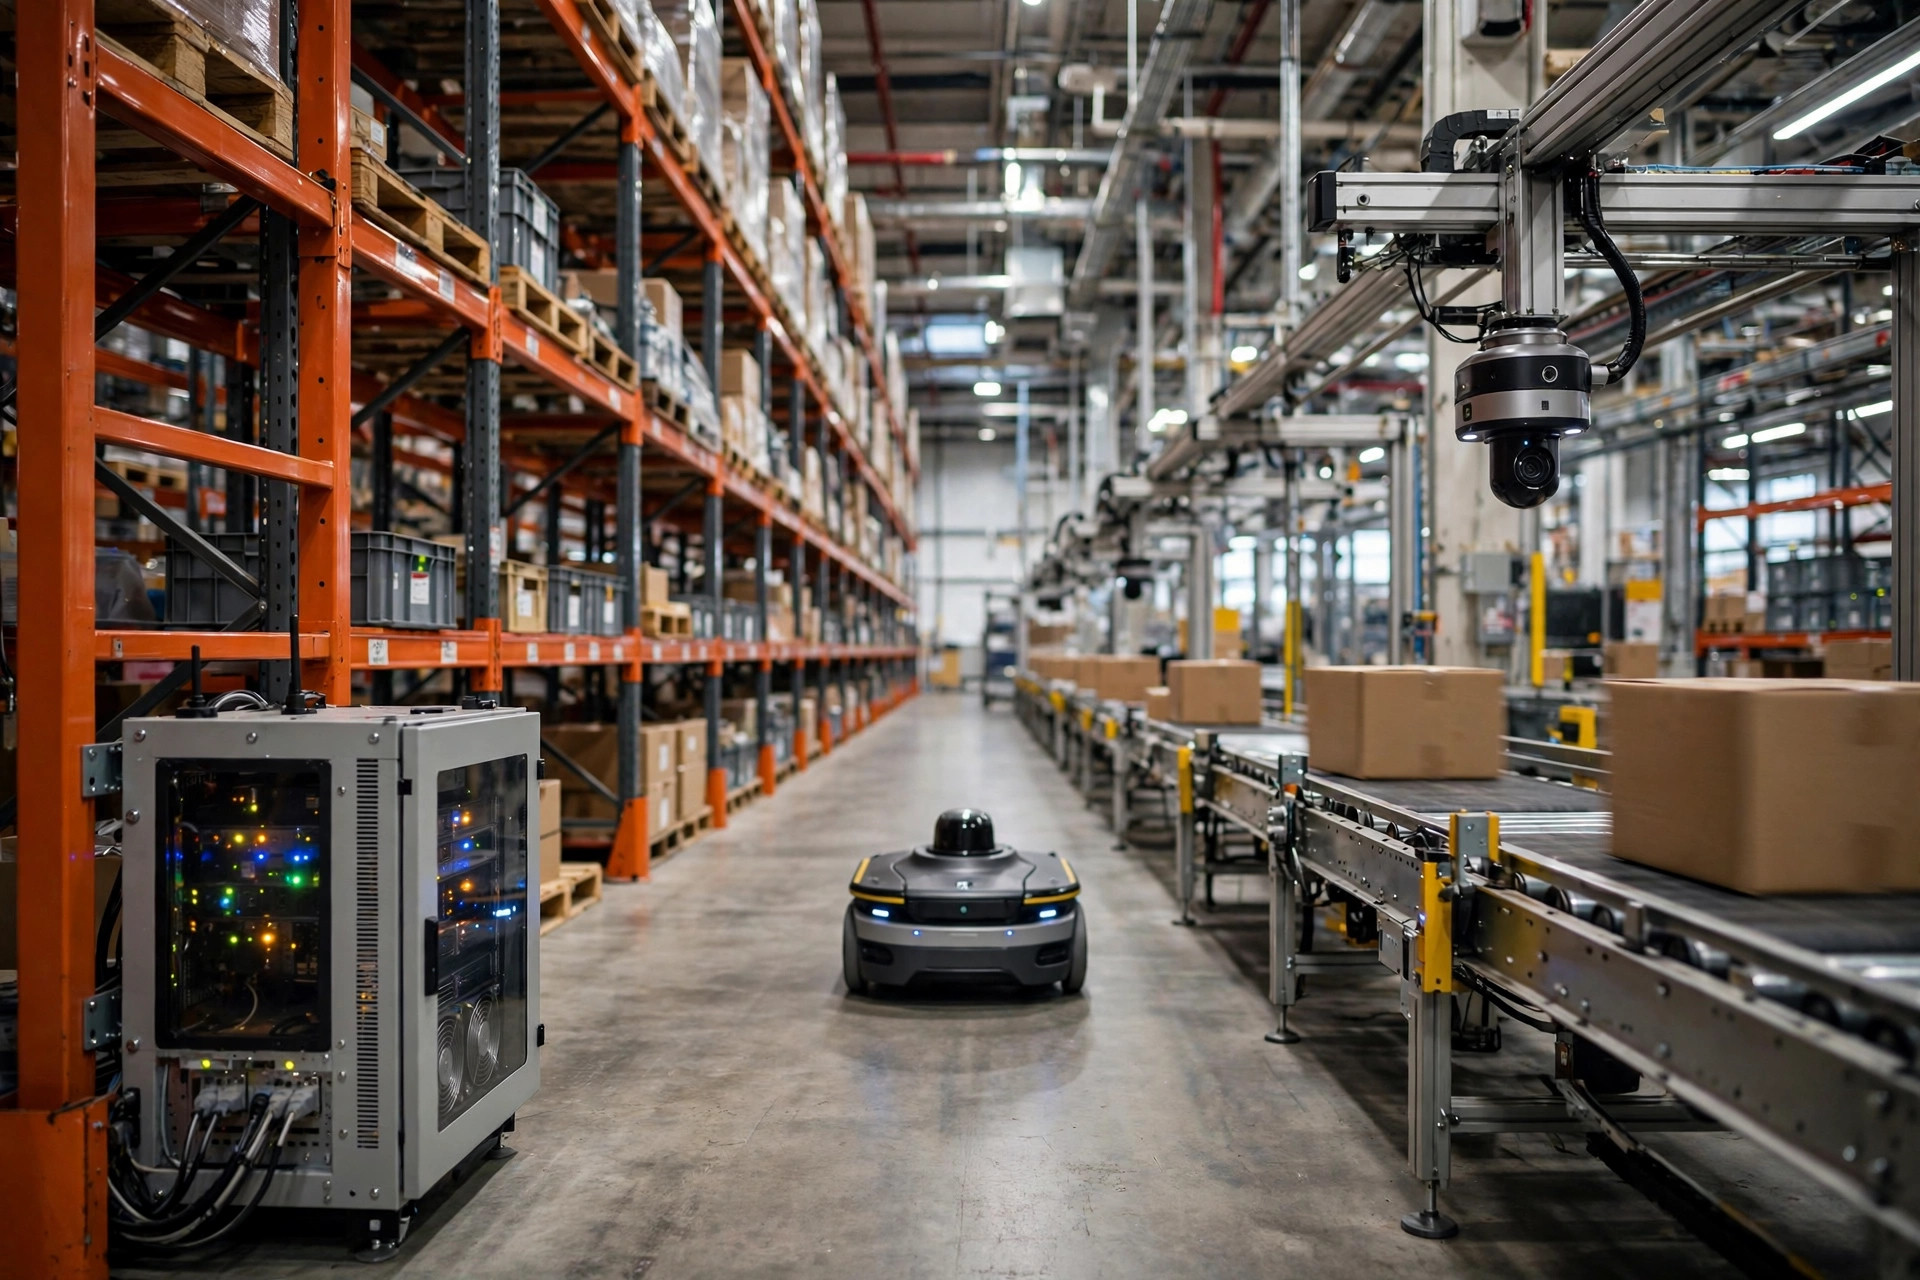
No ano passado visitei um armazém de e-commerce em Riverside que acabava de instalar um sistema de inspeção por visão: seis câmeras sobre a esteira, checando os rótulos dos pacotes por danos e má aplicação. A configuração executava a inferência na nuvem: os fluxos de vídeo eram enviados para uma nuvem pública, processados em GPU, os resultados voltavam. Na primeira semana de operação, quebrou: nos horários de pico os resultados chegavam meio tempo atrasados, os cilindros pneumáticos de rejeição nunca receberam o sinal, e uma dúzia de pacotes problemáticos foi direto para as rampas de separação. O gerente de TI me disse: «Ninguém mencionou a latência antes de assinarmos o contrato».
Meu veredito, de cara: para a IA em um armazém, a diferença entre 10 ms e 300 ms não é um problema de experiência do usuário, é um problema de saber se pode funcionar ou não. Onde você implanta a inferência decide se sua IA é um ativo de produção ou um ornamento caro.
A matemática da latência
A câmera captura um quadro, envia para a nuvem, a inferência roda, o resultado volta: tipicamente 100–300 ms de ida e volta, e isso em um dia bom. Você sabe como são as redes de um armazém: as estantes metálicas são um bloqueador natural de sinal, zonas mortas de Wi-Fi estão por toda parte, e o congestionamento da alta temporada pode dobrar a latência.
Implantação em edge? Um dispositivo edge robusto com computação GPU instalado em um gabinete perto da linha executa a inferência em 10–50 ms. Da câmera ao dispositivo pela rede local, às vezes com conexão direta.
Três regras duras para quando o edge é obrigatório:
Primeiro, controle em malha fechada. Rejeição, separação, desvio de obstáculos de AMRs: tudo aquilo em que «a IA termina e a máquina precisa se mover agora mesmo». A uma velocidade de esteira de 2 m/s, 300 ms de latência significam que o pacote já avançou mais 0.6 m. Você perdeu o ponto de desvio.
Segundo, tudo relacionado à segurança. Em zonas mistas de pedestres e veículos, rodar o desvio por visão dos AMRs pela nuvem é entregar seus freios ao jitter da rede. Meu veredito: edge, sem discussão.
Terceiro, inferência de alta frequência. Uma câmera a 30 fps, 16 horas por dia: a cobrança em nuvem por chamada de API ou por hora de GPU fica assustadora rápido. Um dispositivo edge é um investimento único que fica mais barato por inferência quanto mais você o usa.
Para que a nuvem realmente serve? Treinamento, iteração de modelos, painéis, análise entre instalações. Trabalhos sem pressão de tempo que precisam de computação elástica. Esse é o terreno da nuvem.
Largura de banda e dinheiro: as linhas esquecidas
A maioria calcula a linha de GPU e esquece a largura de banda. Uma câmera 1080p com codificação H.264 empurra cerca de 4–8 Mbps de subida. Cinquenta câmeras: 200–400 Mbps de subida sustentada. Você sabe quanto custa por mês uma linha dedicada de armazém. Pior ainda é a confiabilidade: uma queda do circuito e a inferência de todas as câmeras cai junta.
As necessidades de largura de banda do edge são quase zero: o vídeo nunca sai do prédio, só sobem os resultados de inferência (alguns KB de JSON) e os snapshots de alerta. Se a internet cair, a linha continua rodando; no pior caso, os alertas chegam atrasados.
É assim que decompõe o dinheiro. A nuvem é pague-pelo-uso, boa para cargas pequenas ou irregulares; o edge é investimento fixo mais depreciação, bom para operação contínua 24/7. A linha divisória é fácil de calcular: liste sua conta anual de inferência em nuvem (GPU + largura de banda + transferência de dados) e compare com a compra de dispositivos edge, depreciação de três anos, energia e manutenção. Minha regra prática: acima de 20 fluxos de câmera em inferência contínua, o edge quase sempre vence. Abaixo de 10 fluxos com baixo ciclo de uso (algumas horas de controle de qualidade por dia), a nuvem é a escolha sem complicação.
Uma armadilha: os fornecedores de nuvem têm mais itens de cobrança do que você imagina: horas de GPU, armazenamento, chamadas de API, saída de dados. Consiga cotações por escrito dos quatro antes de assinar. Se algo estiver incerto, peça confirmação por escrito por e-mail. Não confie no «mais ou menos» do vendedor.
Meu guia de implantação: três níveis
Não use receita única para tudo. Eu divido as implantações em três níveis:
Nível um, edge puro: separação por visão, rejeição, navegação e desvio de obstáculos de AMRs, verificação em tempo real para pick-to-light. Estes recebem dispositivos edge que continuam rodando se a rede morrer. Sobre o hardware: cuidado com calor e poeira: os armazéns rotineiramente ultrapassam 35°C no verão, e GPUs de consumo não sobrevivem. Vá de grau industrial ou ao menos com faixa de temperatura ampla.
Nível dois, inferência em edge mais treinamento em nuvem: este é o padrão dominante. O edge executa a inferência; as amostras difíceis voltam para a nuvem; a nuvem retreina e distribui os modelos atualizados. Sobre a estratégia de envio: nunca envie tudo. Envie apenas as amostras em que o modelo ficou em dúvida (baixa confiança) e você corta a largura de banda em mais de 90%.
Nível três, nuvem pura: previsão de demanda, sugestões de reposição, painéis de operação, relatórios entre armazéns. Sem requisito de tempo real, e a computação elástica da nuvem com suas ferramentas de dados prontas para uso são vantagens genuínas.
Um detalhe operacional: quando você tem mais do que um punhado de dispositivos edge, o gerenciamento de versões de modelos vira uma bagunça. Exija atualizações OTA remotas e reversão. Não mande engenheiros por aí com pendrives. Vi um armazém com 12 dispositivos edge rodando 4 versões diferentes de modelo; a solução de problemas levou uma semana.
Sequência de implantação: não cubra o prédio inteiro no primeiro dia
O maior erro que vejo nas primeiras implantações de visão por IA é apostar tudo na instalação inteira. Minha implantação em três etapas:
Passo um, piloto em um único ponto. Escolha sua linha mais dolorosa — controle de qualidade de devoluções ou inspeção de etiquetas — com apenas 2–4 câmeras e um dispositivo edge. Rode o piloto por 4–6 semanas. O objetivo ainda não é economizar dinheiro; é produzir três tabelas: latência, precisão e taxa de falsos positivos. Se os falsos positivos ultrapassarem 5%, a equipe de piso começa a ignorar os alertas: vigie esse número como um falcão.
Passo dois, feche o ciclo de iteração do modelo. Quando o piloto estiver estável, conecte o pipeline de envio de inferência em edge mais treinamento em nuvem. Sobre o trabalho de rotulagem: as amostras difíceis podem chegar a centenas por dia, e alguém tem que rotulá-las. Minha abordagem é fazer a equipe de controle de qualidade rotular enquanto trabalha: o sistema envia os snapshots de baixa confiança para um tablet, a pessoa de controle de qualidade toca em «certo/errado», e a rotulagem não custa essencialmente nada.
Passo três, replique. Expanda para outras linhas apenas quando a precisão estiver estável acima de 98% e os falsos positivos abaixo de 3%. A essa altura você estará comprando dispositivos edge em volume, o que tipicamente corta mais 15–20% do custo unitário.
Mais uma nota prática: modernização de rede em prédios antigos. O edge perdoa as redes, mas não dispensa elas: leve conexões cabeadas das câmeras ao dispositivo edge; não economize no Wi-Fi para tudo. Alguns milhares de dólares em cabeamento por linha não são nada diante de um ano de largura de banda em nuvem.
Uma ação que você pode tomar amanhã: liste cada cenário de IA em execução (ou planejado) no seu armazém e pontue cada um em três colunas: requisito de latência, frequência de inferência, número de câmeras. Tudo que precisar de <100 ms vai para o edge. Baixa frequência e poucas câmeras vão para a nuvem. O meio-termo recebe o híbrido: inferência em edge mais treinamento em nuvem. Feita essa tabela, nenhum fornecedor consegue te enrolar na arquitetura.
Sua IA de armazém roda no edge ou na nuvem? Já se queimou com a latência? Me conte nos comentários.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.





