L'an dernier, je me tenais dans un entrepôt d'accessoires 3C à regarder un tout nouveau système de vision sur le convoyeur. Son travail : lire les étiquettes SKU sur les cartons et remplacer le scan manuel. La démo avait l'air superbe. Puis de nouveaux produits ont été lancés, et la première semaine le système a classé avec confiance les 37 nouveaux SKU comme des anciens. Les caméras étaient bonnes. L'algorithme était bon. Le modèle n'avait simplement jamais vu ces visages — et a quand même choisi la "plus proche" ancienne catégorie.
C'est le défaut fatal des classifieurs classiques : ils ne peuvent choisir que parmi les catégories qu'on leur a enseignées. Mettez une question jamais vue à l'examen et ils écriront quand même une réponse. Le few-shot learning existe pour corriger exactement cela.
Ce qu'il apprend réellement
Un classifieur d'images traditionnel mémorise à quoi ressemble chaque catégorie. Montrez-lui des milliers de photos du produit A et il se souvient du visage de A ; montrez-lui une nouvelle image et il demande : ressemble-t-elle plus à A, B ou C ? Notez le "ou" — il suppose que la réponse doit être l'une des catégories connues. Un nouveau SKU, aussi distinctif soit-il, se retrouve casé de force dans un vieux seau. C'est ainsi que 37 nouveaux SKU sont morts la première semaine.
Le few-shot learning inverse la logique : au lieu de mémoriser "qui c'est", il apprend "si ça se ressemble". Pendant l'entraînement, le modèle apprend à transformer une image en une chaîne de nombres — un embedding. Les images d'aspect similaire obtiennent des nombres proches ; celles d'aspect différent, des nombres éloignés. Au go-live, un nouveau SKU arrive, vous photographiez 5 à 20 vues de référence, et le système se souvient où se situent ces nombres. Chaque nouvelle image après cela est jugée par la distance : la référence la plus proche remporte l'étiquette.
L'analogie humaine : un classifieur classique est un examen à livre fermé — testé uniquement sur ce qu'il a étudié. Le few-shot learning, c'est comme reconnaître un inconnu — voir un visage deux fois, s'en souvenir, le repérer dans la foule la fois suivante. Pas besoin de connaître le nom ni le métier de la personne. Se souvenir du visage suffit.
Une implémentation courante, le réseau prototypique, est encore plus littérale : moyenner les quelques vues de référence de chaque catégorie en un "visage moyen", et assigner chaque nouvelle image à la moyenne la plus proche. Simple à implémenter, et suffisant pour pas mal de tâches d'entrepôt.
Où il brille — et où il ne brille pas
Commençons par où il brille. Les SKU qui se distinguent clairement les uns des autres — emballages de couleurs différentes, tailles de cartons différentes, produits physiquement distincts — sont son terrain de prédilection. Un nouveau SKU est lancé, les opérations prennent une douzaine de photos et les téléversent, et ça marche en une demi-heure. Pas de cycle d'étiquetage et de réentraînement de deux semaines.
L'emballage stable aide aussi. Certains consommables gardent le même emballage pendant des années ; tirez les références une fois et elles servent pendant des lustres.
Maintenant les zones interdites. Premièrement : l'habillement avec le même modèle en cinq couleurs. Visuellement quasi identique à part la couleur, distingué en pratique par les étiquettes pendantes et les étiquettes d'entretien — invisibles pour une caméra à vitesse de convoyeur. Forcer ne produit que des erreurs confiantes. Scannez le code-barres et passez.
Deuxièmement : l'emballage transparent ou réfléchissant. Changez l'éclairage et le "visage" change ; les distances d'embedding s'effondrent. À moins que votre contrôle d'éclairage soit de qualité industrielle, n'espérez pas que ça marche.
Troisièmement : les catalogues qui tournent à des centaines de SKU par mois. Chaque nouveau SKU nécessite des photos de référence prises, revues et classées — c'est du travail soutenu. Laissez la bibliothèque de références pourrir et la précision se dégrade silencieusement en un trimestre, et vous ne le saurez même pas.
Trois pièges du déploiement
Piège un : des références prises trop "propres". On fait poser les produits au bureau par les opérations — fond blanc, angle de face, lumière parfaite. Puis le convoyeur sert des images inclinées, floues, ombrées et rien ne correspond. Tirez les références sur le vrai convoyeur, sous la vraie lumière, à la vraie vitesse : 8 à 12 vues par SKU, angles multiples, un peu d'inclinaison, et incluez aussi les emballages sales et abîmés. Plus les références sont proches des conditions de combat, mieux ça marche.
Piège deux : pas d'option "je ne sais pas". Aussi loin que soit la distance, le système choisit quand même la plus proche — il a toujours une réponse. Il faut un seuil de distance : au-delà, l'image est déclarée inconnue et routée vers un humain. Ce seuil n'est pas de l'intuition ; faites passer deux semaines de données réelles dedans et trouvez où les fausses acceptations et les faux rejets s'équilibrent.
Piège trois : ne jamais chiffrer le coût d'une mauvaise identification. Une mauvaise identification coûte le fret de l'envoi erroné plus le retour plus le temps du service client. Une revue humaine coûte quelques secondes de travail. Votre travail est de trouver la rigueur de seuil qui minimise le coût total. Ce calcul est différent pour chaque entrepôt — ne copiez pas les paramètres d'un autre.
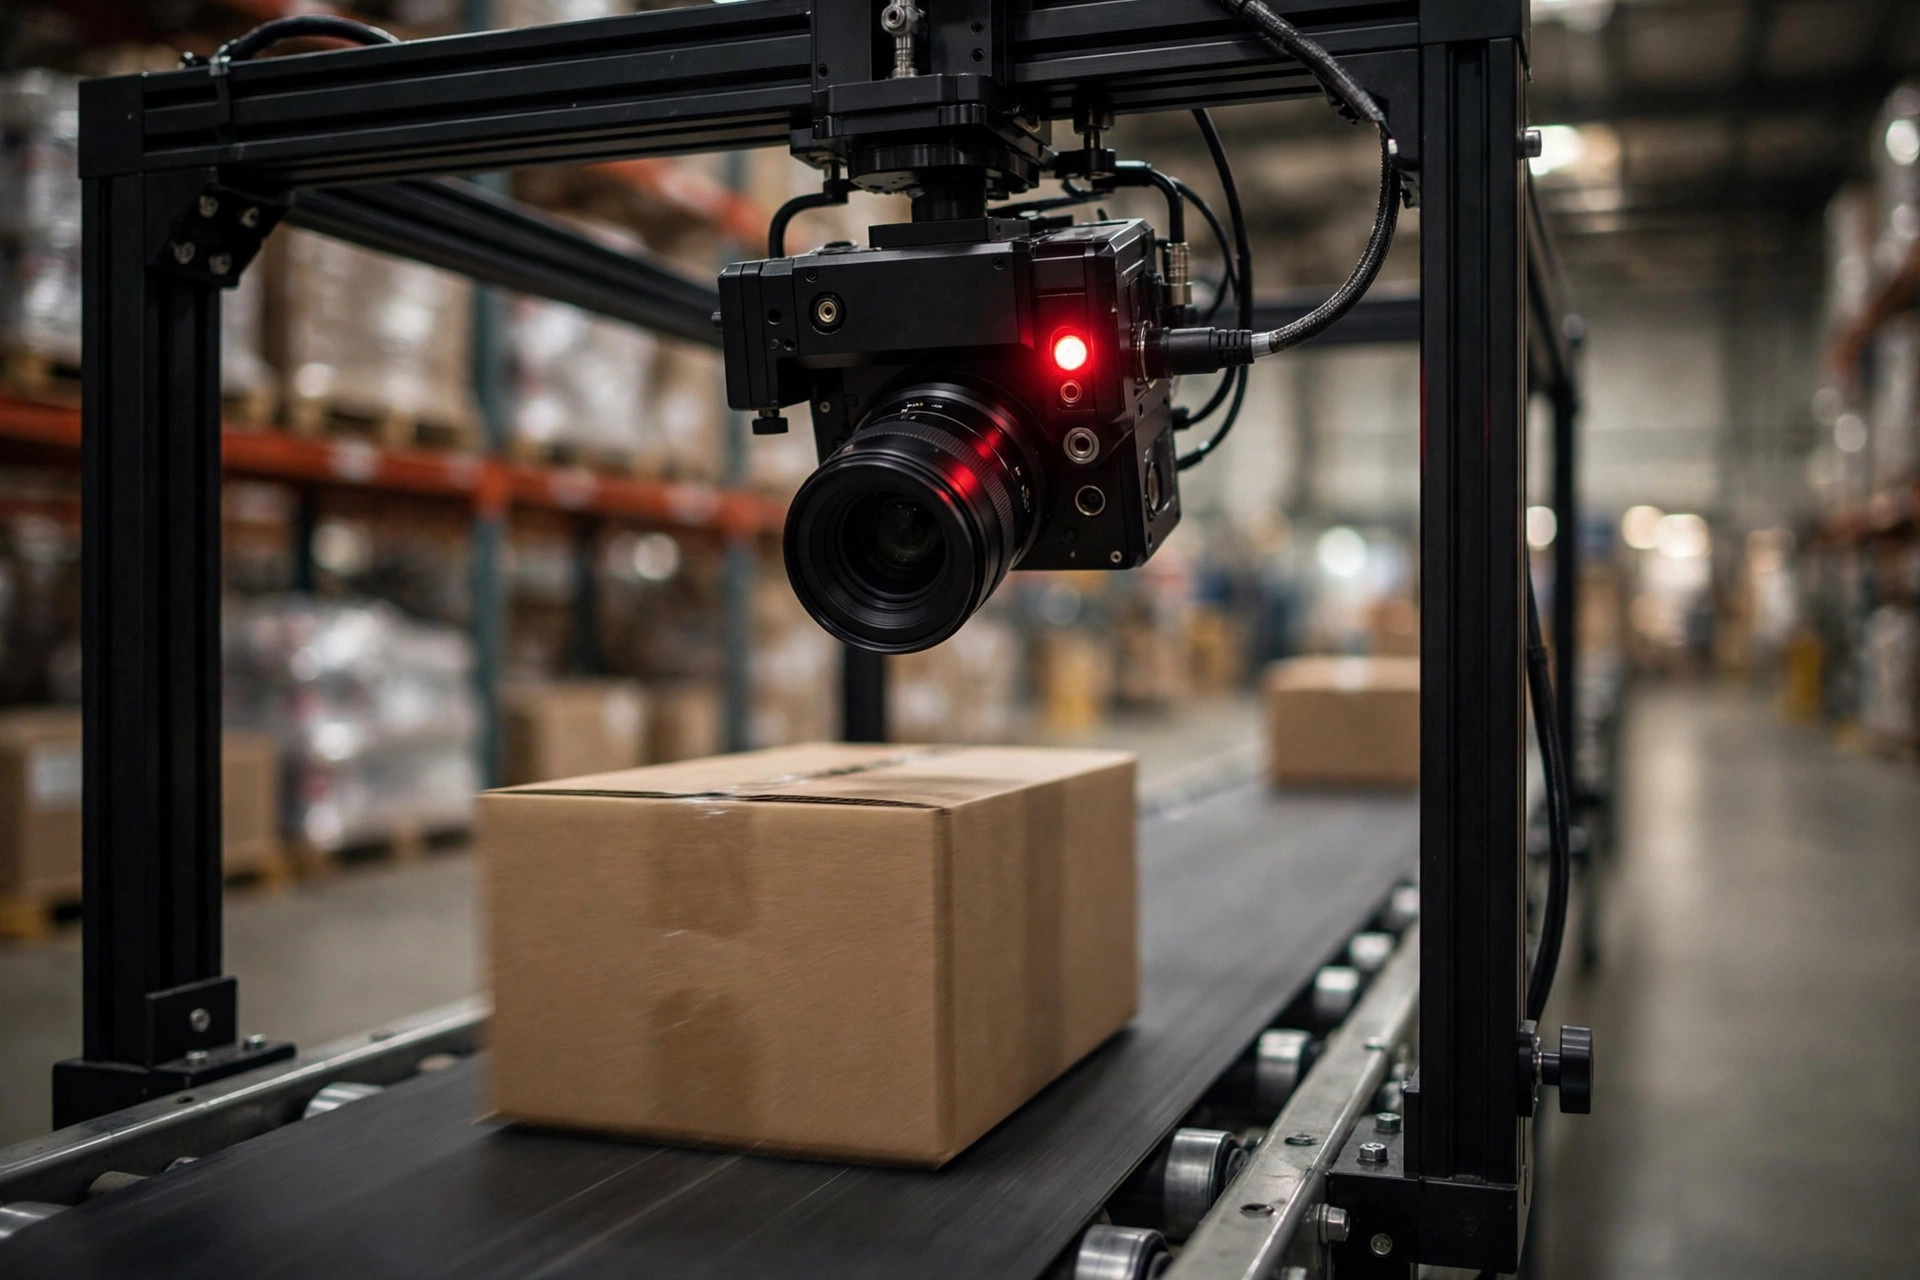
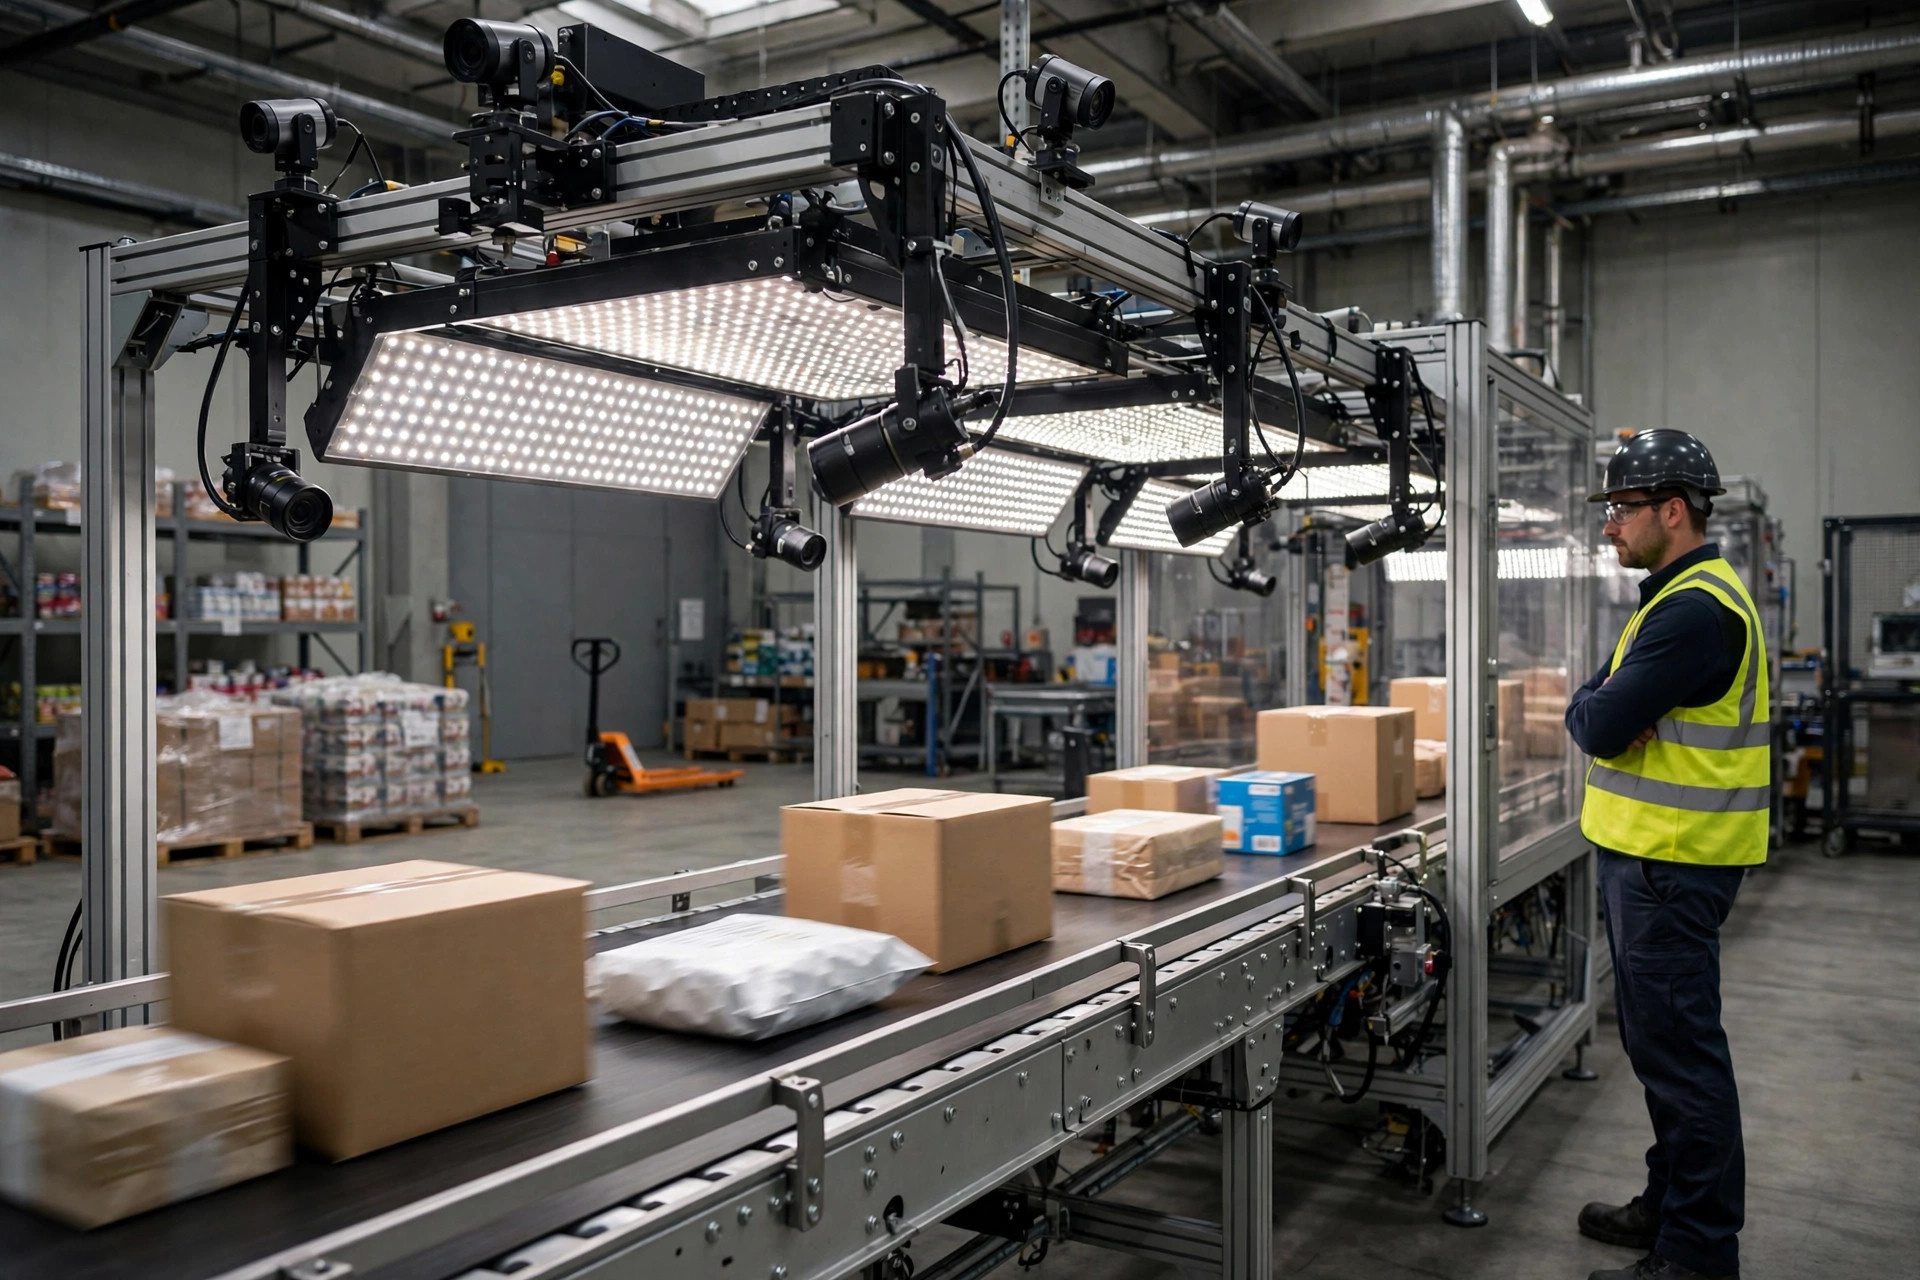
Une note matériel : ne lésinez pas sur la caméra. Une caméra industrielle comme la Basler ace associée à un éclairage LED stable produit des images bien plus consistantes qu'une webcam générique. Le few-shot learning est sensible à la consistance des images ; économiser quelques milliers de dollars au départ et perdre cinq points de précision ensuite est le pire des marchés.
Un lancement en quatre semaines qui marche
Semaine un : tirez les références sur le convoyeur, en vraie lumière, à vraie vitesse. Incluez les cas difficiles — inclinés, à moitié occultés, emballages froissés. La qualité des références fixe le plafond ; ne précipitez pas cette semaine.
Semaine deux : fixez le seuil. Faites passer deux semaines de données historiques dedans et trouvez le point d'équilibre entre fausses acceptations et rejets. Biaisez vers plus de revue humaine, pas moins — un envoi erroné coûte des dizaines de fois ce que coûte une revue.
Semaine trois : pilotez sur un convoyeur, ou sur 20 SKU. Revoyez chaque mauvaise identification quotidiennement et remplacez les mauvaises références. Vous découvrirez des paires de SKU qui "ont l'air différents mais en fait non" — traitez-les maintenant.
Semaine quatre : montez en charge, et verrouillez le processus de maintenance — qui photographie les nouveaux SKU, à quelle fréquence les vieilles références sont revues, à quelle fréquence le seuil est réétalonné. Un système sans processus de maintenance se dégradera en trois mois. Garanti.
Quoi demander au fournisseur
La démo de chaque fournisseur de vision est superbe. Avant de signer, posez cinq questions.
Un : combien de temps faut-il pour qu'un nouveau SKU passe en production ? Si la réponse est "réentraîner le modèle, deux semaines", c'est un classifieur classique déguisé en few-shot. Le vrai few-shot signifie ajouter des références, pas réentraîner — une demi-heure, pas deux semaines.
Deux : quels sont le taux de mauvaise identification et le taux de "je ne sais pas", séparément ? Quiconque ne cite que la précision cache quelque chose. 99 % de précision avec 30 % routés vers les humains signifie qu'un tiers du travail reste manuel.
Trois : comment gère-t-il la dérive d'éclairage ? Demandez-leur de baisser de moitié les lumières de la salle de démo et de recommencer. Pas mal de systèmes atteignent 99 % sous l'éclairage de showroom et tombent à 90 % quand la moitié des tubes de l'entrepôt a vieilli.
Quatre : combien de catégories de SKU la bibliothèque de références peut-elle contenir ? Certaines configurations de recherche d'embeddings ralentissent fortement au-delà de quelques milliers de catégories. Si votre catalogue tourne à cinq chiffres, demandez maintenant.
Cinq : fonctionne-t-il hors ligne ? Edge ou cloud ? Un convoyeur déplace des dizaines de cartons par minute ; un hoquet réseau dans une configuration cloud arrête toute la ligne. Pour le travail d'entrepôt, je ne recommande que le déploiement edge.
Tout fournisseur qui répond proprement aux cinq mérite une discussion de prix. Celui qui ne peut pas — aussi léchée soit la démo — vend une pièce de foire, pas un outil de production. La technologie n'est pas magique. L'utiliser au bon endroit, si.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.