Imaginez un entrepôt de retours qui gère 20,000 SKUs. Le manuel traditionnel de la vision par ordinateur dit : photographiez 500 images d'entraînement par SKU. Cela fait 10 millions d'images. Je vous épargne le calcul : cette route ne mène nulle part.
Ces derniers temps, de plus en plus d'exploitants me posent des questions sur le few-shot learning, et le discours est toujours le même : "Nous avons trop de SKUs pour l'entraînement traditionnel. On nous dit que le few-shot n'a besoin que d'une poignée d'images par produit, est-ce notre porte de sortie ?" Ma réponse est toujours la même aussi : oui, c'est une porte de sortie, pour environ la moitié de vos cas d'usage. Pour l'autre moitié, elle ne peut même pas passer la porte. Aujourd'hui, je trace cette ligne.
Le few-shot, expliqué d'un souffle
Le deep learning traditionnel mémorise. Il doit apprendre à quoi ressemble chaque SKU à partir de zéro, ce qui signifie lui donner des centaines ou des milliers d'images par produit. Le few-shot learning reconnaît plutôt des airs de famille. Le modèle de base a déjà vu des dizaines de millions d'images et a appris la grammaire générale de la forme, de la couleur et de la texture. Vous lui montrez 3 à 5 photos de chaque SKU, et il identifie les produits par similarité, plutôt comme reconnaître un cousin que comme réciter un manuel.
Ce n'est pas une science nouvelle. Les chercheurs y travaillent depuis des années : le jeu de données ouvert SKU-110K contient 11,743 images, plus de 1.7 million de boîtes annotées et plus de 110,000 SKUs uniques (CVPR 2019), et un article de 2024 a poussé la classification one-shot de SKUs à partir d'une seule image prototype. Ce qui a changé, c'est que les modèles de base sont devenus assez puissants ces deux dernières années pour être déployables. La technologie était prête ; ce qui manquait, c'était que les exploitants sachent où elle appartient.
Où le few-shot suffit
Mon test est simple. Deux questions : quelle marge d'erreur avez-vous, et à quelle vitesse votre catalogue de SKUs change-t-il ?
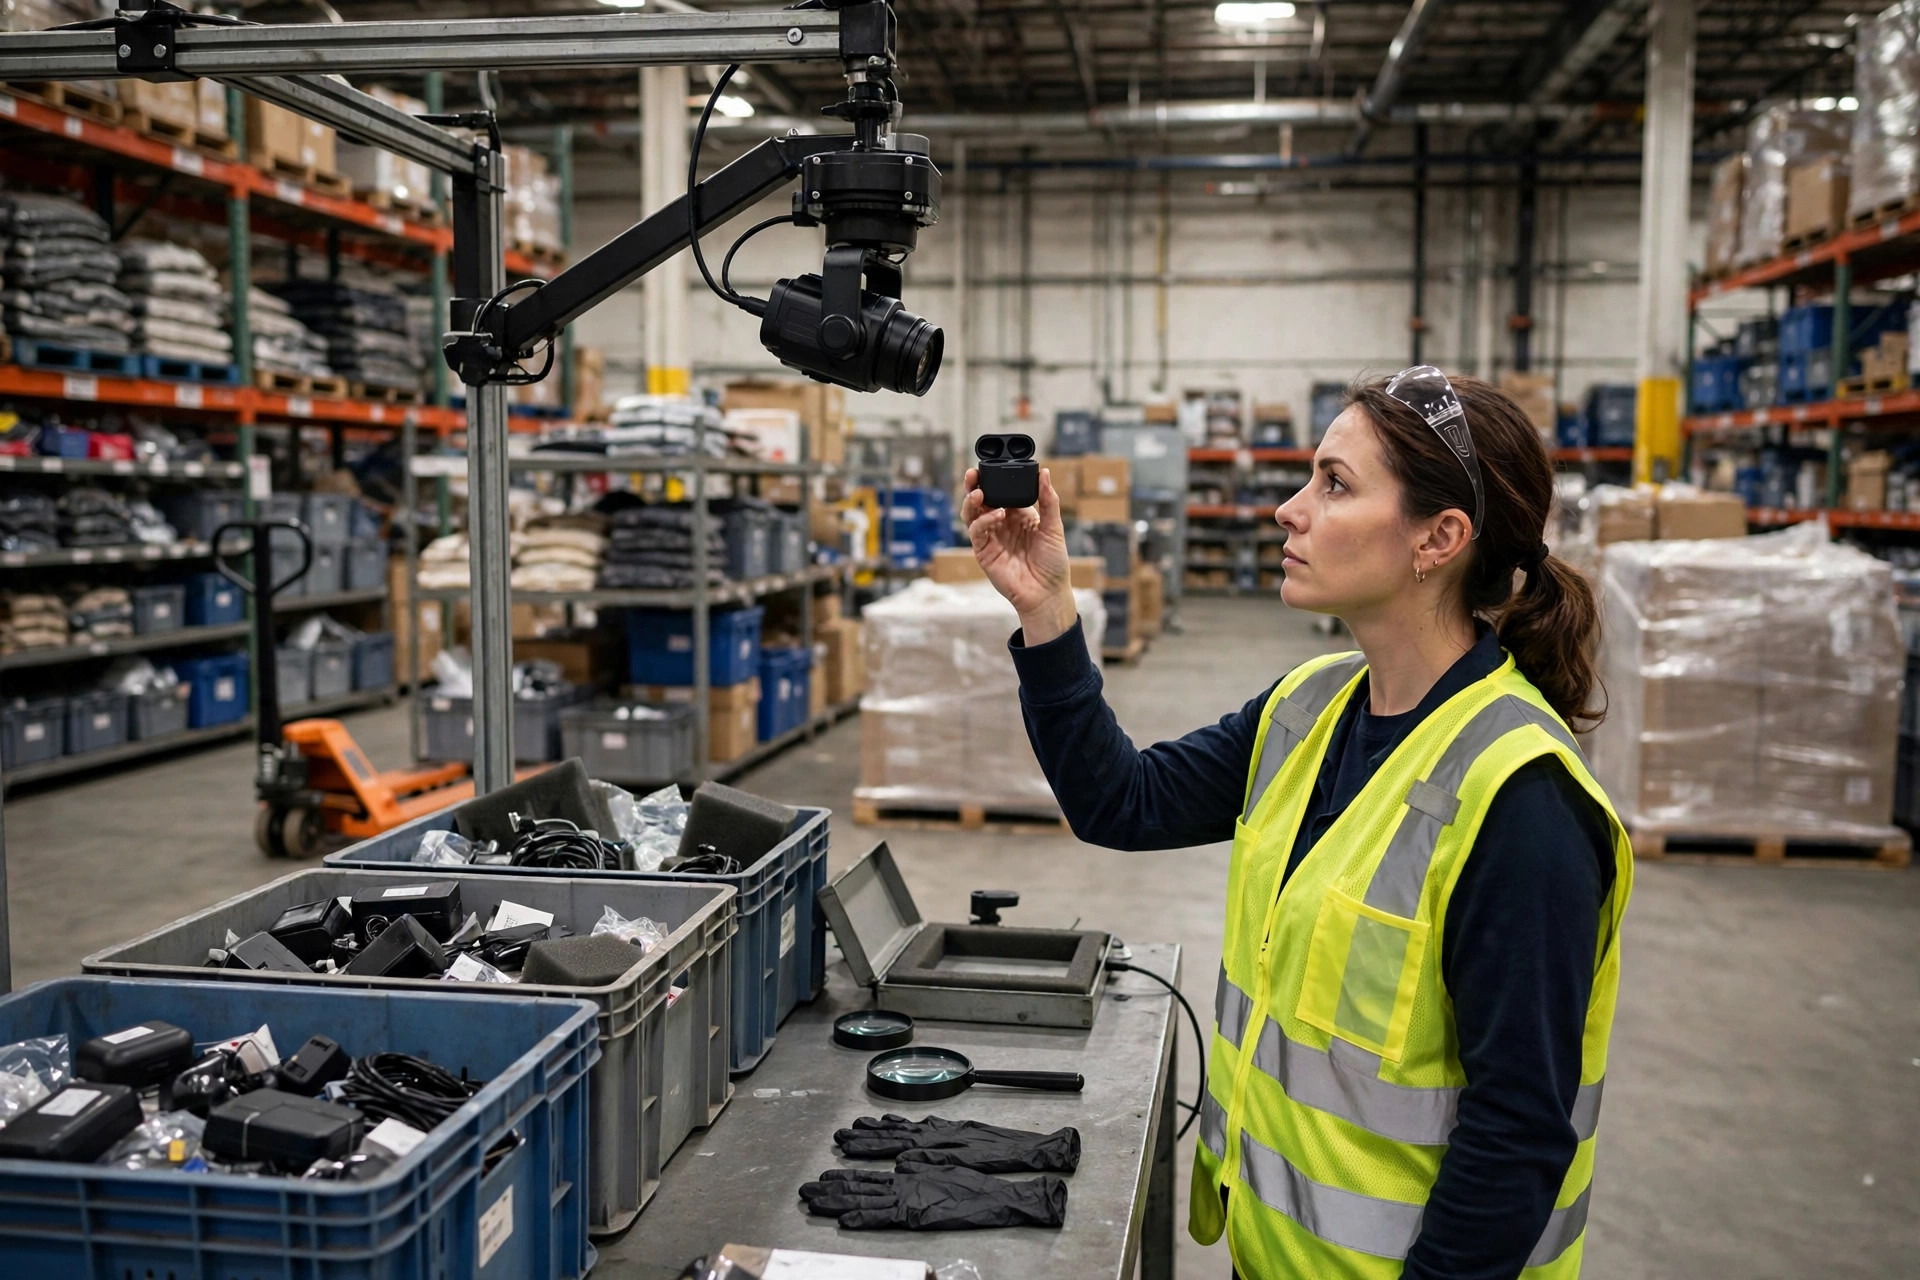
L'inspection des retours est le meilleur cas que j'aie vu. Les marchandises retournées sont un mélange long-tail désordonné : quantité de SKUs vendent quelques dizaines d'unités par an, et vous ne réunirez jamais des centaines d'images d'entraînement pour eux. Un inspecteur tient l'article devant une caméra, le système identifie le SKU et affiche la fiche produit, et l'inspecteur y jette un coup d'œil pour confirmer. Il se trompe sur un ? L'humain le corrige, l'image revient comme un nouvel échantillon, et le système s'affine la fois suivante.
L'autre cas est le tri visuel en tant que second avis. Pensez à un entrepôt transfrontalier plein de marchandises en vrac sans codes-barres, ou de cartons dont les étiquettes ont été collées de travers et ne se scannent pas. La vision few-shot propose un candidat ; une personne ou un scan de code-barres tranche. Notez le mot "candidat" : elle suggère, elle ne décide pas.
Ce que ces scènes partagent : basse vitesse, faible volume, et un filet de sécurité humain derrière le modèle. Plus vous avez de SKUs, moins chacun reçoit d'échantillons, plus la queue est longue, plus l'avantage du few-shot est grand. Dans ces scénarios, l'approche traditionnelle n'est pas seulement chère, elle est impraticable. Personne ne va photographier 500 images pour un SKU de longue traîne qui écoule 30 unités par an.
Où il faut rester à l'écart
D'abord, l'évidence : le tri à haute vitesse. Un trieur qui pousse des centaines de cartons par minute exige une précision de reconnaissance extrêmement élevée (validez-la sur vos propres données), et vous ne l'obtiendrez pas d'un modèle qui a vu trois photos de chaque SKU. L'approche honnête pour les lignes à haute vitesse est l'entraînement étiqueté à grande échelle, ou de sauter la vision entièrement au profit de codes-barres fusionnés avec des capteurs de poids et de dimensions. Plus la ligne est rapide, moins le few-shot a d'air pour respirer. C'est de la physique, pas un problème de réglage.
Deuxième piège : les SKUs qui se ressemblent presque. Deux shampooings de la même gamme de marque, même emballage, ne différant que par la taille de la bouteille imprimée en petits caractères, c'est exactement là que la reconnaissance par airs de famille est la plus faible. J'ai vu une équipe y brûler des mois : le modèle identifiait mal les produits avec une confiance totale, les humains devaient revérifier chaque article, et la ligne a fini plus lente que le travail purement manuel, plus le coût du matériel.
Troisièmement : partout où les conditions d'imagerie ne restent pas en place. Le sol d'un entrepôt n'est pas un laboratoire. Une caméra au-dessus d'un convoyeur, une lumière qui clignote, un carton penché, et la précision chute d'une falaise. Avec seulement quelques échantillons par SKU, une photo floue peut empoisonner un cinquième de vos données d'entraînement. Ironiquement, le few-shot exige une discipline de prise de vue plus stricte que l'entraînement complet, ce qui nous amène au déploiement.
Le déployer : quatre étapes
Étape un : choisissez un modèle de base ; n'entraînez pas à partir de zéro. Les modèles de base de vision ouverts et commerciaux sont tous assez capables désormais. La vraie question est lequel performe sur les images de produits, pas lequel domine les benchmarks génériques. Faites passer vos propres marchandises pendant deux semaines et mesurez vous-même la précision top-1. Ne croyez pas le deck du vendeur. Deux semaines de tests honnêtes coûtent moins cher que six mois de reprise.
Étape deux : figez une spécification de prise de vue. C'est la partie la plus sous-estimée de tout le projet. Position de caméra fixe, éclairage fixe, fond fixe, 3 à 5 angles par SKU. Chaque image doit compter. Imprimez la spécification, plastifiez-la, scotchez-la au poste d'inspection pour qu'elle survive aux changements d'équipe et aux nouvelles recrues.
Étape trois : construisez la boucle des cas difficiles. Tout ce que le modèle rate ou signale avec une faible confiance entre dans une file de révision ; une fois qu'un humain confirme la bonne étiquette, l'image revient comme un nouvel échantillon. Une fois cette boucle en marche, le modèle compose : il s'améliore plus vous l'utilisez. C'est le plus grand avantage opérationnel du few-shot sur l'entraînement traditionnel : ajouter un nouveau SKU signifie prendre quelques photos et passer en production en quelques minutes, pas réunir un jeu de données et réentraîner.
Étape quatre : gardez un humain dans la boucle, en permanence. Tout ce qui est sous votre seuil de confiance passe en révision manuelle. Cette ligne n'est pas optionnelle. Dans un entrepôt, le meilleur siège de l'IA est toujours celui du copilote ; le volant reste aux humains.
Les chiffres : trois approches côte à côte
D'abord l'entraînement entièrement étiqueté. Les guides de prix du secteur situent l'annotation basique de classification d'images autour de $0.03 à $0.10 par image (d'après le guide des coûts d'étiquetage de basic.ai). Ça semble bon marché, jusqu'à ce que vous comptiez la collecte : photographier, organiser, contrôle qualité, contrôle de versions, tout du travail humain. 20,000 SKUs fois 500 images, c'est 10 millions d'images. Cette facture de main-d'œuvre écrase toute opération de taille moyenne. L'entraînement complet n'a de sens que là où les SKUs sont peu nombreux, stables, et où les exigences de précision sont extrêmes.
La voie few-shot : 3 à 5 images par SKU transforment 20,000 SKUs en 60,000 à 100,000 images, deux ordres de grandeur de moins. Le coût d'annotation disparaît pratiquement, puisque l'étiquetage se fait naturellement au moment de la capture. La vraie dépense est le travail initial : valider un modèle de base et faire respecter la spécification de prise de vue. Investissement unique, rendements composés.
Et la troisième voie que les gens oublient : les codes-barres et les règles. Si vos produits portent de vrais codes-barres, scannez-les tout simplement : la vision est un pur surcoût. Mon conseil permanent aux clients : si un scanner le résout, ne construisez pas de vision ; si une règle le résout, ne construisez pas d'apprentissage. L'IA ne répare pas les opérations. Si votre référentiel de SKUs est un désordre et que les étiquettes sont collées de travers, réparez le processus avant de parler d'IA. Cet ordre n'est pas négociable.
Pourquoi les retours méritent leur propre section
La NRF et Happy Returns projettent les retours du retail américain en 2024 à $890 billion, soit 16.9% des ventes annuelles des détaillants. La zone des retours est le coin le plus chaotique de n'importe quel entrepôt : le mix de SKUs le plus sauvage, la main-d'œuvre la plus chère, le processus le moins standardisé. Les inspecteurs doivent identifier l'article, juger son état, et décider s'il retourne en stock ou s'il est mis au rebut. De ces trois tâches, l'identification est là où la vision few-shot gagne sa place, parce que les assortiments de retours sont long-tail par nature.
Un avertissement avant de vous enthousiasmer : identifier le SKU n'est que la moitié du travail d'inspection. Juger l'état, neuf, légèrement utilisé, endommagé, reste au-delà de ce que les modèles few-shot actuels font de façon fiable, quoi qu'en dise le vendeur. Faites d'abord la reconnaissance de SKU, laissez le classement d'état aux humains, et avancez en deux phases. N'essayez pas de tout avaler d'un coup.
Une chose à faire dès demain
Si vous avez un poste d'inspection des retours, voici une expérience d'un après-midi : prenez vos 50 SKUs retournés les plus courants, photographiez 5 angles de chacun, et passez-les dans un modèle de base de vision ouvert comme test de récupération par similarité. Vérifiez la précision top-1. Ça ne coûte presque rien, ça prend un après-midi, et ça vous dira quelque chose qu'aucun discours de vendeur ne peut : si cette route mène réellement quelque part pour votre opération. Laissez les données parler.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.