Un système d'optimisation des parcours de picking qui promet de réduire la distance parcourue d'un cinquième entre en production, et trois mois plus tard les préparateurs marchent toujours sur leurs anciens parcours. Ce n'est pas un problème de personnes. C'est un écart entre deux définitions différentes d'« optimal » — celle de l'algorithme et celle du terrain — et la technologie, mature comme elle l'est devenue, n'a jamais été la partie qui coince. La partie qui coince, c'est l'adoption.
Considérons d'abord le phénomène. En 2024, un entrepôt e-commerce de 30,000 mètres carrés dans l'est de la Chine a déployé un système d'optimisation des parcours de picking piloté par l'IA, qui calculait les séquences de picking en temps réel en fonction des profils de commandes, avec une réduction théorique de 15–20% de la distance parcourue par préparateur. Les chiffres du tableau de bord au premier mois étaient magnifiques. Le superviseur, lui, a remarqué autre chose : les préparateurs n'obéissaient que du bout des lèvres — ils acquiesçaient face au système pendant que leurs pieds suivaient les anciens parcours. Trois mois plus tard, une enquête anonyme révélait que plus de la moitié admettait s'écarter « souvent » de la séquence recommandée.
Le même scénario s'est rejoué au premier semestre 2025, cette fois dans un centre de distribution régional d'une chaîne de distribution qui testait le routage dynamique par IA. Le système recommandait un raccourci par la zone de staging qui éliminerait un long détour. Les préparateurs l'ont collectivement refusé et ont pris le chemin le plus long. La raison était banale : la zone de staging était perpétuellement encombrée de marchandises entrantes en attente de mise en stock, et un chariot ne pouvait tout simplement pas passer. L'algorithme lisait un plan d'entrepôt ; les préparateurs lisaient la réalité.
Les données suggèrent qu'il ne s'agit pas d'une anecdote isolée. Dans ma revue d'une douzaine de projets de routage intelligent publiquement rapportés en 2024–2025, presque tous les cas ayant divulgué des résultats réels mentionnaient une version ou une autre de la « déviation d'exécution sur le terrain ». Les dossiers de la presse spécialisée de la même période reviennent sans cesse sur un chiffre largement cité : le picking représente typiquement environ la moitié du coût de main-d'œuvre d'un entrepôt, ce qui est précisément pourquoi c'est le segment que les fournisseurs d'automatisation veulent le plus conquérir — et le plus difficile à conquérir. L'offre technologique s'accélère : les algorithmes de planification de trajectoires, les jumeaux numériques et le positionnement intérieur ont tous mûri ces dernières années. Mais la courbe d'adoption côté demande est nettement plus plate que ce que suggèrent les récits des fournisseurs.
Pourquoi cet écart « précis mais inutilisé » persiste-t-il ? Je l'attribuerais à trois couches de causes, chacune plus proche de la racine que la précédente.
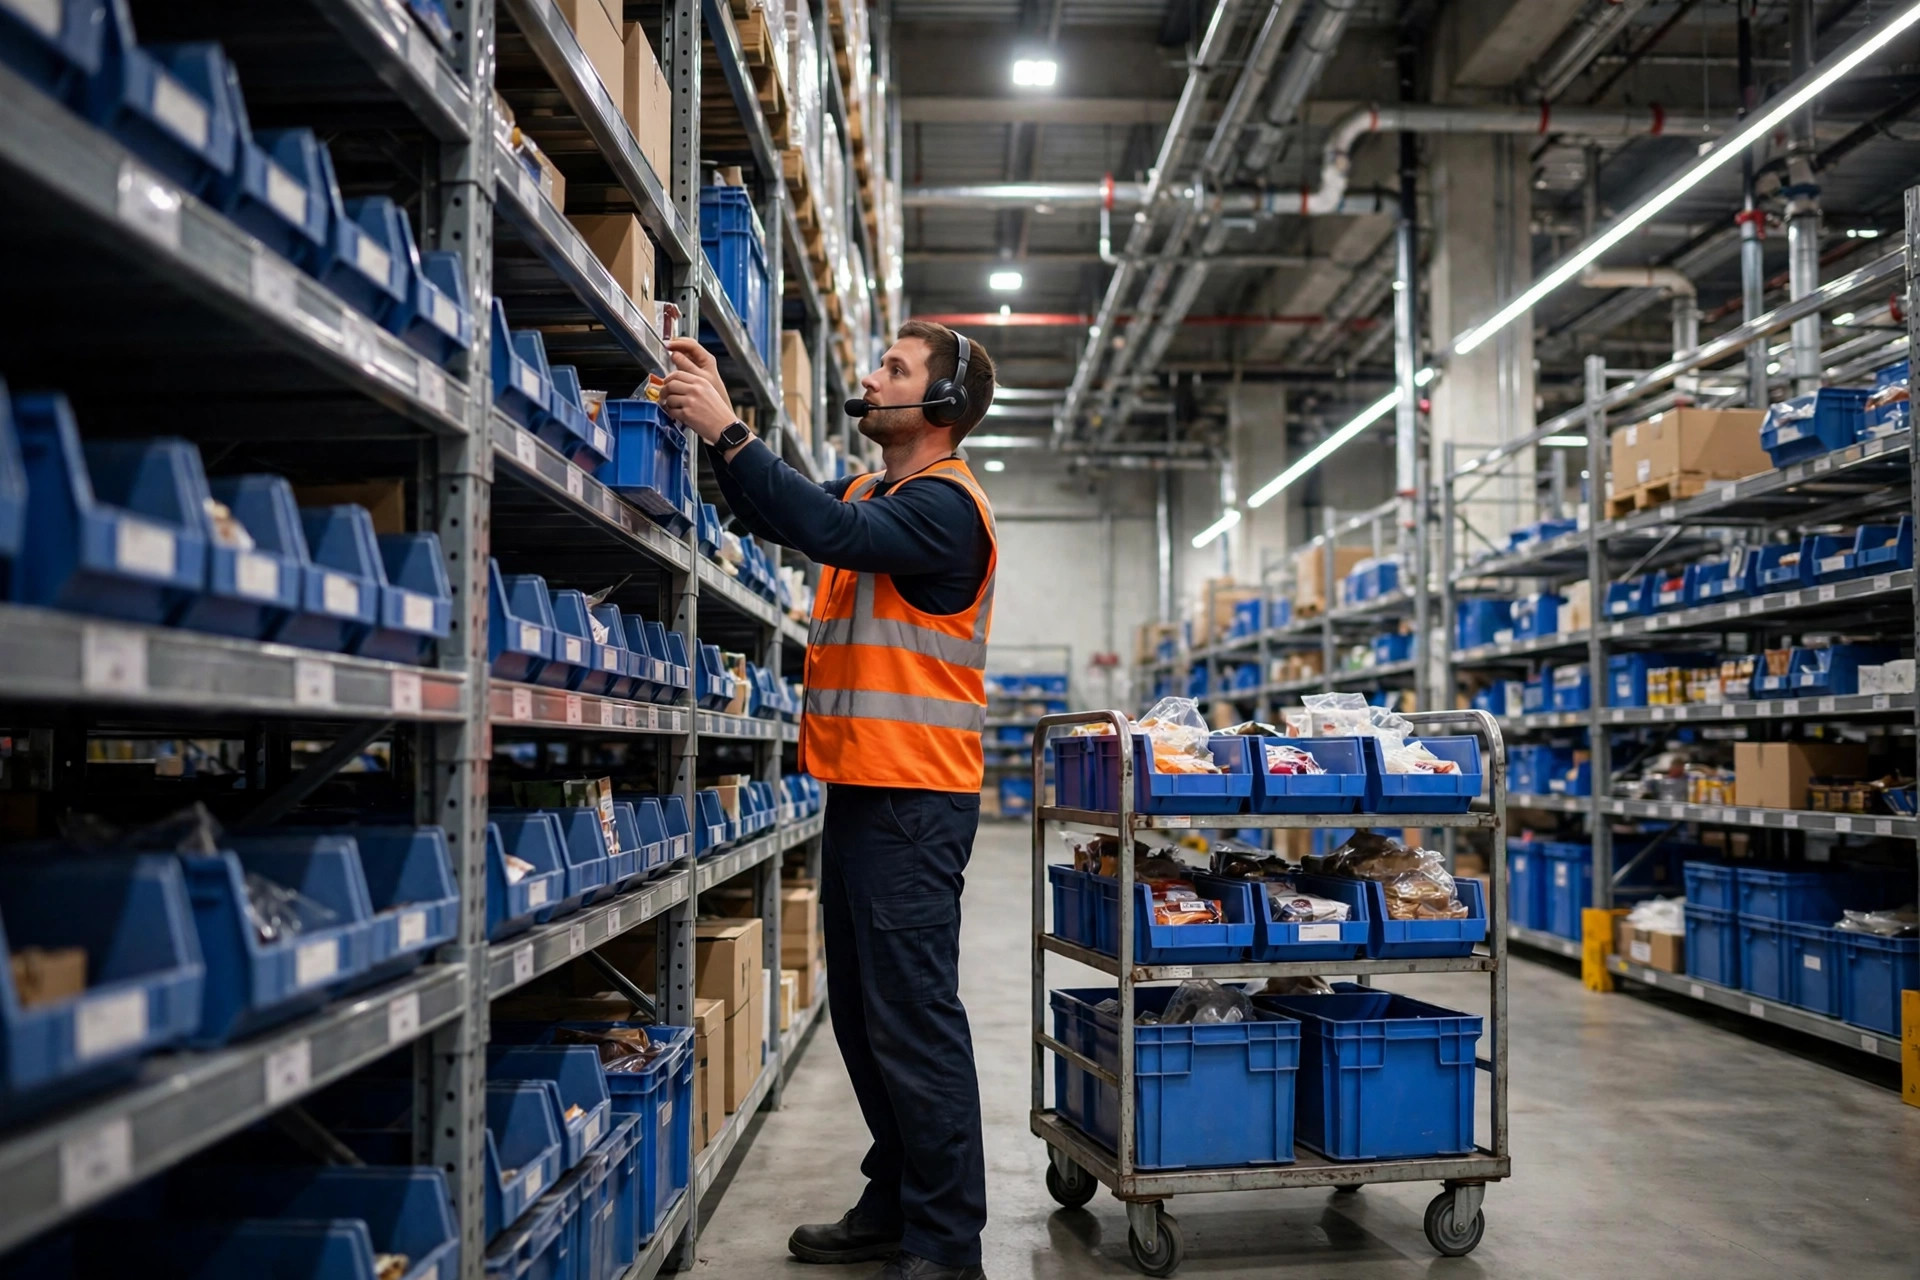
La première couche est le désalignement des incitations, et c'est la plus souvent négligée. Dans beaucoup d'entrepôts, les préparateurs sont payés à la pièce. La fonction objectif du préparateur, c'est les unités préparées par heure ; la fonction objectif de l'IA, c'est la distance totale minimisée. Ces deux objectifs divergent fréquemment : prendre une boucle un peu plus longue qui permet au préparateur de saisir deux articles supplémentaires en un passage et d'éviter un virage est une meilleure affaire pour lui, même si le système l'enregistre comme une déviation. Quand l'algorithme et l'humain optimisent contre des KPI différents, ignorer l'algorithme est un comportement rationnel, pas de la paresse.
La deuxième couche est un déficit de confiance. L'algorithme ne peut pas voir les conditions transitoires du terrain : où sont empilées les têtes de gondole promotionnelles du jour, quelle allée est glissante et mérite d'être évitée, quelle porte de quai est bloquée par des marchandises en attente de mise en stock. Rien de tout cela ne vit dans le système ; tout cela vit dans la tête des préparateurs. Il suffit d'un seul « j'ai suivi le système et je me suis retrouvé dans une impasse » pour fissurer la confiance — et la confiance, une fois fissurée, demande des dizaines de succès pour se reconstruire. Les autopsies des déploiements ratés convergent toujours vers le même détail manquant : le système ne donnait aux préparateurs aucun canal pour signaler les exceptions de terrain. Quand un parcours est impraticable, le choix est de forcer le passage ou de dévier discrètement, et avec le temps, tout le monde dévie discrètement.
La troisième couche, et la plus fondamentale, est la qualité des données. L'optimisation des parcours de picking est, au fond, un système « données pourries en entrée, données pourries en sortie ». Si les données de référence des emplacements sont fausses — le système dit que le SKU A est en B-03 alors qu'il est physiquement en C-11 — alors même un parcours mathématiquement parfait est le plus court chemin sur la mauvaise carte. Dans plusieurs projets que j'ai suivis, les mauvais résultats de routage, une fois creusés d'une couche, révélaient presque toujours des problèmes de données de référence : des écarts d'inventaire tournant durablement supérieurs à quelques pourcents, des changements d'emplacement jamais réenregistrés, un slotting des nouveaux SKU fait au savoir tribal. Les algorithmes ne peuvent pas réparer les problèmes de données. Ils ne peuvent que les amplifier.
Cela mène à une conclusion contre-intuitive qui mérite d'être énoncée clairement : le plus court chemin n'est pas le picking le plus rapide, et ce n'est certainement pas le chemin qu'un préparateur parcourra de bon gré. Les algorithmes optimisent la distance euclidienne ; les préparateurs optimisent la dépense d'énergie et le confort ergonomique — un virage de moins, une montée de moins, éviter une allée encombrée. Des facteurs qui pèsent un poids quasi nul dans la formule de distance pèsent lourd dans la décision humaine. Un moteur de routage fluent en géométrie mais illettré en ergonomie sonne, pour un préparateur, comme de la théorie divorcée de la pratique — et la théorie se fait voter contre à coups de pieds.
Que devrait donc trancher une équipe avant de lancer un projet d'optimisation des parcours de picking qu'elle veut vraiment voir adopter ? L'analyse ci-dessus suggère trois questions obligatoires. Premièrement, quelle est la précision réelle de vos données de référence d'emplacements — les écarts d'inventaire tournant ont-ils été ramenés dans une fourchette acceptable ? Ne parlez pas d'algorithmes sur des fondations branlantes. Deuxièmement, le régime de rémunération des préparateurs est-il d'accord avec l'objectif du système, ou les deux KPI se battent-ils ? Des KPI désalignés garantissent une exécution au rabais. Troisièmement, le système boucle-t-il sur les exceptions de terrain — un préparateur peut-il signaler « ce parcours est bloqué » en un toucher et l'algorithme peut-il en tirer des leçons ? Un système intelligent sans canal de retour est un système en boucle ouverte, et les systèmes en boucle ouverte dérivent dans les environnements complexes. Ce n'est pas une hypothèse ; c'est de la théorie du contrôle.
En regardant vers 2026–2028, ma lecture de la trajectoire technologique est que le secteur passera du calcul du parcours le plus court au calcul du parcours le plus acceptable. Trois observations l'étayent : premièrement, les fournisseurs leaders ont commencé à commercialiser un routage « human-aware » qui modélise explicitement les facteurs ergonomiques dans la fonction objectif ; deuxièmement, la diffusion des wearables et du positionnement intérieur donne aux systèmes leurs premiers vrais jeux de données sur la façon dont les préparateurs marchent réellement — les algorithmes peuvent enfin apprendre les parcours révélés plutôt que les parcours prescrits ; troisièmement, les jumeaux numériques rendent les états transitoires du terrain lisibles par la machine, de sorte qu'une zone de staging encombrée n'aura peut-être plus à n'exister que dans la mémoire de quelqu'un. L'horizon, il faut l'admettre, dépend des coûts du matériel de positionnement intérieur — s'ils ne baissent pas d'ici trois ans, l'ère du « parcours le plus acceptable » pourrait arriver plus tard qu'espéré.
Je conclurai par une question ouverte plutôt que par un verdict. Quand les algorithmes apprendront enfin à penser comme des préparateurs chevronnés — contournant l'encombrement, privilégiant l'ergonomique, économisant l'énergie — la question suivante sera peut-être de savoir si le routage de picking a besoin d'une unique réponse « optimale ». Peut-être que le système du futur proposera plusieurs parcours avec différents arbitrages et rendra le choix final à la personne sur le terrain. La meilleure relation entre la technologie et les personnes, me semble-t-il, n'a jamais été une question de qui commande à qui.
Par Dr. Chen, chercheur en supply chain
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.