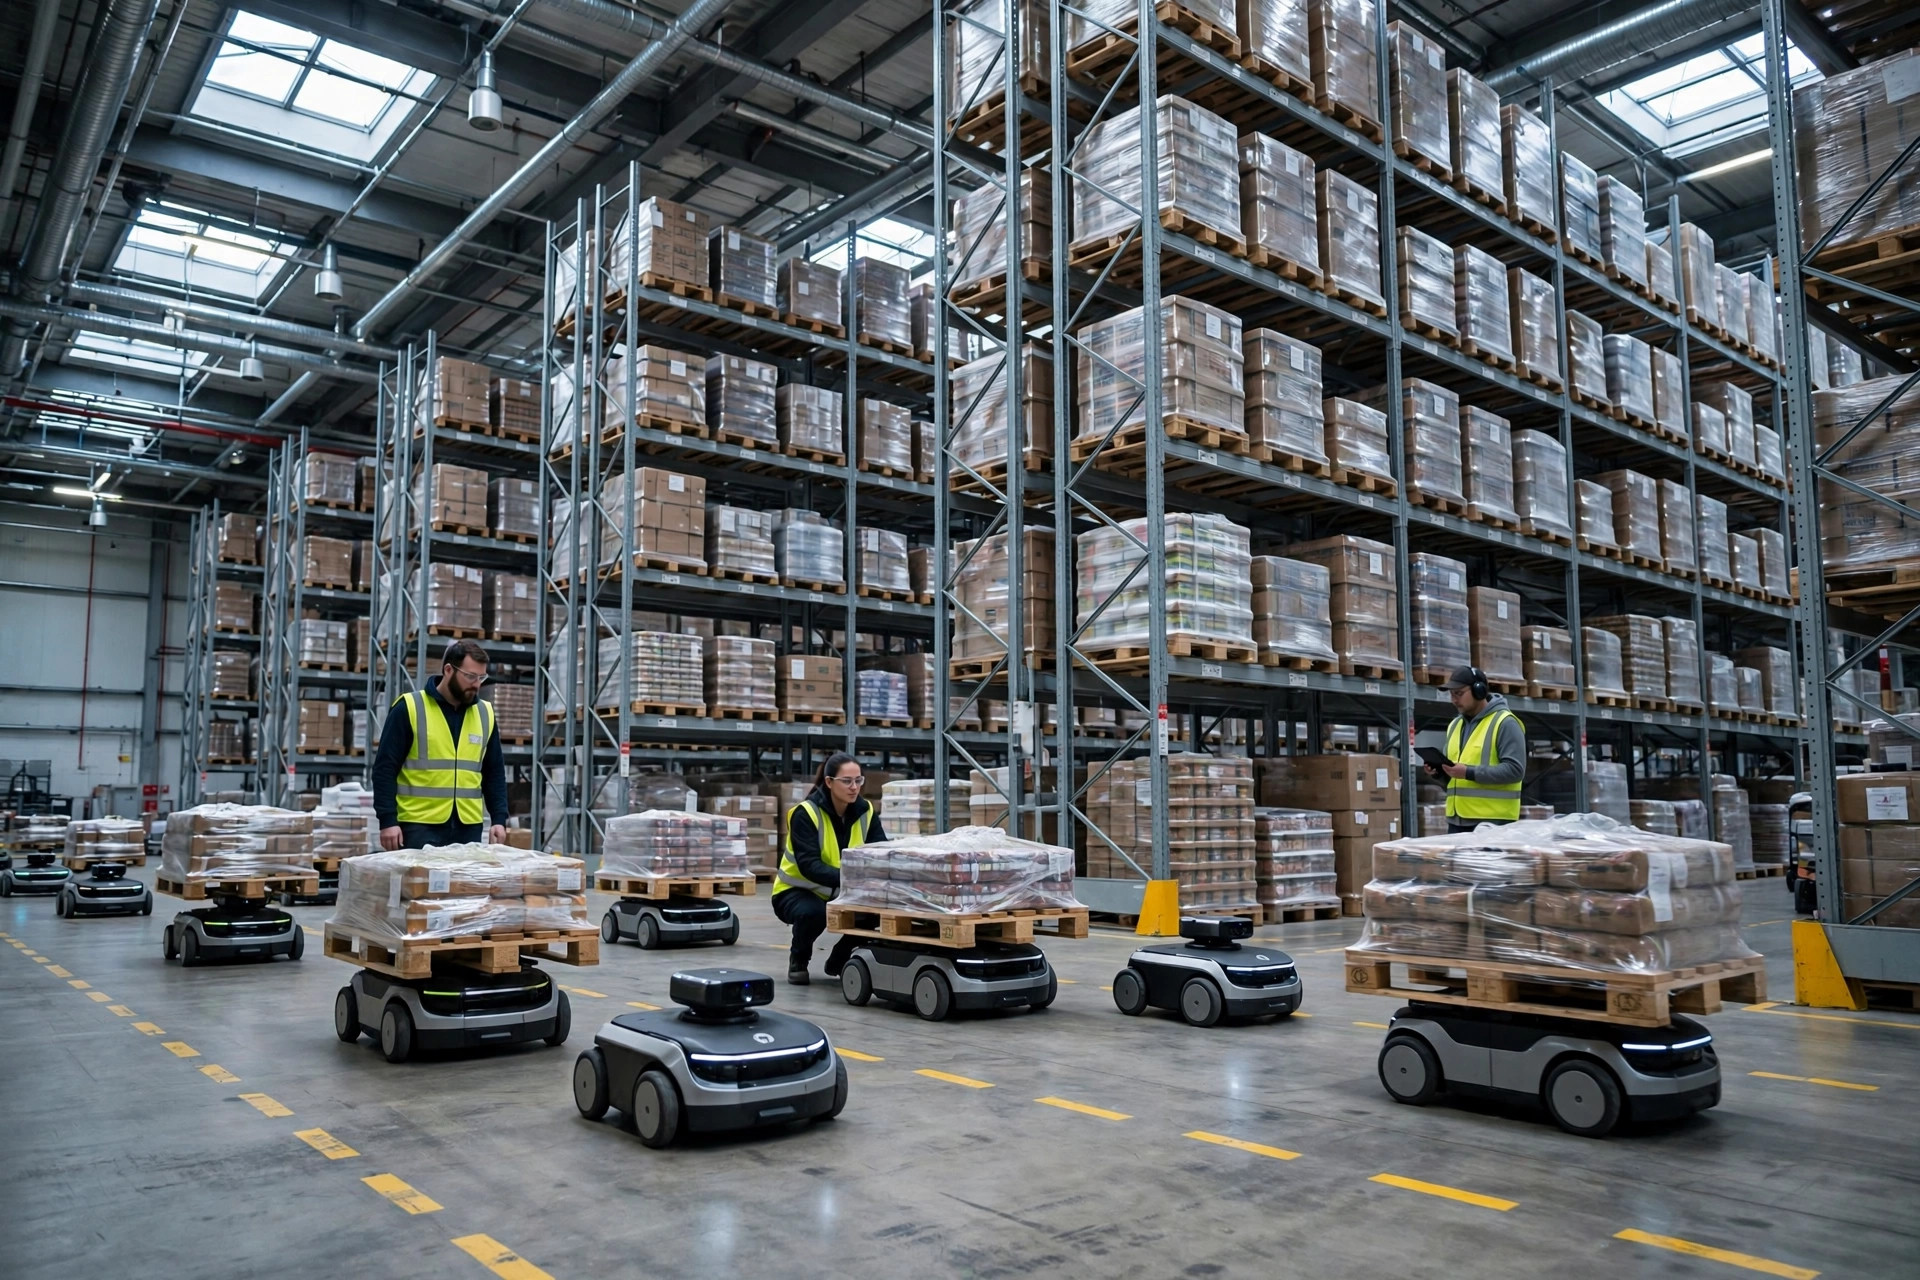
Les termes copilote et pilote automatique marquent les deux extrémités d'un spectre : l'humain conduit pendant que l'IA suggère, contre l'IA qui conduit pendant que l'humain surveille le tableau de bord. L'une des raisons pour lesquelles le débat sur l'IA en entrepôt semble confus en 2026 est que les personnes qui utilisent le même mot — « IA » — désignent souvent des niveaux d'autonomie entièrement différents : pour l'une, c'est un chatbot qui consulte l'inventaire, pour l'autre, un système de planification qui pilote seul un shift complet. Emprunter la logique de classement L1 à L5 que l'industrie de la conduite autonome a établie il y a des années, et l'appliquer à l'autonomie de l'IA en entrepôt, dissipe un nombre surprenant de débats, parce qu'elle force la conversation sur une échelle commune.
L'autonomie de l'IA en entrepôt peut aussi se classer en cinq niveaux
D'abord les définitions :
L1 — Assistance informationnelle. L'IA fournit uniquement de l'information ; elle ne prend aucune décision. Demandez « quel a été le volume sortant de ce SKU la semaine dernière » et elle récupère le chiffre ; ou transformez un manuel SOP de 300 pages en questions-réponses pour qu'un opérateur puisse consulter la procédure de coupure de courant en zone surgelée.
L2 — Recommandation de décision. L'IA analyse les données et propose un plan, mais l'exécution nécessite une validation humaine : un moteur de réapprovisionnement liste « 37 SKU recommandés au réapprovisionnement aujourd'hui », et les tâches ne sont créées qu'après qu'un superviseur a coché les cases.
L3 — Autonomie conditionnelle. L'IA exécute seule dans des conditions et des limites claires ; les humains ne traitent que les exceptions qu'elle remonte. Un système de planification des vagues exécute les vagues automatiquement à heures fixes, ne remontant qu'en cas de rupture de stock ou de conflit de priorité de commande.
L4 — Autonomie élevée. L'IA pilote un shift entier ou un processus entier ; les humains n'existent que comme gestionnaires d'exceptions. Imaginez un entrepôt de nuit où la réception, le contrôle qualité, le stockage, le réapprovisionnement, la planification des vagues et l'expédition sont tous pilotés par le système, et le personnel ne traite que les exceptions remontées.
L5 — Autonomie totale. L'IA fait de la planification, pas seulement des opérations — recommandations de réseau, planification des effectifs à long terme, décisions d'investissement en équipements, ce que fait aujourd'hui un vice-président des opérations.
Une hypothèse clé issue de l'expérience de la conduite autonome : les sauts entre niveaux sont rarement linéaires — la barrière de chaque niveau se situe dans une dimension différente de celle du précédent.
Du copilote à l'autonomie conditionnelle : où en est vraiment chaque niveau en 2026
L1 est assez mature en 2026 : selon la recherche publique du secteur, les assistants de connaissance d'entrepôt basés sur les LLM ont atteint une couverture pilote significative chez les 3PL et les fabricants, et la précision des réponses sur les requêtes de données structurées est généralement exploitable. La barre est claire — connectez les sources de données, réglez correctement les permissions, et ça marche. Mais la barrière L1-vers-L2 n'est pas le modèle ; c'est la confiance. Le mode de défaillance le plus courant signalé en 2026 n'est pas la mauvaise réponse, mais la non-utilisation : les opérateurs retournent demander au vétéran de l'atelier, parce que les réponses de l'assistant doivent encore être double-vérifiées dans le système — aucun temps gagné.
L2 est là où la densité de déploiement est la plus forte en 2026. Les rapports publics montrent que les principaux éditeurs de WMS et les équipes digitales des 3PL se concentrent ici : recommandations de réapprovisionnement, suggestions de combinaison de vagues et alertes d'exception (« cette commande risque de manquer sa date limite promise ») sont les trois cas d'usage les plus fréquents, et leur valeur est la plus facile à quantifier. Mais L2 a une frontière nette : l'IA peut recommander mais ne peut pas exécuter entre les systèmes, car elle n'a aucun accès en écriture.
Observation un provient d'un cas réel de 2026 chez un 3PL du sud de la Chine — un piège d'intégration L2-vers-L3 classique. Son outil de réapprovisionnement L2 fonctionnait bien depuis six mois lorsque la direction a approuvé le passage à l'exécution automatique. L'obstacle était étonnamment banal : l'API du WMS n'exposait que des permissions de consultation, les écritures passant par un workflow d'approbation OA ; la documentation de l'API d'ajustement d'inventaire du système de commandes datait de trois ans, avec des champs désalignés ; et l'informatique, invoquant la politique de sécurité, a refusé d'accorder au service IA un accès en écriture. Aucun n'était grave seul, mais ensemble ils ont retardé la mise à niveau de plus de quatre mois, et l'entreprise s'est contentée d'un intermédiaire « semi-automatique » : l'IA génère les ordres d'exécution, un humain clique sur confirmer. La leçon : la barrière L2-vers-L3 est la permission d'intégration, et ce n'est jamais un problème technique — c'est un problème de gouvernance organisationnelle et de sécurité.
L3 est en déploiement commercial précoce en 2026. Selon les histoires de clients partagées lors de conférences du secteur, la planification automatique des vagues de niveau L3 tourne dans certains grands centres de distribution ; les chiffres cités publiquement se regroupent autour de « temps de génération du plan de vagues réduit d'heures à minutes, taux de remontée d'exceptions à un chiffre » (selon les communications publiques des éditeurs ; les chiffres réels varient par site). Une caractéristique constante : ces cas se situent presque tous dans des installations hautement standardisées — structures de SKU simples, schémas de commandes stables, automatisation déjà en place.
Observation deux provient d'un pilote 2026 de planification des vagues L3 dans un entrepôt e-commerce de l'est de la Chine. Un fournisseur d'AMR a partagé les données du site lors d'un sommet du secteur au printemps : le temps de génération du plan de vagues est tombé d'environ deux heures à moins de douze minutes, avec des taux de remontée autour de 5 % en période stable (selon la communication publique du fournisseur). Puis, en semaine trois, un pic de réapprovisionnement promotionnel a brutalement changé le mix de commandes. Le système a continué en mode normal ; le détecteur d'anomalies ne s'est jamais déclenché ; quand un humain l'a remarqué, la fenêtre d'ajustement était fermée. L'analyse post-mortem n'a pas conclu que le modèle était faible — mais que la définition de « l'anomalie » est elle-même dynamique : le normal en promotion et le normal un jour ordinaire sont deux mondes différents. C'est la barrière L3-vers-L4 : l'exhaustivité du traitement des exceptions. La logique de L3 est « je gère le normal, tu gères l'anormal ». Plus les conditions limites sont claires, plus la remontée est fiable ; plus elles sont floues, plus L3 devient fragile.
L4 en 2026 reste en pilotes en scénario fermé. Une poignée d'installations neuves entièrement automatisées (AMR plus tri automatisé plus contrôle qualité par vision) approchent l'exploitation de style L4 pendant des fenêtres spécifiques comme les shifts de nuit — mais ces sites ont été conçus pour l'autonomie dès le départ. Des rétrofits L4 d'entrepôts existants documentés publiquement sont essentiellement inexistants.
Quels processus atteignent L4 en premier : un cadre « structure × coût de l'erreur »
Pour juger quels processus atteignent L4 en premier, j'utilise un cadre à deux dimensions : structure de la tâche × coût de l'erreur. L'axe horizontal est à quel point la tâche est structurée — entrées et sorties bien définies, règles claires. L'axe vertical est le coût de se tromper.
L4 arrivera d'abord dans le quadrant « hautement structuré, faible coût de l'erreur » : génération des tâches de réapprovisionnement en entrepôt, expédition des palettes vides, planification des inventaires tournants. Les règles sont claires, et une erreur gaspille au plus quelques heures de main-d'œuvre — un coût d'essai-erreur que les entreprises peuvent absorber. Le quadrant « faible structure, coût élevé de l'erreur » — arbitrage des litiges qualité en réception (de qui est la faute de cette marchandise endommagée ?), arbitrage des priorités pour les comptes clés — n'atteindra pas L4 de sitôt, car le coût de l'erreur inclut la relation commerciale, et ce n'est pas quelque chose qu'un algorithme peut se permettre de perdre.
Un corollaire : le même processus peut se situer dans des quadrants différents selon les entreprises. Dans un entrepôt standardisé de 200 SKU, la planification des vagues est hautement structurée ; chez un 3PL de 50,000 SKU avec une longue traîne à 60 %, elle peut être peu structurée. Donc « notre entrepôt a-t-il atteint L4 ? » ne peut se répondre que processus par processus et site par site — aucun entrepôt n'est en L4 globalement.
Pourquoi L5 est un problème de responsabilité, pas de technologie
L5 signifie l'autonomie au niveau de la planification : réseau, planification des effectifs, investissement en équipements — le travail du vice-président des opérations aujourd'hui. Mon jugement est explicite : L5 n'est pas un problème de technologie ; c'est un problème de responsabilité.
Supposons qu'en 2028 un système décide de manière autonome de « construire une nouvelle installation de 200,000 pieds carrés à Dallas », et que la décision s'avère mauvaise, avec des pertes de plusieurs dizaines de millions de dollars. À qui la faute — le fournisseur de l'algorithme, l'intégrateur, ou le dirigeant qui a signé ? Le système d'assurance et de contrats de 2026 n'est pas préparé à cela : la couverture de responsabilité technologique existante couvre le « dysfonctionnement du système », pas le « le système a pris une mauvaise décision commerciale ». Tant que l'attribution de la responsabilité, les produits d'assurance et les termes contractuels ne seront pas tous en place, L5 ne sera pas réellement activé, même si la technologie est prête. C'est un jugement, pas une prévision : la technologie peut arriver tôt ; le régime de responsabilité ne peut pas.
La question la plus productive n'est donc peut-être pas « quand arrive L5 » mais « de quelles conditions préalables le régime de responsabilité a besoin ». Le chemin de l'industrie de la conduite autonome est instructif : avant que les robotaxis L4 ne circulent sur les voies publiques sont arrivés les cadres de permis de test, les règles de responsabilité en cas d'accident et les produits d'assurance dédiés. Le L5 de l'IA en entrepôt suivra très probablement la même route — d'abord les règles, ensuite le déploiement.
Revenons à la taxonomie elle-même : sa valeur n'est pas de prédire quelle année apporte quel niveau, mais de donner à l'industrie un langage commun. Quand un éditeur dit « notre système est autonome en IA », vous pouvez demander : est-ce de la recommandation L2 ou de l'autonomie conditionnelle L3 ? Quand un 3PL dit « nous passons en L4 l'année prochaine », vous pouvez demander : L4 pour quel processus, et dans quelle cellule de la matrice du coût de l'erreur ?
Une question ouverte à surveiller : le saut L3-vers-L4 peut être discontinu plutôt que graduel — L4 exige un shift complet sans intervention humaine, donc l'organigramme doit changer aussi. Le rôle de superviseur de nuit existe-t-il encore ? La plupart des pilotes L3 visibles en 2026 sont toujours opérés comme du L2, et cela peut être une barrière cachée plus grande que la technologie. Est-ce que 2027 produira le premier jalon L4 publiquement revendiqué sur un entrepôt rétrofité ? Si oui, la façon dont son équipe de traitement des exceptions est staffée sera plus instructive que ses détails techniques.
Par Dr. Chen, chercheur en chaîne d'approvisionnement
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.