En 2023, j'ai travaillé avec un entrepôt de retours qui voulait un système de vision sur sa ligne d'audit pour détecter les cartons endommagés. Le calcul était simple : un carton endommagé expédié à un client signifiait une réclamation plus le fret de retour — de quoi payer plusieurs caméras industrielles. Le projet a passé toutes les revues avec succès, puis a calé sur quelque chose que personne n'avait anticipé. Ni l'algorithme. Ni les spécifications des caméras. Nous n'arrivions pas à réunir les données d'entraînement.
Après des mois d'attente, nous avions quelques dizaines de photos réelles de cartons endommagés. Pire, elles étaient presque identiques : le même coin écrasé, les mêmes deux convoyeurs, les mêmes plafonniers. Nous avons quand même entraîné le modèle. Pendant sa première semaine en production, il a signalé des cartons en parfait état comme endommagés, et les fausses alertes se sont accumulées jusqu'à ce que les opérateurs désactivent les alertes. Ce projet m'a appris une règle que j'applique toujours : le premier jour de tout projet de vision, demandez d'où viennent les données avant de choisir une caméra.
Pourquoi le défaut refuse de se laisser photographier
Commençons par la vérité qui dérange. Dommages, fuites, cartons mal étiquetés, ruban adhésif qui se soulève — ce sont des événements rares par conception dans tout entrepôt bien géré. Une ligne d'audit à grand volume déplace des dizaines de milliers d'unités par jour tout en maintenant son taux de dommages à de faibles fractions de pourcent. Collecter quelques milliers de photos d'"endommagés" signifie camper près du convoyeur pendant des mois, et on ne peut pas changer de saison, refaire l'éclairage du plafond ni changer de fournisseur de cartons en cours de collecte sans déplacer sa distribution de données.
Même quand on obtient enfin les photos, l'étiquetage est un puits sans fond. Le dommage n'a pas de vérité terrain : à quel point un coin doit-il être écrasé pour compter ? Un ruban soulevé de deux millimètres classe-t-il un carton ? Trois annotateurs annoteront la même image de trois façons différentes. Et puis il y a le tueur silencieux de la capture réelle : la couverture de scène. Éclairage, angle de caméra, vitesse du tapis, âge du carton — les combinaisons sont infinies. Vos photos décriront toujours "ce poste, le trimestre dernier", et le modèle aura le mal du pays dès sa mise en production.
Au jour où votre jeu de données réel est enfin assez grand, la fenêtre du projet est généralement fermée. C'est la boucle de la mort de la vision en entrepôt : les endroits qui ont le plus besoin du modèle sont exactement ceux qui ne peuvent pas produire les données.
Trois façons de fabriquer des données
Si les vrais défauts ne viennent pas à vous, construisez-les vous-mêmes. Trois approches fonctionnent vraiment, et chacune a son propre caractère.
La première est le rendu de simulation 3D. Modélisez un carton en 3D, programmez la profondeur de la bosse, l'emplacement des déchirures et les motifs de taches, puis randomisez à volonté la position de la caméra, l'éclairage et l'arrière-plan. Chaque image rendue est livrée avec des annotations gratuites — le moteur de rendu voit la scène d'un point de vue divin, donc les boîtes englobantes (bounding boxes), les masques de segmentation et les cartes de profondeur sortent directement du graphe de scène avec zéro coût d'étiquetage. L'outillage est mature : BlenderProc, open-sourcé par Denninger et ses collègues du Centre aérospatial allemand DLR en 2019 (arXiv:1911.01911), construit sur l'idée que le rendu photoréaliste réduit l'écart sim-to-real ; Omniverse Replicator de NVIDIA, dont l'objectif déclaré est de générer des données synthétiques étiquetées à grande échelle pour l'inspection visuelle et la robotique ; et le package Perception d'Unity, conçu spécifiquement pour produire des jeux de données synthétiques avec des annotations de vérité terrain.
La deuxième approche est la randomisation de domaine, et sa logique fonctionne à l'envers : ne chassez pas le réalisme, chassez le chaos. L'article fondateur de Tobin et ses collègues en 2017 (arXiv:1703.06907) a randomisé textures, éclairage et positions de caméra si agressivement que le monde réel a commencé à ressembler à une simple variation aléatoire de plus. Leur modèle a localisé des objets dans des scènes réelles à 1.5 centimètre près. Mon point de vue terrain : les scènes de convoyeurs à arrière-plan fixe sont idéales pour cette astuce, parce que vous n'avez pas besoin que la simulation ait l'air réelle — vous avez besoin qu'elle ait l'air variée.
La troisième voie, ce sont les modèles génératifs. Donnez vos quelques dizaines de photos réelles de dommages à un GAN ou à un modèle de diffusion et laissez-le rêver d'autres variantes. Je suis sceptique sur celle-ci. Les modèles génératifs hallucinent avec une confiance totale, inventant des motifs de dommages qui violent la physique. Un modèle entraîné sur ces fantasmes apprend de fausses caractéristiques et échoue quand même en production. Mon verdict : les modèles génératifs sont très bien comme acolyte d'augmentation — variations de luminosité, échanges d'arrière-plan — mais ne leur demandez pas d'inventer de nouvelles catégories de défauts à partir de rien.
La simulation n'est pas une solution miracle
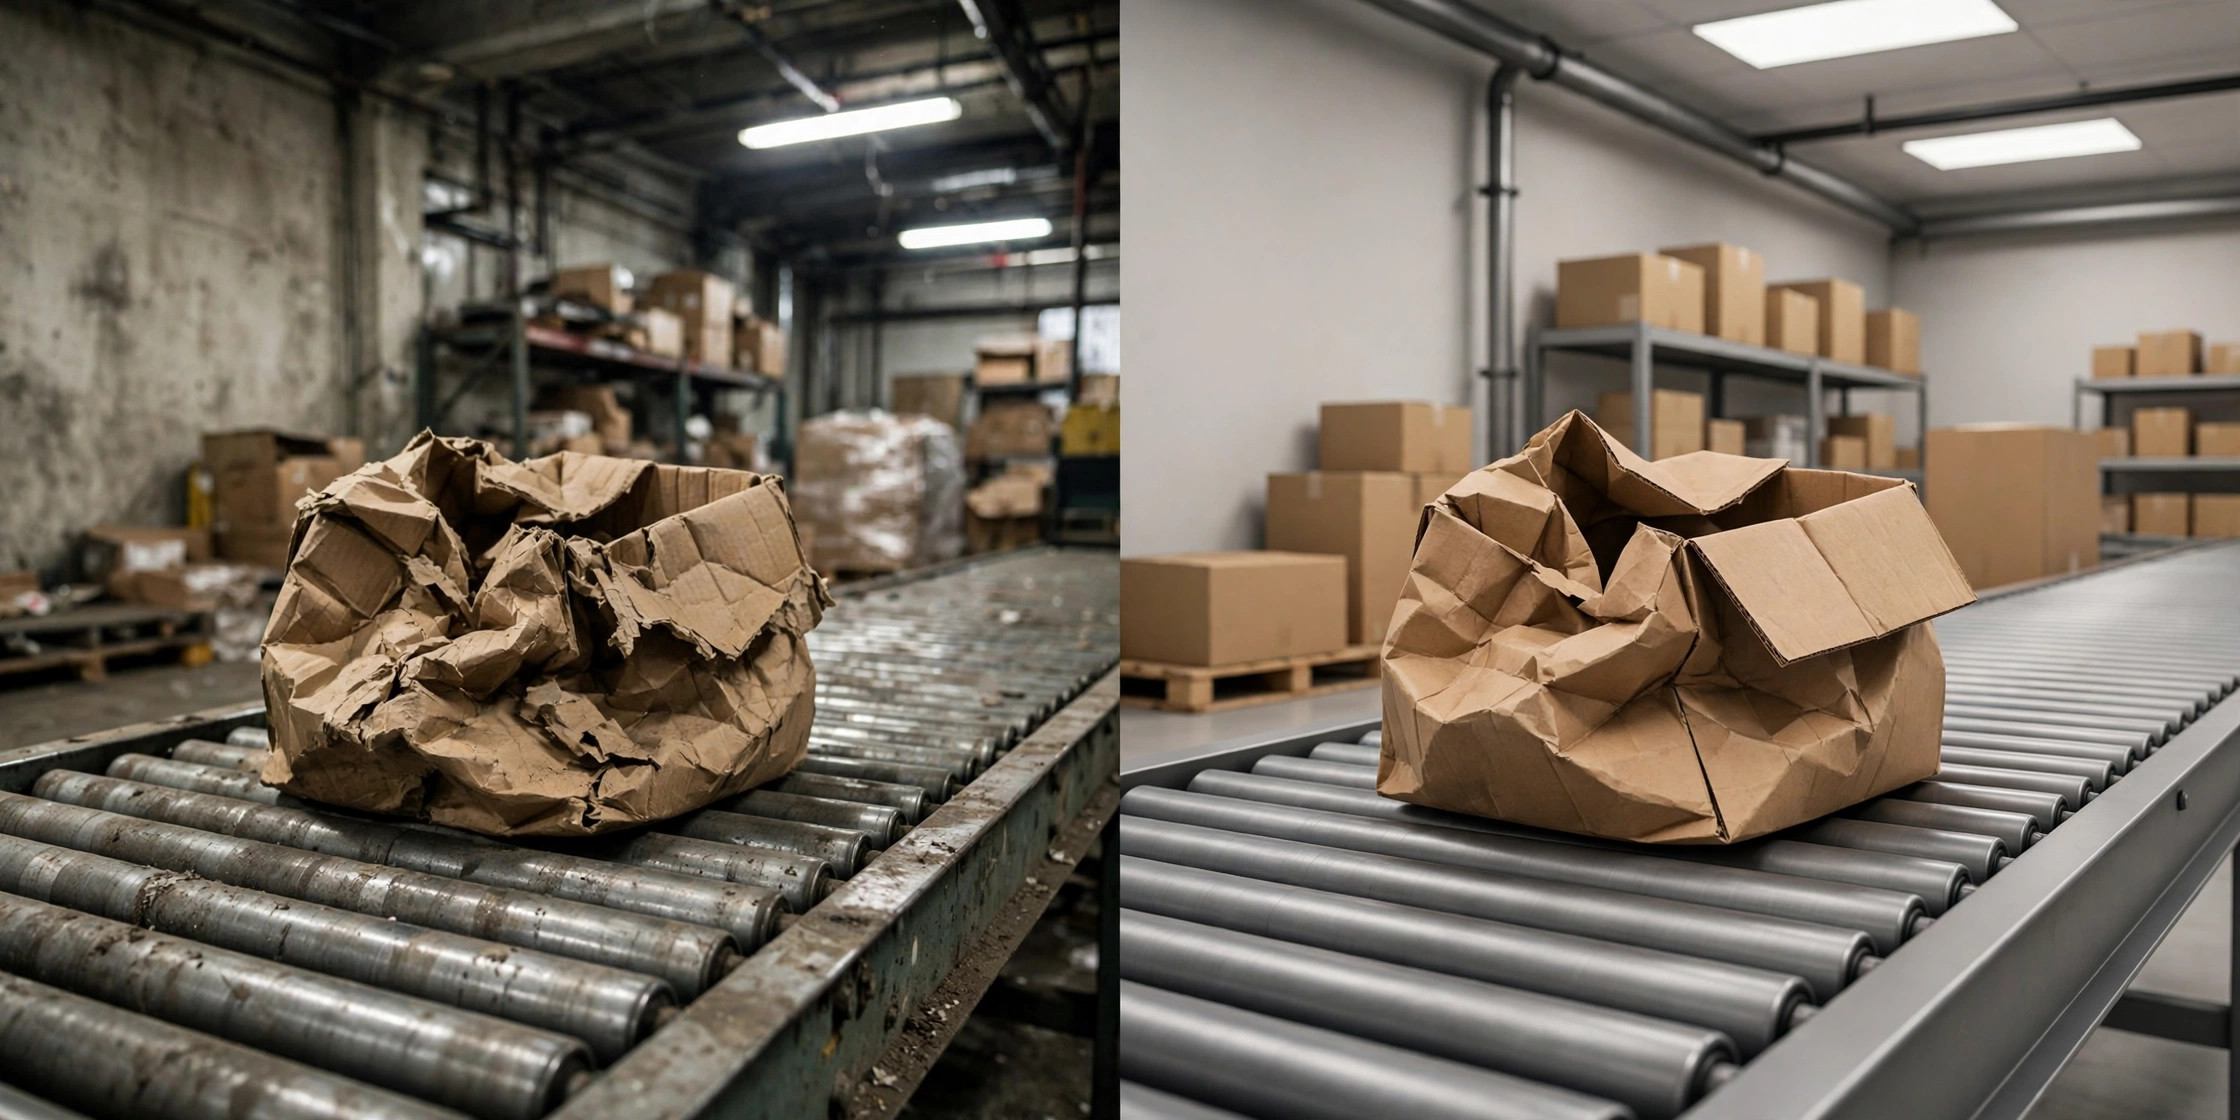
Regardez l'image ci-dessus : un vrai carton endommagé photographié dans un entrepôt, à côté de son jumeau rendu en 3D. Si vos yeux peuvent repérer l'écart, le modèle le ressent dix fois plus fort.
L'écart sim-to-real est réel. Aussi convaincant soit l'éclairage rendu, les simulations omettent systématiquement le bruit du capteur, la distorsion de l'objectif et le flou de mouvement d'un tapis roulant à plein régime. Le piège plus sournois : les défauts synthétiques ont tendance à avoir l'air trop propres, trop scolaires, alors que les vrais dommages sont sales, aléatoires et déraisonnables. Une frontière de décision apprise sur des données propres s'effondre dès qu'elle rencontre la boue du monde réel.
La solution tient en un mot : hybride. Entraînez sur des données synthétiques pour la couverture, afin que le modèle ait vu assez de formes de défauts ; calibrez sur des données réelles, afin que la frontière de décision soit ramenée à la réalité. Ensuite, bouclez la boucle : continuez à réinjecter les faux positifs et les manqués de production dans le jeu d'entraînement. Les données synthétiques vous mènent de zéro à un ; les données réelles vous mènent de "ça marche" à "ça marche bien". Ni l'un ni l'autre ne remplace l'autre.
Quand sauter les données synthétiques
Les données synthétiques sont puissantes, mais certains travaux vont plus vite avec un simple appareil photo.
Sautez la simulation quand le défaut est facile à mettre en scène. Les cartons mal étiquetés, par exemple : imprimez un lot d'étiquettes, collez-les, et vous pouvez prendre des centaines de photos en un après-midi avec l'angle et l'éclairage que vous voulez. Les heures qu'un artiste 3D passe à construire la scène couvriraient trois séances de prise de vue complètes.
Sautez-la quand personne dans l'équipe ne parle le langage du pipeline 3D. Modélisation, matériaux, éclairage, pipeline de rendu — chacun est un métier à part entière. Les devis de modélisation sous-traitée dépassent couramment le coût de la prise de vue plus l'étiquetage, et après deux ou trois cycles de révisions le projet est mort.
Enfin, faites le calcul de coût. La capture réelle est un coût linéaire : une photo de plus, une annotation de plus, un dollar de plus. La simulation est un coût fixe : la partie chère est de construire la scène, et ensuite chaque image supplémentaire ne coûte presque rien. La règle de décision est claire : plus le volume dont vous avez besoin est grand et plus le défaut est rare, plus les données synthétiques gagnent. Petit volume, facile à mettre en scène — prenez l'appareil et photographiez.
Votre checklist pour demain matin
Si vous lancez un projet de vision en entrepôt demain, faites ceci dans l'ordre et ne sautez pas d'étapes :
- Comptez d'abord vos échantillons. Listez chaque classe de défaut que vous devez détecter et comptez les photos réelles que vous détenez pour chacune. Toute classe qui ne remplit pas un jeu de validation va directement dans la colonne "doit utiliser des données synthétiques".
- Montez la caméra d'abord. Installez-la à la position finale de déploiement et laissez-la tourner une semaine. Mettez ce flux de données réelles de côté maintenant — c'est le capital que vous dépenserez pour la calibration plus tard.
- Testez l'outillage d'abord. Procurez-vous une machine avec GPU, exécutez l'exemple officiel de BlenderProc de bout en bout et rendez votre premier lot d'images auto-annotées. Si vous n'arrivez pas à faire fonctionner ça, vous n'êtes pas prêt à construire votre propre pipeline de simulation.
- Faites d'abord une comparaison. Entraînez un petit modèle sur des données pré-entraînées synthétiques plus des données réelles pour l'affinage, et un autre sur des données réelles seules. Comparez les taux de faux positifs et de manqués, et laissez les chiffres décider.
- Parlez d'échelle en dernier. Si le synthétique gagne la comparaison, investissez dans la scène de simulation complète. S'il perd, retournez photographier et ne vous battez pas avec l'outillage.
Mon verdict est direct : les données synthétiques ne sont pas une solution miracle, mais elles sont le levier le plus sous-estimé de la vision en entrepôt. Bien utilisées, elles compressent "l'attente des données" de mois en semaines. Mal utilisées, c'est un jouet coûteux. Ce qui sépare les deux n'est jamais la foi dans la technologie — c'est la comparaison posée sur votre bureau.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.