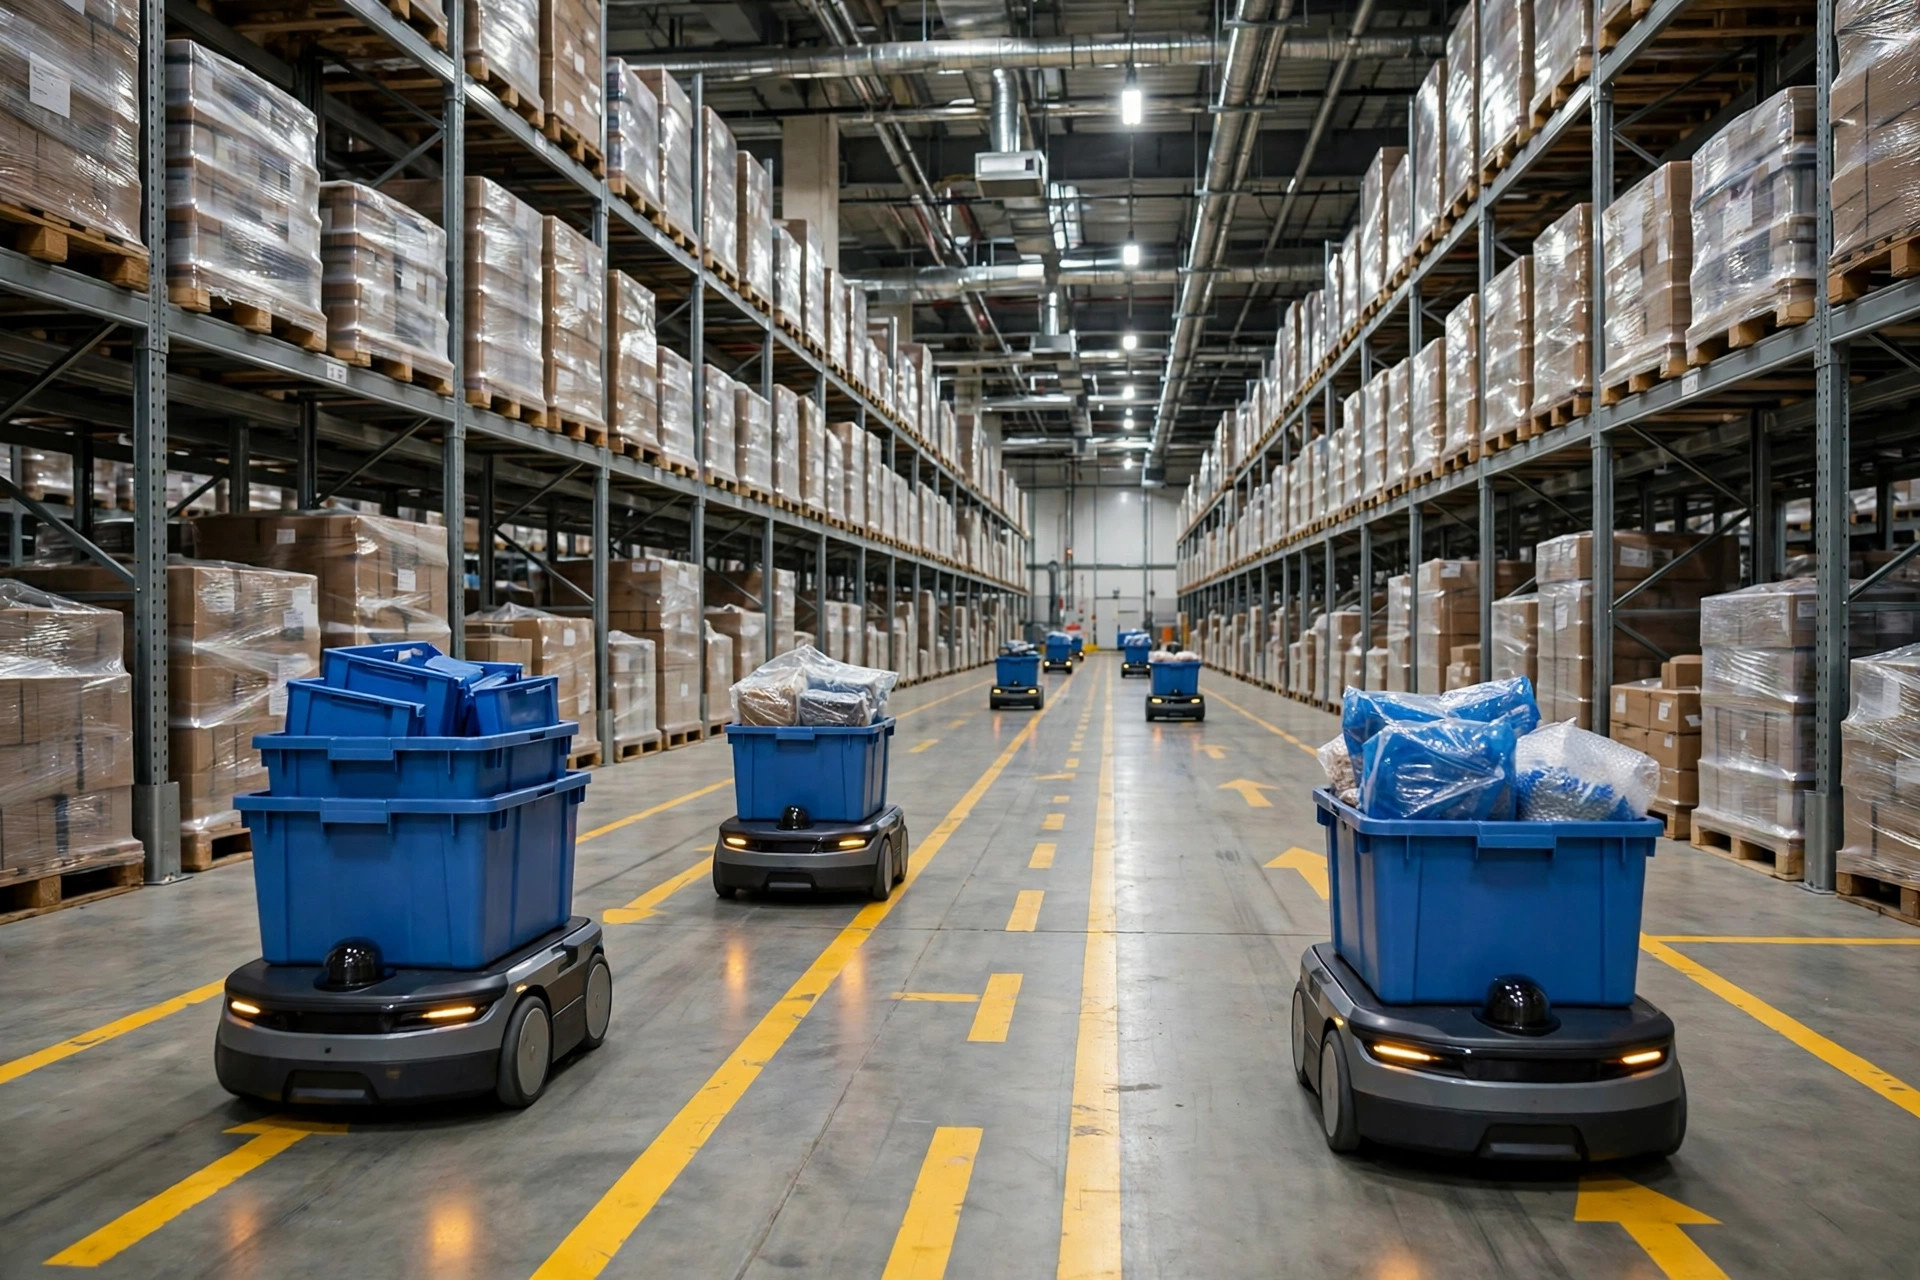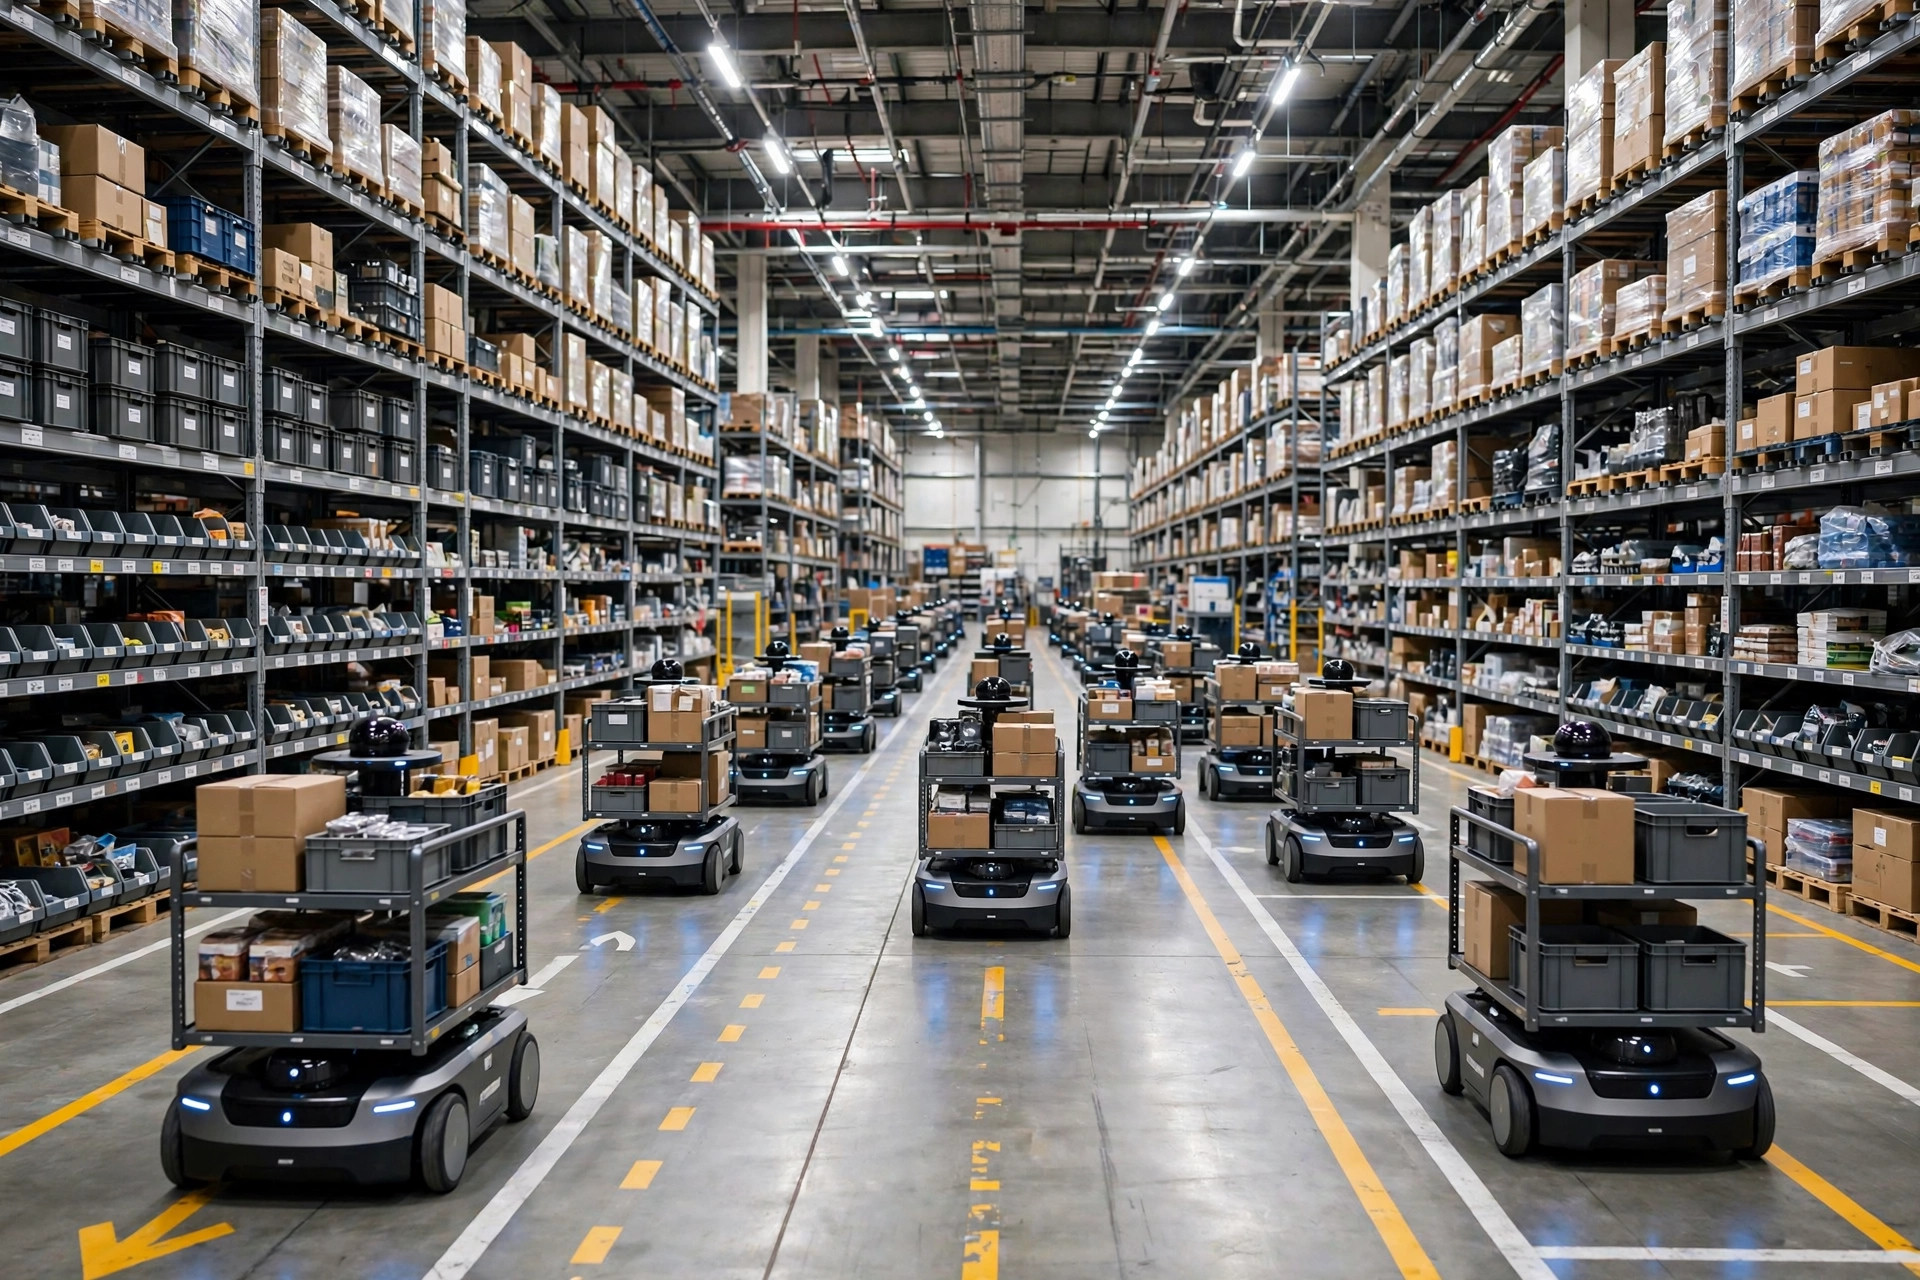
Router un seul robot mobile autonome sur le sol d'un entrepôt est un problème résolu. En coordonner une centaine en même temps ne l'est pas. L'ordonnancement multi-agent de flottes d'AMR est la discipline qui consiste à affecter un flux de tâches en perpétuel changement à un groupe d'exécutants mobiles qui ne cessent de se gêner mutuellement : décider qui prend quelle tâche, quel itinéraire emprunte chaque robot et qui cède à chaque intersection. C'est autant un problème d'organisation qu'un problème d'algorithme.
Le phénomène : les problèmes d'ordonnancement grandissent avec la taille de la flotte
La densité de déploiement des AMR a changé par paliers au cours de la dernière décennie. L'acquisition de Kiva Systems par Amazon pour $775 million en 2012 est largement considérée comme le point de départ ; en 2024, Amazon a révélé une flotte de robots d'entrepôt dépassant 700,000 unités, et des fournisseurs comme Geek+ et Hikrobot livrent désormais couramment des déploiements sur un seul site avec des centaines de robots. À mesure que les robots passent de « une poignée de pilotes » à « une flotte », l'ordonnancement passe d'un problème de navigation d'un seul robot à un problème de coordination multi-agent.
Pourquoi ce saut importe-t-il ? Parce que la navigation d'un seul robot répond à « comment un véhicule va de A à B », tandis que l'ordonnancement de flotte doit répondre à trois questions couplées à la fois : l'affectation des tâches (quelle tâche va à quel robot), la planification des trajectoires (quel itinéraire emprunte chaque robot) et la résolution des conflits (qui cède quand deux robots veulent la même intersection). Les trois sont intriquées : l'affectation la plus ingénieuse ne vaut rien si les allées s'embouteillent, et les trajectoires les plus fluides ne signifient rien si la moitié de la flotte est inactive pendant que l'autre moitié fait la queue.
Trois approches d'ordonnancement multi-agent de flottes : centralisée, décentralisée, basée sur l'apprentissage
La recherche et la pratique industrielle en ordonnancement multi-agent de flottes d'AMR ont largement convergé vers trois lignes d'attaque. Ce n'est pas un simple classement du meilleur au pire ; elles représentent trois visions du monde différentes sur la façon de gérer l'incertitude.
Approche 1 : l'optimisation centralisée — un seul cerveau pour tout le hall
Un ordonnanceur central détient l'état global : chaque tâche en attente, la position de chaque robot, le niveau de batterie et la charge. L'affectation des tâches est généralement résolue avec des algorithmes d'affectation (méthodes de type hongrois et leurs variantes), tandis que la planification des trajectoires utilise A* étendu dans le temps ou des méthodes sensibles aux conflits comme CBS (recherche basée sur les conflits). Toutes les décisions sont calculées en un seul endroit et expédiées à la flotte.
L'attrait est le déterminisme. Avec l'information globale, l'ordonnanceur peut en principe calculer la solution à plus haut débit ; le processus de décision est journalisé, reproductible et auditable — un véritable avantage dans les environnements aux exigences strictes de conformité de sécurité.
Les coûts sont tout aussi clairs. D'abord, la complexité de calcul : l'affectation des tâches est combinatoire et les temps de résolution explosent à mesure que la flotte grandit, forçant les ingénieurs à plafonner le calcul avec des heuristiques et des horizons fuyants — à quel moment « optimal global » devient une approximation. Ensuite, la fragilité du point unique : si l'ordonnanceur central cale ou si le réseau jitter, le comportement de la flotte se dégrade brutalement. Enfin, l'approche suppose une information quasi complète, alors que les vrais entrepôts livrent tout sauf cela : les arrivées de tâches sont stochastiques, le Wi-Fi fluctue et les robots tombent en panne.
J'ai vu un cas d'école lors d'une visite d'un entrepôt de fulfillment e-commerce dans l'Inland Empire californien l'an dernier : environ 120 AMR porteurs d'étagères sous ordonnancement centralisé, avec des taux de trajets à vide magnifiquement bas en simulation. En production, les arrivées de tâches par rafales en provenance du WMS ont forcé une replanification constante, et en haute saison — environ 20,000 commandes par jour — le système est retombé à plusieurs reprises sur des règles simples parce qu'il « ne pouvait pas calculer assez vite ». L'optimisation centralisée a le plafond le plus haut, mais ses exigences sur la qualité des entrées dépassent couramment ce qu'un vrai entrepôt peut fournir.
Approche 2 : la négociation décentralisée — chaque robot pour soi, poliment
La voie décentralisée pousse la prise de décision vers le bas : chaque AMR agit comme un agent indépendant, réclamant des tâches via des mécanismes d'enchères ou d'offres (le moins-disant l'emporte), tandis que les conflits d'intersection sont gérés par des règles de priorité ou une négociation locale. Il n'y a pas de cerveau central ; les robots n'échangent que l'information dont ils ont besoin.
Les atouts sont la robustesse et l'évolutivité : ajouter des robots signifie ajouter des nœuds, sans modèle central à reconstruire ; la défaillance d'un seul robot reste locale ; la tolérance aux pannes de communication est plus élevée, car un robot déconnecté peut continuer à avancer selon des règles locales au lieu de se figer sur place.
Le prix est l'optimalité locale. Chaque robot ne voit que son voisinage, de sorte que le comportement collectif peut se stabiliser dans des équilibres sous-optimaux — plusieurs robots convergeant vers la même zone de préparation chaude et l'encombrant, ou un blocage poli dans une allée étroite pendant que chacun attend que l'autre bouge en premier. Plus difficile encore est l'explicabilité : le comportement émergent dans les systèmes distribués résiste à la prédiction, et les revues post-incident se terminent souvent sans que personne ne puisse dire exactement « qui a bougé en premier ».
Un centre de distribution 3C dans l'est de la Chine offre un cas représentatif : environ 80 AMR de tri sont entrés en service en 2023 avec un ordonnancement décentralisé basé sur les enchères. L'exploitation quotidienne était fluide et la montée en échelle était véritablement facile. Mais quand les pics promotionnels ont doublé la densité de tâches, le coût de négociation aux intersections a visiblement augmenté, avec des épisodes de robots s'attendant mutuellement jusqu'à ce que des couloirs de priorité définis par les humains brisent l'impasse. Décentralisé ne signifie pas « pas de gestion » — cela déplace la complexité de l'algorithme central vers la conception des règles et la gestion des exceptions.
Approche 3 : les politiques basées sur l'apprentissage — laisser la flotte s'apprendre à coopérer
La troisième voie est l'apprentissage par renforcement multi-agent (MARL) : des centaines d'agents s'entraînent en simulation jusqu'à converger vers des stratégies coopératives, qui sont ensuite déployées sur des robots physiques. En théorie, cela peut découvrir des schémas de coordination qu'aucun ingénieur humain ne concevrait — un certain rythme de cession, par exemple — et s'adapter naturellement aux environnements dynamiques.
Mais plusieurs obstacles se dressent entre cette approche et le déploiement à grande échelle. D'abord, l'écart sim-to-real : une politique qui performe magnifiquement en simulation peut échouer face au bruit des capteurs, au frottement du sol et à la variance des charges sur du matériel réel, et quiconque a fait du transfert sim-to-real sait que le dernier kilomètre de réglage coûte souvent plus cher que l'entraînement lui-même. Ensuite, le problème de la boîte noire : les politiques neuronales résistent à l'audit, ce qui les rend difficiles à certifier dans des contextes critiques pour la sécurité comme les zones partagées homme-robot. Enfin, le coût d'entraînement : le MARL à grande échelle exige un calcul substantiel pour des retours qui restent incertains.
D'où le véritable schéma actuel : les méthodes basées sur l'apprentissage apparaissent surtout dans la couche de « prédiction » — prévoir les arrivées de tâches, anticiper la congestion — plutôt que de prendre les décisions elles-mêmes. Laisser l'IA servir de conseillère avant de la promouvoir commandante est la voie d'ingénierie la plus réaliste.
Choisir une approche d'ordonnancement de flotte : pas de solution miracle, seulement l'adéquation
Comparer les trois approches d'ordonnancement multi-agent de flottes d'AMR côte à côte clarifie la logique de sélection :
| Dimension | Optimisation centralisée | Négociation décentralisée | Politiques basées sur l'apprentissage |
|---|---|---|---|
| Décideur | Ordonnanceur central | Chaque robot indépendamment | Politique de groupe entraînée |
| Échelle de flotte | Mieux à petite et moyenne échelle ; dégradation nécessaire à très grande échelle | Meilleure évolutivité ; ajouter des robots ajoute des nœuds | Plus difficile à entraîner à mesure que l'échelle grandit |
| Réactivité | La latence de replanification est le goulot d'étranglement | Réponse locale rapide | Inférence rapide, mais dépendante de la qualité du modèle |
| Défaillance de point unique | Fragile ; une panne centrale frappe tout | Robuste ; les défaillances restent locales | Dépend de l'architecture de déploiement |
| Explicabilité / auditabilité | Forte ; décisions rejouables | Faible ; comportement émergent difficile à prédire | La plus faible ; boîte noire |
| Maturité de déploiement | La plus élevée ; standard des fournisseurs traditionnels | Moyenne ; nécessite une conception soignée des règles | La plus faible ; surtout des pilotes |
Un jugement contre-intuitif mérite d'être souligné : l'approche au plus haut débit en simulation ne gagne pas nécessairement en production. L'« optimum global » centralisé repose sur deux hypothèses — information complète et calcul instantané — et les vrais entrepôts les décotent fortement toutes les deux. Une conception sous-optimale à réaction rapide et dégradation gracieuse — disons, une affectation grossière des tâches centralisée combinée à une résolution locale distribuée des conflits — surpasse souvent une conception optimale mais fragile. En ingénierie, « ne pas s'effondrer dans de mauvaises conditions » vaut plus que « optimal dans de bonnes conditions ».
Un autre fait sous-estimé : l'algorithme d'ordonnancement lui-même représente peut-être trente pour cent de la difficulté du déploiement. Les soixante-dix pour cent restants sont la stratégie de recharge, le zonage de la carte et la coordination avec le WMS et les opérateurs humains (granularité des tâches, propriété des exceptions). J'ai vu plus d'un projet où l'équipe algorithme avait réglé CBS à la perfection, avant que le débit ne soit plafonné par trop peu de quais de recharge. L'ordonnancement de flotte n'a jamais été qu'un problème d'algorithmes.
Perspectives : architectures hybrides maintenant, méthodes basées sur l'apprentissage comme variable de long terme
Causalement, les trois approches incarnent trois attitudes face à l'incertitude : la centralisée l'élimine par le calcul, la décentralisée la tolère par la redondance et celle basée sur l'apprentissage s'y adapte par les données. À court terme, les architectures hybrides (affectation grossière centrale plus résolution locale distribuée) domineront les déploiements, trouvant un équilibre acceptable entre auditabilité et robustesse ; les composants basés sur l'apprentissage entreront par la prédiction et le réglage de la simulation avant de migrer vers la prise de décision.
En regardant plus loin, une question ouverte : à mesure que le nombre d'AMR continue d'augmenter et que les robots humanoïdes, les chariots élévateurs sans conducteur et les camions autonomes rejoignent les mêmes halls, la frontière de l'« ordonnancement de flotte » s'étendra-t-elle de « une classe d'équipement » à « un système d'exploitation de la circulation pour l'ensemble du site » ? Ce jour-là, l'ordonnanceur coordonnerait des participants de trafic hétérogènes plutôt qu'une flotte homogène — potentiellement un changement de paradigme plus grand que les trois approches actuelles. Pour l'instant, cette question n'a pas de réponse standard.
Par Dr. Chen, chercheur en chaîne d'approvisionnement
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.