Un responsable d'entrepôt dans l'Inland Empire m'a raconté l'année dernière une histoire que je n'arrive pas à oublier. Son équipe a passé trois mois à photographier et à étiqueter plus de dix mille images de SKU, puis a entraîné un modèle de vision pour la vérification de picking. La première semaine en production, la précision semblait excellente. Puis le changement d'emballage saisonnier est arrivé — quelques SKU phares ont reçu de nouveaux designs aux couleurs dominantes différentes — et la précision s'est effondrée. Le modèle a fini par être pire que les contrôles manuels qu'il remplaçait. Vous auriez dû voir les visages de l'équipe projet.
Ce n'était pas un cas isolé. Quand les entrepôts tentent d'entraîner leurs propres modèles de vision, le point de défaillance n'est presque jamais l'algorithme — les modèles open source sont nombreux et de qualité proche. Le point de défaillance, ce sont les données : combien de photos, prises comment, étiquetées comment. Décortiquons tout ça.
Vous n'avez pas besoin de plus de photos. Vous avez besoin de plus de variété
L'instinct pousse à accumuler du volume : dix mille photos devraient suffire. À moitié vrai.
Les modèles ne souffrent pas de « trop peu ». Ils souffrent de « trop biaisé ». Dix mille photos prises à la même station, avec la même caméra, sous le même éclairage de 10 heures du matin, n'apprennent au modèle qu'une seule chose, et la cent millième photo lui apprend la même chose une fois de plus. Ce qui détermine vraiment si vos données suffisent, c'est le nombre de types de variation qu'elles couvrent. Avant de prendre la moindre photo, épinglez une liste de contrôle des variations au mur :
Éclairage. Les néons de l'entrepôt et le soleil de fin d'après-midi qui entre en biais par les portes du quai, ce sont deux couleurs complètement différentes. Photographiez les mêmes SKU le matin et l'après-midi. Les tubes vieillissants à température de couleur décalée comptent aussi.
Angle. La caméra au-dessus de la station de vérification est fixe, mais les cartons ne le sont pas : sur le côté, debout, à l'envers, à moitié hors du cadre. Ne photographiez pas seulement la pose mise en scène — capturez la façon dont un cariste fait réellement tomber un carton.
Arrière-plan. Convoyeurs, interstices entre palettes, reflets du sol — plus l'arrière-plan est désordonné, plus le modèle doit apprendre à l'ignorer. Faites tourner deux ou trois stations au lieu d'en exploiter une seule.
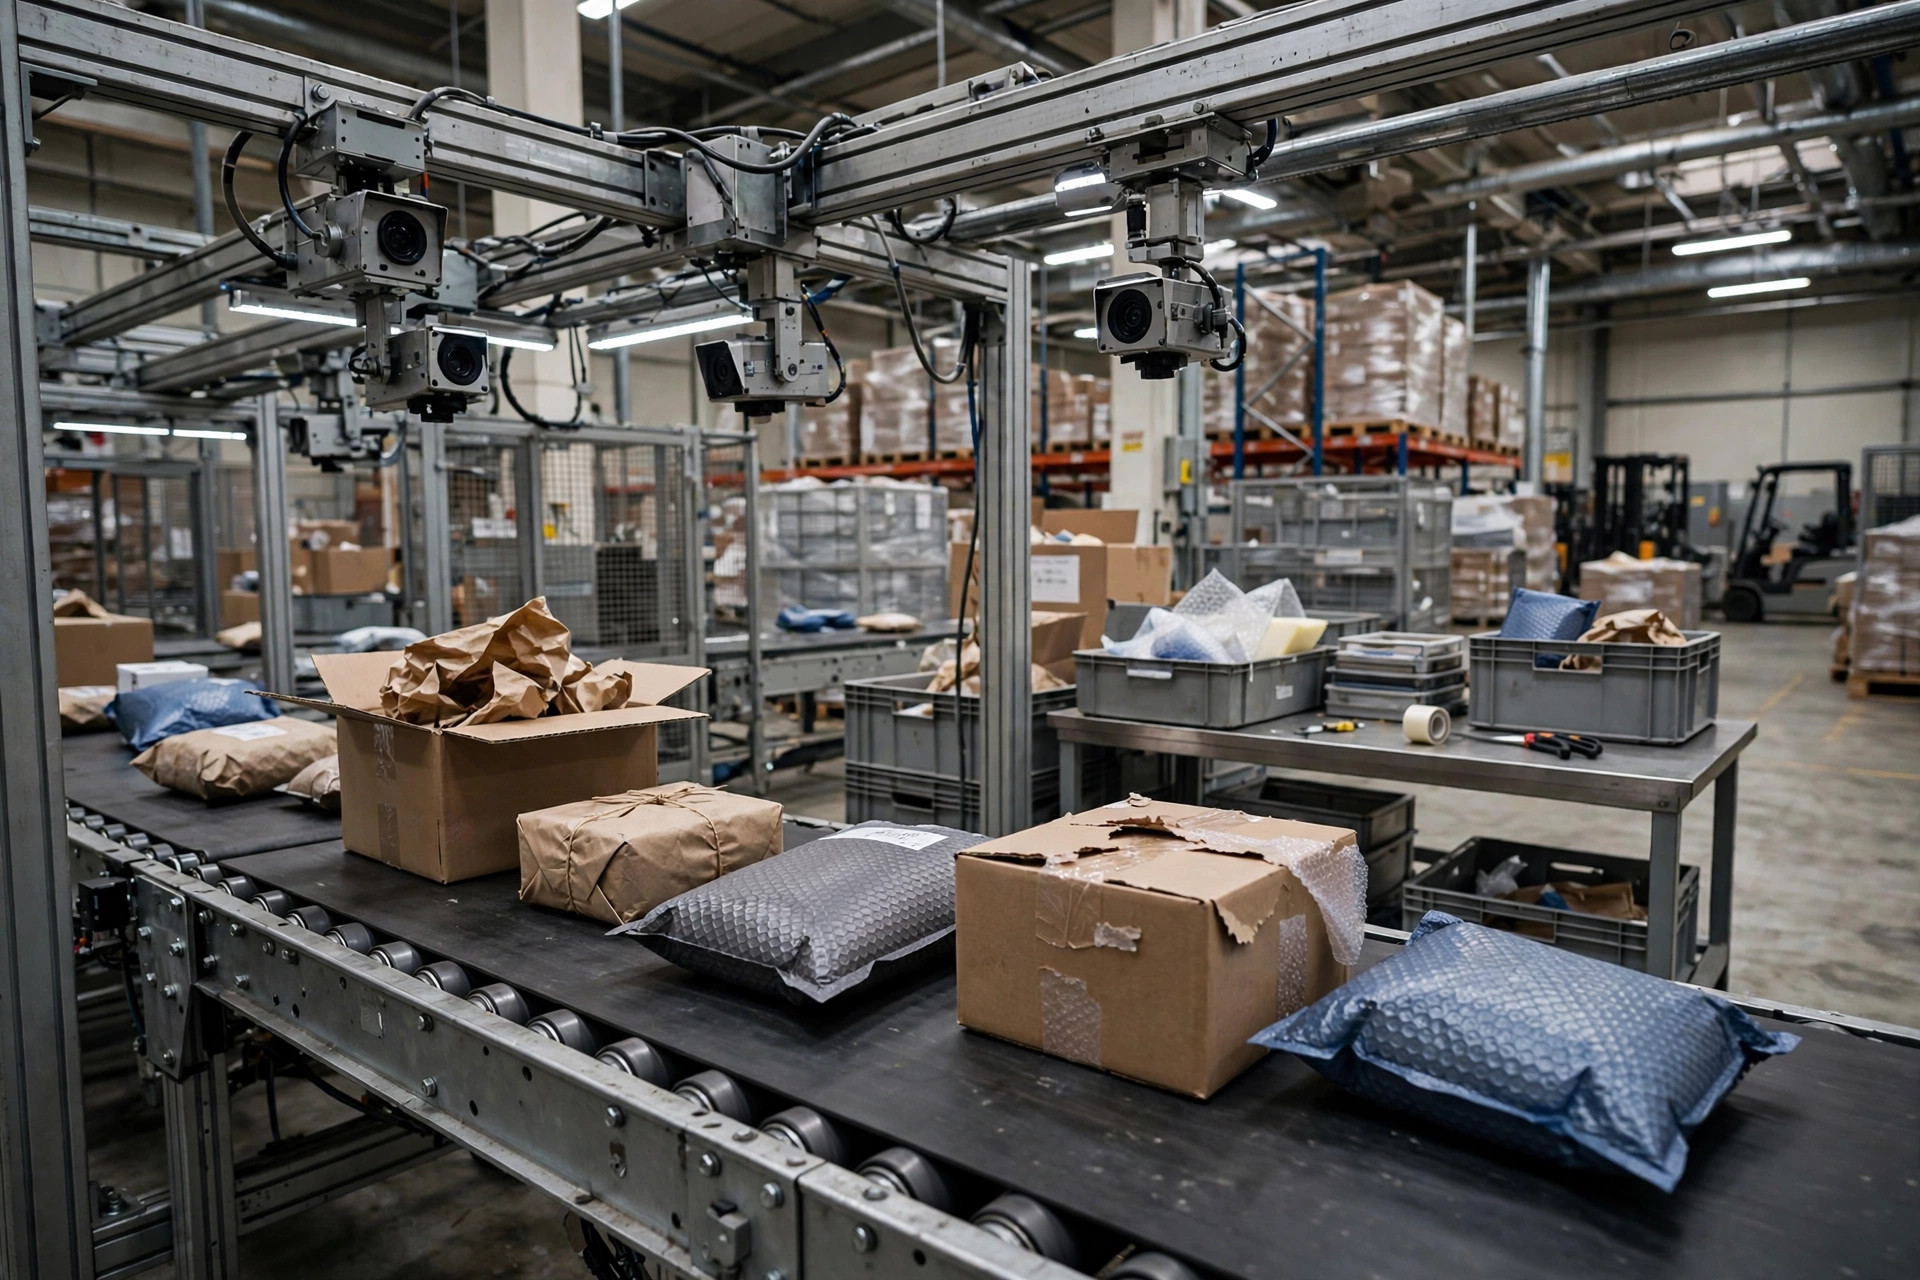
État de l'emballage. C'est là que meurt la précision. Cartons écrasés, tachés d'eau, à moitié enveloppés de film étirable, couverts d'autocollants promotionnels — plus l'emballage redessiné qui arrive chaque saison. Ce distributeur dont je parlais ? Son jeu d'entraînement contenait zéro exemple du nouvel emballage. Le modèle ne l'avait jamais vu, alors il a deviné.
Faites une série, cochez ce que vous avez couvert, retournez chercher ce qui manque. Ça bat à tous les coups les dix mille photos prises à l'aveugle. Une chose de plus : classez vos SKU selon la fréquence de changement de leur emballage. Les pièces industrielles qui se ressemblent pendant des années peuvent être photographiées une fois et laissées tranquilles. Les produits alimentaires et de grande consommation qui sont reconditionnés quelques fois par an ont besoin d'une collecte de données comme habitude récurrente, pas comme projet ponctuel.
Commencez par les boîtes, pas par les polygones
Le deuxième piège, c'est l'étiquetage. Beaucoup d'équipes sautent directement à la segmentation d'instances parce que « plus précis doit être mieux ». Mon conseil : faites d'abord fonctionner un modèle à boîtes englobantes.
Les boîtes sont bien plus rapides à étiqueter — un annotateur entraîné peut en faire des centaines en une matinée (estimation illustrative). Dessiner des polygones prend plusieurs fois plus de temps et est plus difficile à garder cohérent. Et les boîtes gèrent déjà la plupart des tâches d'entrepôt : identification des SKU, détection de cartons vides, savoir si une palette est chargée, s'il y a un corps étranger sur la bande. La segmentation ne mérite sa place que quand il faut une mesure précise (disons, estimer les dimensions d'un carton pour le poids volumétrique) ou quand l'occlusion est si forte qu'une boîte ne peut de toute façon pas encadrer l'objet.
La qualité des étiquettes bat la quantité, et ce n'est même pas serré. Quelques centaines d'images où deux annotateurs ne s'accordent pas sur ce qui compte comme « endommagé » n'apprennent que du bruit au modèle. Avant de commencer l'étiquetage, rédigez une spécification d'une demi-page : ce qui compte comme endommagé, ce qui compte comme correct, s'il faut étiqueter les objets occlus à plus de moitié. Puis faites étiqueter le même lot de quelques dizaines d'images (illustratif) par deux personnes. Là où elles divergent, corrigez la spécification. Ne montez pas en charge tant qu'elles ne sont pas globalement d'accord.
Sous-traiter ou étiqueter en interne ? Ça dépend de la phase. Les plateformes d'étiquetage (Labelbox, Roboflow et leurs pairs) montent vite en volume, mais elles ne connaissent pas votre métier — elles ne reconnaîtront pas qu'un « nouveau design d'emballage » ou un « autocollant promotionnel » est un changement significatif. Vos propres équipes étiquettent lentement, mais elles vivent dans l'entrepôt et repèrent les anomalies d'un coup d'œil. Ma méthode : étiquetez en interne le premier lot de cas difficiles pour fixer la norme, sous-traitez le volume courant, et auditez au moins un lot sur dix (taux d'audit illustratif) — un mauvais lot fait échouer l'ensemble.
Affinez, n'entraînez pas depuis zéro — puis réalimentez avec les cas difficiles
Voici le verdict : la plupart des entrepôts n'ont jamais besoin d'entraîner un modèle depuis zéro.
Les modèles open source pré-entraînés — la famille YOLO d'Ultralytics, pré-entraînée sur des jeux de données massifs comme COCO — ont déjà vu des centaines de milliers d'objets du quotidien. Votre travail est d'en affiner un sur vos SKU pour qu'il apprenne votre emballage. Les données nécessaires pour l'affinage, c'est un autre univers que l'entraînement depuis zéro : typiquement, quelques centaines à quelques milliers de photos bien couvertes suffisent pour démarrer (ça varie énormément selon les SKU ; testez avec vos propres données). Entraîner depuis zéro, c'est un sport de laboratoire de recherche. Les entrepôts n'en ont pas besoin.
Ne fixez pas non plus vos objectifs de précision au gré de vos envies. Dans un rôle de vérification, le modèle assiste les gens ; il ne les remplace pas. Un objectif raisonnable ressemble à « réduire la charge de vérification manuelle de plus de moitié, avec un taux d'échec pas pire que la référence manuelle actuelle » (illustratif — calibrez-le sur vos propres chiffres). Visez un magique « 99 % » et vous vous noierez dans une boucle infinie de collecte de données.
Le morceau le plus sous-estimé, c'est ce qui se passe après le lancement. De nouveaux SKU arrivent, les anciens sont reconditionnés, les autocollants promotionnels fleurissent — la longue traîne que votre jeu d'entraînement n'a jamais vue, là où le modèle devient aveugle. La solution, c'est une boucle, pas un jeu de données plus gros : après la mise en production, récupérez automatiquement les photos que le modèle a ratées ou sur lesquelles il doutait, faites-les confirmer par un humain, réalimentez le jeu d'entraînement avec les cas difficiles confirmés, et réentraînez selon un calendrier. La fréquence dépend de la vitesse d'évolution de vos SKU : les produits alimentaires et de grande consommation pourraient avoir besoin d'un réentraînement mensuel, voire bimensuel ; les produits industriels à évolution lente peuvent rester trimestriels. L'essentiel, c'est que la boucle continue de tourner — c'est exactement cette boucle qui manquait à mon ami distributeur.
Et un mot d'honnêteté : si vous n'avez même pas d'équipe d'étiquetage, ne parlez pas de construire le vôtre. Il existe sur le marché des services de vérification par vision à la station — achetez une station, prouvez la valeur, puis décidez s'il faut construire. Le plus gros coût d'un modèle maison, ça n'a jamais été les GPU. Ce sont les gens.
Ce que vous pouvez faire demain : ne lancez pas encore de projet. Choisissez une station de vérification de picking, passez un après-midi à photographier vos meilleurs SKU, quelques dizaines de prises chacun (illustratif), dans des conditions normales, à contre-jour, endommagées et empilées — quelques centaines de photos au total. Envoyez-les à une plateforme d'étiquetage pour un lot d'essai. Mettez-le en production une semaine et regardez comment ça se comporte sur des équipes réelles. Si c'est bon, parlez d'expansion. Sinon, vous saurez exactement où est le problème — et neuf fois sur dix, c'est une variation non couverte, pas trop peu de photos.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.