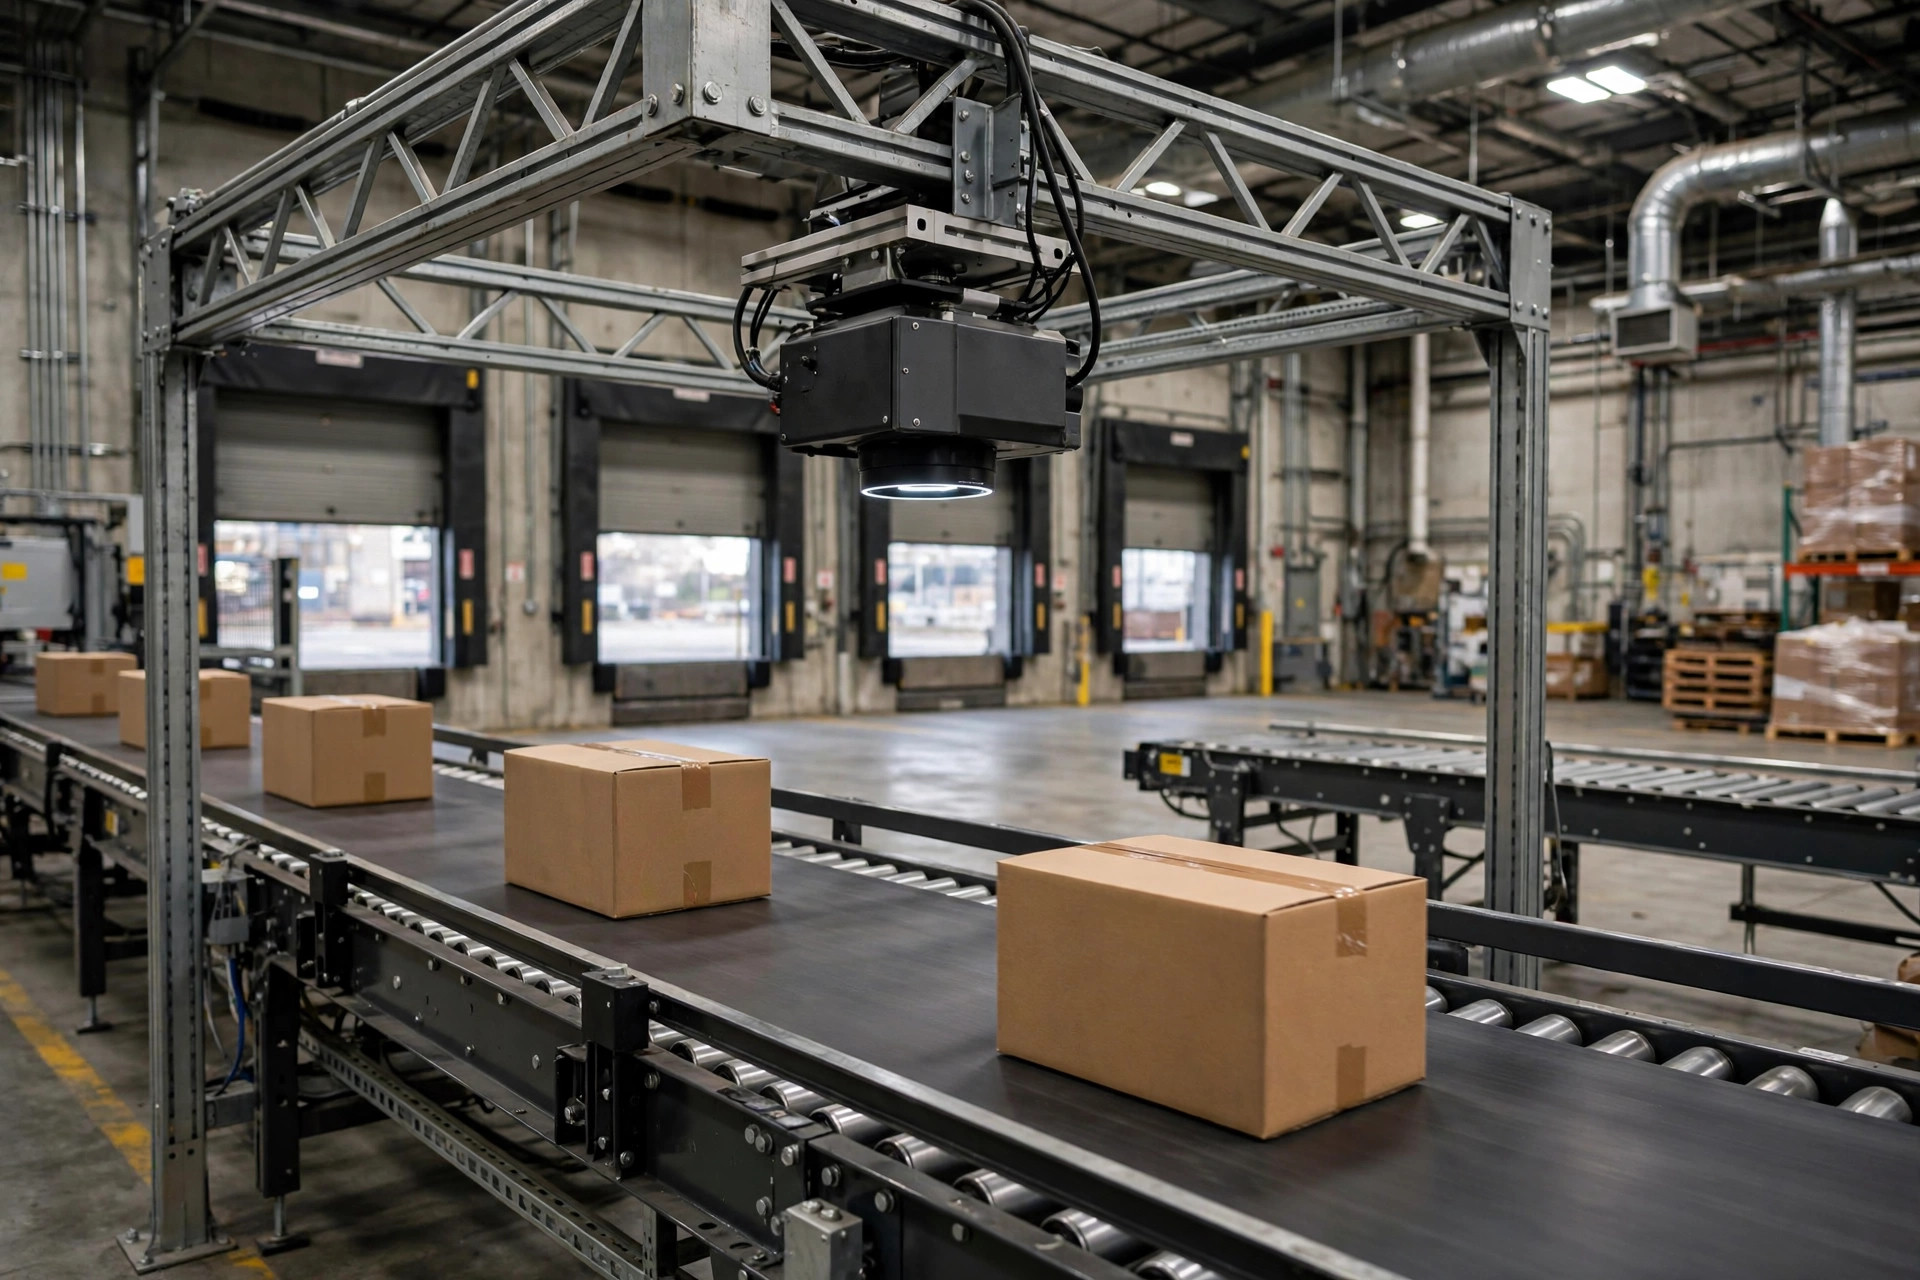
El año pasado estuve en un almacén de accesorios 3C viendo un sistema de visión nuevo en el transportador. Su trabajo: leer las etiquetas de SKU en las cajas y reemplazar el escaneo manual. La demo se veía genial. Luego lanzaron productos nuevos, y en la primera semana el sistema clasificó con confianza los 37 SKU nuevos como viejos. Las cámaras estaban bien. El algoritmo estaba bien. El modelo simplemente nunca había visto esas caras — y eligió de todos modos la categoría vieja "más cercana".
Ese es el defecto fatal de los clasificadores clásicos: solo pueden elegir entre categorías que les enseñaron. Póngales una pregunta nunca vista en el examen y aun así escribirán una respuesta. El aprendizaje de pocos ejemplos existe para corregir exactamente esto.
Lo que realmente está aprendiendo
Un clasificador de imágenes tradicional memoriza cómo se ve cada categoría. Muéstrele miles de fotos del producto A y recuerda la cara de A; muéstrele una imagen nueva y pregunta: ¿se parece más a A, B o C? Note el "o" — asume que la respuesta debe ser una de las categorías conocidas. Un SKU nuevo, por distintivo que sea, se mete a la fuerza en algún cubo viejo. Así es como murieron 37 SKU nuevos en la primera semana.
El aprendizaje de pocos ejemplos invierte la lógica: en lugar de memorizar "quién es este", aprende "si esto se parece". Durante el entrenamiento, el modelo aprende a convertir una imagen en una cadena de números — un embedding. Las imágenes de aspecto similar obtienen números cercanos; las de aspecto distinto, números distantes. Al salir en vivo, llega un SKU nuevo, fotografía de 5 a 20 fotos de referencia, y el sistema recuerda dónde están esos números. Cada imagen nueva después se juzga por distancia: la referencia a la que esté más cerca gana la etiqueta.
La analogía humana: un clasificador clásico es un examen a libro cerrado — solo se evalúa lo que estudió. El aprendizaje de pocos ejemplos es como reconocer a un desconocido — ve una cara dos veces, la recuerda, la detecta entre la multitud la próxima vez. No necesita saber el nombre ni el trabajo de la persona. Recordar la cara basta.
Una implementación común, la red prototípica, es aún más literal: promedia las pocas fotos de referencia de cada categoría en una "cara promedio", y asigna cada imagen nueva al promedio más cercano. Simple de implementar, y suficiente para muchos trabajos de almacén.
Dónde brilla — y dónde no
Empecemos por dónde brilla. Los SKU que se ven claramente distintos entre sí — empaques de colores distintos, tamaños de caja distintos, productos físicamente distintos — son su terreno. Lanza un SKU nuevo, operaciones toma una docena de fotos y las sube, y está funcionando en media hora. Sin ciclo de etiquetado y reentrenamiento de dos semanas.
El empaque estable también ayuda. Algunos consumibles mantienen el mismo empaque por años; tome las referencias una vez y sirven por años.
Ahora las zonas prohibidas. Primera: ropa con el mismo estilo en cinco colores. Visualmente casi idéntica salvo el color, distinguida en la práctica por etiquetas colgantes y etiquetas de lavado — invisibles para una cámara a velocidad de transportador. Forzarlo solo produce errores confiados. Escanee el código de barras y siga.
Segunda: empaque transparente o reflectante. Cambie la iluminación y la "cara" cambia; las distancias de embedding se desmoronan. A menos que su control de iluminación sea de grado industrial, no espere que funcione.
Tercera: catálogos que rotan cientos de SKU al mes. Cada SKU nuevo necesita fotos de referencia tomadas, revisadas y archivadas — eso es trabajo sostenido. Deje que la biblioteca de referencias se pudra y la exactitud decae en silencio en un trimestre, y ni siquiera lo sabrá.
Tres trampas en el despliegue
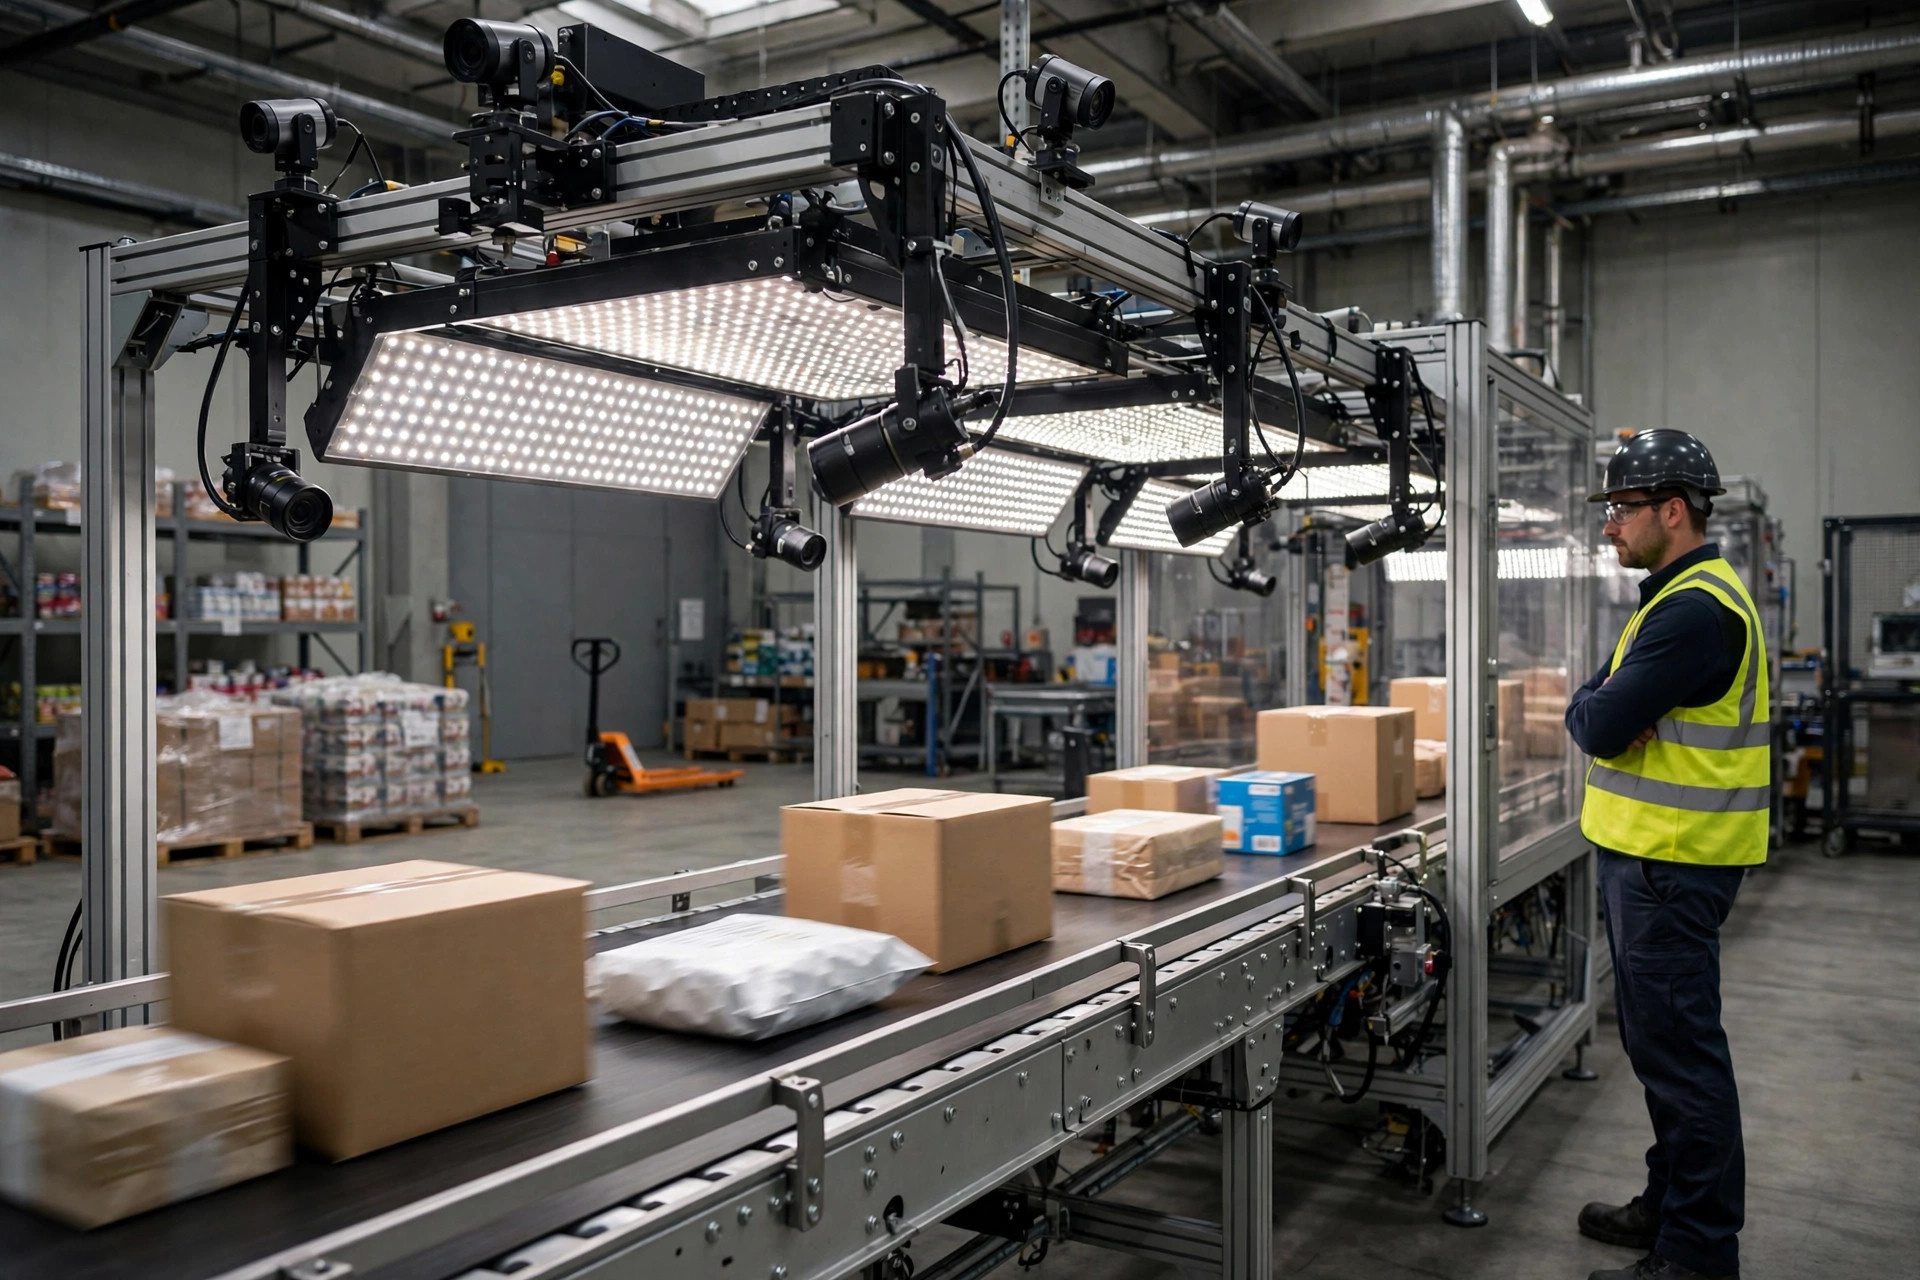
Trampa uno: referencias tomadas demasiado "limpias". La gente hace que operaciones pose productos en la oficina — fondo blanco, ángulo frontal, luz perfecta. Luego el transportador sirve imágenes inclinadas, borrosas, con sombras y nada coincide. Tome las referencias en el transportador real, bajo luz real, a velocidad real: de 8 a 12 tomas por SKU, múltiples ángulos, un poco de inclinación, e incluya empaque sucio y dañado también. Cuanto más cerca estén las referencias de las condiciones de combate, mejor funciona.
Trampa dos: sin opción de "no sé". Por lejos que esté la distancia, el sistema igual elige la más cercana — siempre tiene una respuesta. Necesita un umbral de distancia: más allá, la imagen se declara desconocida y se dirige a un humano. Ese umbral no es intuición; pase dos semanas de datos reales por él y encuentre dónde se equilibran las falsas aceptaciones y los falsos rechazos.
Trampa tres: nunca ponerle precio al costo de una mala identificación. Una mala identificación cuesta el flete del envío erróneo más el viaje de vuelta más el tiempo de servicio al cliente. Una revisión humana cuesta unos segundos de trabajo. Su trabajo es encontrar el rigor de umbral que minimiza el costo total. Esa matemática es distinta para cada almacén — no copie los parámetros de otro.
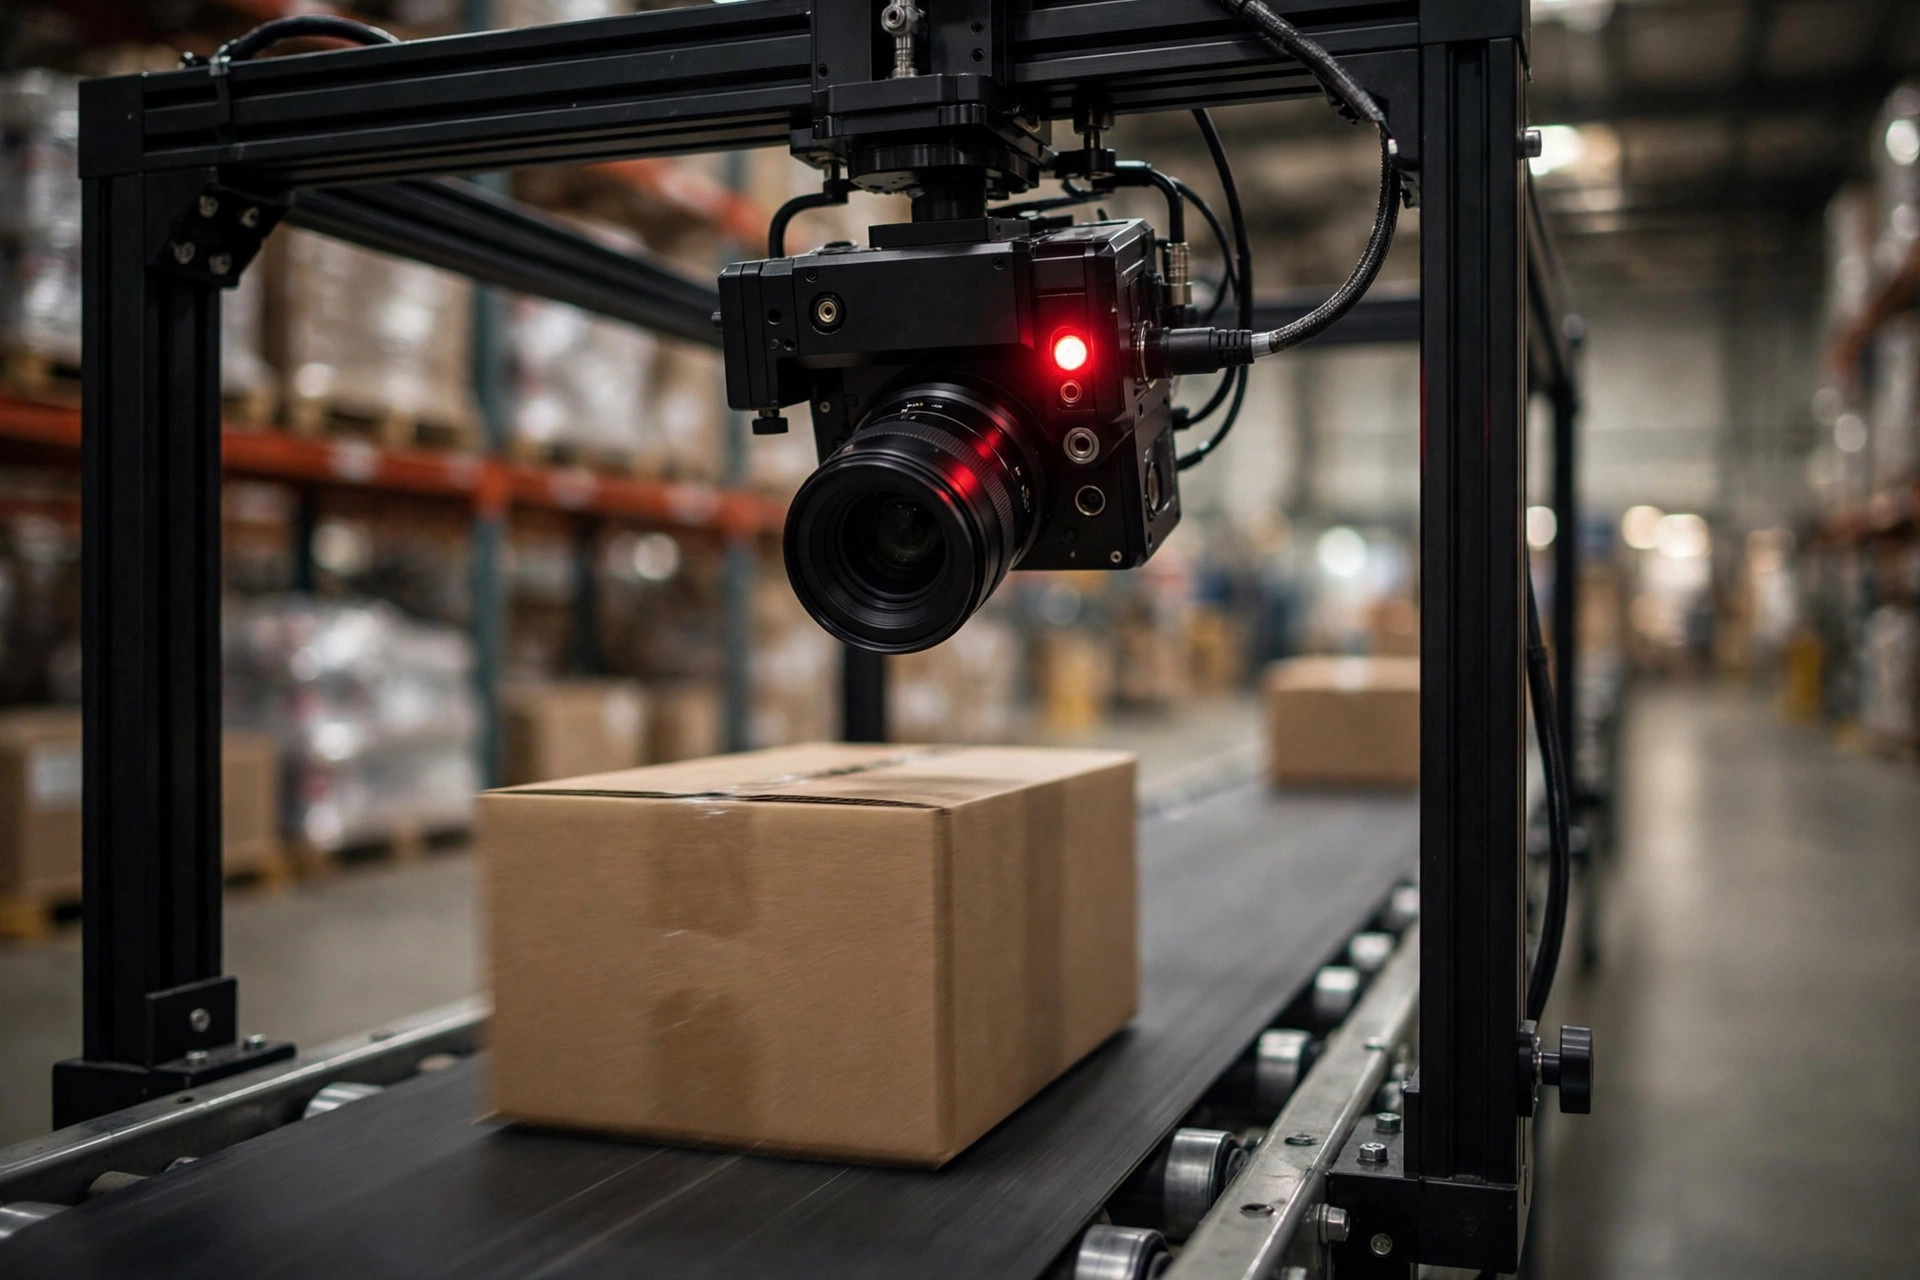
Una nota de hardware: no escatime en la cámara. Una cámara industrial como la Basler ace combinada con iluminación LED estable produce imágenes mucho más consistentes que una webcam genérica. El aprendizaje de pocos ejemplos es sensible a la consistencia de imagen; ahorrar unos pocos miles de dólares al inicio y perder cinco puntos de exactitud después es el peor negocio.
Un lanzamiento de cuatro semanas que funciona
Semana uno: tome referencias en el transportador, con luz real, a velocidad real. Incluya los casos difíciles — inclinados, medio ocluidos, empaque arrugado. La calidad de referencia pone el techo; no apure esta semana.
Semana dos: fije el umbral. Pase dos semanas de datos históricos por él y encuentre el punto de equilibrio entre falsas aceptaciones y rechazos. Sesgue hacia más revisión humana, no menos — un envío erróneo cuesta docenas de veces lo que cuesta una revisión.
Semana tres: pilotee en un transportador, o en 20 SKU. Revise cada mala identificación a diario y cambie las malas referencias. Descubrirá pares de SKU que "se ven distintos pero en realidad no" — manéjelos ahora.
Semana cuatro: escale, y fije el proceso de mantenimiento — quién fotografía SKU nuevos, con qué frecuencia se revisan referencias viejas, con qué frecuencia se reajusta el umbral. Un sistema sin proceso de mantenimiento decaerá en tres meses. Garantizado.
Qué preguntar al proveedor
La demo de cada proveedor de visión se ve increíble. Antes de firmar, haga cinco preguntas.
Una: ¿cuánto tarda un SKU nuevo en salir en vivo? Si la respuesta es "reentrenar el modelo, dos semanas", es un clasificador clásico disfrazado de few-shot. Few-shot de verdad significa agregar referencias, no reentrenar — media hora, no dos semanas.
Dos: ¿cuáles son la tasa de mala identificación y la tasa de "no sé", por separado? Quien solo cite exactitud está ocultando algo. 99% de exactitud con 30% dirigido a humanos significa que un tercio del trabajo sigue siendo manual.
Tres: ¿cómo maneja la deriva de iluminación? Pídales que bajen a la mitad las luces de la sala demo y lo corran de nuevo. Muchos sistemas sacan 99% bajo luz de exhibición y caen a 90% cuando la mitad de los tubos del almacén se han agotado.
Cuatro: ¿cuántas categorías de SKU puede contener la biblioteca de referencias? Algunas configuraciones de recuperación de embeddings se vuelven muy lentas pasando unos pocos miles de categorías. Si su catálogo anda por cinco dígitos, pregunte ahora.
Cinco: ¿corre sin conexión? ¿Edge o nube? Un transportador mueve docenas de cajas por minuto; un hipo de red en una configuración de nube detiene toda la línea. Para trabajo de almacén, solo recomiendo despliegue edge.
Cualquier proveedor que responda las cinco limpiamente vale una conversación de precio. Quien no pueda — por pulida que sea la demo — está vendiendo una pieza de feria, no una herramienta de producción. La tecnología no es magia. Usarla en el lugar correcto sí lo es.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.