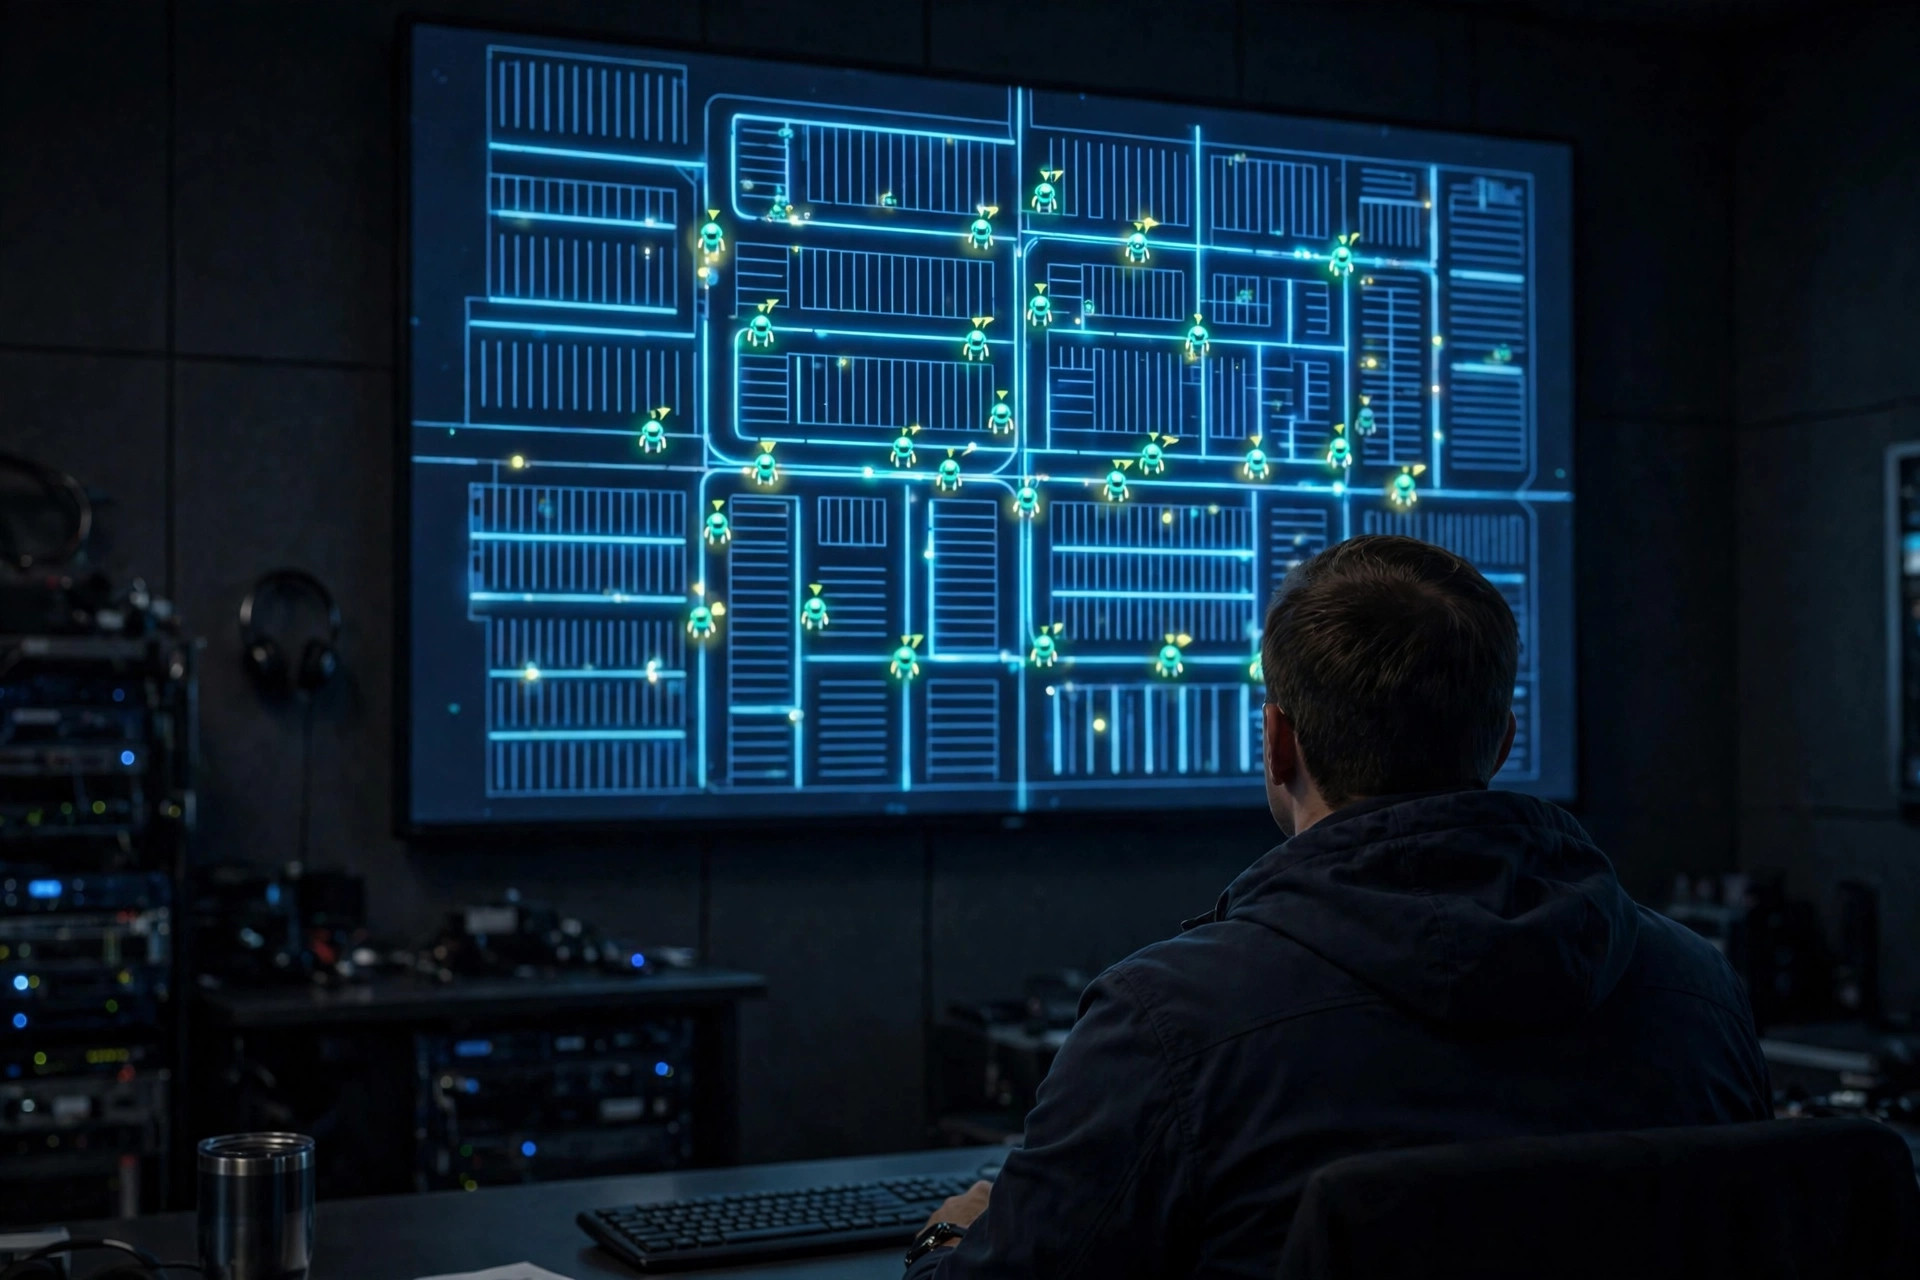
Pregunta a cualquier proveedor de AMR qué pasa cuando se cae la red y verás cómo la sala se queda en silencio. La demostración siempre muestra el camino feliz: robots deslizándose, tareas asignándose, el panel brillando en verde. Nadie demuestra la llamada telefónica de las 2 de la mañana. Pero yo he recibido esa llamada, y la diferencia entre una mala noche y un desastre nunca fueron los robots: fueron tres ajustes en los que nadie había pensado.
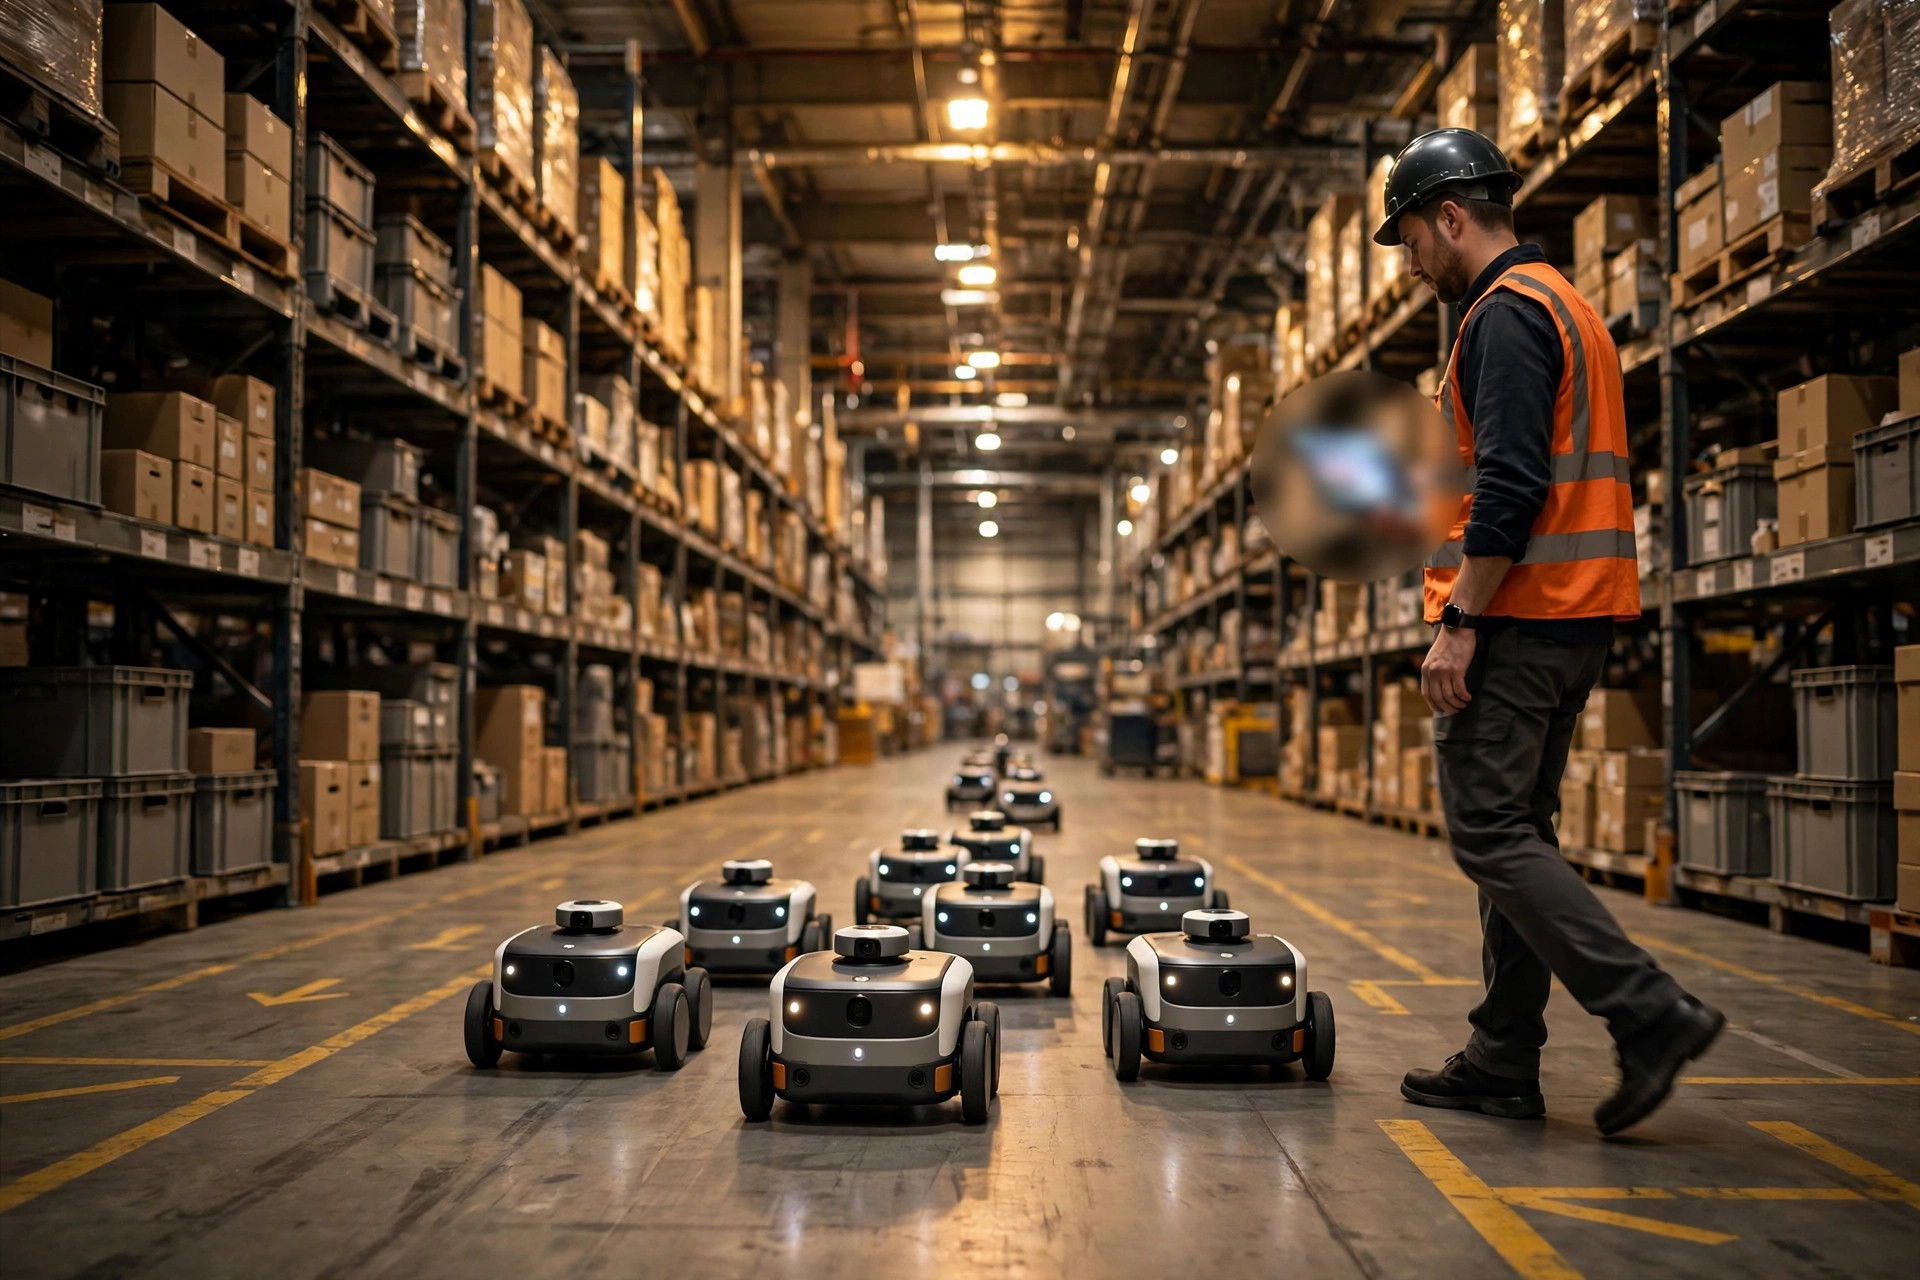
El invierno pasado, un centro de distribución a las afueras de Chicago perdió su RCS durante unos quince minutos por un reinicio rutinario de un switch. Una veintena de robots se quedaron congelados en medio del pasillo. El turno de noche hizo lo que hace la gente sin formación: empezó a reiniciar los robots uno por uno, lo que solo enredó aún más los estados de las tareas. Cuando la red volvió, la mitad de la flota mostraba "offline" y la otra mitad "task exception", y deshacer el enredo tomó casi dos horas. Los robots estaban bien. Lo que faltaba era el plan.
Esta es la verdad incómoda: el enlace entre el robot y el RCS es el enlace entre el cerebro y el cuerpo, y cada proveedor entrega valores predeterminados distintos sobre lo que hace el cuerpo cuando el cerebro se queda en silencio. Si esos valores no están en tu contrato, estás comprando una sorpresa.
Nadie prueba la red hasta que muere
El primer ajuste es el comportamiento ante la pérdida de enlace: cuánto tiempo sin latido antes de que el robot declare muerta la red, y qué hace después. Si el tiempo de espera es demasiado corto, cada microcorte de Wi-Fi provoca una parada de emergencia en toda la planta. Si es demasiado largo, una red realmente muerta deja a los robots conduciendo con instrucciones obsoletas.
Tras el tiempo de espera, los proveedores suelen ofrecer dos filosofías. La conservadora: detente donde estés y espera. Funciona en edificios con tráfico mixto de personas y robots y pasillos complejos. La agresiva: cambia al modo local, termina la tarea actual con la caché del mapa a bordo y luego estaciónate en un lugar apartado. Suena más inteligente, pero tiene una trampa: el mapa local tiene que estar actualizado. Si el RCS acababa de emitir una zona de exclusión temporal y el robot no la había sincronizado antes de la caída, el modo local lo llevará directo a un pasillo bloqueado.
Mi recomendación: los edificios con tráfico mixto deben detenerse en el lugar; las líneas de producción cerradas de ruta fija pueden considerar la continuación local. En cualquier caso, la velocidad reducida no es negociable: un robot que avanza a ciegas debe ir más lento de lo normal. Ponlo por escrito en tus criterios de aceptación.
Y una palabra sobre la propia red: la mayoría de las "caídas" no son redes muertas, son zonas muertas. Un robot que deambula entre dos puntos de acceso falla en el traspaso, el latido se interrumpe unos segundos y el RCS lo declara perdido. Conecta los servidores del RCS por cable: no los obligues a pelear con los robots por el Wi-Fi. Añade redundancia a la cobertura de AP y revisa las esquinas y la parte trasera de las estanterías altas. Antes de la puesta en marcha, haz circular la flota por todo el edificio en una prueba de itinerancia y corrige primero los puntos débiles. Eso supera con creces ajustar los tiempos de espera después.
Los tres ajustes enterrados en tu contrato
El segundo ajuste es la cola de tareas: lo que el robot recuerda y quién gana la discusión cuando la red regresa. A bordo, un robot suele guardar en caché su tarea actual más una o dos tareas en cola; la profundidad de la caché varía según el proveedor. Una caché poco profunda significa que una caída de más de unos minutos borra la lista de tareas y el RCS tiene que reasignar todo tras la recuperación. Una caché profunda significa que el robot sigue trabajando de memoria un poco más.
La verdadera trampa es el momento del reencuentro. El RCS despierta recordando el mundo como era antes de la caída; los robots conservan el trabajo que hicieron durante la caída. Algunos sistemas concilian del lado del robot: el robot informa, el RCS acepta y las tareas se reanudan donde se detuvieron. Otros concilian del lado del RCS: todo lo de la ventana de la caída se anula y se reasigna. En ese segundo diseño, la paleta que un robot ya entregó en la línea aparece como "not delivered" y el sistema envía otra. Entrega doble, dos paletas en la línea y una discusión sobre de quién es la culpa.
Así que antes de firmar: cuando la red se recupera, ¿qué estado de tarea prevalece y cómo se eliminan las ejecuciones duplicadas? Consigue ambas respuestas en un anexo del contrato. Durante la selección, no te limites a ver la demostración del camino feliz: pide al proveedor que demuestre una caída de red de cinco minutos y su recuperación, y observa si la lógica de conciliación se sostiene. La vacilación en esa demostración te lo dice todo.
El tercer ajuste es la toma de control manual: quién puede pasar un robot a manual, cómo y qué pasa después. Cuando la caída se prolonga, siempre habrá alguien en planta que piense "lo conduzco yo mismo". Sin una regla, tienes tres turnos haciendo tres cosas distintas: empujar robots, encenderlos y apagarlos, arrancar baterías. Lo vi exactamente una vez: tras la recuperación, nadie podía decir qué robots estaban a mitad de tarea y cuáles simplemente estaban perdidos, porque los humanos habían tocado la mitad de la flota.
La solución es aburrida y esencial: nombra un comandante de caída por turno, normalmente el jefe de turno. Nadie más toca un robot: ni movimientos manuales ni ciclos de encendido. Tras la recuperación, el comandante recorre una lista de verificación, confirma el estado de cada robot y solo entonces emite el comando de reanudación. Escríbelo en el manual de operación y enséñalo en la incorporación. Y mantén el privilegio restringido: la autoridad del modo manual es para los jefes, no para todos. Los operadores necesitan visibilidad del estado, no las llaves.
Lo que me lleva a la prueba de aceptación que más importa. En la semana de la puesta en marcha, desconecta el cable de verdad: no una presentación, no una demostración de laboratorio, sino el cable de red real, en tu edificio real, durante producción real. Observa cada robot: cuántos segundos tarda en declarar la pérdida, si se detiene o continúa, qué distancia recorre, si las tareas se concilian al recuperarse, si algo se asigna dos veces. Escríbelo todo. Ese documento es el primer borrador de tu manual de caídas.
Luego hazlo cada trimestre, como un simulacro de incendio. El equipo de red envejece, el RCS se actualiza, el firmware de los robots cambia: cualquiera puede cambiar un valor predeterminado en silencio. Elige una ventana de baja producción, desconecta el cable durante diez minutos y confirma que el manual sigue funcionando.
Una caída no es el desastre. Descubrir tu plan de contingencia por primera vez en plena temporada alta, sí. Ensáyalo antes de necesitarlo, y las llamadas de las 2 de la mañana se acortan mucho.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.