En los últimos dos años, el debate sobre la IA en el borde frente a la nube en el almacenamiento ha producido un patrón curioso en los materiales de marketing de los proveedores: el mismo proveedor presentará la "IA en el borde en tiempo real" en un párrafo y la "orquestación unificada basada en la nube" en el siguiente, mientras que la pregunta que realmente interesa a los clientes —dónde debería ejecutarse mi inferencia— rara vez recibe una respuesta directa. Según la observación pública disponible del sector, este debate no es una competición tecnológica en la que el ganador se lo lleva todo. Es una decisión de ingeniería que debe tomarse tarea por tarea, porque las distintas tareas difieren notablemente en su sensibilidad a la latencia, la fiabilidad, el coste y la seguridad de los datos. Aplicar un único modelo de despliegue a todas las tareas es, en sí mismo, un síntoma de la falta de un marco de decisión.
El fenómeno: tres tareas, tres escalas de tiempo
Las tareas de inferencia de IA en el almacén se dividen aproximadamente en tres categorías según su sensibilidad temporal, y la sensibilidad temporal es el primer factor determinante del lugar de despliegue.
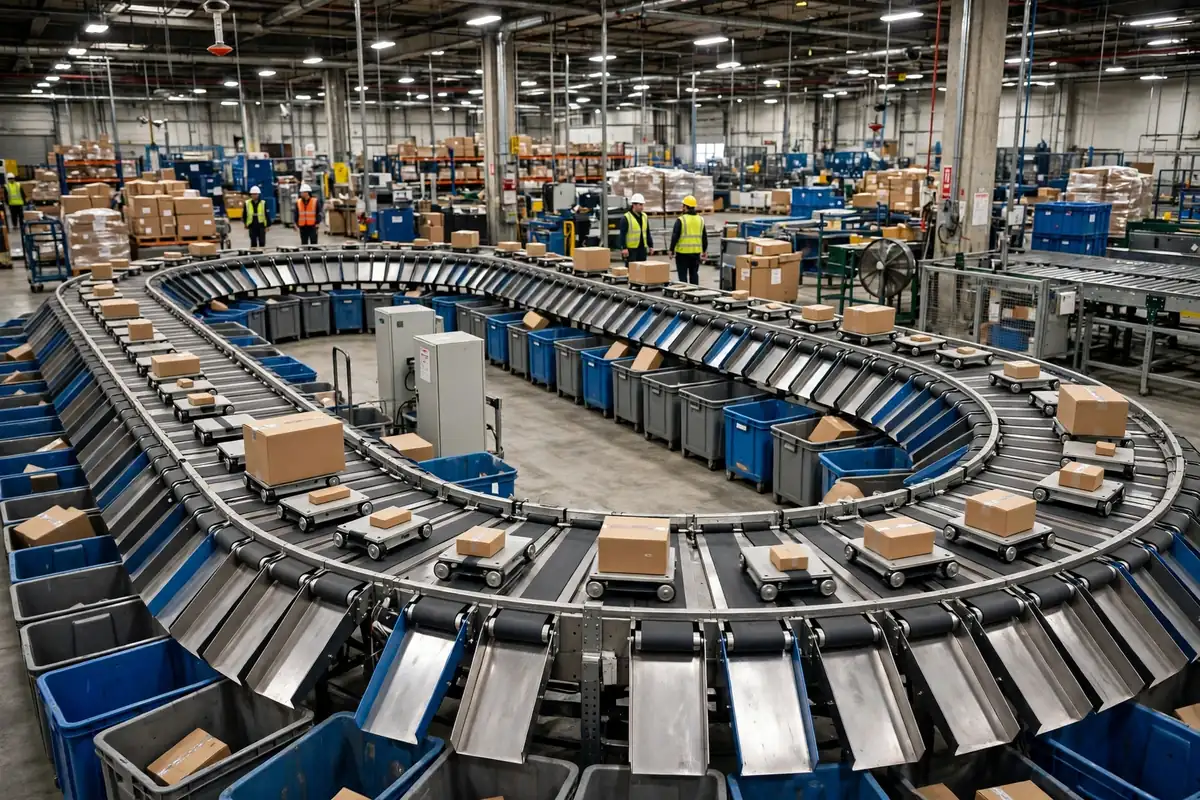
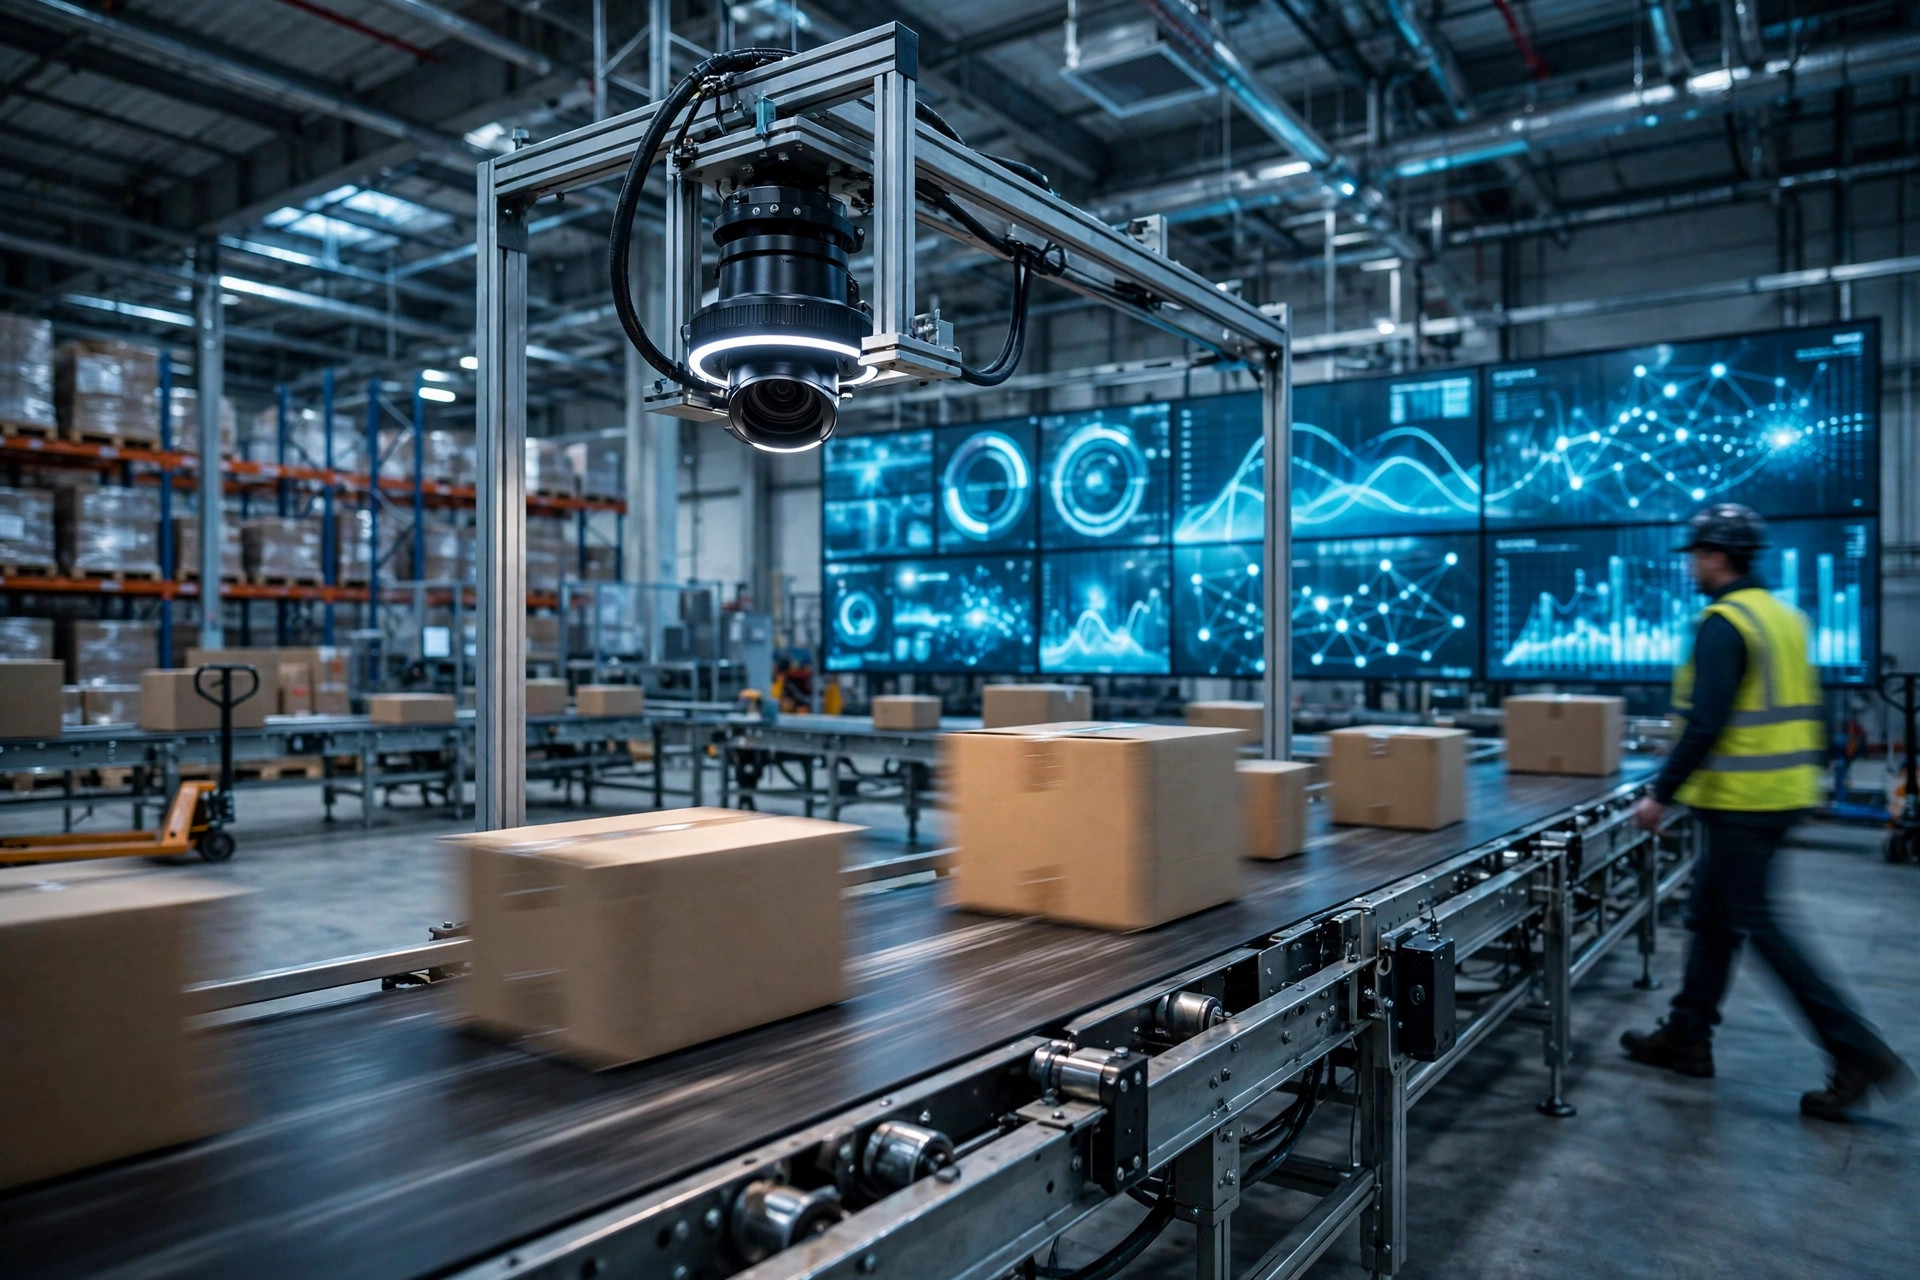
La primera categoría es la inspección visual: la lectura de códigos de barras en cintas transportadoras, la detección de paquetes dañados, el dimensionado y la interceptación de excepciones en las rampas de clasificación. Estas tareas comparten una propiedad: están directamente acopladas a la acción física. En el plazo de un segundo desde que la cámara captura un paquete, un brazo robótico o un desviador debe actuar. Si la latencia de inferencia supera el tiempo de ciclo mecánico, toda la línea se ralentiza o se detiene. En otras palabras, el presupuesto de latencia para la inspección visual se mide normalmente en decenas de milisegundos, y cualquier viaje de ida y vuelta a través de una red de área amplia es inaceptable.
La segunda categoría es la programación de los AMR y de los equipos: la planificación de rutas, la asignación de tareas y el control del tráfico. Lo que estas tareas necesitan es una visión global —las posiciones en tiempo real de decenas o incluso cientos de unidades, las colas de tareas y los estados de congestión— más que una respuesta en milisegundos en un solo punto. Las decisiones de programación operan en un ciclo medido en segundos, lo que deja margen para elegir: pueden ejecutarse en un servidor local o en la nube, y los factores decisivos son la escala del sistema y la tolerancia a las interrupciones de red.
La tercera categoría es la previsión: la predicción de la demanda, las sugerencias de reposición, la planificación de la mano de obra y las advertencias de fallo de los equipos. Estas tareas se ejecutan sobre datos históricos y por lotes, y sus resultados siguen siendo válidos durante horas o incluso días. Casi no tienen ningún requisito en tiempo real, pero sí la mayor demanda de potencia de cálculo y de amplitud de datos.
Las escalas de tiempo de estas tres categorías difieren en órdenes de magnitud. Forzarlas a una única arquitectura de despliegue garantiza un coste innecesario en algún punto.
Cuatro dimensiones: el borde frente a la nube en latencia, resiliencia sin conexión, coste y seguridad de los datos
En cuanto a la latencia, la ventaja del borde es física: los datos nunca salen del almacén, por lo que los viajes de ida y vuelta de la inferencia pueden mantenerse en milisegundos. Los viajes de ida y vuelta a la nube dependen de la calidad de la red, y normalmente oscilan entre decenas y cientos de milisegundos, con una larga cola de fluctuación. Para la inspección visual acoplada a los tiempos de ciclo mecánico, esa diferencia es decisiva. Para la previsión, es totalmente irrelevante.
La dimensión sin conexión a menudo se subestima. Una interrupción de la red del almacén puede ser una línea de fibra cortada o un conmutador del campus averiado, y durar desde minutos hasta horas. Si la inspección visual y la programación de los equipos dependen por completo de la nube, una interrupción significa una línea detenida. Si la inferencia se ejecuta localmente, las operaciones principales continúan durante la interrupción, y solo se detienen la previsión y la sincronización de informes. La pregunta correcta al evaluar la tolerancia sin conexión es concreta: si la red se cae durante una hora, ¿cuántos pedidos puede seguir enviando este almacén? La respuesta determina directamente qué tareas deben permanecer locales.
La dimensión del coste requiere una contabilidad completa, no solo una comparación de los precios unitarios de cálculo. El pago por uso de la nube parece flexible, pero la inspección visual funciona 24/7 sin pausa, y con el tiempo la combinación de los cargos por inferencia en la nube y las tarifas de transferencia de datos a menudo supera la depreciación de una inversión única en hardware en el borde. Por el contrario, la previsión es intermitente y orientada a lotes, por lo que el cálculo elástico en la nube es más barato: no hay necesidad de poseer hardware de forma permanente para una capacidad máxima que se usa una vez por semana. El punto contraintuitivo es que muchos asumen que "pasar a la nube ahorra dinero", pero para las cargas de trabajo de inferencia continua, la factura de la nube es precisamente la partida con más probabilidades de descontrolarse, no porque el precio unitario sea alto, sino porque el uso nunca se detiene.
La dimensión de la seguridad de los datos depende de la naturaleza de los propios datos. Las imágenes del exterior de los paquetes y las grabaciones de las operaciones dentro del almacén suelen tener poca sensibilidad comercial, por lo que transmitirlas fuera es un riesgo relativamente bajo. Los datos de pedidos de los clientes, la estructura de inventario de un remitente o las grabaciones de vigilancia que contienen rostros de trabajadores requieren una evaluación de cumplimiento más estricta antes de cruzar el límite de la red. Los clientes en Europa y en determinados sectores regulados se enfrentan a restricciones explícitas sobre los datos que salen de sus instalaciones, y en esos casos el despliegue en el borde no es una elección de rendimiento, sino un requisito previo de cumplimiento.
| Dimensión | Despliegue en el borde | Despliegue en la nube |
|---|---|---|
| Latencia | Escala de milisegundos, estable | Decenas a cientos de ms, con fluctuación |
| Resiliencia sin conexión | Las operaciones principales continúan | Depende de la red; una interrupción significa detención |
| Estructura de costes | Hardware inicial + bajo coste marginal | Sin hardware + cargos de uso continuos |
| Seguridad de los datos | Los datos permanecen en las instalaciones, favorable al cumplimiento | Deben evaluarse el cumplimiento de la transmisión y el almacenamiento |
| Tareas más adecuadas | Inspección visual, control en tiempo real | Previsión, coordinación entre centros |
Dos casos en el mismo almacén
Consideremos dos escenarios realistas. El primero es una modernización de una línea de clasificación en un almacén logístico de terceros en el este de China: a la velocidad de la cinta transportadora, la inspección visual debe completar su juicio antes de que cada paquete llegue al desviador, y cualquier evento aislado de fluctuación en la nube provoca una clasificación errónea. El equipo del proyecto terminó desplegando el modelo de inspección en servidores en el borde junto a la línea, y la nube se encargó solo de las actualizaciones del modelo y de las estadísticas de rendimiento. La lógica era sencilla: el presupuesto de tiempo de la tarea no permitía cruzar la red.
El segundo es la previsión de reposición para una cadena minorista: los datos provienen de decenas de almacenes, el modelo se reentrena semanalmente y el resultado es una recomendación de reposición para dos semanas. Ejecutar esto en la nube es natural: los datos ya están distribuidos, la demanda de cálculo se concentra en la ventana de entrenamiento y el consumo en reposo el resto del tiempo es casi cero. Forzar la previsión a servidores en el borde en cada almacén por el bien de una "arquitectura unificada" significaría pagar por capacidad de cálculo en cada centro que se usa una vez por semana. Claramente antieconómico.
Puestos uno al lado del otro, la conclusión es clara: el lugar de despliegue debe seguir a la tarea, no a la línea de marketing del proveedor.
Una ruta híbrida: el borde y la nube por capas
Para la mayoría de los almacenes, la respuesta realista es el despliegue híbrido, y la clave del despliegue híbrido es una estratificación limpia, no simplemente "un poco de ambas".
Una estratificación viable es la siguiente: la capa del borde ejecuta la inferencia en tiempo real: inspección visual, juicio de parada de emergencia, control de una sola máquina. Una capa local o regional ejecuta la programación: asignación de tareas de los AMR, control del tráfico, optimización de oleadas, desplegada en servidores dentro del almacén o en una sala de datos del campus, equilibrando una visión global con la resiliencia sin conexión. La nube ejecuta la previsión y la coordinación: predicción de la demanda, recomendaciones de transferencias entre almacenes, entrenamiento de modelos y gestión de versiones.
Al implementar esto se aplican tres sugerencias de secuencia. Primero, fijar las tareas en tiempo real en el borde para proteger la continuidad operativa; esta es una base no negociable. Segundo, mantener la capa de programación local en primer lugar y trasladarla a la nube solo cuando crezca la escala y aparezca una demanda real de coordinación entre almacenes; no pagar pronto los costes de migración a la nube por una escala imaginada. Tercero, gestionar los modelos de forma centralizada desde la nube: el entrenamiento, el versionado y el despliegue por fases son responsabilidades de la nube, mientras que el borde solo descarga y ejecuta los modelos, preservando la velocidad de iteración de la nube sin hacer que la cadena de inferencia dependa de la red.
Un límite merece énfasis: el despliegue en el borde no termina en "comprar un servidor". Los mecanismos de actualización de modelos, el mantenimiento remoto de la flota en el borde y la recuperación de datos tras las interrupciones son cargas de trabajo que habitualmente se subestiman. Si un equipo no puede mantener una flota de dispositivos en el borde, el despliegue forzado en el borde introduce nuevos puntos de fallo, en cuyo caso un compromiso de "servidor local más respaldo en la nube" es más robusto que el borde puro.
En última instancia, la elección entre el borde y la nube no es una cuestión de fe técnica, sino un problema aritmético de coste y riesgo: dividir por tarea, puntuar en las cuatro dimensiones y comprobar si la capacidad operativa del equipo puede sostener la arquitectura elegida. En los próximos años, a medida que el rendimiento de los chips en el borde siga aumentando y los costes de inferencia en la nube sigan bajando, la línea divisoria seguirá moviéndose, pero es probable que el marco de "dividir por tarea" sobreviva a cualquier recomendación de despliegue específica.
¿Terminará el despliegue de la IA en el almacén adoptando por defecto el borde, con la nube como excepción, o al revés? Eso depende de qué crezca más rápido en el próximo ciclo —el volumen de tareas en tiempo real o la demanda de coordinación entre almacenes— y la respuesta probablemente solo se aclarará después de la próxima oleada de modernizaciones a gran escala.
Por Dr. Chen, Investigador de la cadena de suministro
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.