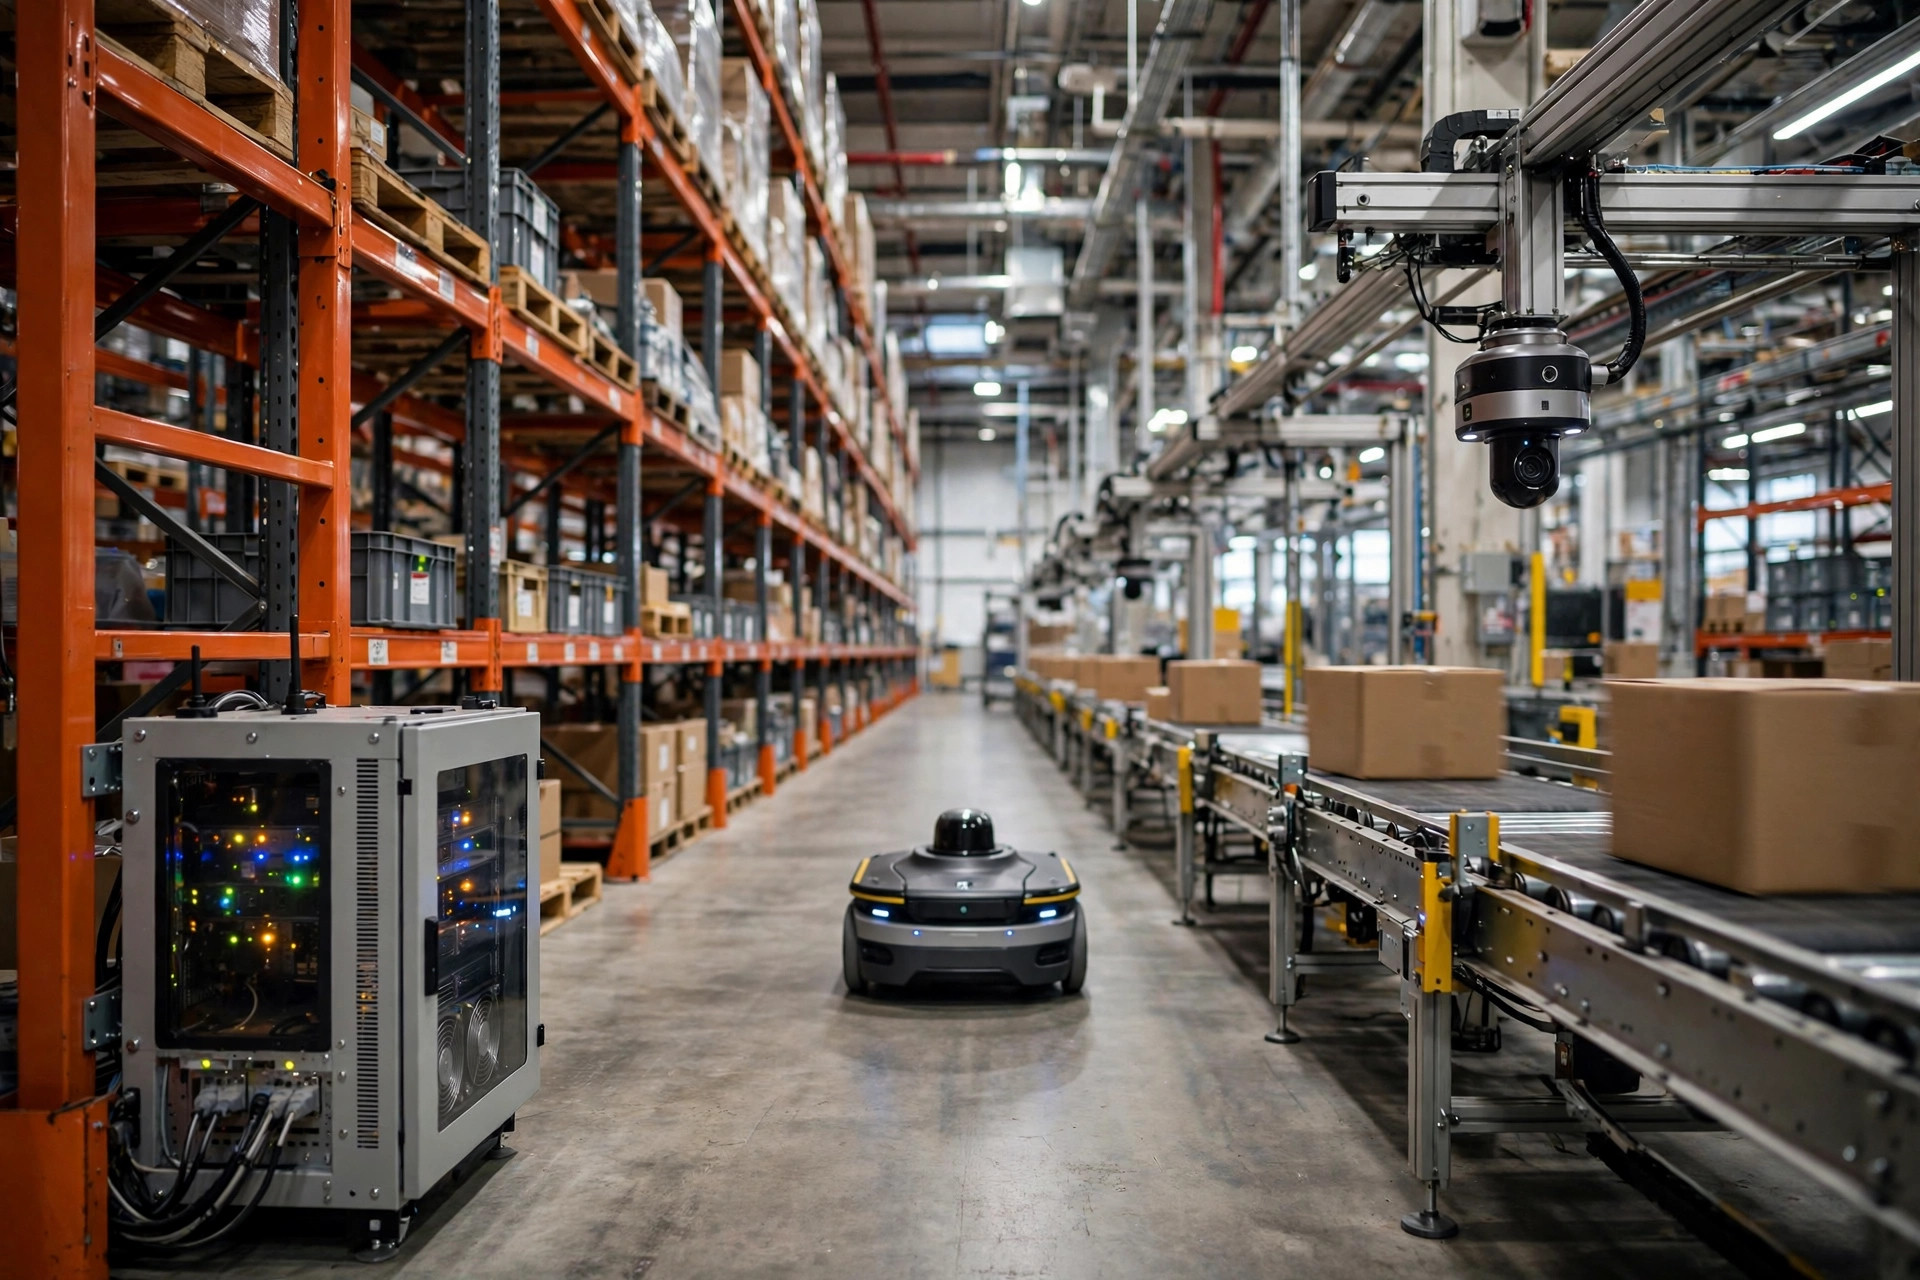
El año pasado visité un almacén de comercio electrónico en Riverside que acababa de instalar un sistema de inspección por visión: seis cámaras sobre la cinta transportadora, revisando las etiquetas de los paquetes por daños y mala aplicación. El sistema ejecutaba la inferencia en la nube: los flujos de video se enviaban a una nube pública, se procesaban en GPU y los resultados volvían. En la primera semana de operación, falló: en las horas pico los resultados llegaban medio tiempo tarde, los cilindros neumáticos de rechazo nunca recibieron la señal y una docena de paquetes problemáticos fueron directo a las rampas de clasificación. El gerente de TI me dijo: «Nadie mencionó la latencia antes de firmar el contrato».
Mi veredicto, de entrada: para la IA en un almacén, la diferencia entre 10 ms y 300 ms no es un problema de experiencia de usuario, es un problema de si puede funcionar o no. Dónde despliegas la inferencia decide si tu IA es un activo de producción o un adorno caro.
Las cuentas de la latencia
La cámara captura un cuadro, lo envía a la nube, se ejecuta la inferencia, el resultado vuelve: típicamente 100–300 ms de ida y vuelta, y eso en un buen día. Ya sabes cómo son las redes de un almacén: las estanterías metálicas son un bloqueador natural de señal, las zonas muertas de Wi-Fi están por todas partes y la congestión de temporada alta puede duplicar la latencia.
¿Despliegue en edge? Un dispositivo edge robusto con cómputo GPU instalado en un gabinete junto a la línea ejecuta la inferencia en 10–50 ms. De la cámara al dispositivo por la red local, a veces con conexión directa.
Tres reglas duras para cuándo el edge es obligatorio:
Primero, control de lazo cerrado. Rechazo, clasificación, evasión de obstáculos de los AMR: todo aquello donde «la IA termina y la máquina debe moverse ahora mismo». A una velocidad de cinta de 2 m/s, 300 ms de latencia significan que el paquete ya avanzó otros 0.6 m. Te perdiste el punto de desvío.
Segundo, todo lo relacionado con la seguridad. En zonas mixtas de peatones y vehículos, pasar la evasión de obstáculos por visión de los AMR por la nube es poner tus frenos en manos del jitter de la red. Mi veredicto: edge, sin discusión.
Tercero, inferencia de alta frecuencia. Una cámara a 30 fps, 16 horas al día: la facturación en la nube por llamada API o por hora de GPU se pone fea rápido. Un dispositivo edge es una inversión única que sale más barata por inferencia cuanto más lo usas.
¿Para qué sirve realmente la nube? Entrenamiento, iteración de modelos, tableros, analítica entre instalaciones. Trabajos sin presión de tiempo que necesitan cómputo elástico. Ese es el terreno de la nube.
Ancho de banda y dinero: las líneas olvidadas
La mayoría calcula la línea de GPU y olvida el ancho de banda. Una cámara 1080p con codificación H.264 empuja unos 4–8 Mbps de subida. Cincuenta cámaras: 200–400 Mbps de subida sostenida. Ya sabes lo que cuesta al mes una línea dedicada para el almacén. Peor aún es la fiabilidad: una caída del enlace y la inferencia de todas las cámaras cae al mismo tiempo.
Las necesidades de ancho de banda del edge son casi cero: el video nunca sale del edificio, solo suben los resultados de inferencia (unos KB de JSON) y las instantáneas de alerta. Si se cae internet, la línea sigue funcionando; en el peor de los casos, las alertas llegan tarde.
Así desgloso yo el dinero. La nube es pago por uso, buena para cargas pequeñas o irregulares; el edge es inversión fija más depreciación, bueno para operación continua 24/7. La línea divisoria es fácil de calcular: lista tu factura anual de inferencia en la nube (GPU + ancho de banda + transferencia de datos) y compárala con la compra de dispositivos edge, depreciación a tres años, energía y mantenimiento. Mi regla práctica: con más de 20 flujos de cámara en inferencia continua, el edge casi siempre gana. Con menos de 10 flujos y bajo ciclo de uso (unas pocas horas de control de calidad al día), la nube es la opción sin complicaciones.
Una trampa: los proveedores de nube tienen más líneas de facturación de las que esperas: horas de GPU, almacenamiento, llamadas API, salida de datos. Consigue cotizaciones por escrito de las cuatro antes de firmar. Si algo no está claro, que te lo confirmen por escrito por correo. No confíes en el «más o menos» del vendedor.
Mi guía de despliegue: tres niveles
No apliques la misma receta a todo. Yo divido los despliegues en tres niveles:
Nivel uno, edge puro: clasificación por visión, rechazo, navegación y evasión de obstáculos de AMR, verificación en tiempo real para pick-to-light. Estos reciben dispositivos edge que siguen funcionando si la red muere. Sobre el hardware: cuidado con el calor y el polvo: los almacenes superan rutinariamente los 35°C en verano y las GPU de consumo no sobreviven. Ve por grado industrial o al menos con rango de temperatura amplio.
Nivel dos, inferencia en edge más entrenamiento en nube: este es el patrón dominante. El edge ejecuta la inferencia; las muestras difíciles se devuelven a la nube; la nube reentrena y distribuye los modelos actualizados. Sobre la estrategia de subida: nunca subas todo. Envía solo las muestras en las que el modelo dudó (baja confianza) y reduces el ancho de banda en más del 90%.
Nivel tres, nube pura: pronóstico de demanda, sugerencias de reposición, tableros de operaciones, reportes entre almacenes. Sin requisito de tiempo real, y el cómputo elástico de la nube más sus herramientas de datos listas para usar son ventajas genuinas.
Un detalle operativo: cuando tienes más de un puñado de dispositivos edge, la gestión de versiones de modelos se vuelve un lío. Exige actualizaciones OTA remotas y reversión. No mandes ingenieros por ahí con memorias USB. Vi un almacén con 12 dispositivos edge ejecutando 4 versiones distintas de modelo; la resolución de problemas tomó una semana.
Secuencia de despliegue: no cubras todo el edificio el primer día
El mayor error que veo en los despliegues primerizos de visión por IA es apostar todo a la instalación completa. Mi despliegue en tres pasos:
Paso uno, piloto en un solo punto. Elige tu línea más dolorosa: control de calidad de devoluciones o inspección de etiquetas, con solo 2–4 cámaras y un dispositivo edge. Ejecuta el piloto 4–6 semanas. El objetivo aún no es ahorrar dinero; es producir tres tablas: latencia, precisión y tasa de falsos positivos. Si los falsos positivos superan el 5%, el personal de piso empieza a ignorar las alertas: vigila ese número como un halcón.
Paso dos, cierra el ciclo de iteración del modelo. Cuando el piloto esté estable, conecta el pipeline de subida de inferencia en edge más entrenamiento en nube. Sobre el trabajo de etiquetado: las muestras difíciles pueden llegar a cientos por día, y alguien tiene que etiquetarlas. Mi enfoque es que el personal de control de calidad etiquete sobre la marcha: el sistema envía las instantáneas de baja confianza a una tableta, la persona de control de calidad toca «correcto/incorrecto» y el etiquetado no cuesta esencialmente nada.
Paso tres, replica. Expándete a otras líneas solo cuando la precisión esté estable por encima del 98% y los falsos positivos por debajo del 3%. Para entonces estarás comprando dispositivos edge al por mayor, lo que típicamente recorta otro 15–20% del costo unitario.
Una nota práctica más: modernizar la red en edificios viejos. El edge perdona las redes, no las elimina: lleva conexiones cableadas de las cámaras al dispositivo edge; no escatimes en Wi-Fi para todo. Unos pocos miles de dólares en cableado por línea no son nada frente a un año de ancho de banda en la nube.
Una acción que puedes tomar mañana: lista cada escenario de IA que esté corriendo (o planeado) en tu almacén y califica cada uno en tres columnas: requisito de latencia, frecuencia de inferencia, número de cámaras. Todo lo que necesite <100 ms va al edge. Baja frecuencia y pocas cámaras van a la nube. El punto intermedio recibe el híbrido: inferencia en edge más entrenamiento en nube. Una vez hecha esa tabla, ningún proveedor puede enredarte con la arquitectura.
¿Tu IA de almacén corre en el edge o en la nube? ¿Alguna vez te quemó la latencia? Cuéntame en los comentarios.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.