多模态 AI 第一次在仓库里真正派上用场,往往不是在发布会上,而是在一次普通的破损上报里。2025 年秋天,华东某 3PL 仓的夜班,操作员在分拣线上发现一只压变形的纸箱,举起手持终端拍了一张照片,随口说了一句"三号线,外箱压瘪,里面是玻璃器皿,疑似漏液"。几秒钟后,系统把照片、语音和这票订单的文字信息拼在一起,给出判断:建议隔离、拍照留证、通知客服先行联系客户。过去,这三件事分属三个系统,靠人来回切换;现在,一个模型把它们对到了一起。
仓库的问题从来不是缺数据,而是缺"对得上"
一个中等规模的仓库每天产生的数据并不少:摄像头录像、手持终端的扫描记录、语音拣选的通话、WMS 里的订单与库存、邮件与工单里的文字。问题在于,这些数据各说各话。摄像头看见一只箱子倒了,不知道它属于哪票订单;语音系统听见操作员报了异常,不知道异常长什么样;WMS 知道订单延迟了,不知道延迟发生在哪个环节。
根据 OpenAI 在 2024 年 5 月发布 GPT-4o 时的公开说明,这类模型的设计目标就是把文本、图像与音频放进同一个模型处理,而不是用三个模型分别处理再拼接结果。这个思路被搬进仓库,意义不在于技术本身更时髦,而在于仓库的业务恰好就是多通道的:眼睛看、嘴巴说、系统记,缺了任何一环,判断都会走样。
多模态 AI 在仓库里到底融合了什么
这种融合发生在三个层面。第一个层面是对齐:同一事件在不同通道里留下痕迹,模型要先认出它们属于同一件事。照片里的破损纸箱、语音里的"三号线"、订单里的库位编号,三者指向同一个库位、同一时刻,才有融合的前提。
第二个层面是互补:一个通道说不清的地方,由另一个通道补上。照片能证明破损程度,语音能补充照片拍不到的上下文,比如"里面是玻璃器皿";文字能提供照片和语音都没有的订单背景,比如这个客户是否接受换货。三个通道各自的短板,正好被另外两个通道盖住。
第三个层面是冲突处理:通道之间说法不一致时,模型要判断信谁。语音说"外箱完好",照片却显示箱角塌陷,模型需要按证据强度排序,而不是简单少数服从多数。仓库里真正有价值的融合系统,能力高下往往体现在第三个层面,而不是第一个。
多模态 AI 在仓库里的三类场景
第一类是拍照加语音报损。操作员在现场拍一张照片,口头说明情况,模型结合照片与语音,输出异常类型、严重程度与建议处置。它的价值不在识别本身,而在把"发现异常"和"记录异常"合并成一个动作。过去操作员要先拍照、再回工位填单、再打电话通知;现在现场一次完成,异常记录里自带照片与语音原文,事后追溯不需要再找人回忆。
第二类是视觉复核加文字指令。打包台的摄像头拍下封箱前的包裹内容,模型对照订单的文字明细核对:数量、SKU、赠品是否齐全。某汽车零部件仓在打包环节试点这类复核,复核员从逐单盯屏幕,变成只处理模型挑出来的可疑单。这类场景里模型的作用是筛查,不是终审;最终放行的责任仍然在人,系统只负责把人的注意力集中到最值得看的少数单据上。
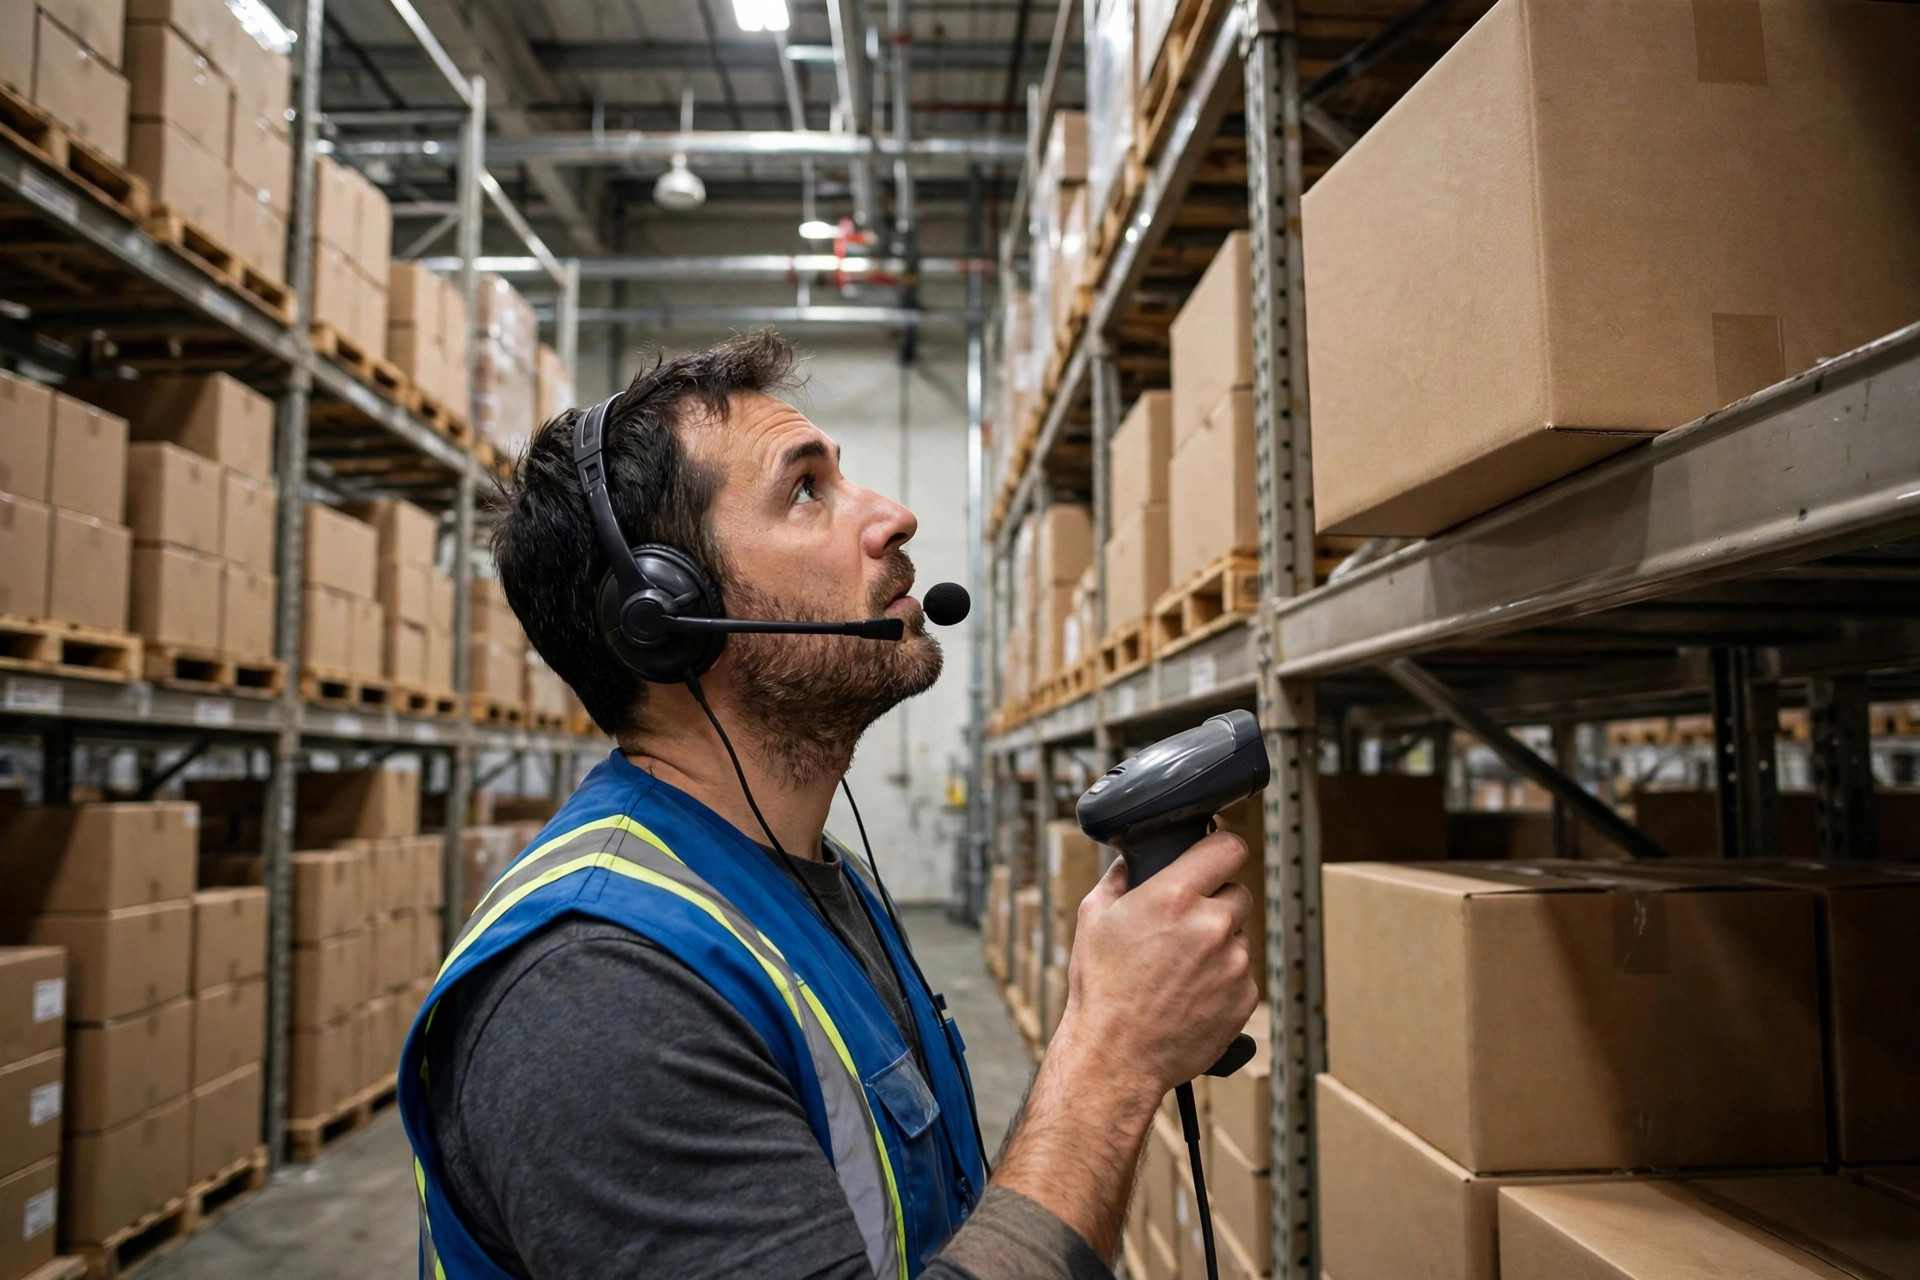
第三类是语音盘点加图像确认。盘点员戴着耳机报数,摄像头同时拍下货架现状,模型把语音里的数量与图像里的货位状态对上,发现不一致就当场提示复核。传统盘点的问题是"报了数、错了也不知道",复盘要等到差异报表出来;这种盘点把复核提前到报数的那一刻,错误在现场就被拦下,而不是在报表里才被发现。
单模态与多模态的对照
| 对比维度 | 单模态系统 | 多模态 AI |
|---|---|---|
| 输入 | 只处理一种信号,如图像或语音 | 同时处理图像、语音与文字 |
| 异常判断依据 | 单一证据,容易误判 | 多通道证据交叉验证 |
| 上下文 | 只有本通道内的信息 | 叠加订单、库位与历史记录 |
| 冲突处理 | 无法察觉其他通道的矛盾 | 能识别并排序矛盾证据 |
| 人工衔接 | 异常要在多个系统间手动流转 | 现场一次完成记录与通知 |
| 适用环节 | 固定、重复的单一任务 | 需要综合判断的异常与复核场景 |
这张表说明一个基本判断:它的优势不在单项指标上碾压单模态系统,而在需要综合判断的环节减少人工衔接。
多模态 AI 的准确率、误报与延迟
它落地有三个硬约束,任何一个不达标,系统就只能停留在试点。
第一个是误报。视觉复核把合格的包裹反复挑出来,复核员很快就不再信任系统,开始批量放行,系统等于白装。误报率的容忍度取决于环节:发错货的代价高的环节,宁可漏报也不能多报;破损上报这类环节,误报的代价只是多看一眼,可以放宽一些。部署之前,先问清楚这个环节的误报成本,再定阈值,而不是追求一个漂亮的准确率数字。
第二个是延迟。语音盘点要求模型在操作员报完数的短时间内给出反馈,拖得太久,操作员已经走到下一个库位,现场复核的意义就没了。
第三个是算力成本。这类模型的推理成本高于单模态,尤其在视频流持续输入的情况下。ROI 的算法里,算力是不能忽略的一项。
为什么瓶颈不在模型,在仓库
一个反常识的判断是:制约它进仓库的主要因素,已经不是模型能力,而是仓库自身的数据基础。模型需要大量带标注的仓库场景数据做适配:什么样的破损算严重,什么样的混装算异常,这些判断标准每个仓库都不一样,没有现成的公开数据集可以直接套用。标注这件事本身就需要老师傅参与,而老师傅的时间恰恰是最贵的。
再看摄像头与语音设备的部署密度。很多仓库的摄像头装在通道上方,拍的是全景,不是货位特写;语音设备只在拣选环节配了,盘点环节没有。模型再强,也看不见没拍到的画面,听不见没录到的声音。
还有一个容易被忽视的约束是隐私与合规。摄像头与语音同时采集,意味着员工的面部与声音也被持续记录。不同地区的法规要求不同,员工告知、数据保存期限、访问权限都需要提前安排。技术团队如果只谈模型、不谈这些,项目很容易在法务与员工关系这一关被搁置。
趋势判断:它会先在三个地方规模化
根据目前的落地节奏,我的判断是,它在仓库的规模化会分三步走。第一步是异常处理:破损、混装、空库位这类有明确触发事件的环节,因为投入产出最容易算清楚,试点周期最短。第二步是复核环节:打包复核、装车复核这类"看一眼就能省一次客诉"的场景,模型做筛查、人做终审的分工模式最容易被接受。第三步才是全流程的实时理解,比如用多模态模型持续监控整个仓库的运转状态,这一步对算力、数据与组织流程的要求都更高,时间表也最不确定。
需要说明的是,这个判断建立在一个前提上:模型厂商继续把多模态能力当作通用能力提供,而不是做成昂贵的定制项目。如果未来推理成本降不下来,时间表就要往后推。
它改变的不是仓库的某一个环节,而是仓库"看懂"自身运转的方式。摄像头、语音与文字第一次被放进同一个判断框架,仓库从"记录发生了什么"走向"理解正在发生什么"。至于理解之后,决策权交给模型还是留在人手里,这个问题,技术给不出答案,只能由每一个仓库自己回答。
作者:陈博士|供应链行业研究员