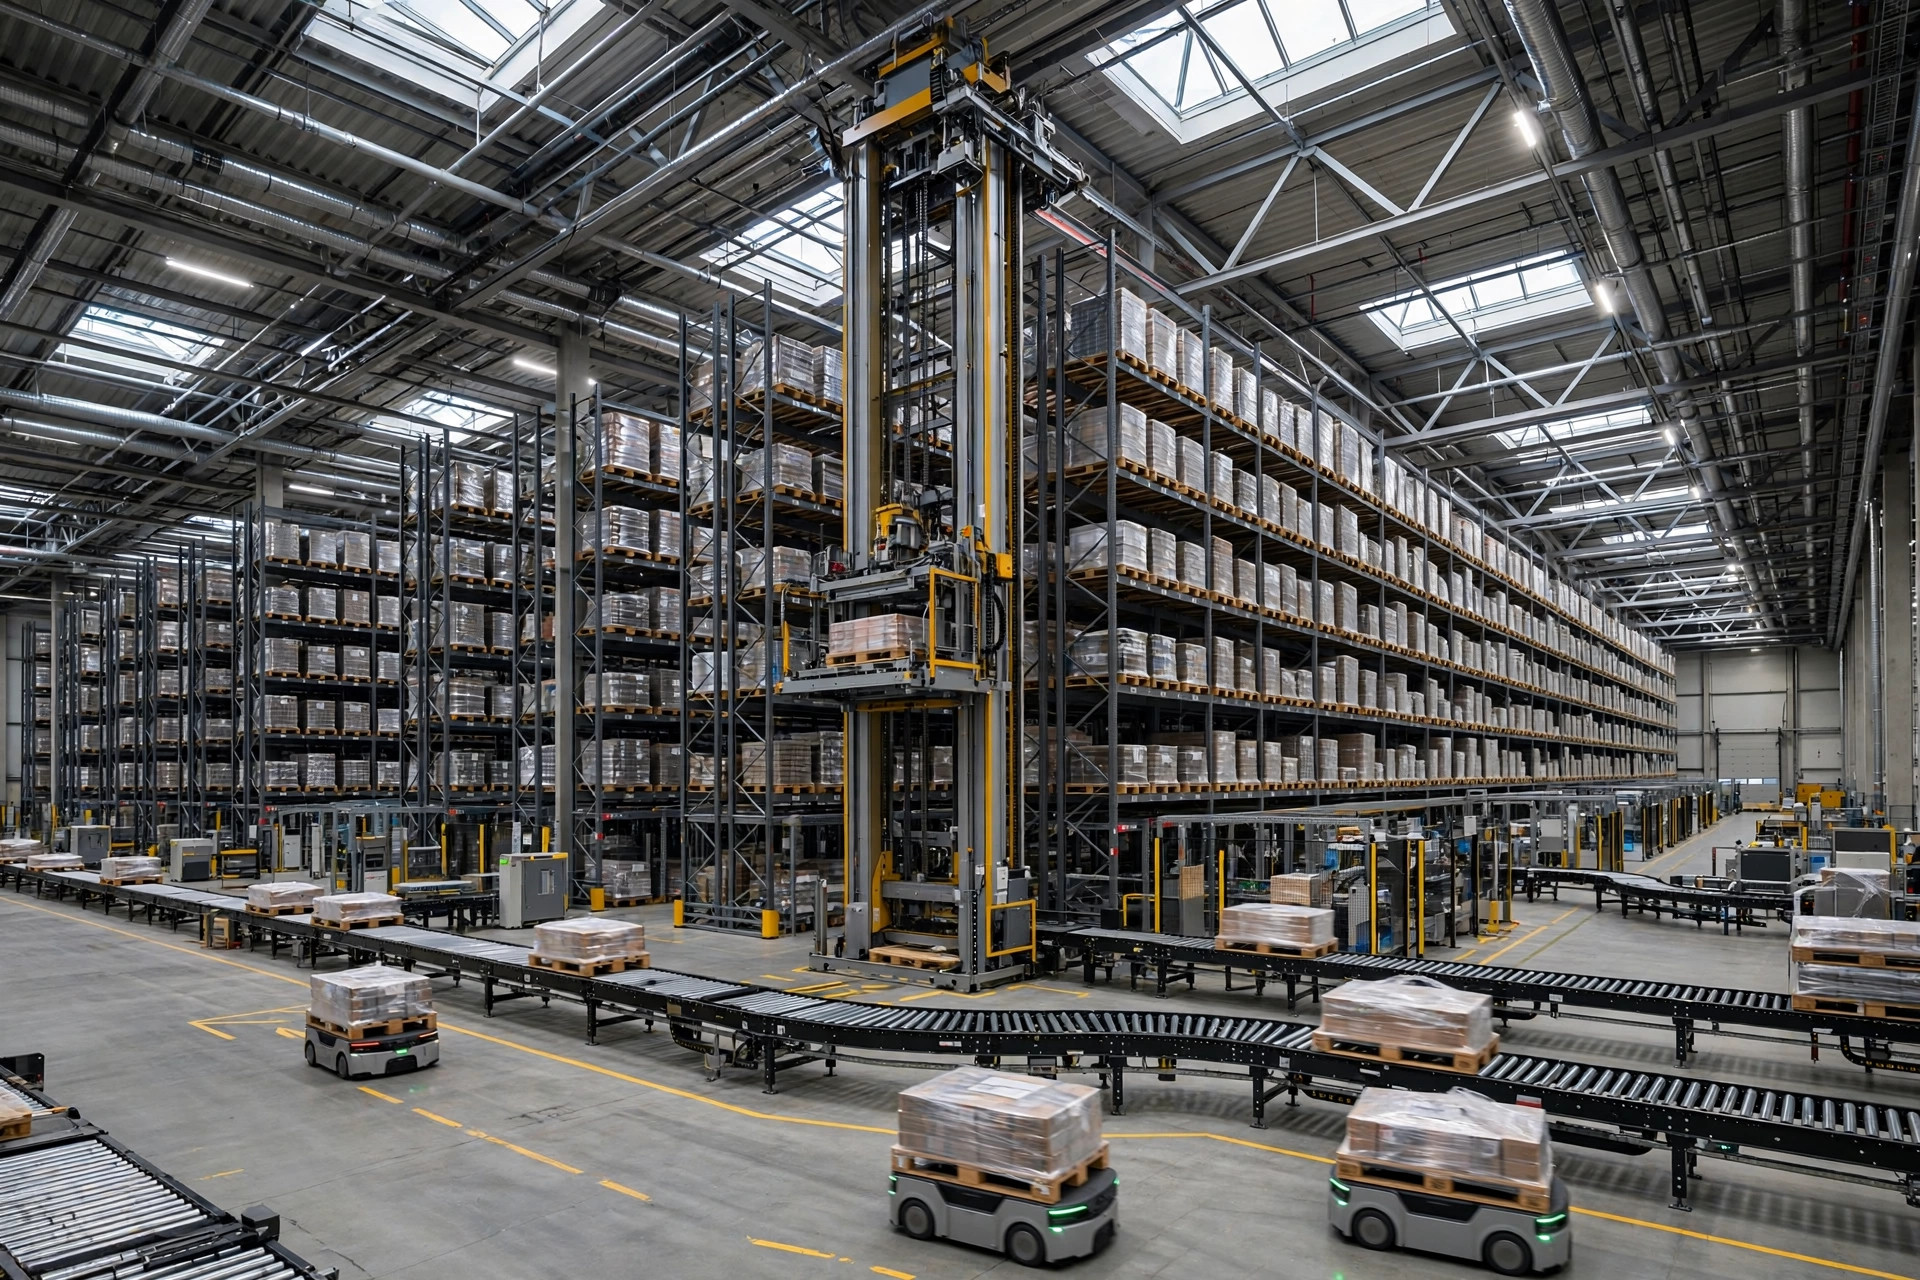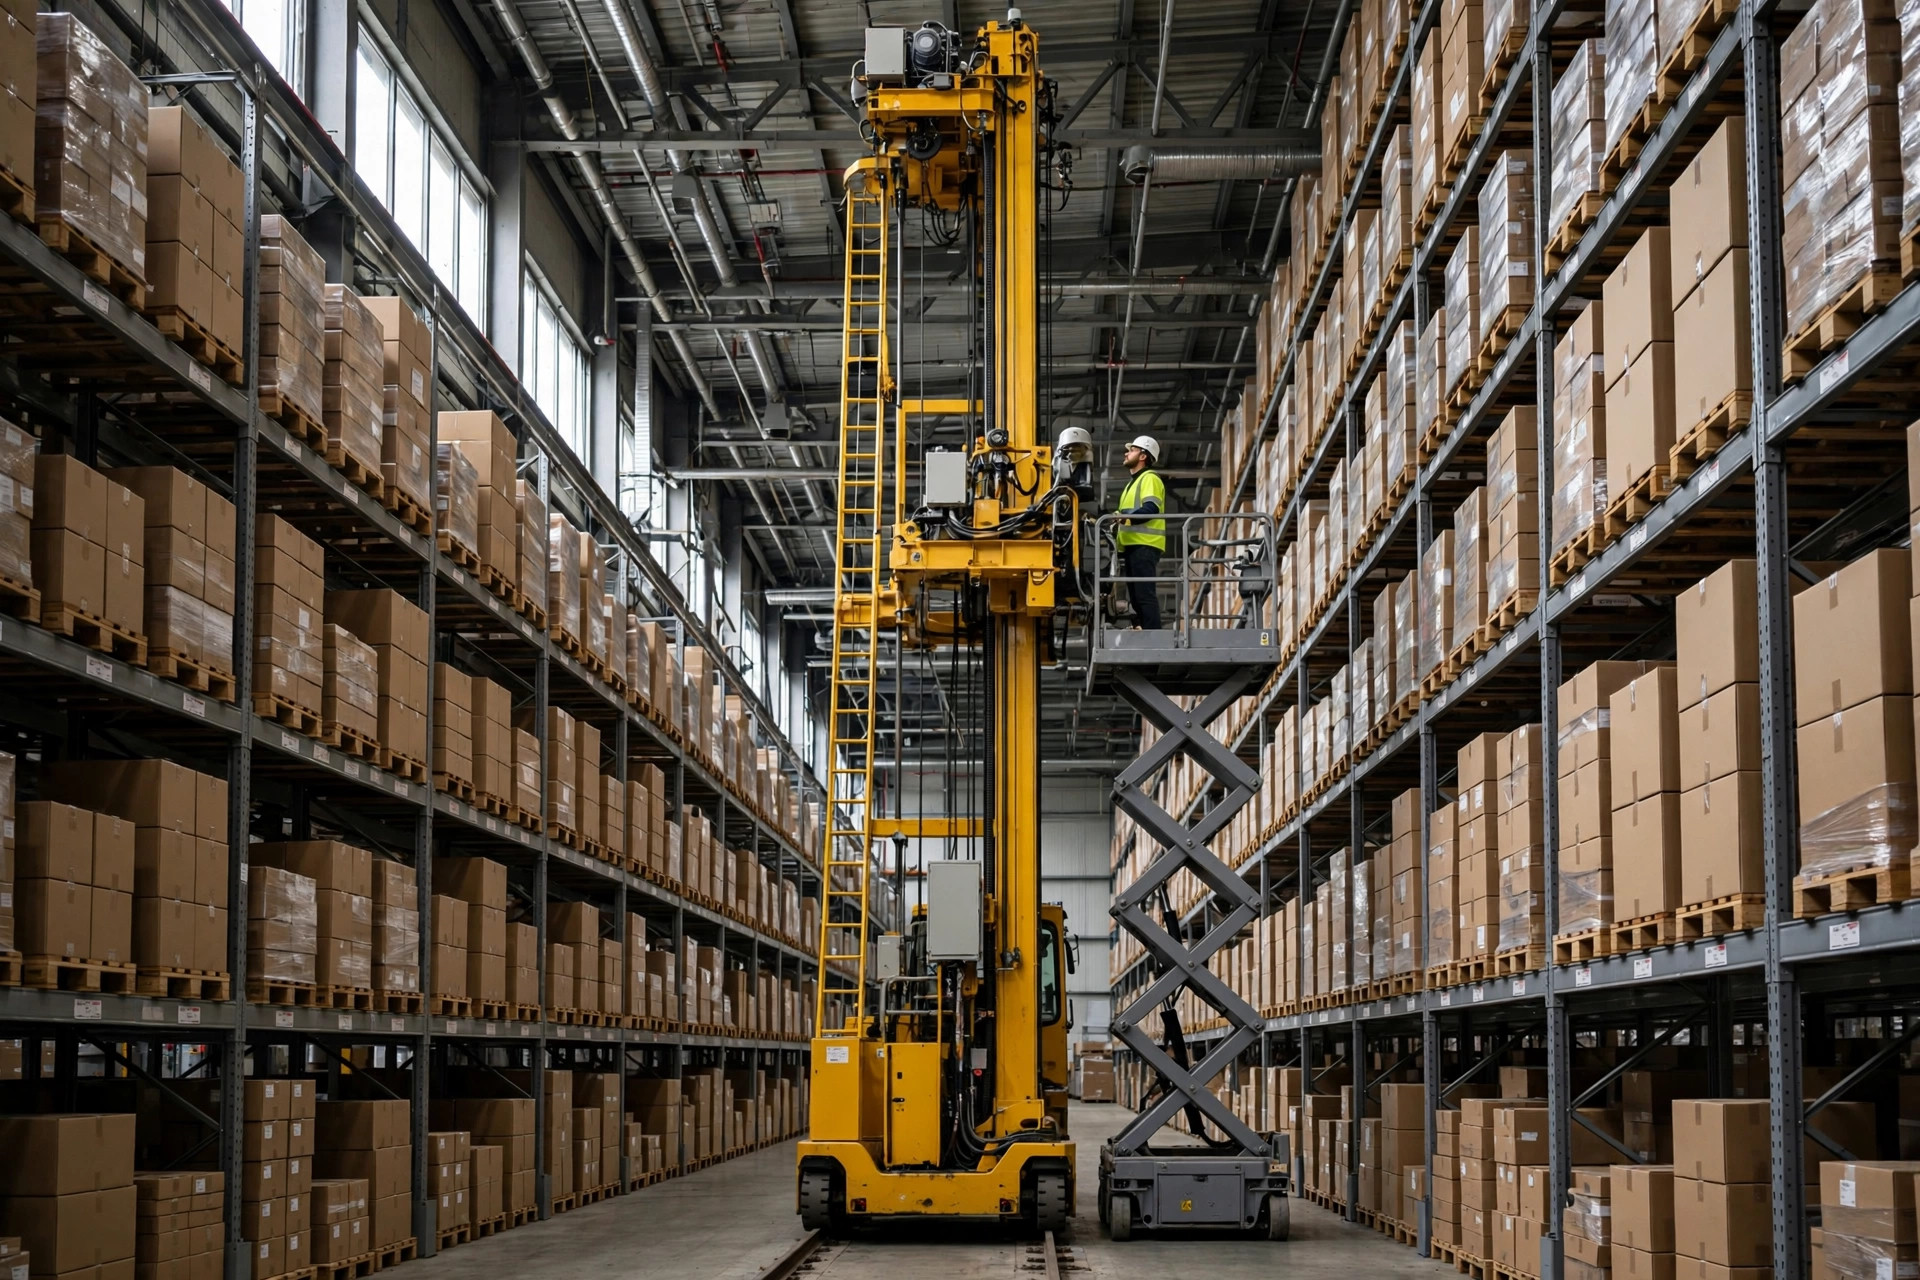
立库维保这事,行业里有个流传很广的说法:"立库一停,全仓瘫痪,所以维保窗口只能在春节。"听到这话我就想开炮——2023年我去一家华东的汽车零部件立库做维保审计,他们8条巷道,每月固定轮检一条,全年没停过一天机,Uptime跑到99.6%。另一家华北的冷链立库,4台堆垛机单线作战,2021年冬天轨道沉降,修了整整4天,出库全靠叉车+人工硬扛,效率掉到平时的三成不到。同一套"立库维保",两家完全是两个世界。差别不在运气,在设计之初有没有给维保留"不停机"的余地,以及窗口到底怎么排。
这篇文章就讲透三件事:不停机检修的原理是什么;什么时候值得为"不停机"多花钱;以及维保最容易踩的三个坑。先上结论:不停机维保不是不维保,而是把一次大停机拆成无数个小碎片,塞进生产的间隙里。
不停机维保的原理:把立库切成独立的"作战单元"
先讲原理。你可以理解为,立库这套系统本质上是一组"巷道+输送线+控制"的并联体。并联系统的好处是:只要控制系统(WCS)能按区域隔离,任何一个巷道停下来做维保,其他巷道照样跑,整库只是降级运行,而不是全停。
实现这个目标,行业里有三种成熟手段。
第一种,巷道级冗余。 最简单粗暴:8条巷道按7条的产能规划,永远留一条做"维保机动"。双伸位堆垛机(double-deep)本身就是一种冗余思路——一台堆垛机服务两排货位,少一台,邻道还能顶一部分。行业里托盘堆垛机的常见量级是:水平运行120-180米/分钟,起升30-60米/分钟,货叉伸缩20-30米/分钟,单台双循环大约30-40托/小时。8条巷道全开,出库能力在240-320托/小时这个量级。轮检时关一条,产能掉12.5%,白天订单高峰前把优先级SKU提前倒腾到其他巷道,基本无感。
第二种,输送线旁路。 很多仓只盯着堆垛机,却忘了前端输送线和提升机才是单点故障的重灾区。成熟的做法是在主线旁并一条bypass回路,或者在立库出库口做双路分流。一条线停下来清堵、换滚筒,托盘自动切到旁路。这就像城市修路要留一条便道,道理一模一样。
第三种,控制分区。 WCS按巷道/区域做逻辑分区,维保模式一键切换:目标巷道进入"维护锁定",任务自动重分配到其他巷道,AGV和输送线不再往该区域送料。没有这个功能,维保就得靠人工逐台屏蔽任务,又慢又容易漏——我见过一家仓,维保时WCS没做分区,技术员在巷道里换货叉链条,调度员手一滑又派了个任务进来,堆垛机直接启动,差点出大事。安全这事,靠流程不如靠系统锁死。
原理总结一句话:不停机检修 = 冗余硬件 + 旁路通道 + 分区控制,三者缺一不可。 少了任何一个,"不停机"都只是PPT上的口号。
维保窗口的排期框架:四象限法
原理有了,窗口怎么排?这是我最常被问到的问题。给你一个我用了多年的四象限框架:横轴是设备分级(A类关键/B类重要/C类一般),纵轴是作业强度窗口(高峰/平峰/低谷)。
排期铁律只有三条:A类设备只进低谷窗口;B类设备进平峰窗口;C类设备随到随修,不占用窗口。 堆垛机本体、提升机、主输送线是A类;滑触线碳刷、轨道巡检、传感器清洁是B类;照明、标识、安全门开关是C类。
具体排法分三步。第一步,画出你家仓的作业强度曲线——出库托数按小时统计,连续看两周,低谷时段自然就出来了。大多数仓的低谷在凌晨1点到5点,或者周日全天。第二步,把A类设备的维保任务拆成"巷道级小包":比如8条巷道,每月轮检2条,每条占用一个低谷窗口4小时,全年覆盖。第三步,WCS里预置"维保模式"任务模板,窗口一到,一键切换,任务自动重分配,维保完一键恢复。
说两个真实案例。2022年,苏州一家汽车零部件立库,8巷道双伸位堆垛机,日均出库约4000托。他们的做法是:每月第一周和第三周的周三凌晨1-5点,固定轮检一条巷道,WCS提前2小时把该巷道的高周转SKU任务排空。检修内容标准化:轨道紧固件扭矩抽查、滑触线碳刷磨损测量、货叉链条张紧度、编码器读数校验。一年下来,计划性维保占用了约100个小时,但没有一小时落在生产时段,全年Uptime 99.6%。代价是维保团队要上夜班,人力成本比白天高30%左右——这笔账后面算。
反例。2021年冬天,天津一家冷链食品立库,-25℃环境,4台堆垛机单线布置,没有巷道冗余。12月的一次例行巡检发现其中一条轨道有沉降迹象(地坪冻胀),必须停机校调。没有冗余,停机就是全停。4天时间里,出库全靠叉车进库人工拣选,-25℃的库里人待不了20分钟就要出来暖一轮,效率只有平时的三成不到, downstream的门店配送直接断档。这次事故之后,他们才在二期扩建时加了两条巷道做冗余——冗余这东西,建的时候嫌贵,出事之后嫌晚。
选型分界线:什么时候值得为"不停机"多花钱
这是全文最关键的一节,因为"不停机维保"本质上是个花钱买时间的问题。直接上对比表:
| 对比项 | 计划性停机维保 | 不停机维保(冗余+错峰) |
|---|---|---|
| 一次性投入 | 基准(无冗余) | 多1-2条巷道或旁路输送线,增量投入约整套设备的15-25% |
| 年维保工时 | 约200-300小时,集中在节假日 | 约400-600小时,拆成碎片分布在全年 |
| 单次停机时长 | 8-24小时/次 | 0(生产时段零停机) |
| 恢复爬坡 | 每次大修后1-2天产能打折 | 无 |
| 适用场景 | 单班制、有自然长假的仓 | 7×24或旺季不能停的仓 |
看到没有?不停机维保的维保工时其实是停机维保的2-3倍——这就是我要讲的第一个反常识判断。很多人以为"不停机"等于"省事",恰恰相反,它是把一次性的大手术拆成全年无休的小针灸,总工作量更大。它的价值不在于省维保的钱,而在于不丢生产的钱。
第二个反常识,顺带开个炮:对90%的仓来说,Uptime 99.9%是个伪需求。 99.5%和99.9%,一年差35个小时的停机预算,但为了这35个小时,你可能要多投一条巷道、配双套控制系统,多花几百万。集成商最爱拿"零停机""99.99%"当溢价卖点,签合同前先算一笔账:你家仓停机1小时到底损失多少?出库延误的违约金、人工应急成本、订单流失,加起来有没有超过冗余投入的年化成本?没有的话,老老实实做计划性停机维保,把窗口排好,一样过得很好。为用不上的指标付费,是自动化选型里最贵的智商税。
再开一炮,关于"智能维保平台"。现在有些厂商推销"预测性维护平台",传感器+算法告诉你哪个轴承还有2000小时寿命。听起来很美,但我问过三家上了这平台的仓同一个问题:备件囤了吗?两家摇头。平台告诉你轴承要坏了,备件采购周期6周,有什么用?预测性维护的前提是备件体系和响应流程,软件只是最后一公里。 关键备件(电机、编码器、货叉链条、滑触线碳刷)必须现场有库存,MTBF数据以设备厂商手册为准,备件清单按手册的推荐清单打八折囤——这才是预测性维护的地基。地基没有,上层全是空中楼阁。
维护的三个坑:都是拿真金白银踩出来的
原理和选型讲完了,最后讲维护实操的三个坑,个个都是我亲眼见过的。
坑一:只保养堆垛机本体,不管"路"和"电"。 堆垛机是个精密设备,但它跑在轨道上、吃滑触线的电。轨道紧固件松动、地坪沉降、滑触线碳刷磨没了——这三样出问题的概率比堆垛机本体高得多。尤其是滑触线,碳刷属于耗材,高强度工况下1-2年就得换一批。很多仓的维保清单里只有"堆垛机检查",没有"轨道+滑触线"专项,等于只给汽车换机油不看轮胎。维保清单必须按"机-路-电"三条线分别列项,缺一条都是半套维保。
坑二:维保窗口只排巷道,不排输送线和提升机。 巷道轮检做得很漂亮,结果前端输送线堵了、提升机钢丝绳到了更换周期没人管——巷道活着,货进不来出不去,等于白干。维保窗口排期必须覆盖"巷道+输送+提升+控制"全链路,做一张全系统维保日历,A类设备错开窗口,绝不能出现"巷道在检修、输送线也在同一天大修"的撞车。
坑三:维保记录不进系统,靠老师傅的脑子。 这是最隐蔽的坑。很多仓的维保就是老师傅拿个本子记,换了什么件、什么参数,人一走全没了。正规做法:每次维保的测量数据(轨道水平度、碳刷剩余厚度、链条张紧度、电机电流)全部录入系统,形成趋势曲线。轴承电流逐月爬升5%,就是给你发预警——这比任何"智能平台"都实在,因为数据是你自己的。
最后回到开头那个问题:这钱花得值不值?看这一个数——
冗余投入回收期 = 冗余增量投入 ÷(年计划停机小时 × 单小时停机损失)
分子是多花的钱,分母是每年省下来的停机损失。算出来小于3年,闭眼投;3到5年,看旺季风险偏好;大于5年,老老实实做计划性停机维保,把窗口排漂亮,一样是好汉。技术问题到最后都是算账问题,参数再漂亮,不如这一行公式实在。
作者:大刘|自动化设备工程师