2024 年初,加拿大一家航空公司的智能客服聊天机器人给一位旅客提供了错误的退票政策答复,旅客据此索赔,仲裁庭最终判航空公司担责——理由很简单:机器人是你们自己上线的,它的回答算你们公司的承诺。这个案子在客服行业传得很开,因为它第一次把「智能客服说错话,到底谁买单」这件事摆到了法律层面。
根据 Gartner 在 2022 年的预测,到 2027 年,约四分之一的企业会把聊天机器人作为主要客服渠道。与此同时,多家电商客服团队公开分享过一个高度相似的工单结构:售后咨询里,「我的货到哪了」(WISMO)这类订单状态查询,通常占到总工单的四成到六成——高度重复、答案高度标准化、高度依赖后台数据。IBM 在其客服 AI 白皮书中估算,引入对话式 AI 后,企业客服成本最高可下降三成左右。这些数字来自不同口径,不能直接加总,但它们指向同一个结论:售后咨询是智能客服 ROI 最容易算清楚的一块,也是 AI 在电商领域落地最扎实的一个场景。
智能客服为什么先拿售后咨询开刀
三个原因,层层递进。第一,工单高度集中:少数几类问题吃掉大半工作量,自动化覆盖的杠杆最大,一次投入撬动的工单量最多。第二,答案有「唯一数据源」:物流状态、退换政策、库存状态都存在系统里,不是开放式闲聊,模型不需要「编」,只需要「查」——这从根本上决定了幻觉风险可控。第三,边界可定义:什么能自动答、什么必须转人工,可以写成明确规则。恰恰是这第三点,是整个落地里最被低估的一环,也是区分「装了个机器人」和「真降了本」的分水岭。
WISMO 落地:技术路径与话术边界
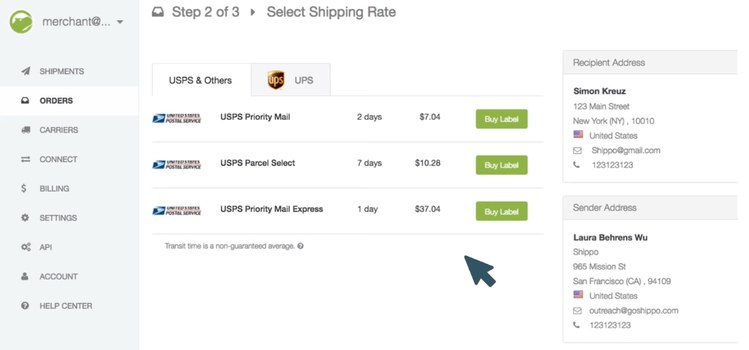
智能客服处理「我的货在哪」,本质是一条三段式流水线:第一步意图识别,判断这是不是查单查询,并提取订单号或手机号;第二步工具调用,依次调订单系统的订单状态接口、物流商的轨迹接口、仓库系统的出库状态;第三步按话术模板组织回答。
关键点在第二步:机器人不靠背知识,它靠调接口。这意味着落地难度不取决于模型多聪明,而取决于你的订单、物流、仓储三套系统有没有干净的 API、有没有统一的订单号。我见过不少项目翻车,翻的不是模型,而是物流轨迹接口返回「暂无数据」时,机器人该说什么——这是话术设计问题,不是 AI 问题。数据链路的完整度,决定了智能客服的天花板:出库信息在 WMS 里、轨迹在物流商手里、订单状态在 OMS 里,三方对不上,机器人就只能含糊其辞,而含糊其辞恰恰是售后场景里最伤信任的回答。
落地的核心设计,是把售后问题分成三个区:
绿区(可自动答复):物流查询、退换货政策复述、运费规则、尺码规格咨询——答案唯一、有数据源、有政策原文可引用。
黄区(自动答但人工复核):退款金额确认、破损理赔、地址修改——机器人可以预填信息、走审批流,但最终动作由人确认。
红区(必须转人工):投诉升级、欺诈嫌疑、法律相关、情绪激烈的客户——直接转人工,不许机器人「安抚」。
转人工的触发条件要写死:置信度低于阈值、同一问题问第二遍、客户明确说「转人工」、涉及金额超过设定线。这里有一个反常识的判断:智能客服项目最值钱的部分,往往不是机器人答对了多少题,而是它把「答不对的题」识别得多准、转接得多顺。自动回复率 90% 但转人工体验稀烂的项目,客户满意度掉得比没上机器人之前还快——因为客户被机器人绕了三圈才见到人,火气是翻倍的。
算一笔账:智能客服上线前后的成本对比
做一个带明确假设的示例测算(参数请按自家工单结构调整):假设一家日均 300 票售后工单的中型电商,WISMO 及政策类查询占 50%,单票人工处理成本按行业常见口径约 2~4 美元(含座席分摊),客服团队 8 人。
上线前,月工单约 9000 票,成本 = 座席薪资 + 管理 + 培训与人员流失。上线后,绿区工单(约 50%)按服务商披露的案例口径,自动解决率取 60%~80% 的中值 70%,即每月约 3150 票不再占用人工;黄区流程提效约 30%。
成本项则包括 SaaS 订阅或自建投入(模型调用 + 知识库搭建 + 接口开发),首年一次性投入加年费。回本测算上,节省的人力工时折算成「少招 2~3 个座席」,多数项目在 6~12 个月回本——这是按保守口径算的。这里要提醒一句:自动解决率的口径在各家服务商手里水分不小,签合同前一定要问清「自动解决」的定义:是「机器人给了回答」,还是「客户 48 小时内没再追问」?两种口径差出来的 ROI,可能差一倍。我访谈过的一家华南 3C 配件出海卖家就是个例子:2024 年旺季,他们的日均工单从平时的 400 涨到 1500,客服团队没加人,靠 WISMO 自动回复加夜间值班兜底扛了过去;旺季后复盘发现,自动解决的工单里有 7% 在 48 小时内又追问了——这个数字让他们把「自动解决」的统计口径从「给了回答」改成了「48 小时无追问」,ROI 测算一下掉了近四成。
幻觉风险、兜底机制与趋势判断
回到开头那个航空公司的案子。智能客服的幻觉风险有两类:一类是编政策(把退货期从 30 天说成 60 天),一类是编事实(把「已发货」说成「已签收」)。兜底机制有四件套:第一,知识库只引用带版本号的政策原文,回答附政策链接;第二,涉及金额、时效、责任的回答强制走「引用加人工确认」双保险;第三,所有自动答复留审计日志,定期抽检;第四,红线问题清单——列出机器人永远不许碰的话题,碰到直接转人工。
技术上,检索增强(RAG)能大幅降低编政策的概率,但它防不住数据源本身过期。所以知识库必须有明确的 owner 和更新 SLA:政策一变,知识库当天跟进。很多团队把知识库当成一次性工程,这是幻觉风险最大的来源——过期的正确答案,比编出来的错误答案更难被发现。
2026 年往后看,智能客服正在从「FAQ 机器人」进化到「能调工具的智能体」:查单、改地址、发起退款这些动作,机器人可以直接在系统里执行,而不是只给个链接让人自己去点。Gartner 的时间线(2027 年约四分之一企业以聊天机器人为主要渠道)放在这个背景下看,关键变量不是模型能力,而是企业敢不敢把「执行权限」交给机器人——这又回到了上面的边界问题:绿区可以放权,黄区必须留人。
我的判断是,未来两年的分水岭不在「谁的模型更聪明」,而在「谁的话术边界和兜底机制更扎实」。模型能力正在快速商品化,拉不开差距;真正拉开差距的,是把工单结构、数据接口、转人工流程啃下来的那家。
智能客服的账算得清、路径也清楚,真正的难题其实是组织层面的:客服团队愿不愿意把重复工作交出去,业务部门愿不愿意为机器人的回答背书。当回答出错时,是怪模型,还是怪当初拍板上线的人?这个问题,每个公司都得自己回答一遍。
作者:陈博士|供应链行业研究员