Comecemos pela conta.
Ensinar um robô de picking a reconhecer caixas de papelão leva cerca de 100,000 imagens de treinamento. Rotulá-las à mão, e as listas públicas de preços dos fornecedores colocam o simples desenho de caixas delimitadoras em $0.10–$0.50 por imagem: $10,000–$50,000 só pela primeira passada.
Três meses depois, o fornecedor de embalagem troca o papelão, a luz do inverno muda os reflexos, e o modelo deixa de reconhecer metade das caixas: mais 20,000 imagens, mais alguns milhares de dólares, sumidos.
Então este artigo não é sobre redes neurais. É sobre dinheiro: como os modelos de visão de IA de armazém são treinados, quanto custa cada rota, onde estão as armadilhas — e um problema de aritmética no qual você pode inserir suas próprias cotações.
Comecemos pela conta: como os modelos de visão de IA de armazém são treinados se resume a três rotas
Os dados de treinamento de modelos de visão têm exatamente três fontes: fotografados por humanos, desenhados por humanos ou gerados por máquinas.
Rota 1: fotos reais + rotulagem humana. Fotografe no chão do armazém, desenhe as caixas à mão — "isto é uma caixa de papelão, isto é um pallet, isto é um dano".
Rota 2: renderização por simulação CAD. Com desenhos CAD 3D precisos, solte peças virtuais num contêiner virtual, randomize iluminação, quantidade, texturas e ruído, e renderize centenas de imagens. Os rótulos se geram sozinhos — o motor sabe onde cada peça está; o tempo humano vai para ajustar parâmetros.
Rota 3: dados sintéticos por IA generativa. Sem necessidade de desenhos. A IA generativa "pinta" cenas de armazém anotadas diretamente — incluindo os estados feios: caixas amassadas, poeira, filme stretch. A tabela comparativa de custos está abaixo; uma rota de cada vez primeiro.
Rota 1: fotos reais + rotulagem humana — a mais burra, a mais cara, a mais honesta
A rota mais antiga, ainda a que a maioria dos projetos de visão de armazém segue. Sem mágica: fotografar, desenhar caixas, QA, treinar.
As contas, das listas públicas de preços dos fornecedores (Basic.ai): $0.03–$1.00 por caixa, $0.10–$0.50 por imagem para trabalho simples. Com 4 caixas por imagem e $0.30/imagem, 100,000 imagens = $30,000 — antes do QA, onde a revisão de dupla passagem é padrão e um multiplicador de custo total de 1.5–2x é normal.
Em 2024 precifiquei um de verdade: um site 3PL em Kunshan, robôs de picking, mais de 2,000 SKUs, 80,000 imagens capturadas. Cotação do fornecedor: $0.08 por caixa, 4 caixas por imagem — 80,000 × 4 × 0.08 = $25,600 no papel. Com gestão de projeto e cerca de 15% de retrabalho, a conta real passou de $30,000.
Seis meses após a entrada em operação, o fornecedor de papelão trocou de kraft para papel branco revestido. A refletividade mudou; o reconhecimento caiu 6 pontos. Mais 20,000 imagens — quase $10,000 a mais.
A verdade sobre a Rota 1: dados reais não são uma compra única, são uma assinatura. Cada mudança de embalagem, iluminação ou estação pode disparar outra rodada de rotulagem. Você não assina um contrato; assina uma conta recorrente.
Sua virtude também é real: a fidelidade. Modelos treinados com dados reais têm a menor lacuna sim-to-real — o ambiente de treinamento e o de implantação são o mesmo lugar.
Rota 2: renderização por simulação CAD — a mais barata quando você tem os desenhos
Com modelos CAD 3D precisos, a vida fica simples: uma ferramenta de simulação solta peças virtuais num contêiner virtual, varia quantidade, iluminação, texturas e ruído de câmera, e renderiza centenas de imagens. A anotação é gratuita — o motor sabe onde cada peça está.
Uma matéria de maio de 2026 da RoboticsTomorrow acertou em cheio: com um modelo CAD preciso, esta é "a abordagem mais confiável e que menos consome recursos" — o tempo do engenheiro vai para ajustar parâmetros, não para desenhar caixas.
Duas falhas fatais. Primeira: sem desenhos, sem festa — peças legadas, componentes de fornecedores e o desvio do construído não dão à simulação onde se apoiar. Segunda: os renders saem limpos demais: imagens reais trazem óleo, arranhões, luzes piscando; os renders não. Modelos treinados com dados impecáveis desmoronam no chão.
A conclusão contraintuitiva: o problema da simulação CAD nunca foi "não realista o bastante" — é "limpo demais para ser verdade". Armazéns não são salas limpas; modelos não temem o feio, temem a sujeira invisível.
Rota 3: dados sintéticos por IA generativa — o que o STRIPES da Zebra está realmente resolvendo
A Rota 3 é a resposta mais quente de 2026 para como os modelos de visão de IA de armazém são treinados. Sua vitrine: o dataset STRIPES da Zebra (Sim-to-Real Industrial Perception for Warehouse Scenes), lançado em setembro de 2026.
Os números: 30,000 imagens, 3,000 texturas e geometrias de caixas únicas, um milhão de caixas rotuladas — nenhuma desenhada por um humano.
As três inovações do STRIPES atingem exatamente os pontos fracos da Rota 2: criação de imagens por IA generativa sem modelos 3D estáticos, para que a diversidade de cenas escape da sua biblioteca de desenhos; desgaste simulado — caixas amassadas, amassados, poeira superficial, filme stretch — os estados mais sujos do armazém, e a etapa mais valiosa do pipeline; e aglomeração com física, onde a simulação de gravidade empilha as caixas em configurações naturalmente densas, inclinadas e intertravadas através de três fases reais: armazenamento em prateleiras, preparação no piso e carregamento de caminhões.
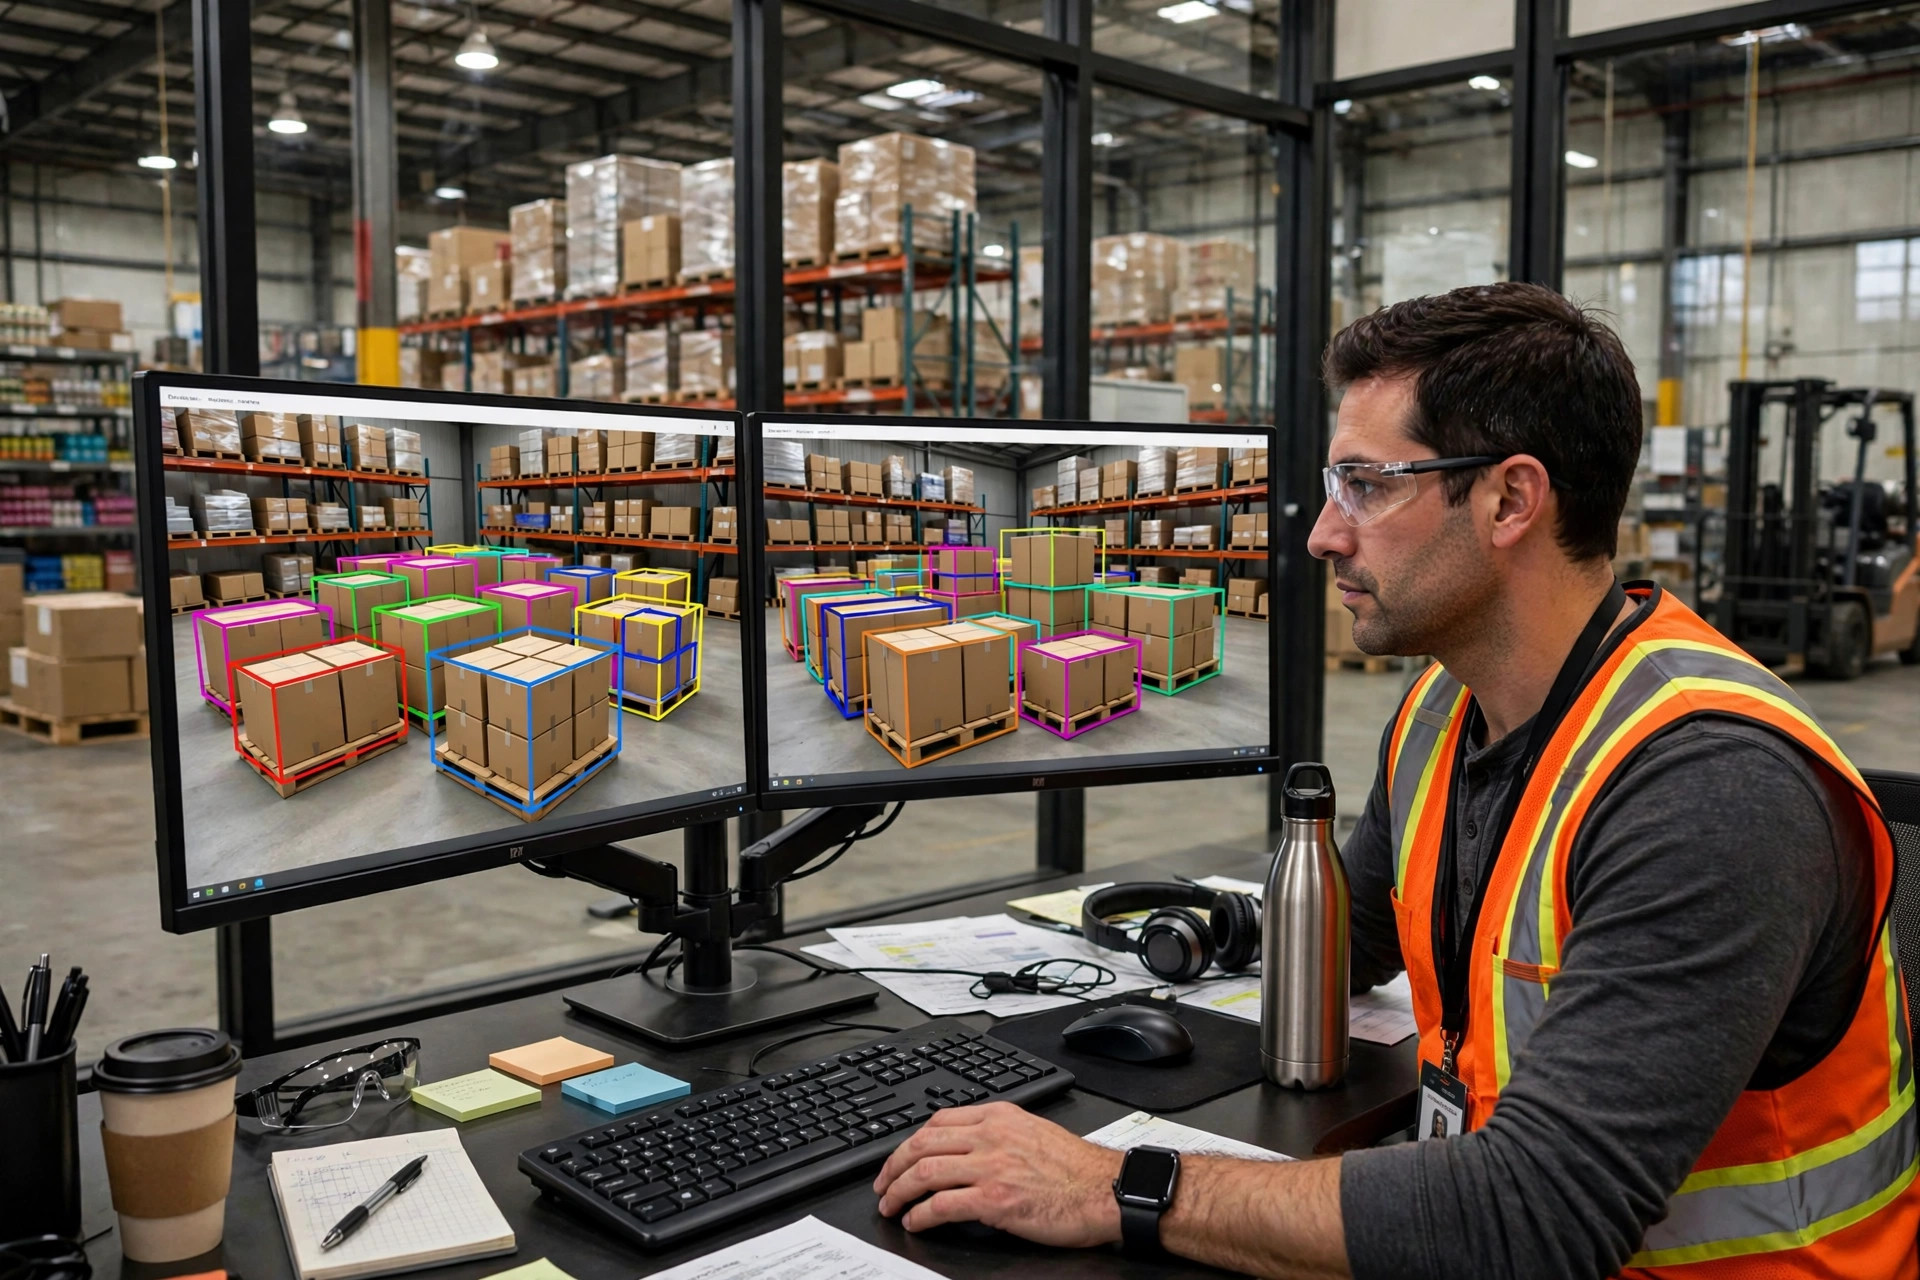
Viu? O STRIPES não está resolvendo "se os dados sintéticos parecem reais", mas "se são sujos o bastante". Dados sintéticos não precisam ser mais bonitos — precisam ser mais sujos. Um 99 na simulação não significa nada; o que importa é quantos tipos de sujeira o modelo já viu ali.
Sobre o custo: 30,000 imagens e um milhão de caixas, custo marginal em computação, não em mão de obra. Mas a Rota 3 exige o maior investimento fixo das três — modelos generativos, simulação física, engenharia de pipeline, tudo antecipado. Projetos pequenos não podem pagar o ingresso; os grandes ficam mais baratos com escala.
A lacuna sim-to-real: 99 no laboratório, 92 no chão
A lacuna sim-to-real: a diferença entre o ambiente de treinamento e o ambiente de implantação. Em maio de 2026, a Robotics and Automation News chamou fechá-la de "um dos objetivos de maior valor na robótica moderna".
Quão brutal? Setembro de 2026: a Telexistence ajustou o DreamZero da NVIDIA — um modelo que prevê ações e vídeo de câmera juntos — para reposição em lojas de conveniência. Dados simulados limpos de picking: 45% de sucesso. Gravações reais de teleoperação: 0%. Causa raiz: distribuições conjuntas e escalas de estado desalinhadas entre a simulação e a realidade.
45% para 0% não é "um pouco fora" — é outro universo. A lacuna não é o número de imagens; é se as distribuições se alinham.
Steve Nemzer, da TELUS Digital, disse bem em abril de 2026: use dados sintéticos para preencher lacunas específicas, mas ancore o treinamento em dados do mundo real — eles não podem ensinar a um modelo sobre artefatos de sensores ou as condições adversas da produção.
Minha tradução: dados sintéticos são um curativo, não a fundação. A fundação continua sendo dados reais; os curativos cobrem a cauda longa que você não pode fotografar ou não pode se dar ao luxo de esperar.
Sobre essa cauda longa: o artigo de 7 de outubro de 2026 deste site — "Amostras de anomalia que você não pode fotografar" — é o manual prático de curativos; este é o panorama das três rotas com a conta anexada.
Três rotas, uma tabela
| Rota 1: real + rotulagem humana | Rota 2: simulação CAD | Rota 3: sintético generativo | |
|---|---|---|---|
| Custo marginal / imagem | $0.10–$0.50 (tarifas públicas de fornecedores) | Computação de render, muito abaixo do humano | Computação de geração, muito abaixo do humano |
| Investimento fixo | Baixo (principalmente mão de obra de fotografia) | Médio (pipeline + ajuste de engenheiro) | Alto (modelos generativos + sim física + pipeline) |
| Conta em escala de 100K imagens | $10K–$50K, vezes o multiplicador de QA de 1.5–2x | A mais baixa com desenhos, custo fixo amortizado | A mais barata em escala; projetos pequenos não atingem o ponto de equilíbrio |
| Fidelidade | A mais alta, menor lacuna | Média — teme "limpo demais" | Média-alta — o STRIPES está consertando "a sujeira" |
| Falha fatal | Não consegue capturar a cauda longa; re-rotulagem a cada mudança de SKU / ambiente — o custo é uma assinatura | Morta sem desenhos | Alto investimento inicial; antieconômico em pequena escala |
Mais duas conclusões contraintuitivas:
Primeiro, a indústria de rotulagem de dados está sendo devorada pelos modelos que treina. A pré-anotação por IA mais revisão humana é agora o manual padrão dos fornecedores; o desenho manual puro de caixas está acabando, e os preços unitários continuam caindo. Um grande contrato de longo prazo de manual puro hoje provavelmente significa comprar no topo.
Segundo, os dados mais caros não são a taxa de rotulagem — são os dados que você não consegue capturar. O custo marginal de uma amostra de anomalia de cauda longa tende ao infinito: espere três meses e você nunca obterá uma foto padrão de "a empilhadeira destruiu o pallet". O verdadeiro poder de precificação dos dados sintéticos não é o barato — é o incomprável.
O veredito de Lao Zhou: "como os modelos de visão de IA de armazém são treinados" é um problema de aritmética
Qual rota? Sem achismo — calcule. Total da Rota 1 ≈ N × p × q (N: imagens necessárias; p: cotação por imagem, faixa pública $0.10–$0.50; q: multiplicador de QA, 1.5–2). Total da Rota 3 ≈ F + N × m (F: investimento fixo do pipeline; m: custo marginal por imagem, muito abaixo de p). Ponto de equilíbrio N* = F ÷ (p × q − m): passado N*, o sintético vence.
Exemplo resolvido (dados ilustrativos — insira suas próprias cotações): F = $30,000, p = $0.30/imagem, q = 1.5, m ≈ $0.05/imagem. N* = 30,000 ÷ (0.45 − 0.05) = 75,000 imagens.
O veredito: passadas cerca de 75,000 imagens — ou com giro rápido de SKUs e ambientes em mudança empurrando N sempre para cima — a rota sintética se paga. Caso contrário, fique com a rotulagem humana; não pague a mais por "mais avançado".
Se o dinheiro foi bem gasto, a fórmula decide.
Por Lao Zhou, analista de custos logísticos
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.