Vou dar meu veredito logo de cara: na maioria das vezes, o problema é o dado.
Eu já vi esse filme vezes demais em vinte anos de armazém. Um DC investe uma grana pesada num módulo de previsão de demanda com AI, o modelo entra em produção, e três meses depois a reposição continua sendo tocada no feeling do planejador veterano. O primeiro instinto do pessoal de TI é sempre "o modelo está errado, vamos trocar de algoritmo". O meu é sempre o mesmo: não mexa no modelo ainda — pegue os dados que você alimentou nele e olhe com atenção. Quase sempre, o problema está ali.
Um modelo é só um aluno muito esforçado. Entregue a ele um livro cheio de páginas faltando e erros de digitação, e não dá para culpá-lo por ir mal na prova.
Primeira pergunta: seus dados estão realmente completos?
Muito projeto de previsão morre no passo um: o cadastro de SKUs está uma bagunça.
Alguns anos atrás, visitei uma operação 3PL em Ontario, California — bem mais de cem mil pés quadrados, mais de vinte mil SKUs — que tinha implementado previsão de reposição baseada em ML. Seis meses depois, a acurácia era péssima. Cavamos e descobrimos que campos como categoria do produto, flag de sazonalidade e relações de substituição estavam em branco para uma enorme parcela do catálogo. Itens novos ficavam meses no sistema sem categoria nenhuma. O que exatamente o modelo deveria aprender? Do nada?
E tem a rotulação inconsistente: o mesmo produto marcado como "winter style" num DC, "Winter-2023" em outro, e em branco num terceiro. O modelo enxerga três produtos diferentes e aprende os padrões errados para todos eles.
O teste é simples: puxe 200 SKUs aleatórios e olhe categoria, sazonalidade, status de ciclo de vida e campos de substituição. Se a taxa de nulos passar de vinte por cento, pare de falar de modelo e vá arrumar seu cadastro. É trabalho sem glamour, mas pule essa etapa e tudo depois disso é esforço jogado fora.
Segunda pergunta: você está medindo a coisa certa?
Esse é o modo de falha mais sorrateiro que eu conheço. O "histórico de vendas" com que seu modelo treina muitas vezes nem é demanda real.
Caso clássico: um SKU ficou sem estoque por duas semanas em novembro passado, e o sistema registrou zero vendas. O modelo aprendeu "ninguém quer esse SKU em novembro" e subestocou neste ano — só que este ano não houve ruptura, a demanda apareceu normalmente, e a prateleira esvaziou. Um zero durante uma ruptura não é demanda. É o teto do que você conseguiu entregar. Ensine o modelo a confundir o teto com o piso e ele não tem como acertar.
Outro: transferências entre armazéns. O DC A fica sem produto, então 500 unidades saem do DC B, e o registro de saída do DC B marca 500 unidades de "vendas". O modelo vê demanda forte no DC B para aquele SKU e manda você estocar — estocando por uma demanda fantasma que na verdade foi só uma transferência interna. Demanda real e movimentação interna misturadas num número só vão enviesar cada previsão.
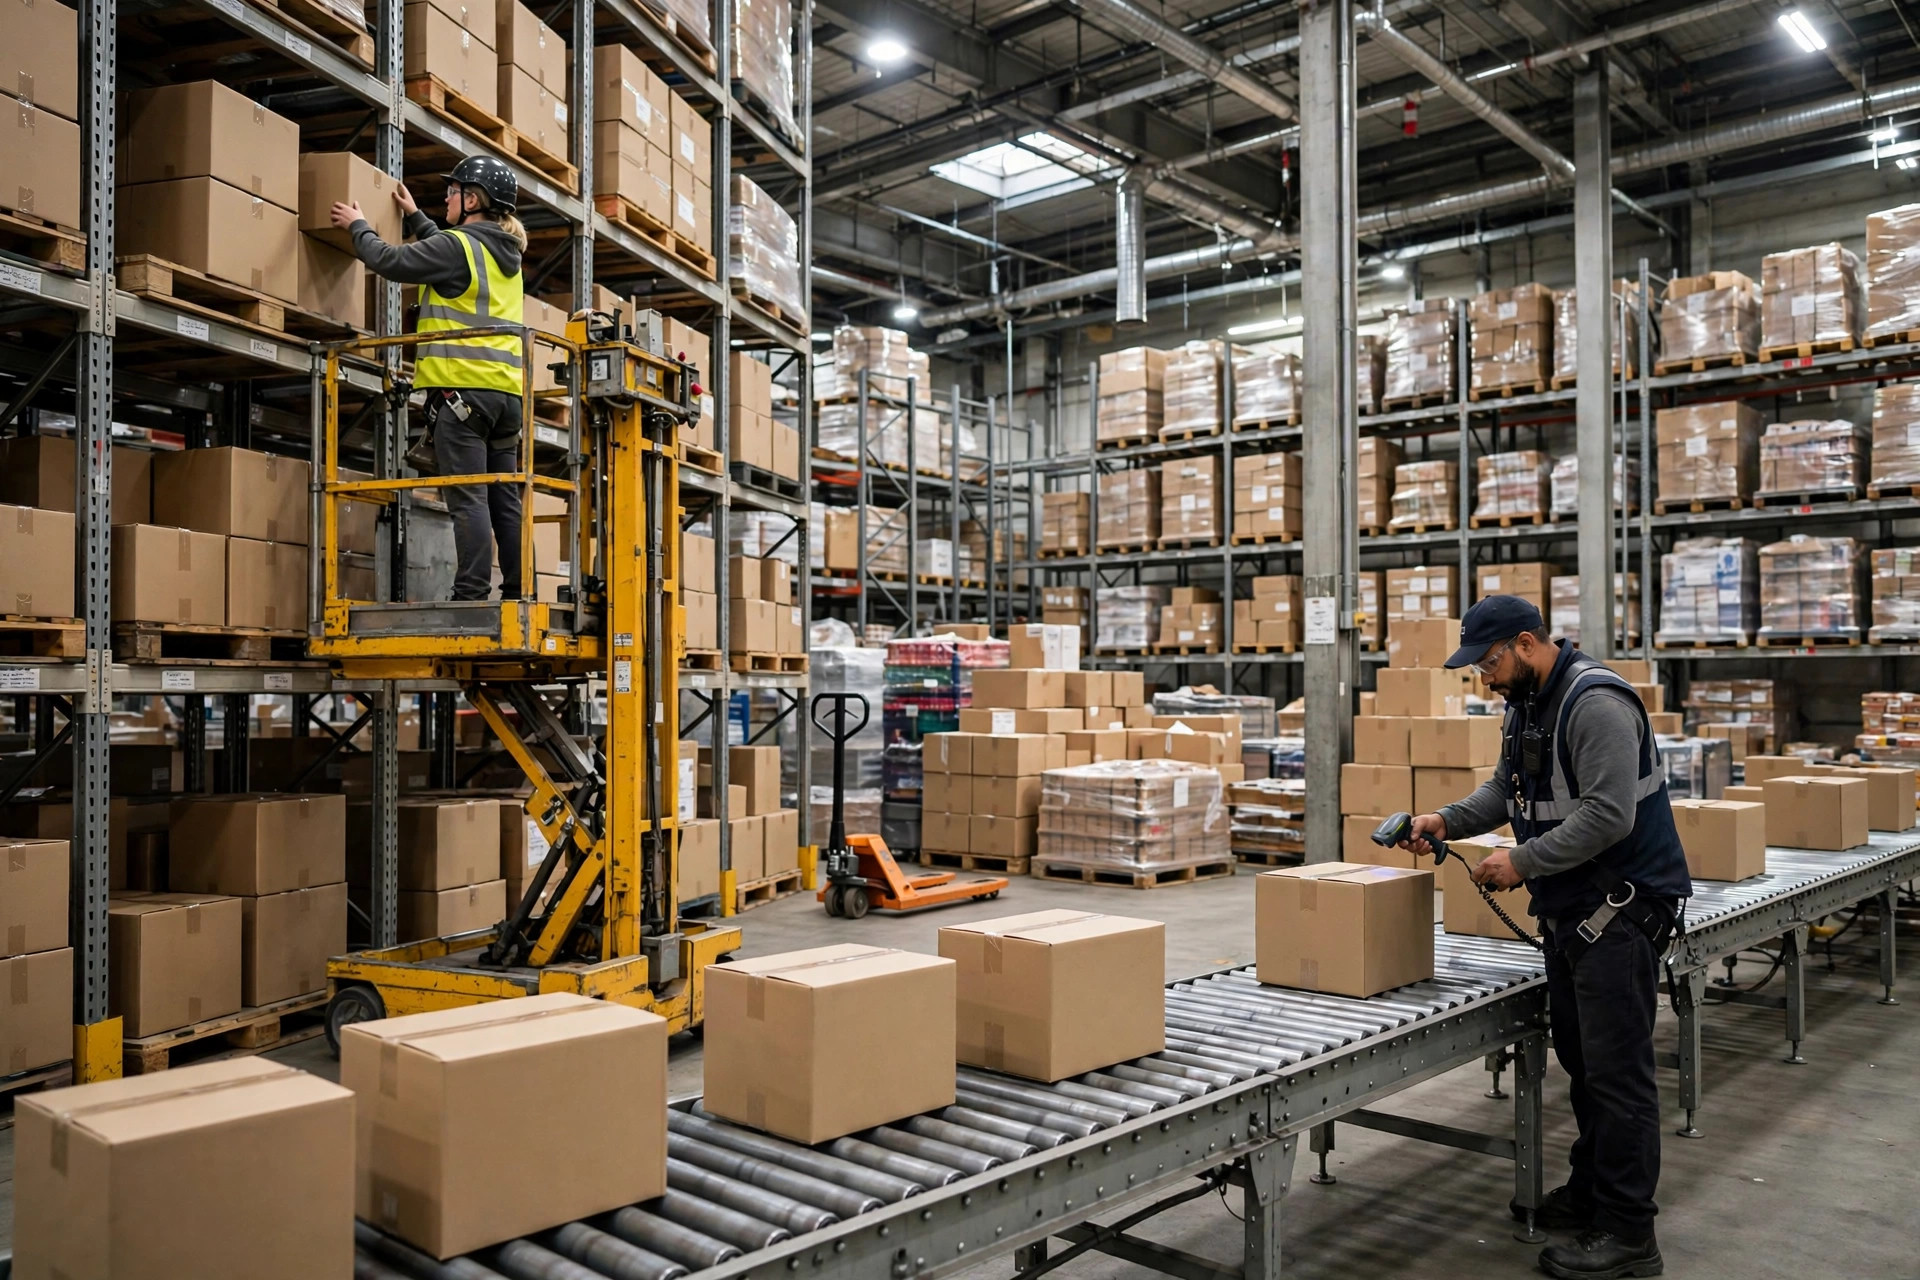
E não esqueça as devoluções. No fulfillment de e-commerce, venda bruta e venda líquida podem diferir muito. Treine com a bruta e o modelo vai superestimar cronicamente.
O teste: ache o documento que define sua métrica de vendas — se existir — e faça três perguntas. Como os períodos de ruptura são tratados — alguém reconstruiu a demanda real? As transferências estão excluídas? Bruta ou líquida? Se ninguém souber responder, ou a resposta for "a gente nunca tratou disso", você achou a causa raiz. Com uma métrica turva, quanto mais esperto o modelo, mais confiante ele erra.
Mais uma coisa que vale dizer: muito armazém puxa os dados de venda direto do ERP, e os registros de saída do ERP não distinguem "vendido para um cliente" de "enviado para nosso DC irmão". Ninguém faz essa etapa de limpeza, então o modelo estuda demanda falsa o dia inteiro. Eu costumo pedir ao time de dados para separar um ano de registros de saída em vendas, transferências e sucata primeiro. Essa única etapa costuma encolher a "demanda histórica" de vários SKUs visivelmente — e cada unidade que desaparece era ruído.
Terceira pergunta: alguém marcou os eventos?
Modelos de previsão odeiam picos sem explicação. As vendas dobraram num mês do ano passado, o modelo decorou o padrão, e este ano estocou o dobro — só que o pico do ano passado foi uma promoção grande e este ano não tem nenhuma. Agora você está sentado em estoque parado.
Promoções, queimas de estoque, picos puxados por influenciadores, clima atípico, ruptura de um concorrente — se nada disso estiver marcado, o modelo absorve tudo como "demanda natural". O que ele aprende não é um padrão. É ruído.
O pior caso que eu vi: três anos de dados de estocagem da era da pandemia dentro do conjunto de treino sem nenhuma anotação. O modelo tratou aqueles picos anormais como base, manteve o estoque de segurança do dia a dia permanentemente alto, e estoque parado encheu dois corredores inteiros. Depois que esse período foi marcado e recebeu peso menor, a previsão voltou à realidade.
Tem também uma dimensão fácil de esquecer: eventos do lado do suprimento. Uma entrega atrasada de fornecedor, uma greve portuária empurrando o inbound três semanas para frente — isso abre buracos inexplicáveis na curva de vendas. O modelo não entende "não conseguimos vender porque a mercadoria nunca chegou". Ele só aprende "ninguém quis esse SKU naquele mês". Então seu calendário de eventos não pode acompanhar só promoções. Registre também grandes rupturas de suprimento e anomalias de inbound. Marque os dois lados ou o quadro fica incompleto.
O teste: pegue os dez SKU-meses com as oscilações históricas mais selvagens e pergunte ao time de negócio o que aconteceu. Se eles explicarem mais da metade mas o sistema não registrar nada, seu calendário de eventos está vazio. Capturar os eventos custa dez minutos para o negócio descrever e talvez duas semanas para o time de dados implementar — vale cada hora.
Então quando a culpa é realmente do modelo?
Depois que os dados passarem nos três testes — cadastro completo, métricas limpas, eventos marcados — e a previsão ainda errar, aí sim, vamos falar de modelos. Serei o primeiro a concordar.
Problemas reais de modelo têm esta cara: os dados estão limpos, mas modelos simples e complexos performam quase igual, às vezes com o simples um pouco à frente. Ou a distribuição da demanda mudou estruturalmente — digamos que o negócio migrou do atacado para o varejo, ou da loja física para o online — e o modelo antigo aprendeu as regras de um mundo que não existe mais.
Tem também a engenharia de features deixando a desejar. Alimentar o modelo só com a série temporal de vendas, deixando de fora preço, posição de estoque e lead time — as features que o negócio realmente usa para operar. Isso é menos "algoritmo errado" e mais "o modelador não entende de armazém". Trocar de algoritmo não ajuda; trazer alguém que entende de reposição, sim.
Na minha experiência, features vencem algoritmos nesse domínio quase sempre. Um planejador que entende lógica de ressuprimento mais uma regressão simples geralmente supera um modelo sofisticado ajustado por alguém que nunca pisou no chão de um armazém. Os drivers de demanda de armazém são concretos: o calendário de promoções, os pedidos em aberto, a sazonalidade, a variabilidade do lead time dos fornecedores. Transforme isso em features e você vai mais longe do que com qualquer troca de arquitetura.
Minha regra prática é simples: se três modelos diferentes pontuam quase igual no mesmo conjunto limpo, o gargalo não é o modelo. Ajustar a escolha de modelo em dados sujos é só trabalho ocupado caro.
Um checklist de preparação de dados que dá para usar de verdade
Diagnóstico feito — agora vá arrumar a casa. Nesta ordem, sem pular:
- Cadastro: categoria, sazonalidade, ciclo de vida e campos de substituição para cada SKU, taxa de nulos abaixo de cinco por cento
- Métricas: reconstrua a demanda real dos períodos de ruptura (no mínimo, marque-os), remova as transferências, treine com vendas líquidas
- Eventos: monte um calendário de eventos — promoções, queimas de estoque, clima atípico, pedidos avulsos de volume, tudo marcado
- Granularidade: garanta que a granularidade da previsão (SKU-DC-week) seja a mesma das suas decisões de reposição; previsão certa na granularidade errada não serve para nada
- Backtest: rode um backtest de três meses nos dados limpos e estude a distribuição de erros antes de colocar qualquer coisa em produção
A maioria dos armazéns que concluem esses cinco passos descobre algo curioso: o modelo antigo de repente ficou "mais esperto". Ele nunca foi burro. Só estava lendo um livro cheio de erros de digitação.
Uma pergunta de autoteste para levar para casa: no histórico de vendas que você está alimentando no seu modelo de previsão agora, você consegue dizer quais linhas são demanda real, quais são rupturas e quais são transferências internas? Se não consegue distinguir, não se apresse em trocar de modelo — separe esses três primeiro. Quando essa pergunta estiver respondida, a maior parte do mistério das previsões ruins se dissolve.
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.