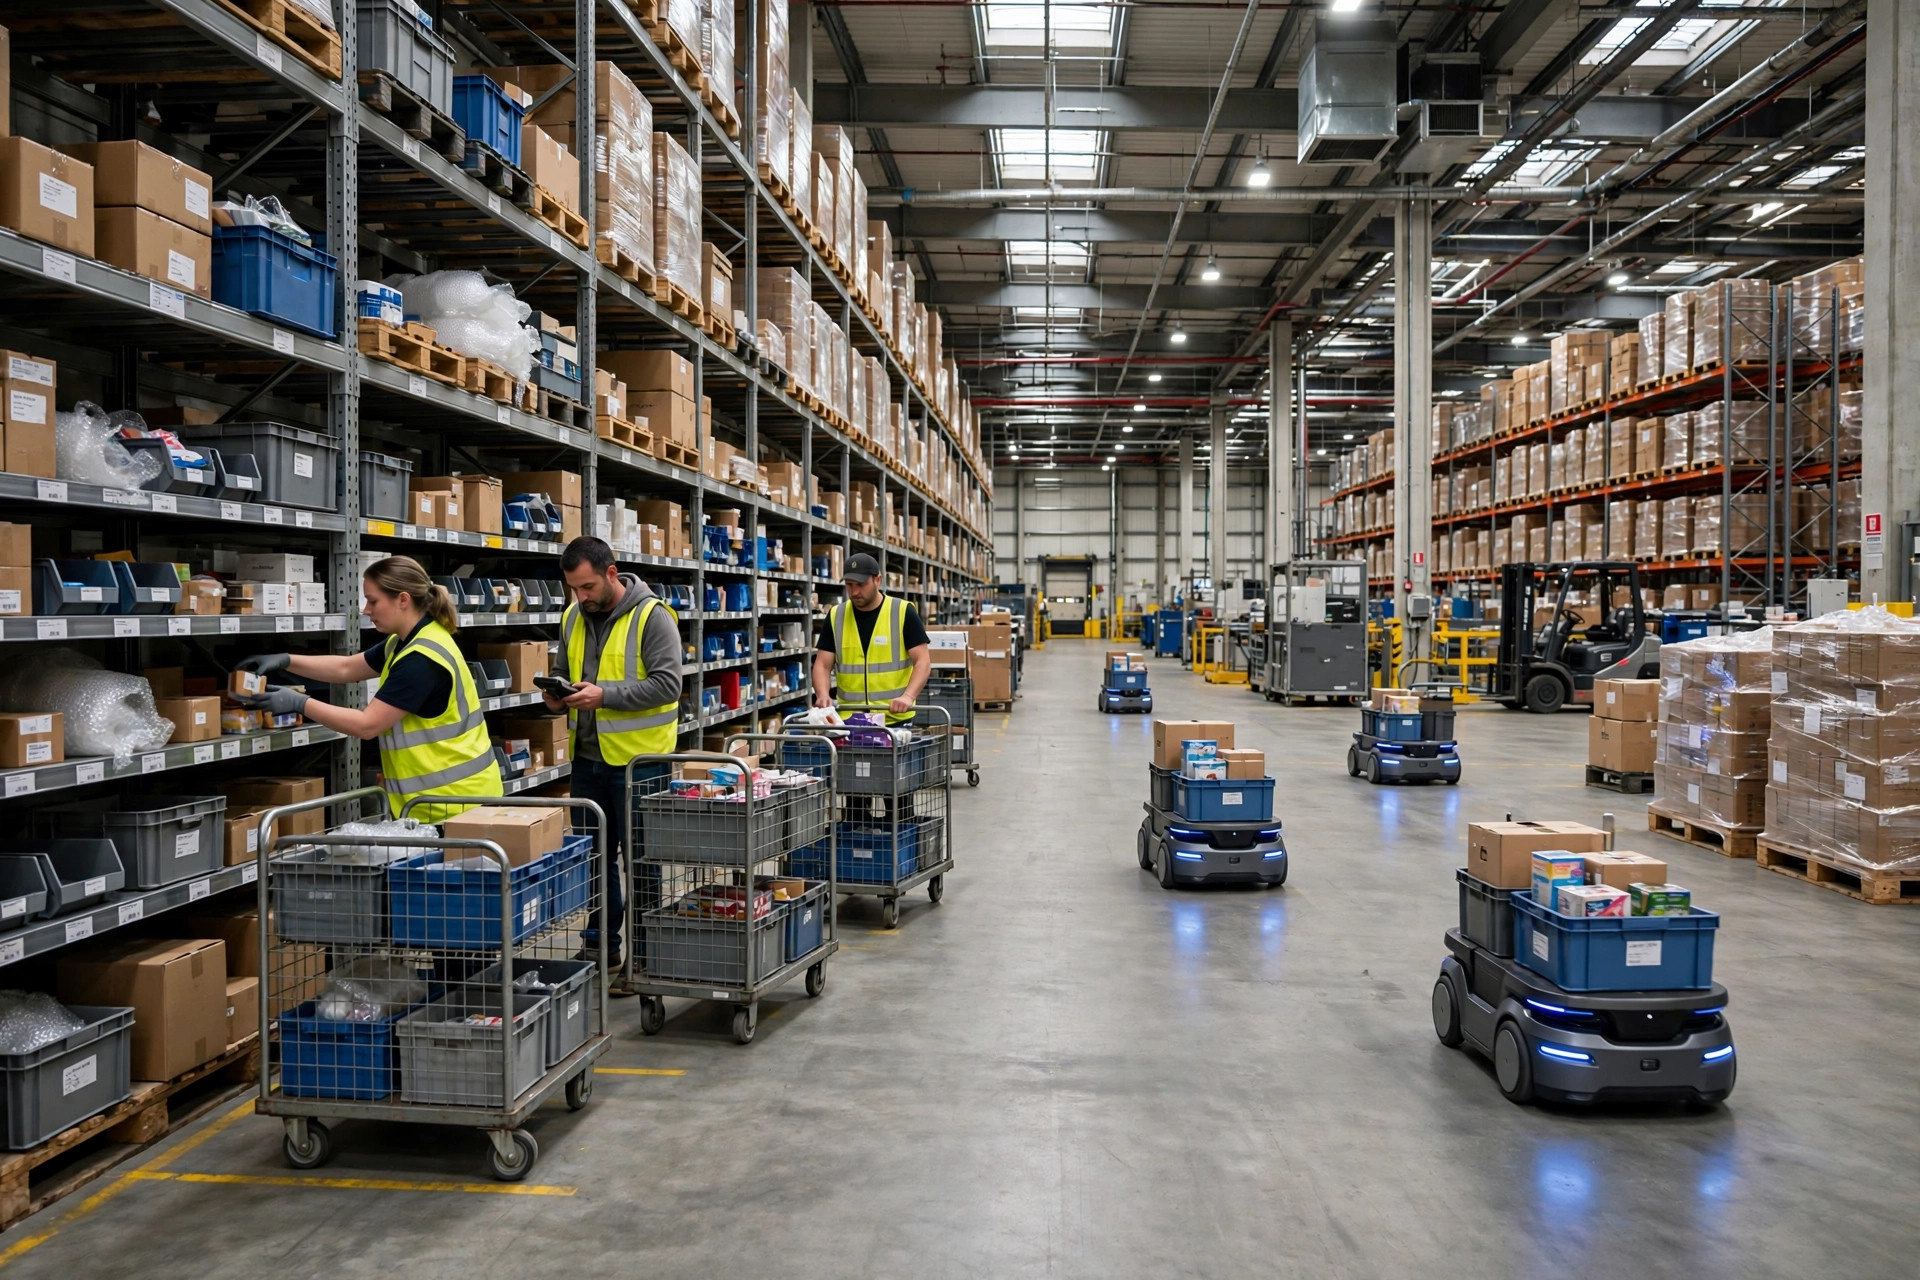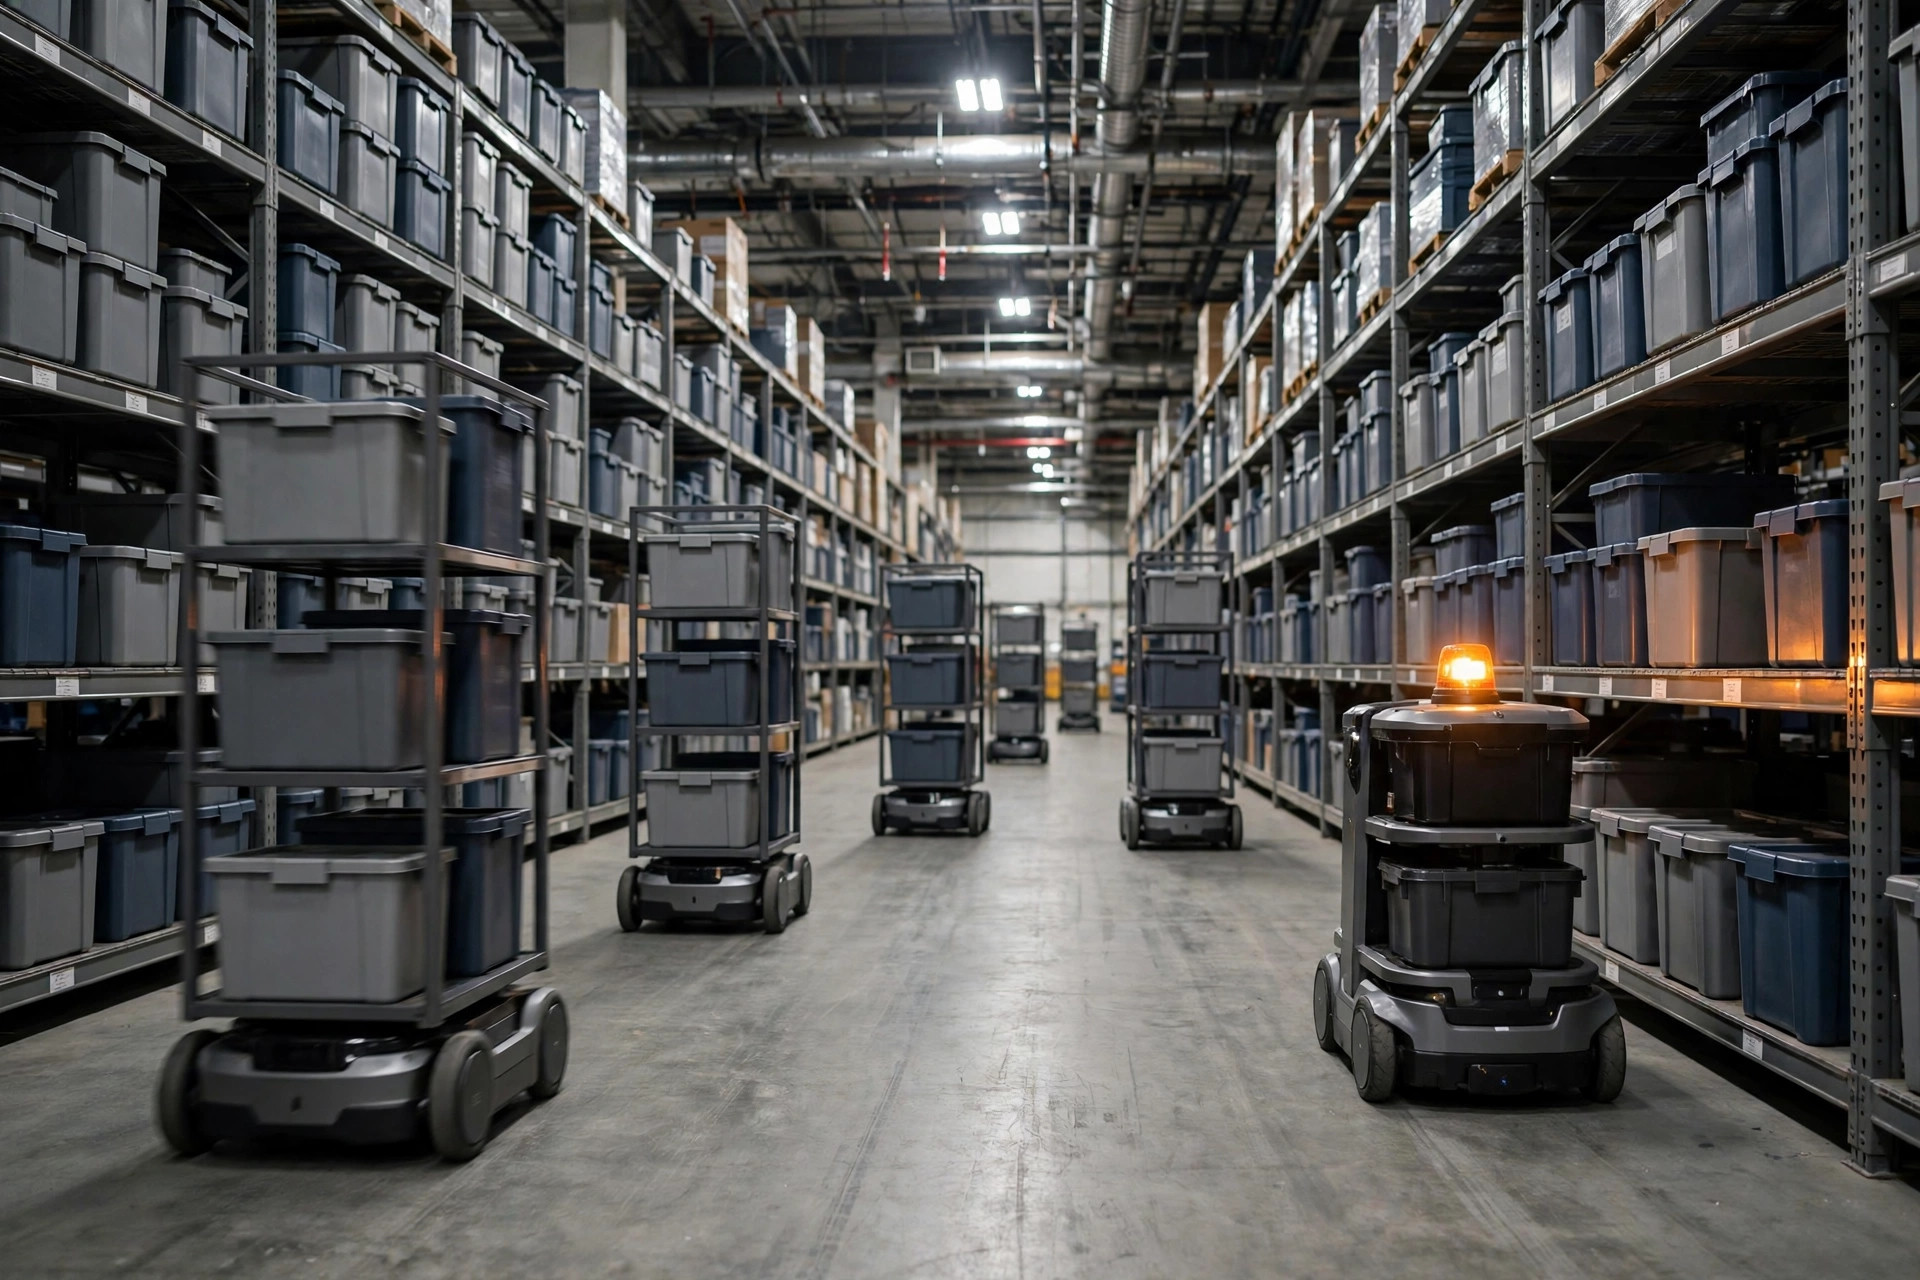
Em agosto passado, eu estava numa visita de acompanhamento num armazém de e-commerce 3C no leste da China — quarenta AMRs de transporte de prateleiras funcionando sem parar. Às 10h, o ar-condicionado da sala de servidores morreu e o servidor de gerenciamento de frota superaqueceu até reiniciar — uma falha de ponto único de manual. Quinze minutos sem emitir nenhuma ordem: cada robô acionou sua parada de proteção e congelou. A onda da manhã atrasou quase duas horas.
A autópsia foi humilhante: o servidor estava bem, uma reinicialização resolveu. Mas aqueles quinze minutos expuseram a verdade — neste sistema "inteligente", o ponto único de falha estava escondido no lugar mais entediante. Este artigo divide as falhas de ponto único dos AMRs em três camadas — onde cada uma se esconde, como reforçá-la, onde traçar a linha — além de como quebrar o sistema de propósito na aceitação. Aviso: os números sem fonte abaixo são minhas estimativas pós-projeto; a ordem de grandeza está certa, não os copie para uma licitação.
Onde as falhas de ponto único dos AMRs realmente se escondem
Pense nisso como o trânsito de uma cidade. A frota de AMRs é o fluxo de carros, o sistema de gerenciamento de frota (FMS) é o centro de controle de semáforos, e a rede Wi-Fi é o rádio na mão de cada motorista. O que paralisa uma cidade nunca é um carro quebrado — é uma destas três coisas falhando:
Camada um: o veículo individual. Um robô cai — bateria superdescarregada, lidar sujo, detritos numa roda motriz. O mais comum, o menos perigoso: um robô caído é 2.5% da vazão numa frota de 40 robôs.
Camada dois: o despachante. O servidor FMS trava, o software de agendamento dá um bug, o banco de dados entra em deadlock. Um servidor soluça e a frota inteira fica surda — aquele corte de quinze minutos foi esta camada. A verdadeira falha de ponto único: uma máquina comandando tudo.
Camada três: a rede. Um ponto de acesso morre, o roaming falha, uma zona morta aparece. Os robôs perdem contato com o despacho e executam sua política de "link perdido" — parar onde estão, frequentemente no meio de uma via principal.
Das três camadas, 90% dos projetos despejam dinheiro na camada um — robôs mais sofisticados, mais sensores — enquanto as camadas dois e três recebem as sobras. É por isso que todo incidente vira uma parada total do piso: o dinheiro foi para a camada errada.
As três camadas de redundância: para onde o dinheiro deveria ir
Princípios primeiro, linhas divisórias depois. Mais backup não é automaticamente melhor — trata-se de gastar na camada certa.
Backup de veículos significa robôs sobressalentes, não peças sobressalentes. A abordagem correta é N+1: numa frota de 40 robôs, compre uma ou duas unidades extras como sobressalentes quentes. Um robô morto é arrastado para fora, um sobressalente assume, a vazão não cai. A linha divisória: dois turnos 24 horas → N+1 é obrigatório. Um único turno diurno → compartilhe um pool de sobressalentes entre sites, ou pule; um robô que morre ao meio-dia é consertado à noite.
Agora preciso denunciar um pseudo-requisito. Alguns fornecedores vendem "lidar duplo, bateria dupla" e aumentam o preço do robô em 30%. Isso é uma doação ao fornecedor, não engenharia. Os AMRs industriais convencionais trazem números de MTBF declarados pelo fornecedor acima de 5,000 horas. Gastar um prêmio de 30% para reduzir falhas de uma unidade de algumas vezes por ano para uma ou duas é inútil quando um soluço do despachante mata a frota inteira de qualquer jeito. Guarde esse dinheiro para a camada dois.
O backup do despachante — servidores ativo-standby — é o dinheiro que mantém você vivo. Dois servidores FMS — um ativo, um em espera — com monitoramento por heartbeat e failover automático. Pense num avião bimotor — perca um motor e você continua voando. A linha divisória é o tempo de failover: precisa vencer o limiar de "parada de proteção por link perdido" dos robôs, comumente 5–10 segundos dependendo do fornecedor (experiência de campo — exija esse número e escreva no acordo técnico). Failover em 30 segundos conta como aprovado. Mais de um minuto é o mesmo que não ter backup — os robôs já terão parado sozinhos, e seu servidor de reserva herda um piso de cadáveres precisando de recuperação manual, um por um.
Backup de rede significa cobertura de AP sobreposta. Cada zona precisa estar dentro do alcance de pelo menos dois pontos de acesso, de modo que quando um AP morre o vizinho absorve a carga. A linha divisória: com um único AP caído, os vizinhos precisam cobrir pelo menos 90% daquela zona, com handoff de roaming abaixo de um segundo. Um "projeto de AP duplo" que não atinge esses números é decoração.
Três níveis custeados para uma frota típica de 40 robôs (as porcentagens são minhas faixas de experiência):
| Nível | Custo extra (% do projeto) | Complexidade | Tempo típico de recuperação | Para quem é |
|---|---|---|---|---|
| Básico: FMS único + AP único + sem robô sobressalente | +0% | Baixa | Recuperação manual, 30 min – 2 h | Armazém pequeno de um turno que pode se dar ao luxo de parar |
| Padrão: FMS ativo-standby + cobertura de AP sobreposta + 1 robô sobressalente | +8%–12% | Média | Failover em 30 s, falha de um robô coberta em 10 min | A maioria dos armazéns 24 horas |
| Alta disponibilidade: FMS ativo-ativo + rede dual-band + 10% de pool sobressalente | +20%–30% | Alta | Failover em segundos, a vazão quase não cai | Pharma, automotivo — onde uma linha parada significa penalidades |
Viu o formato? De básico para padrão custa cerca de 10% a mais e puxa a recuperação de horas para minutos — o melhor valor por dólar aqui. O nível de alta disponibilidade é para operações onde um minuto parado custa dinheiro de verdade. Armazéns de e-commerce comuns devem ficar longe; a complexidade morde de volta.
Isolamento de falhas: arraste o robô morto para fora da rede de tráfego primeiro
O backup mantém o sistema vivo. O isolamento de falhas impede que a parte morta derrube a parte viva. Como uma pane na rodovia: o primeiro passo é arrastar o carro para o acostamento, não consertá-lo na faixa de rolamento.
Uma cadeia de isolamento de falhas adequada: o autodiagnóstico do robô detecta uma anomalia (bateria, perda de localização, falha de tração) → informa o FMS em 3 segundos → o FMS marca aquele trecho de via como zona de exclusão temporária → as tarefas inacabadas do robô morto são reatribuídas a robôs saudáveis → um humano ou um robô sobressalente o reboca. Tudo automático; o humano só faz o reboque final.
Eu vi o contraexemplo. Em março de 2024, num armazém de autopeças no norte da China, o módulo de energia de um AP queimou. Seis robôs na zona perderam o link por mais de 5 segundos e pararam por proteção — dois deles numa artéria principal. A lógica de isolamento do FMS tinha um bug: dados de posição com mais de 10 segundos de um robô com link perdido contavam como obsoletos, então nenhum desvio saiu. Quatro robôs saudáveis ficaram na fila atrás dos "cadáveres". Quarenta minutos de limpeza manual, metade do despacho do armazém congelado.
Duas lições. Primeira, projete o isolamento para a pior posição — assuma que o robô morto sempre para na via mais crítica. Segunda, nunca desvie pela última posição reportada; desenhe a zona de exclusão a partir de "última posição conhecida mais um raio de segurança". Desvie longe demais em vez de entrar dirigindo.
Depois a degradação elegante — a segunda metade do isolamento de falhas. Caso extremo: 30% da frota caída de uma vez (um lote ruim de baterias acontece). O sistema não deveria se deitar; deveria se degradar automaticamente: abaixar um grau de velocidade, repriorizar tarefas (proteger a onda de saída, adiar a entrada), expandir a zona de picking manual. Pré-configure isso no FMS com limiares duros — "entrar em modo degradado automaticamente quando os robôs saudáveis caírem abaixo de 70%". Não conte com o operador do turno da noite improvisando às 3h.
Antes da aceitação: simulados de falha de ponto único que você não pode pular
A armadilha da manutenção: documentos de projeto lindos, mas ninguém ousa quebrar o sistema na aceitação. Execute cada simulado à mão; não assine se algum falhar:
- Puxe o plugue do servidor de despacho. Cronometre a assunção do servidor de reserva; verifique se não há paradas de proteção em massa. Mais de um minuto — reprovado.
- Mate o processo de despacho sem cortar a energia. Simula um crash de software — verifique se a detecção por heartbeat pega o "falso vivo" split-brain (processo rodando, serviço morto).
- Desligue um AP. Verifique um roaming suave, sem paradas por link perdido.
- Pare de emergência um robô aleatório. Cronometre a zona de exclusão e a reatribuição de tarefas. Mais de 3 minutos — o isolamento falha.
- Corte a energia de toda a fila de carregamento. Verifique se a política de despacho de bateria baixa se sustenta — o item mais negligenciado aqui. Já vi duas vezes robôs com bateria baixa fazerem fila para carregar, não acharem energia e morrerem coletivamente.
- Simule 30% da frota offline. Verifique se o modo degradado dispara automaticamente e se a onda de saída sobrevive.
Registre cada simulado: hora de disparo, hora de recuperação, intervenção humana ou não. Se o fornecedor disser "testamos no nosso laboratório", a resposta é: seus robôs, meu piso, agora mesmo. Uma disponibilidade de 99.99% testada em laboratório perde pelo menos 20% no momento em que encontra racks e empilhadeiras de verdade.
Balanço final. Se esse dinheiro vale a pena se resume a um número: o custo de uma hora parada na sua alta temporada. Volume horário de saída de pico × margem média por pedido, mais penalidades por atraso e mão de obra ociosa — facilmente mais de $3,000 para um armazém de e-commerce de médio porte. O nível padrão custa cerca de 10% a mais; em três anos de depreciação isso dá dezenas de dólares por hora. Dezenas de dólares por hora para proteger contra milhares de dólares por hora de prejuízo — faça a conta você mesmo. Mas se seu armazém roda um turno com volume modesto e uma parada de duas horas só atrasa uma tarde — o nível básico basta; esse orçamento compra melhor peças sobressalentes. Gasto com backup não é sistema de crença. É aritmética.
Por Da Liu, Engenheiro de Automação
Traduzido do inglês. Em caso de divergência, prevalece a versão em inglês.