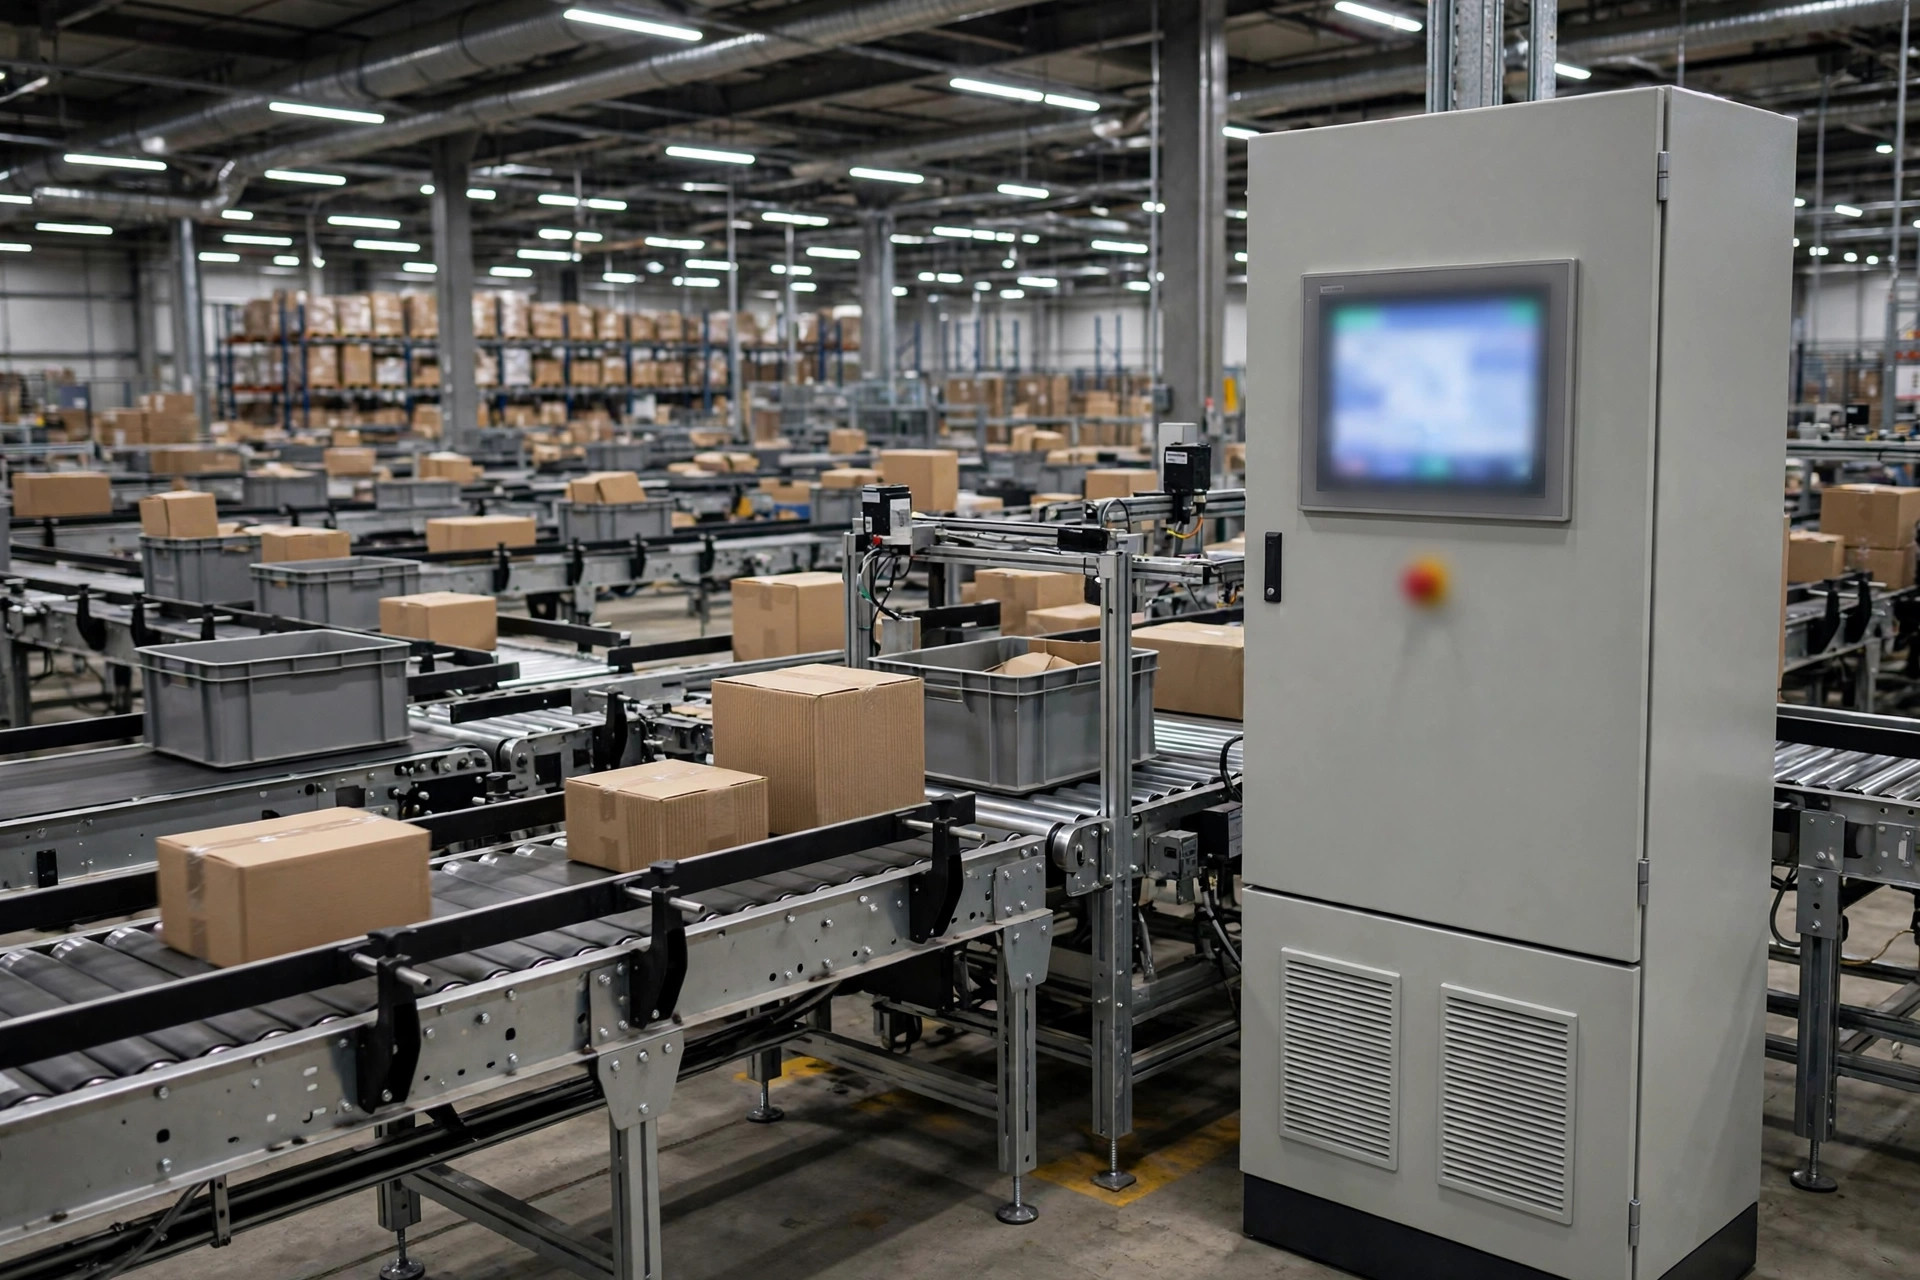
火曜日の午前2時14分、夜勤のリーダーからピッキング失敗の連絡が入った。WCS の画面では、売れ筋 SKU のトートが 12 個シャトルシステム内にあると表示されていた。WMS の画面では在庫はゼロ。ピッカーはすでに通路を 2 往復していた。原因が判明したとき――夕方シフトが例外品をスキャンせず手作業でさばいていた――すでに 40 分を浪費し、30 件の注文について運送会社の締め切りに間に合わなかった。
その一夜のコストは、これから説明する照合ルーチンを 1 年間回すコストを上回った。
2つのシステム、2つの「ここ」
まず押さえておきたいのは、WCS と WMS が追跡している在庫は種類が違う、ということだ。WCS が追跡するのはキャリアだ――どのトートがコンベアのどの区間にあり、どのシャトルがどのパレットを保持し、各 AMR が何を運んでいるか。設備の位置で考えている。WMS が追跡するのはロケーションだ――どのラックのどのスロットにどれだけの在庫があるか。帳簿の位置で考えている。
製品が設備上を移動している間、WCS が「こっちにある」と正しく言い、WMS が「まだ帳簿に載っていない」と正しく言う。どちらも間違っていない。方言が違うだけだ。この前提を飛ばした照合作業は、すべて噛み合わない議論に終わる。
規模感をつかむために:繁忙期のある夕方 18 時、全長 600 メートルのコンベアループが一度に 400 個以上のトートを運んでいた――WCS 側では 3,800 ユニット超の輸送中在庫、WMS の帳簿では 4 パーセント近く少なかった。何も失われていなかった。すべて方言だ。だが方言を理解しない照合ルーチンは毎日狼少年を叫び、チームがアラートを無視することを覚えたら、本物の異常はノイズに埋もれる。誰もが理解する 4 パーセントの差異は、誰にも説明できない 0.5 パーセントの差異に勝る。
差異の3つの型
輸送中の変動は正直者だ。コンベア上、シャトル上、AMR 上の製品――どの保管ロケーションにもない。繁忙期には 600 メートルのコンベアループが一度に何百ものトートを抱え、輸送中在庫は総在庫の 5 パーセントを超えることもある。ある時点での両システムの数ポイントの差は正常だ。仕事はそれを消すことではなく、その差が紛失ではなく輸送中だと知ることだ。
例外引き抜きは危険だ。設備が問題のあるカートンを例外シュートに振り分けたり、現場の誰かが製品を物理的に取り除いたりする。WCS は移動を記録するが、WMS には確認が届かない。帳簿が乖離する――そして輸送中在庫と違い、この製品は本当にいるべき場所にない。
信号ロスは腹が立つ。バーコードスキャナーが読み取りをミスする。PLC が 3 分間オフラインになる。物理的な移動は起きたのに、データは同期されなかった。製品はまったく問題なく、あるべき場所にきちんとあるのに、両システムは数の一致に同意できない。
3 つの型のうち、例外引き抜きが最も高くつく。1 件のピッキング失敗で、ピッカーは無駄足を踏み、再カウントし、探し回る――15 分が消える。繁忙期には 1 日に何十回も起き、手戻り労働と SLA へのダメージが急速に積み上がる。間違ったデータによる誤ピッキングは、顧客クレームでさらに高くつく。照合は IT の雑用ではない。お金に直結している。
実際に回る照合ルーチン
リアルタイム照合は幻想だ。WCS はミリ秒単位の設備の世界に生き、WMS はトランザクションの帳簿の世界に生きている。2 つのテンポを無理に一致させようとすると、チームは疲弊し、それでも本質は外れる。
うまくいくのは 2 層構造だ。まず、1 時間ごとの変動スナップショット――合計数量と主要 SKU のみで、異常な振れにアラートを出す。私は 1 SKU あたり 5 ユニットのような閾値を使っている。きつく設定しすぎると 1 日に何十ものアラートが飛び、皆が無視することを覚える。アラートなしと同じだ。次に、シフト終了前に行う終日の完全照合。未解決の変動には必ず担当者を割り当てる。担当者のいない変動は、差異が伝説化していく道だ。
変動を拾ったら、1 本の鎖をたどる。まず WCS のイベントログから:LPN またはトート ID を時間軸でさかのぼり、最後に記録されたアクションまで――どの設備が最後にそれを見たか。次に同じ商品の WMS トランザクション履歴を引く:帳簿上の最後の移動は何だったか。タイムスタンプが合わなければ、インターフェースのメッセージを落とした可能性が高い。タイムスタンプが合うのに数量が合わなければ、誰かがシステムに黙って製品に触れた。
2023 年のプロジェクトの事例が今も頭から離れない。変動は夜勤に集中し、日勤はきれいだった。WCS のログでは、午前 2 時か 3 時ごろに例外シュートの製品が WMS の記録なしに「消えて」いた。原因は、夜勤リーダーがラインを止めないために例外品を手でさばいていた――スキャンは一度もしていなかった。ソフトウェアの問題ではない。システムが予防できるよう設計されるべきだった、人の問題だ。
予防策に進もう、影響の大きい順に。1 つ目:例外シュートは製品を出すのにスキャンを必須にする――物理的に、できるなら、両システムが記録せずに何も出ていかないように。2 つ目:すべての手作業介入はハンディ端末の 2 ステップ例外フローで行う。そうすれば WMS は製品と一緒に帳簿を動かす。2 ステップに抑えること。長いフローは使われない。3 つ目:WCS と WMS の間にメッセージキューを置く。ネットワークの瞬断は人生の事実だ。問題は、メッセージが再送されるか、静かに捨てられるかだ。古い連携の多くは直接結合で、そこで変動が静かに積み上がる。1 パケットの欠落ずつ。
次に差異が出たら、この順で 3 つの質問を。製品は今、設備上にあるかロケーションにあるか? WCS のイベントログが最後に見たのは何か? WMS のトランザクション履歴が最後に記録したのは何か? 10 件中 8 件は、3 つ目の答えが議論に決着をつける。3 つの答えを書き出すこと。書く規律は覚える自信に勝る。両システムが完全に一致することは永遠にない――あなたの仕事は、その不一致を退屈で説明可能なものにすることだ。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。