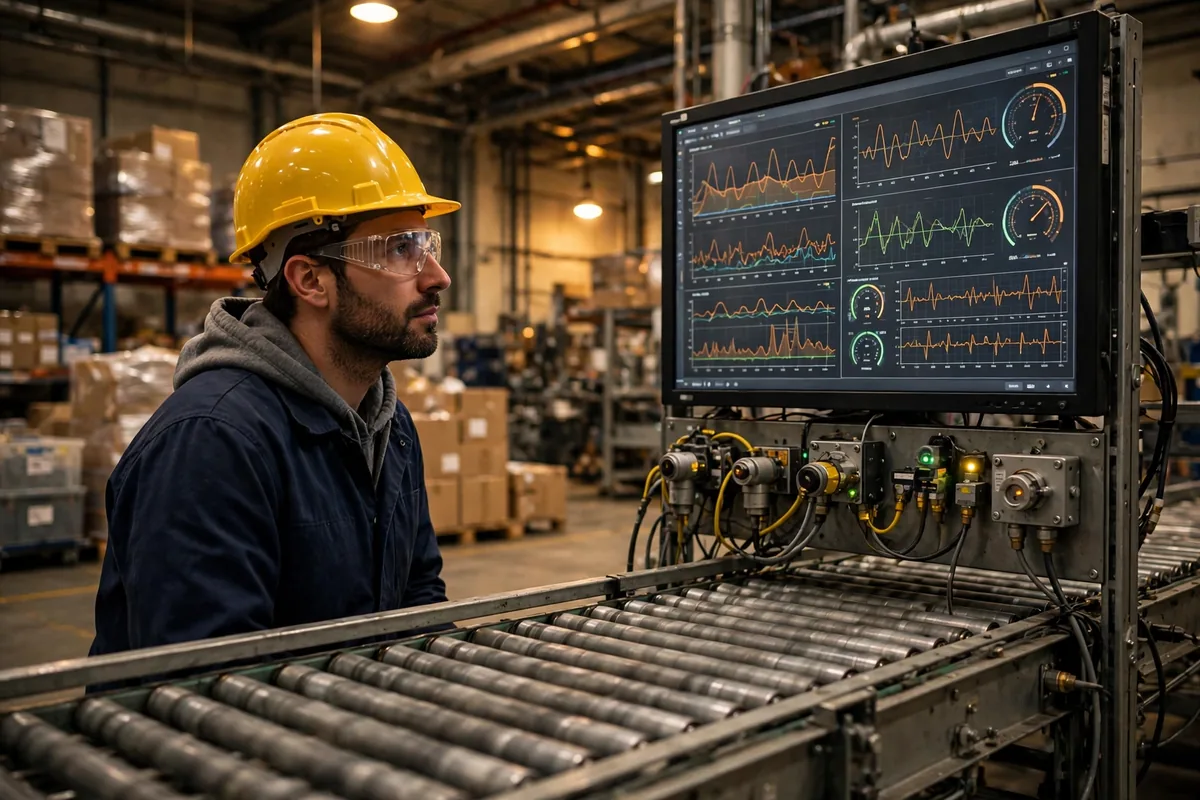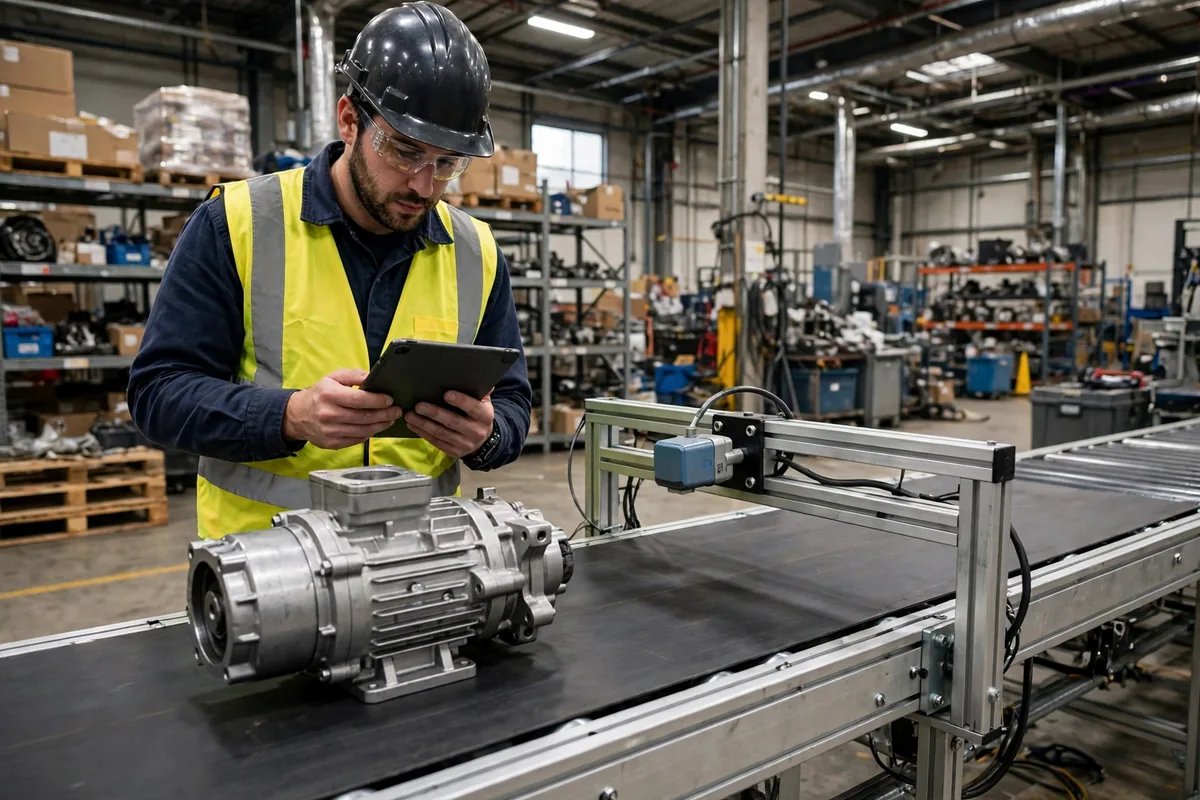
コンベヤが止まると、AIによる倉庫コンベヤの予知保全は抽象的な話題ではなくなる。最初に壊れるのは、たいてい機械そのものではない。その周りのスケジュールである。人が並び、注文が滞り、締切時刻がずれ、計画できたはずの保全作業が緊急対応になってしまう。業界の公開レポートやベンダーのパイロット概要によれば、そのタイミングこそが計画外停止が非常に高くつく理由である。なぜなら、それは静かな時間帯にはめったに起きず、ピークの夜、締切の二時間前、あるいは最も人員の薄いシフトに起きるからだ。ここで倉庫運営者が繰り返し立ち返る問いが生まれる。故障するコンベヤは停止する前に何らかの警告を発するのか、そして発するなら、その警告は行動できるほど信頼できるものにできるのか。AIによる倉庫コンベヤの予知保全は、条件付きの答えを与える。すなわち、警告の兆候は通常存在するが、それは継続的に観測され、同じ設備自身の履歴と比較され、新しさではなくコストで判断される場合に限る、というものである。
その根底にある考え方は神秘的ではない。モーター、ベアリング、ベルト、ローラーは通常、健全な状態からいきなり故障するわけではない。劣化の曲線に沿って進み、詰まりやライン停止のはるか前に、まず振動スペクトルに、次に音響的な特徴に、そしてしばしば温度や電流の変化に痕跡を残す。言い換えれば、故障は突発的な出来事ではなく観測可能なプロセスであり、AIはそれを定量化し、順位付けし、一晩中見守ることができるものに変える。最初から重要な留保が一つある。タイトルの「二週間前」という表現は、パイロットの範囲のうち強い側の端を示すものであり、保証ではない。報告されたパイロット経験では、リードタイムは通常数日から二週間のあいだに収まり、個々の設備がどこに位置するかは、設備の種類、センサーの配置、ベースラインデータの収集期間、運転条件によって決まるため、それらの条件なしに引用された正確な精度の主張は慎重に扱うべきである。
AIによる倉庫コンベヤの予知保全が実際に監視するもの
2025年5月の事例が、振動の側からこの点をよく示している。中国北部のコールドチェーン倉庫で、一日約十六時間稼働する仕分けコンベヤが、二週間にわたってあるローラーベアリング区間の振動の緩やかな上昇を示した。その上昇は劇的というより漸進的で、単独の一日だけ見れば読み値は正常と見なせたかもしれない。十四日間連続のデータを傾向として描いて初めて、傾きの変化が紛れもないものになった。システムは十一日目に警告を発し、保全チームは計画された週末の時間枠でベアリングを交換し、その後の点検で軌道面に初期のピッティングが見つかった。もしチームが可聴音を待っていたら、故障はほぼ間違いなく月曜朝のピークに重なり、その日約三千件の注文の仕分けリズムを乱していただろう。教訓は、予知保全が監視するのは単一の読み値が単一のしきい値を超えることではなく、傾向、変化率、そして機械自身の履歴からの逸脱だということである。
第二の事例は、2024年10月の中国東部の自動車部品倉庫からのもので、異なる信号によるものだった。重負荷のコンベヤ区間に、かすかで持続的な音があり、手作業の点検では特定できなかった。建物内の環境騒音のために人間の聴覚が頼りにならなかったことが大きな理由である。音響センサーを追加すると、システムはその音をあるモーターの特定の周波数帯に分離し、電流の変動と突き合わせて、故障になる前にファンの初期の緩みを確認した。修理は半シフトで済み、計画された時間枠内に完了した。両事例を合わせると、役割分担が見えてくる。振動はベアリングの劣化に、音は緩みや摩擦に、温度は潤滑不良や過負荷に適しており、複数の信号を一緒に確認することが、単一の信号だけよりも優れている理由がここにある。
倉庫コンベヤ予知保全AIとROI:精度だけでは誤解を招く
投資収益率を論じるとき、精度だけでは誤解を招く指標である。なぜなら、システムが最初の一年を生き延びるかどうかを決める唯一の問い、すなわち真の警告一つにどれだけの価値があり、誤報一つにどれだけのコストがかかるのかに答えないからだ。パイロット評価で最も一般的に使われるコストの枠組みによれば、便益側には三つの要素がある。計画外停止を避けることで守られるスループット、緊急修理を計画修理に変えることで回避される残業費と緊急部品費、そして部品在庫が念のためではなく測定された傾向に従うことで解放される運転資金である。コスト側には、センサーとデータ収集ハードウェア、プラットフォームの利用料または自社開発コスト、そしてモデルの校正と誤報への対応に費やす労務が含まれる。具体例として、計画外停止の一時間が数万元かかる一方、計画されたベアリング交換が閑散時間枠で半時間で済むなら、年に二〜三回の早期介入の成功でパイロットの費用をまかなえるかもしれない。逆に、毎月の誤報は信頼を急速に損ない、システムはやがて電源を切られることになる。
| 信号の種類 | 主に監視するもの | パイロットにおける代表的なリードタイムの範囲 | よくある誤報の原因 |
|---|---|---|---|
| 振動 | ベアリングとローラーの劣化傾向 | 数日から二週間、設備により異なる | 緩んだ取り付け、外部振動 |
| 音 | 緩みや摩擦タイプの異常 | 数日から約一週間 | 工場の背景騒音、隣接設備 |
| 温度と電流 | 潤滑不良、過負荷 | 数時間から数日 | 周囲温度の変動、負荷の変化 |
パイロットチームが繰り返し報告する、直感に反する知見もある。センサーを増やしても、システムが自動的に正確になるわけではない。クリーンなベースライン、設備台帳との校正、モデルへの修理記録のフィードバックがなければ、追加の信号は主にノイズを増やし、しきい値の設定を難しくする。関連するトレードオフも同じく現実的である。しきい値を敏感にしすぎると誤報で保全チームが疲弊し、保守的にしすぎるとシステムは事後アラームに戻ってしまう。したがって、しきい値の選択は純粋に技術的な設定ではなく、見逃した故障一つのコストと誤報一つのコストを天秤にかけるコスト判断であり、正しいバランスは倉庫の注文プロファイルやシフトパターンによって異なる。
工場全体ではなく一つのラインから始める
より信頼できる展開の進め方は、工場全体ではなく一つのラインから始めることであり、そのラインは厳しい基準で選ぶ。停止コストが高いこと、故障履歴が記録されていること、比較的安定した条件であること、そして修理結果をフィードバックする意欲のある保全チームがいることである。最初の三か月のパイロットでは、システムは監視のみを行い、モデルがそのラインのベースラインを学べるようにする。その後初めて警告を保全計画に結び付けるべきであり、三か月後のレビューに必要な指標は三つだけである。本当に早期に捉えた故障、誤報、そして各警告が実際に修理のタイミングを変えたかどうかである。その三つのうち二つが悪いようなら、問題は通常アルゴリズムではなく、データ品質かしきい値の設定であり、展開を拡大しても同じ問題を拡大するだけである。古い設備にはここで特に注意が必要である。過去の運転データがなく、規律ある交換記録もない場合、モデルは当初、正確な余寿命予測ではなく異常アラートを提供する可能性があり、そのような状況では、信頼できないベースラインの上にAIを載せるよりも、基本的な予防保全と点検の規律を立て直すほうがしばしば価値が高い。
今後を見ると、トレンドは二つの方向を向いている。一つはセンサーフュージョンとエッジコンピューティングであり、判断の一部を設備自身で行えるようにする。もう一つは、警告を保全計画や部品在庫に直接結び付け、アラートを赤いインジケーターではなく実行可能な作業指示に変えることである。どちらも同じ前提条件に立っている。継続的なデータ、クリーンな台帳、そしてフィードバックされる修理記録である。この三つがなければ、AIはより魅力的に見せたノイズしか見ない。
そうなると、より興味深い問いは、AIがどれだけ前もって警告できるかではなく、倉庫がそもそも警告に行動できる体制になっているかどうかかもしれない。真夜中にシステムがアラートを上げたとき、誰かが見ているのか、保全の時間枠はあるのか、予備部品は手元にあるのか。いずれかの答えが不明確なら、最も緊急のギャップはアルゴリズムではなく保全組織そのものである。逆に、組織が警告を受け取れるなら、数日から二週間の時間枠で十分に、突発事象を計画に変えることができる。
Dr. Chen(サプライチェーン研究者)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。