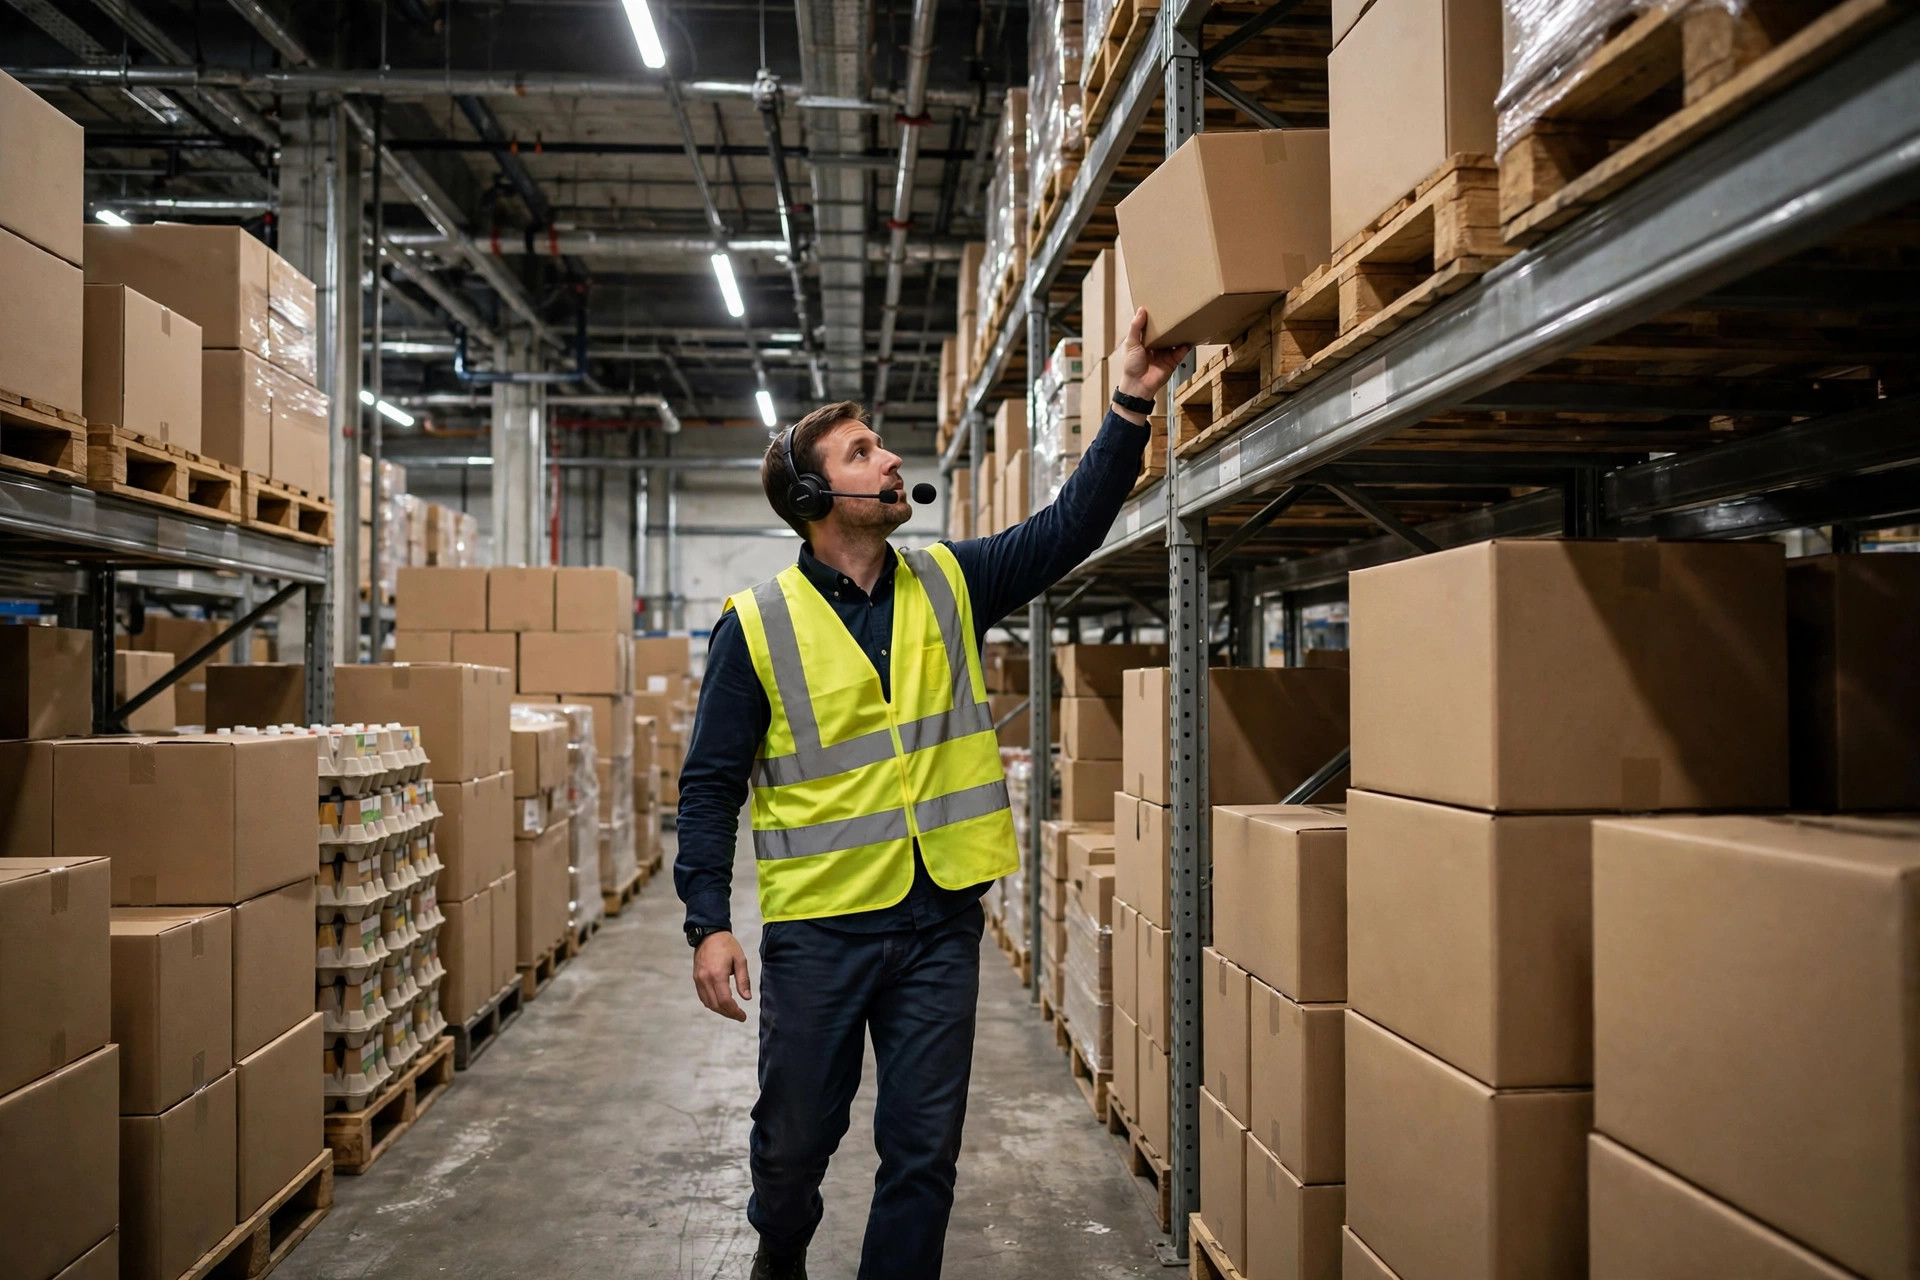
ボイスピッキングについて言いにくい真実を話しましょう。現場の声を何度も聞き間違えるとき、ハードウェアに罪があるのは十回中せいぜい二回。技術は成熟しました。ほぼ毎回失敗するのは、誰もチューニングしなかった三つのうちのどれか——騒音、アクセント、確認の語彙です。
米国のあるディストリビューターは、ボイスを本番導入した後の数値を業界誌で公表しました。ピッキングエラーは65%減、精度は99.73%から99.9%に向上。言い回しに注目してください——「ハードウェアを導入した後」ではなく「本番導入した後」です。同じ機材でも、プロセスがチューニングされていなければ、一日中人の声を聞き間違え続けます。
つまりこの記事はハードウェアの選び方ではありません。誤認識を下げるチェックリスト——そしてボイスをそもそも導入すべきでない倉庫はどれか、という結論をお届けします。
まずは騒音計、サービスチケットは後回し
ボイスピッキングが恐れるのは「うるさい」ではありません。恐れるのは、連続的でリズミカルな大音量——コンベアのローラー、屋根の換気扇、フォークリフトの後退警報です。人間の耳には背景音として消えていきますが、マイクにとっては干渉です。OSHAは労働者の8時間騒音曝露限度を90 dBAと定めており、私もその数値のすぐそばをうろうろしているコンベアラインを何度も測定してきました。ノイズキャンセリング付きブームマイクにも限界があり、その限界を超えればどんなヘッドセットも助けてくれません。
現場のチェックリストは短いものです。
第一に、本番導入の前に騒音計を持ってピックゾーンを歩きましょう。特に三カ所を測定します。コンベアのカーブ、大型換気扇の下、ドックの扉です。長時間にわたって85 dBAを超えている場所は、将来の誤認識ホットスポットです。この85は規制ではなく私自身の実務上の閾値——規制は90ですが、90まで待ってから動いたのでは手遅れです。
第二に、口角に位置する指向性ブームマイクを必ず使いましょう。汎用ヘッドセットでケチった倉庫——マイクが口から数センチ浮き、周囲の騒音が音声チャネルにそのまま混入——は、初日に認識精度が一段丸ごと落ちます。
第三に、ホットスポットに手動確認ステップを追加します。システムがロケーションを読み上げたら、ピッカーがチェックデジットを発声し、ロケーションのバーコードをスキャンする。一秒余計にかかるだけで、そのゾーンの誤認識はほぼゼロに落ちます。このトレードオフは計算済みです。一つの誤ピックをやり直すコストで、何千回ものバーコードスキャンが賄えます。比較になりません。
アクセントの問題は実は語彙の問題
米国の倉庫の現場は、スペイン語系のアクセント、東南アジア系のアクセント、半ダースもの地域のアメリカンアクセントが日常的に混ざっています。初期の音声システムは全員に個人の音声テンプレートを録音させました——風邪をひいた日も調子の悪い日も、精度は崩壊しました。現代の話者非依存認識はテンプレート不要ですが、アクセント問題は消えませんでした。形を変えたのです。「この人を認識できない」から「特定の単語を区別できない」へ。
いつも問題になるのは数字です。Fifteenとfifty、thirteenとthirty——強いアクセントでは、システムは聞き分けられません。騒がしい通路で、ピッカーに確認として数字の発声を求めるプロセスは、誤認識に装填済みの銃を渡しているようなものです。
対策は二つ。第一に、確認に数字だけを使わない。単語と数字を混ぜる——「1-3」ではなく「Alfa-3」。単語は音節が多く音響的特徴も多いので、システムの認識が良くなり、人の言い間違いも減ります。第二に、本番導入の最初の週に、各ピッカーが最も誤認識された単語をエクスポートし、システムの同音異義語辞書に一つずつ追加する。地道な作業です。半年は効きます。
数字を単語に置き換える:ここ数年で見た最大の効果
古典的な仕組みはチェックデジットです。各スロットに掲示された二桁または三桁のコードを、ピッカーが到着時に声に出して読み上げ、システムがピックを解放する前に照合する。仕組み自体は健全です。弱点は発声——数字は短く音節が少なく、騒音とアクセントの下で最初に壊れるのがそこです。
ここ数年で見た最も効果的な変更は、数字のチェックデジットを単語のチェックコードに置き換えることです。方法はシンプルです。高速ピックゾーンの各スロットに、互いにできるだけ違って聞こえるよう選んだ短い確認ワードを割り当てます——NATOフォネティックコード方式を思い浮かべてください。Alfa、Bravo、Charlie。ピッカーは数字ではなく単語を発声します。
効果はシンプルなトレードオフから来ます。単語は発声に0.5秒余計にかかりますが、聞き間違えられる確率は数字の羅列よりはるかに低い。ある3PLのオペレーションマネージャーは、切り替え後にチェック工程でのやり直し依頼がほぼ半減したと話してくれました。コストは、スロットと単語の対応表を維持し、スロッティングが変わるたびに更新すること。私の結論はこうです。一日に数千ラインをピックする倉庫なら、維持コストは取るに足らないほど割に合います。数百ラインの低速倉庫なら、手を出さないことです。
もう一つ小さなコツ。日常会話で使う単語は確認ワードに絶対に使わない。「OK」「yes」「got it」——一日中カジュアルに発声され、誤検出を引き起こします。倉庫の現場で誰も言わない専用ワードを使いましょう。
ボイスを導入すべきでない三つの倉庫
最終結論。ボイスピッキングは万能薬ではなく、無理に導入して授業料を払った三つのタイプの倉庫を私は見てきました。
低密度の倉庫。一日数百ラインのピック、ピッカーの大半の時間は歩行——「紙を見なくて済む」節約効果は一オーダーあたりゼロに希薄化し、ハードウェアと導入コストは決して回収できません。
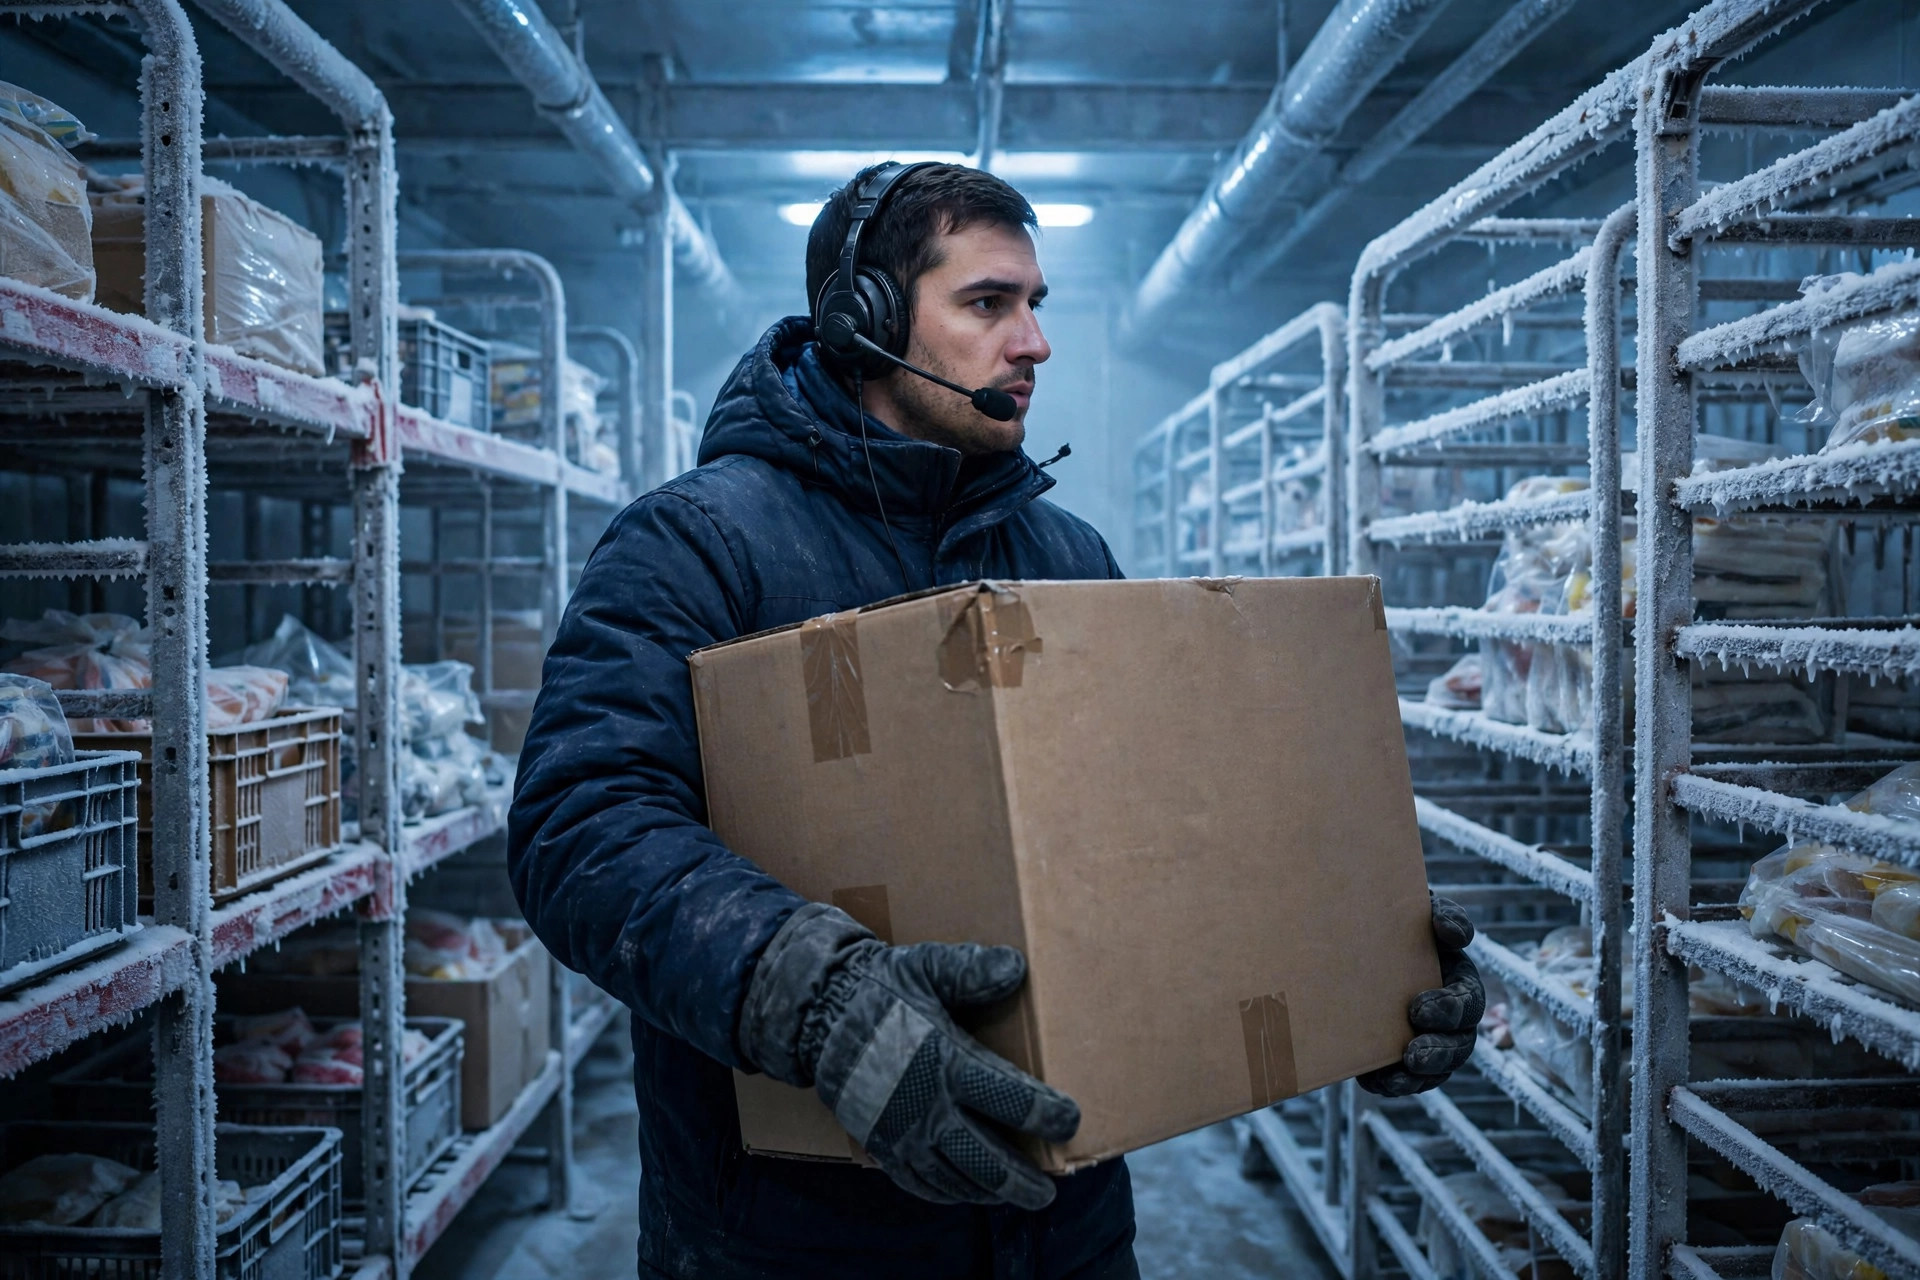
解決できない騒音問題を抱えた倉庫。冷凍倉庫の換気扇、終日稼働する大型コンベア、ヘッドセットがキャンセルできる水準を恒常的に上回る測定騒音——ボイスは一日中聞き間違えます。スキャナーを使いましょう。まず騒音を直して、ボイスの話はその後です。
厳格な検証を求める精密倉庫。高額商品、一対一のシリアル追跡——20桁のシリアル番号をヘッドセットに向かって発声させるのは惨事です。そこでの答えはスキャンのみ。ボイスは候補にすら入りません。
ボイスピッキングが真に輝くのは、ライン数が多く、標準SKU、騒音管理された食品・食料品の物流です。そこでは精度を99.9%超えまで押し上げられます。ただし三つを済ませた後に限ります。騒音を測定し、アクセントに適応し、確認ワードを設計する。この三つを飛ばせば、どんなに高額なハードウェアも置物です。
最後に皆さんへの問いかけです。皆さんの倉庫の誤認識のうち、システムが本当に「聞き間違えた」のは何件で、人がどう話すべきかを誰も設計しなかったのが何件でしょうか。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。