2023年、私は返品倉庫と仕事をしました。検品ラインに損傷した段ボール箱を検出する画像認識システムを導入したいという案件です。計算は単純でした。顧客に損傷した箱を1箱送ってしまえば、クレームと返品輸送費が発生します。それは産業用カメラ数台分に相当する金額です。プロジェクトはすべての審査を通過しましたが、誰も想定していなかった壁で停滞しました。アルゴリズムではありません。カメラの仕様でもありません。学習データを集められなかったのです。
数か月待った末、集まったのは損傷した箱の実写写真が数十枚。それもほぼ同じものばかりでした。同じつぶれた角、同じ2台のコンベヤ、同じ天井の照明。それでもモデルを学習させました。稼働開始後の最初の1週間、モデルは良品の段ボール箱を損傷品として誤検出し、誤アラームが積み上がって、最終的にオペレーターがアラートをオフにしました。このプロジェクトから学んだルールを今も使っています。画像認識プロジェクトの初日には、カメラを選ぶ前にデータの出どころを確認しろ、というものです。
なぜ欠陥は撮影させてくれないのか
まず、不都合な真実から始めましょう。損傷、液漏れ、ラベルの貼り間違い、浮いたテープ。これらは、きちんと運営されている倉庫では設計上まれなイベントです。大規模な検品ラインは1日に数万個の貨物を流しながら、損傷率を1%未満の低い水準に抑えています。「損傷」の写真を数千枚集めようと思ったら、コンベヤの横に数か月張り付く必要があります。しかも、収集中に季節が変わったり、天井の照明を交換したり、段ボールの仕入先を変えたりすれば、データ分布がずれてしまいます。
ようやく写真が集まっても、アノテーションは底なし沼です。損傷に正解はありません。角がどれだけつぶれたら損傷と数えるのか。2ミリ浮いたテープは対象になるのか。3人のアノテーターが同じ画像を3通りにアノテーションするでしょう。さらに、実写データ収集の静かな殺し屋がいます。シーンの網羅性です。照明、カメラアングル、ベルト速度、段ボールの古さ。組み合わせは無限にあります。あなたの写真が語るのはいつも「このステーションの、先四半期」であり、モデルは稼働した瞬間にホームシックになるでしょう。
実写データセットがようやく十分な大きさになった頃には、プロジェクトの期限は大抵過ぎています。これが倉庫画像認識のデスループです。モデルを最も必要としている現場ほど、データを生み出せないのです。
データを製造する3つの方法
実在の欠陥がこちらに来てくれないなら、自分で作りましょう。実際に機能する手法は3つあり、それぞれに個性があります。
1つ目は3Dシミュレーションのレンダリングです。段ボール箱を3Dでモデリングし、へこみの深さ、破れの位置、汚れのパターンをスクリプトで制御して、カメラ位置、照明、背景を自由にランダム化します。レンダリングした画像にはすべて無料のアノテーションが付いてきます。レンダラーは神の視点からシーンを見ているため、バウンディングボックス、セグメンテーションマスク、デプスマップがシーングラフからそのまま、ラベリングコストゼロで出てきます。ツールは成熟しています。ドイツ航空宇宙センターDLRのDenningerらが2019年にオープンソース化したBlenderProc(arXiv:1911.01911)。フォトリアルなレンダリングがsim-to-realギャップを縮めるという考えに基づいています。NVIDIAのOmniverse Replicator。その目的は、外観検査やロボティクス向けにラベル付き合成データを大規模に生成することです。そしてUnityのPerceptionパッケージ。正解アノテーション付きの合成データセットを生成するために特別に設計されています。
2つ目の手法はドメインランダム化で、そのロジックは逆向きです。リアリズムを追うのではなく、カオスを追うのです。2017年のTobinらの先駆的論文(arXiv:1703.06907)は、テクスチャ、照明、カメラ位置をあまりに激しくランダム化したため、現実世界が「また別のランダムなバリエーション」に見えるようになりました。彼らのモデルは実シーン内の物体を1.5センチメートルの精度で位置特定しました。現場での私の見解はこうです。背景が固定されたコンベヤシーンはこのトリックに最適です。シミュレーションをリアルに見せる必要はなく、多様に見せる必要があるからです。
3つ目のルートは生成モデルです。手持ちの数十枚の実写損傷写真をGANや拡散モデルに与え、さらに多くのバリエーションを夢に見させます。これには懐疑的です。生成モデルは完全な自信で幻覚を見て、物理法則に反する損傷パターンを発明します。そんな幻想で学習したモデルは偽の特徴を学び、結局本番で失敗します。私の結論はこうです。生成モデルはデータ拡張の脇役としては有効です。輝度シフト、背景差し替えなど。でも、ゼロから新しい欠陥カテゴリを発明させるのはやめましょう。
シミュレーションは万能薬ではない
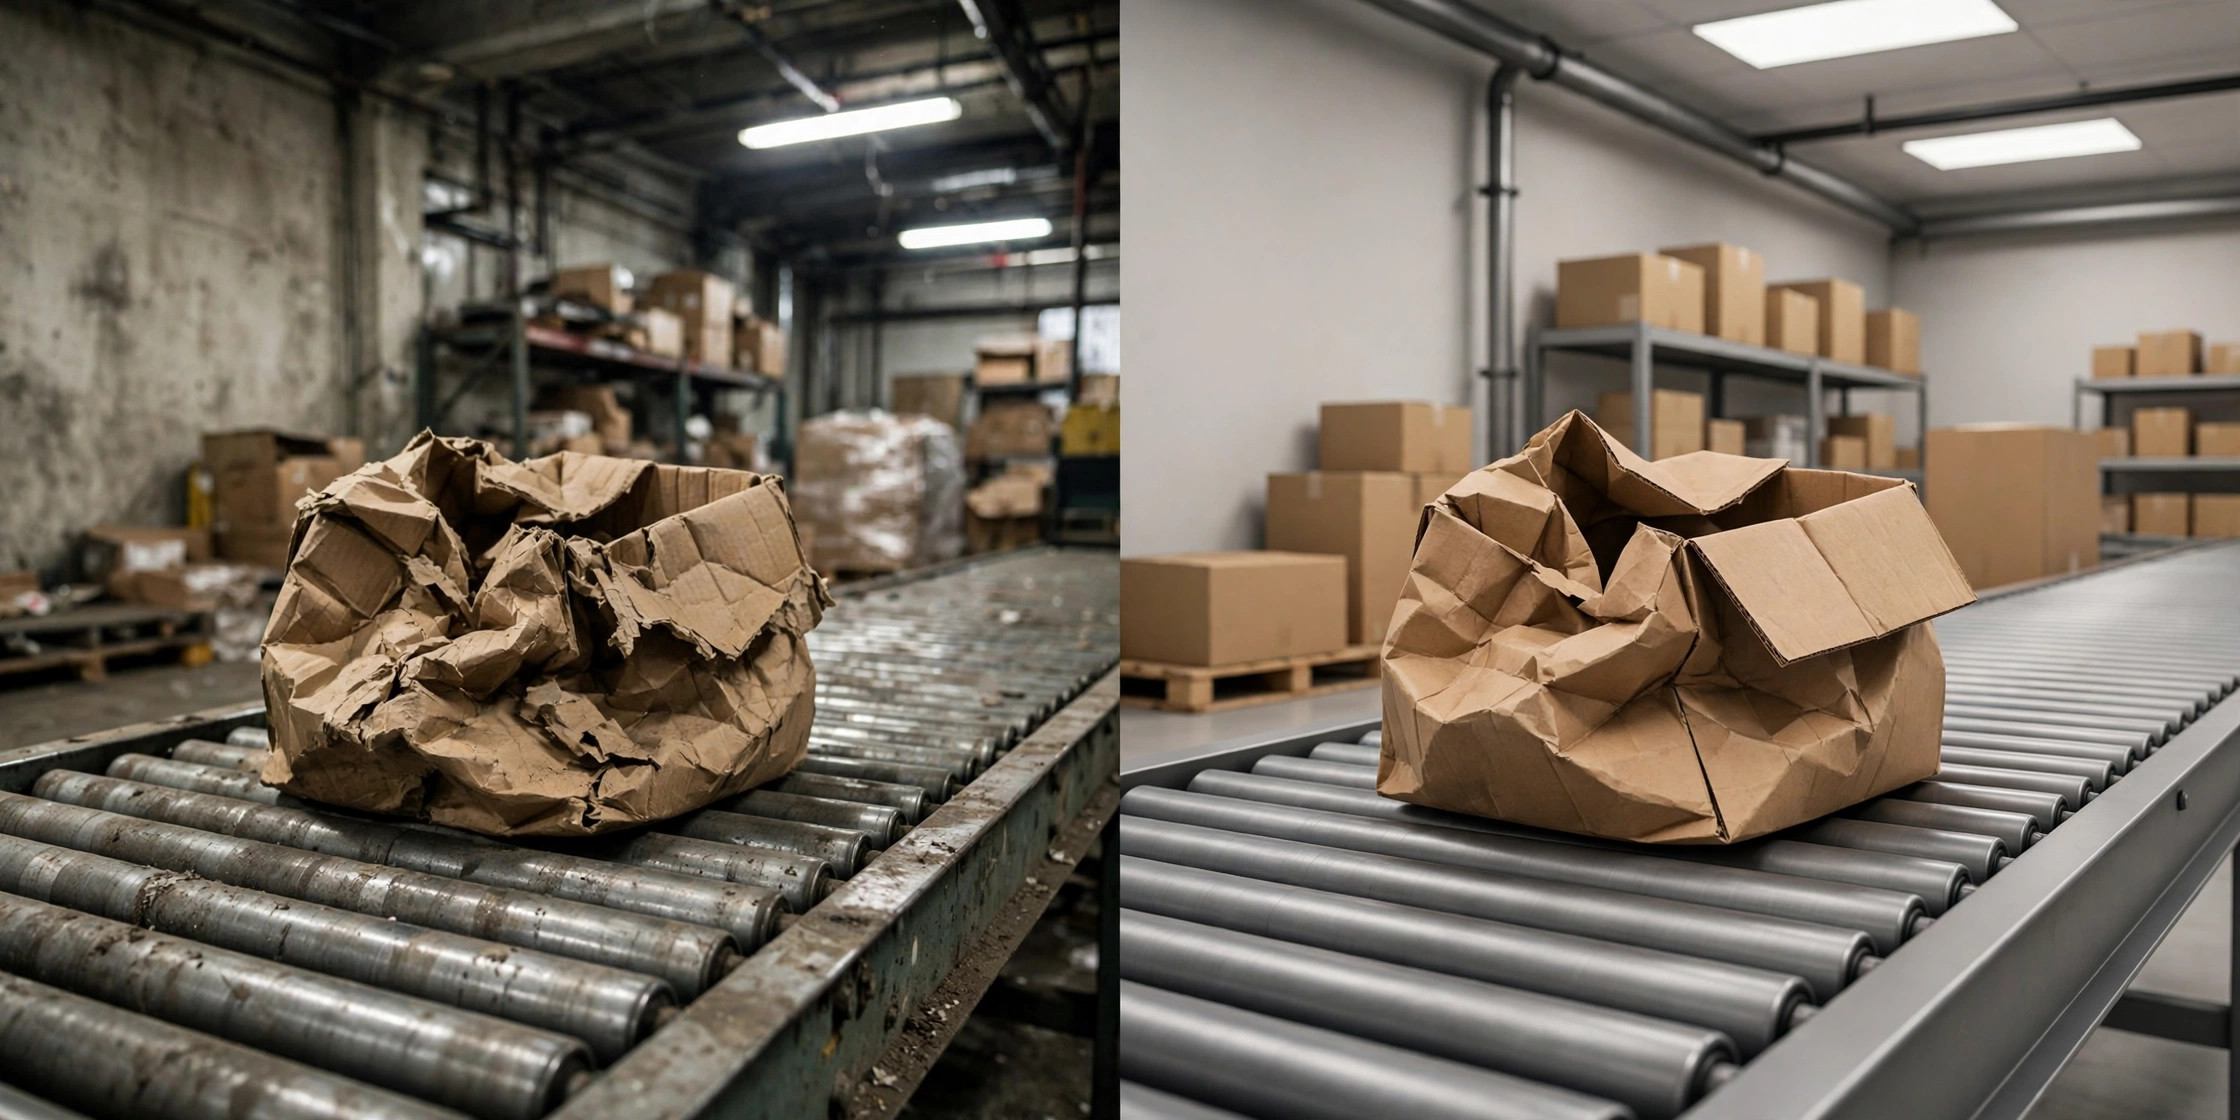
上の画像を見てください。倉庫で撮影された損傷した段ボール箱の実写と、その3Dレンダリングの双子です。あなたの目にギャップが見えるなら、モデルはその10倍強く感じています。
sim-to-realギャップは実在します。レンダリングされた照明がどれほど説得力を持っていても、シミュレーションはセンサーノイズ、レンズの歪み、フルスピードで走るベルトのモーションブラーを日常的に省略します。もっとずるい罠があります。合成の欠陥はきれいすぎて、教科書的すぎるのです。一方、実在の損傷は汚く、ランダムで、理不尽です。きれいなデータで学習した決定境界は、現実世界の泥に触れた瞬間に崩壊します。
修正は一言で言えます。ハイブリッドです。欠陥の形を十分に見せるため、合成データで学習してカバレッジを確保する。決定境界を現実に引き戻すため、実データでキャリブレーションする。その後、ループを閉じます。本番の誤検出と見逃しを学習セットに継続的にフィードバックするのです。合成データはゼロから1へ、実データは「動く」から「良い」へ導きます。どちらも他方の代わりにはなりません。
合成データをスキップすべきとき
合成データは強力ですが、普通のカメラの方が速い仕事もあります。
欠陥を簡単に演出できる場合はシミュレーションをスキップしましょう。ラベルの貼り間違いがその例です。ラベルを一束印刷して貼れば、好きな角度と照明で午後のうちに数百枚撮影できます。3Dアーティストがシーン構築に費やす時間は、3回分のフル撮影セッションに相当します。
チームに3Dパイプラインを話せる人がいない場合もスキップしましょう。モデリング、マテリアル、ライティング、レンダリングパイプライン。どれも独立した職人技です。外注のモデリング見積もりは撮影+ラベリングのコストを日常的に上回り、2〜3回の修正ラウンドを経てプロジェクトは死にます。
最後に、コスト計算をしましょう。実写データ収集は線形コストです。写真が1枚増えれば、アノテーションが1つ増え、1ドル増えます。シミュレーションは固定コストです。高いのはシーン構築の部分で、その後の追加画像はほぼタダです。判断ルールは明確です。必要な量が多く、欠陥がまれなほど、合成データが勝ちます。量が少なく、演出が簡単なら、カメラを手に取って撮りましょう。
明日の朝のためのチェックリスト
明日から倉庫の画像認識プロジェクトを始めるなら、次の手順を順番に、スキップせずに行いましょう。
- まずサンプルを数える。検出すべき欠陥クラスをすべて列挙し、各クラスについて手持ちの実写写真を数える。検証セットを満たせないクラスはすべて「合成データ必須」の列に直行させる。
- まずカメラを設置する。最終的な設置位置に取り付け、1週間稼働させる。実データの流れを今のうちに蓄える。それは後でキャリブレーションに使う資本だ。
- まずツールを動かす。GPU搭載マシンを用意し、BlenderProcの公式サンプルをエンドツーエンドで実行して、自己アノテーション付き画像の最初のバッチをレンダリングする。これが動かせないなら、独自のシミュレーションパイプラインを構築する準備はできていない。
- まず比較実験をする。合成データで事前学習+実データでファインチューニングした小さなモデルと、実データだけで学習したモデルを1つずつ作る。誤検出率と見逃し率を比較し、数字に決めさせる。
- スケールの話は最後にする。比較実験で合成データが勝てば、フルサイズのシミュレーションシーンに投資する。負ければ、撮影に戻り、ツールと戦わない。
私の結論は率直です。合成データは万能薬ではありませんが、倉庫画像認識で最も過小評価されているレバーです。うまく使えば「データを待つ時間」を数か月から数週間に圧縮します。下手に使えば、高価なおもちゃです。両者を分けるのはテクノロジーへの信仰ではなく、あなたの机の上にある比較実験なのです。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。