昨年、カリフォルニアのInland Empireにある倉庫のマネージャーが話してくれた話が、何度も頭を離れない。彼のチームは3か月かけて1万枚以上のSKU画像を撮影・ラベリングし、ピッキング検証用のビジョンモデルを訓練した。本番稼働の最初の週は、精度は素晴らしく見えた。ところが季節の包装変更がやってきた——上位SKUのいくつかが、支配色の異なる新デザインになった——精度は崖から落ちた。結局そのモデルは、置き換えたはずの人手チェックより悪かった。プロジェクトチームの顔と言ったらなかった。
これは単発の話ではない。倉庫が独自のビジョンモデルを訓練しようとすると、失敗の原因はほぼ間違いなくアルゴリズムではない——オープンソースのモデルは豊富にあり、品質も大差ない。失敗の原因はデータだ:写真は何枚、どう撮り、どうラベル付けしたか。その話を分解してみよう。
必要なのは写真の枚数ではなく、バリエーションの多さだ
本能的には量を積み上げたくなる:1万枚撮れば足りるはずだ。半分正解。
モデルが苦しむのは「少なすぎ」ではない。「偏りすぎ」だ。同じステーション、同じカメラ、午前10時の同じ照明で撮った1万枚は、モデルに1つのことしか教えないし、10万枚目の写真も同じことをもう一度教えるだけだ。データが足りるかどうかを実際に決めるのは、どれだけの種類のバリエーションをカバーしているかだ。何か撮る前に、バリエーションのチェックリストを壁に貼ろう:
**照明。**倉庫の蛍光灯と、午後の遅い時間にドックの扉から斜めに差し込む太陽は、まったく違う色だ。同じSKUを午前と午後で撮る。色温度のずれた古い蛍光管も対象だ。
**角度。**検証ステーションの上のカメラは固定だが、段ボールはそうではない:横向き、縦向き、逆さま、フレームから半分はみ出す。演出したポーズだけ撮るな——フォークリフトのドライバーが実際に箱を落とす様子を撮るんだ。
**背景。**コンベヤベルト、パレットの隙間、床の反射——背景が雑然としているほど、モデルはそれを無視することを学ばなければならなくなる。1つのステーションに固執せず、2〜3か所のステーションを使い回せ。
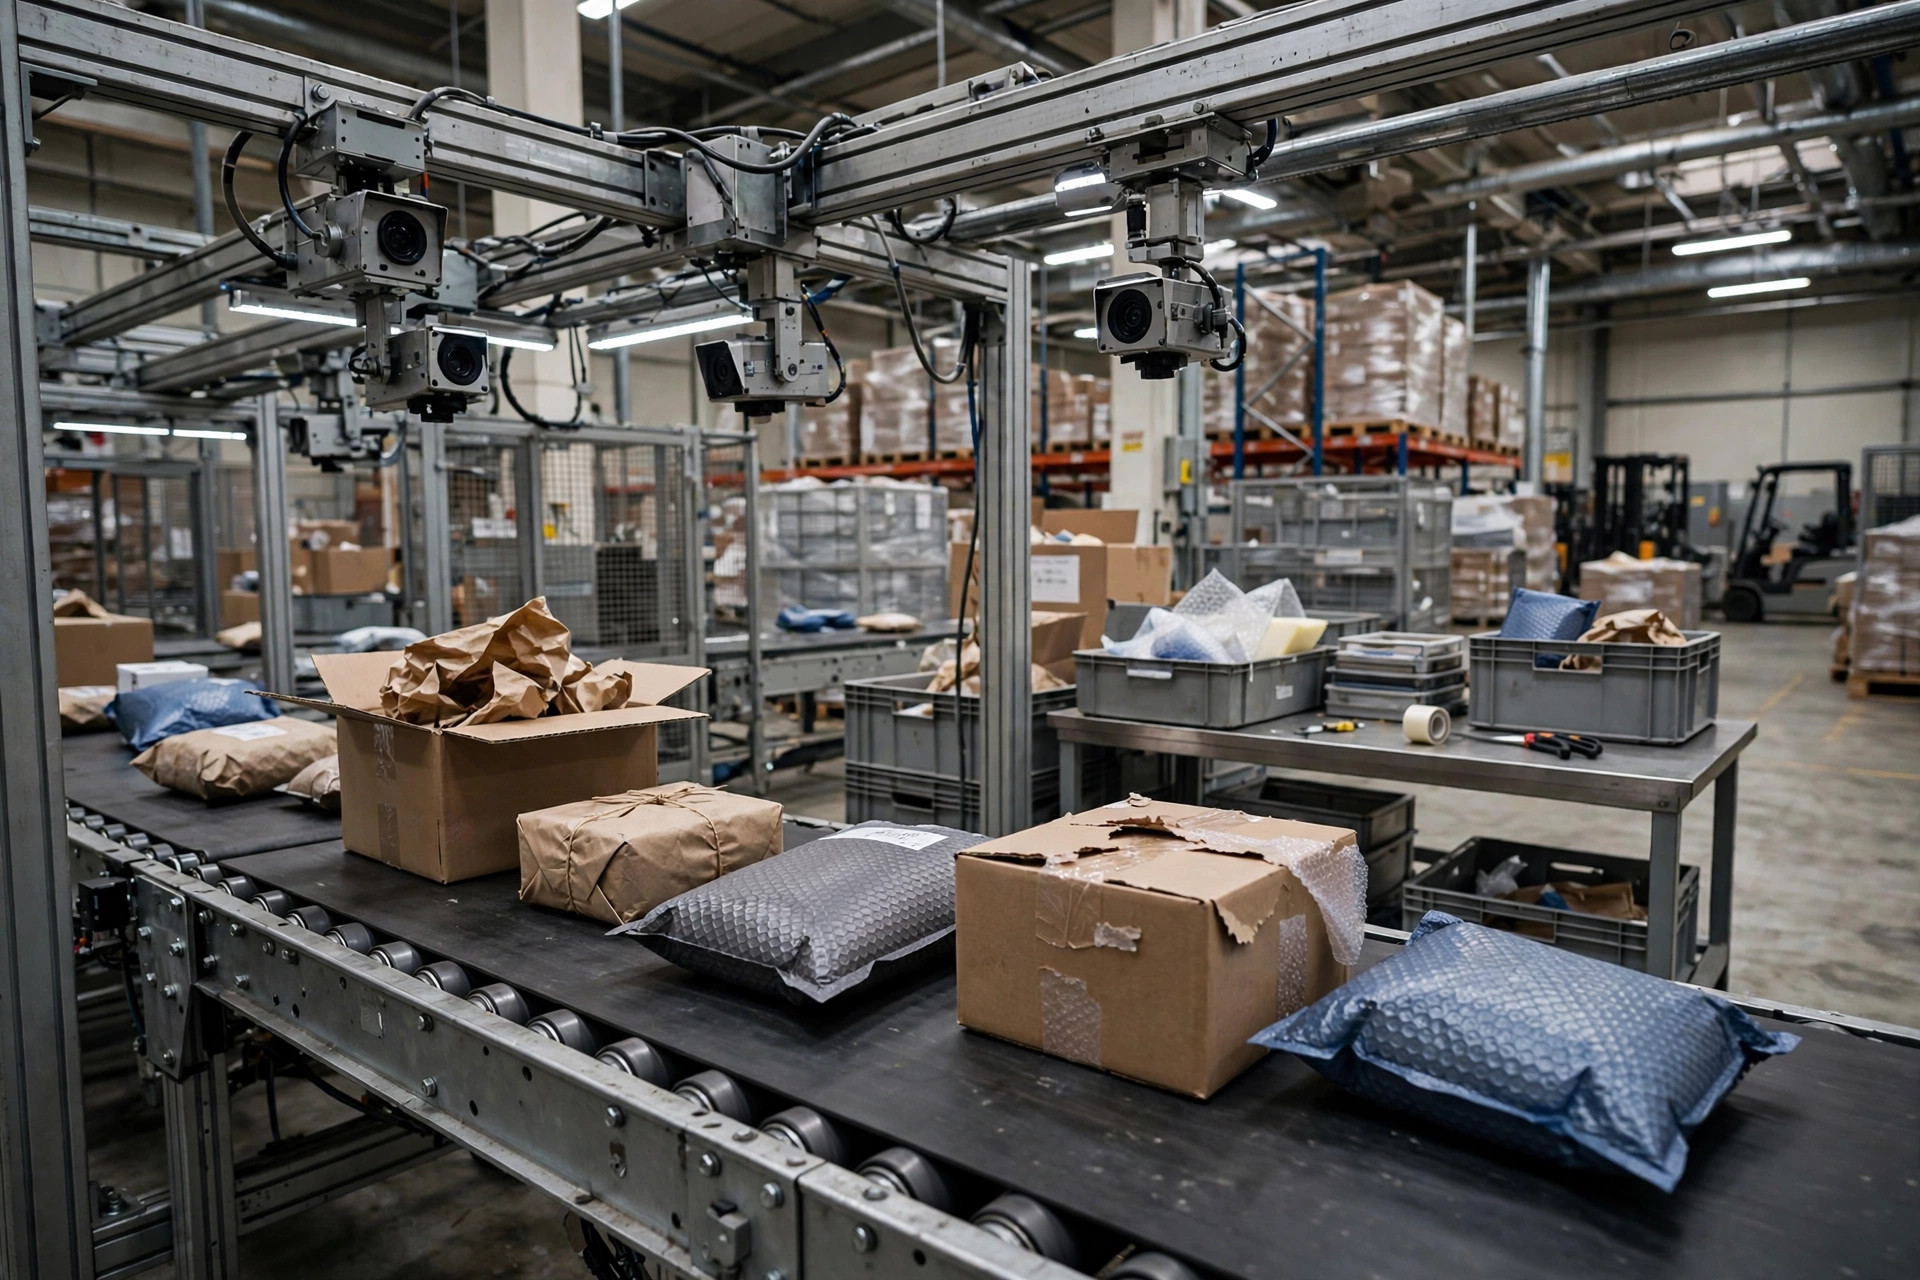
**包装の状態。**ここで精度は死ぬ。潰れた段ボール、水濡れ、ストレッチフィルムで半分包まれたもの、販促シールだらけのもの——それに毎シーズン届くリニューアル包装。先ほど話した卸業者は、訓練セットに新包装の例がゼロだった。モデルはそれを見たことがなく、当てずっぽうになった。
一巡撮って、カバーしたものにチェックを入れて、足りないものに戻る。このやり方が、やみくもに1万枚撮るより毎回勝つ。もう一つ:SKUを包装変更の頻度で層別にしよう。何年も見た目が変わらない工業部品は一度撮って放置でいい。年に数回パッケージが変わる食品や消費財は、データ収集を一回きりのプロジェクトではなく定期的な習慣にしなければならない。
ポリゴンではなく、ボックスから始めよう
二つ目の落とし穴はラベリングだ。「精度が高いほど良いに決まっている」とばかりに、多くのチームがいきなりインスタンスセグメンテーションに飛びつく。私のアドバイスはこうだ:まずバウンディングボックスのモデルを動かせ。
ボックスはラベリングが圧倒的に速い——訓練されたアノテーターなら午前中で数百枚こなせる(参考値)。ポリゴンを描くのは数倍の時間がかかり、一貫性を保つのも難しい。しかもボックスで倉庫の仕事のほとんどは足りる:SKUの識別、空箱検知、パレットが積載されているか、ベルト上の異物があるか。セグメンテーションが出番を得るのは、精密な計測が必要なとき(たとえば容積重量のための段ボール寸法の推定)か、オクルージョンがひどすぎてボックスではどうにも対象を囲めないときだけだ。
ラベルの質は量に勝る。その差は僅差どころではない。2人のアノテーターが何を「破損」とみなすかで意見が分かれる数百枚の画像は、モデルにノイズを教えるだけだ。ラベリング開始前に、半ページの仕様書を書く:「破損」とみなすもの、「正常」とみなすもの、半分以上隠れた対象をラベル付けするかどうか。次に、2人が同じ数十枚(参考)のバッチをラベル付けする。意見が分かれたところで仕様書を直す。大体一致するまでスケールさせない。
外注か内製か?フェーズ次第だ。ラベリングプラットフォーム(Labelbox、Roboflowなど)は量を一気に上げられるが、あなたのビジネスを知らない——「新包装デザイン」や「販促シール」が意味のある変化だとは気づかない。自社の人たちは手が遅いが、倉庫で暮らしているので異常には一目で気づく。私のやり方はこうだ:まず難しいケースの最初のバッチを内製でラベル付けして基準を決め、定型の量は外注し、10分の1以上(参考監査率)は監査する——1つのダメなバッチが全体を台無しにする。
スクラッチで訓練するな、ファインチューニングせよ——そして難しいケースを食わせ続けろ
結論はこうだ:ほとんどの倉庫はスクラッチでモデルを訓練する必要などない。
事前学習済みのオープンソースモデル——UltralyticsのYOLOファミリーは、COCOのような巨大データセットで事前学習済み——は、すでに数十万の日常的な物体を見てきた。あなたの仕事は、自社のSKUでファインチューニングして、あなたの包装を覚えさせることだ。ファインチューニングに必要なデータは、スクラッチからの訓練とは別世界だ:通常、よくカバーされた写真が数百枚から数千枚あれば始められる(SKUによる差は大きい。自分のデータで試せ)。スクラッチからの訓練は研究室のスポーツだ。倉庫に必要ない。
精度目標も願望で決めるな。検証の役割では、モデルは人を助けるもので、人を置き換えるものではない。まともな目標はこんな感じだ:「人手検証の作業量を半分以上削減し、ミス率は今の人手ベースライン以下にする」(参考——自分の数字で決めろ)。魔法の「99%」を目指せば、終わりのないデータ収集ループに溺れる。
最も過小評価されているのが、本番開始後の話だ。新SKUが来る、旧SKUはリパッケージされる、販促シールが貼られる——訓練セットが見たことのないロングテール、そこでモデルは盲目になる。対処法は、より大きなデータセットではなくループだ:本番稼働後、モデルが間違えた・自信のなかった写真を自動で回収し、人間が確認し、確定した難しいケースを訓練セットに戻して、スケジュールで再訓練する。頻度はSKUの変化速度次第だ:食品や動きの速い消費財なら月次、場合によっては隔週の再訓練が必要かもしれない。変化の遅い工業品は四半期でいい。要点はループを回し続けること——私の卸業者の友人に欠けていたのはまさにこのループだ。
そして正直な一言:ラベリングチームすらいないなら、自前で作る話はやめよう。市場にはステーション単位のビジョン検証サービスがある——まず1ステーション買って価値を証明し、それから作るか決めればいい。自前モデルの最大コストはGPUではなかった。人だ。
**明日からできること:**まだプロジェクトを始めるな。ピッキング検証ステーションを1つ選んで、午後の半日を使って上位SKUを各数十ショットずつ(参考)撮る——通常、側光、破損、積み重ねの条件で、合計数百枚。ラベリングプラットフォームに試しバッチとして送る。1週間本番で回して、実際のシフトでどう動くか見る。良ければ拡大の話をしよう。ダメなら問題がどこにあるか正確に分かる——そして10回中9回は写真の枚数不足ではなく、カバーしていないバリエーションの問題だ。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。