今回、私はエッジ派だ——ただし条件がある。AIを2種類に分けることだ。「道路を見張る」AIと「運勢を読む」AIである。
道路の見張りは1ミリ秒も待てない。運勢読みは1時間かかっても誰も死なない。その線こそがエッジとクラウドの分かれ目だ。この2年間、私は両方の側で倉庫がお金を燃やすのを見てきた。すべてをクラウドに押し込んで、ネットワークが一瞬つまずいただけでソートライン全体が停止するのを見守る倉庫。あるいは、1日に1回だけ動けばいいレポート用モデルを動かすために、初日からGPUサーバーを買ってしまう倉庫。
推論をどこにデプロイするかは、互いに競合する3つの要素に帰着する。レイテンシ、帯域幅、コストだ。ユースケースが最も敏感な要素が、推論の居場所を決める。
ミリ秒で測られるものはすべてエッジのもの
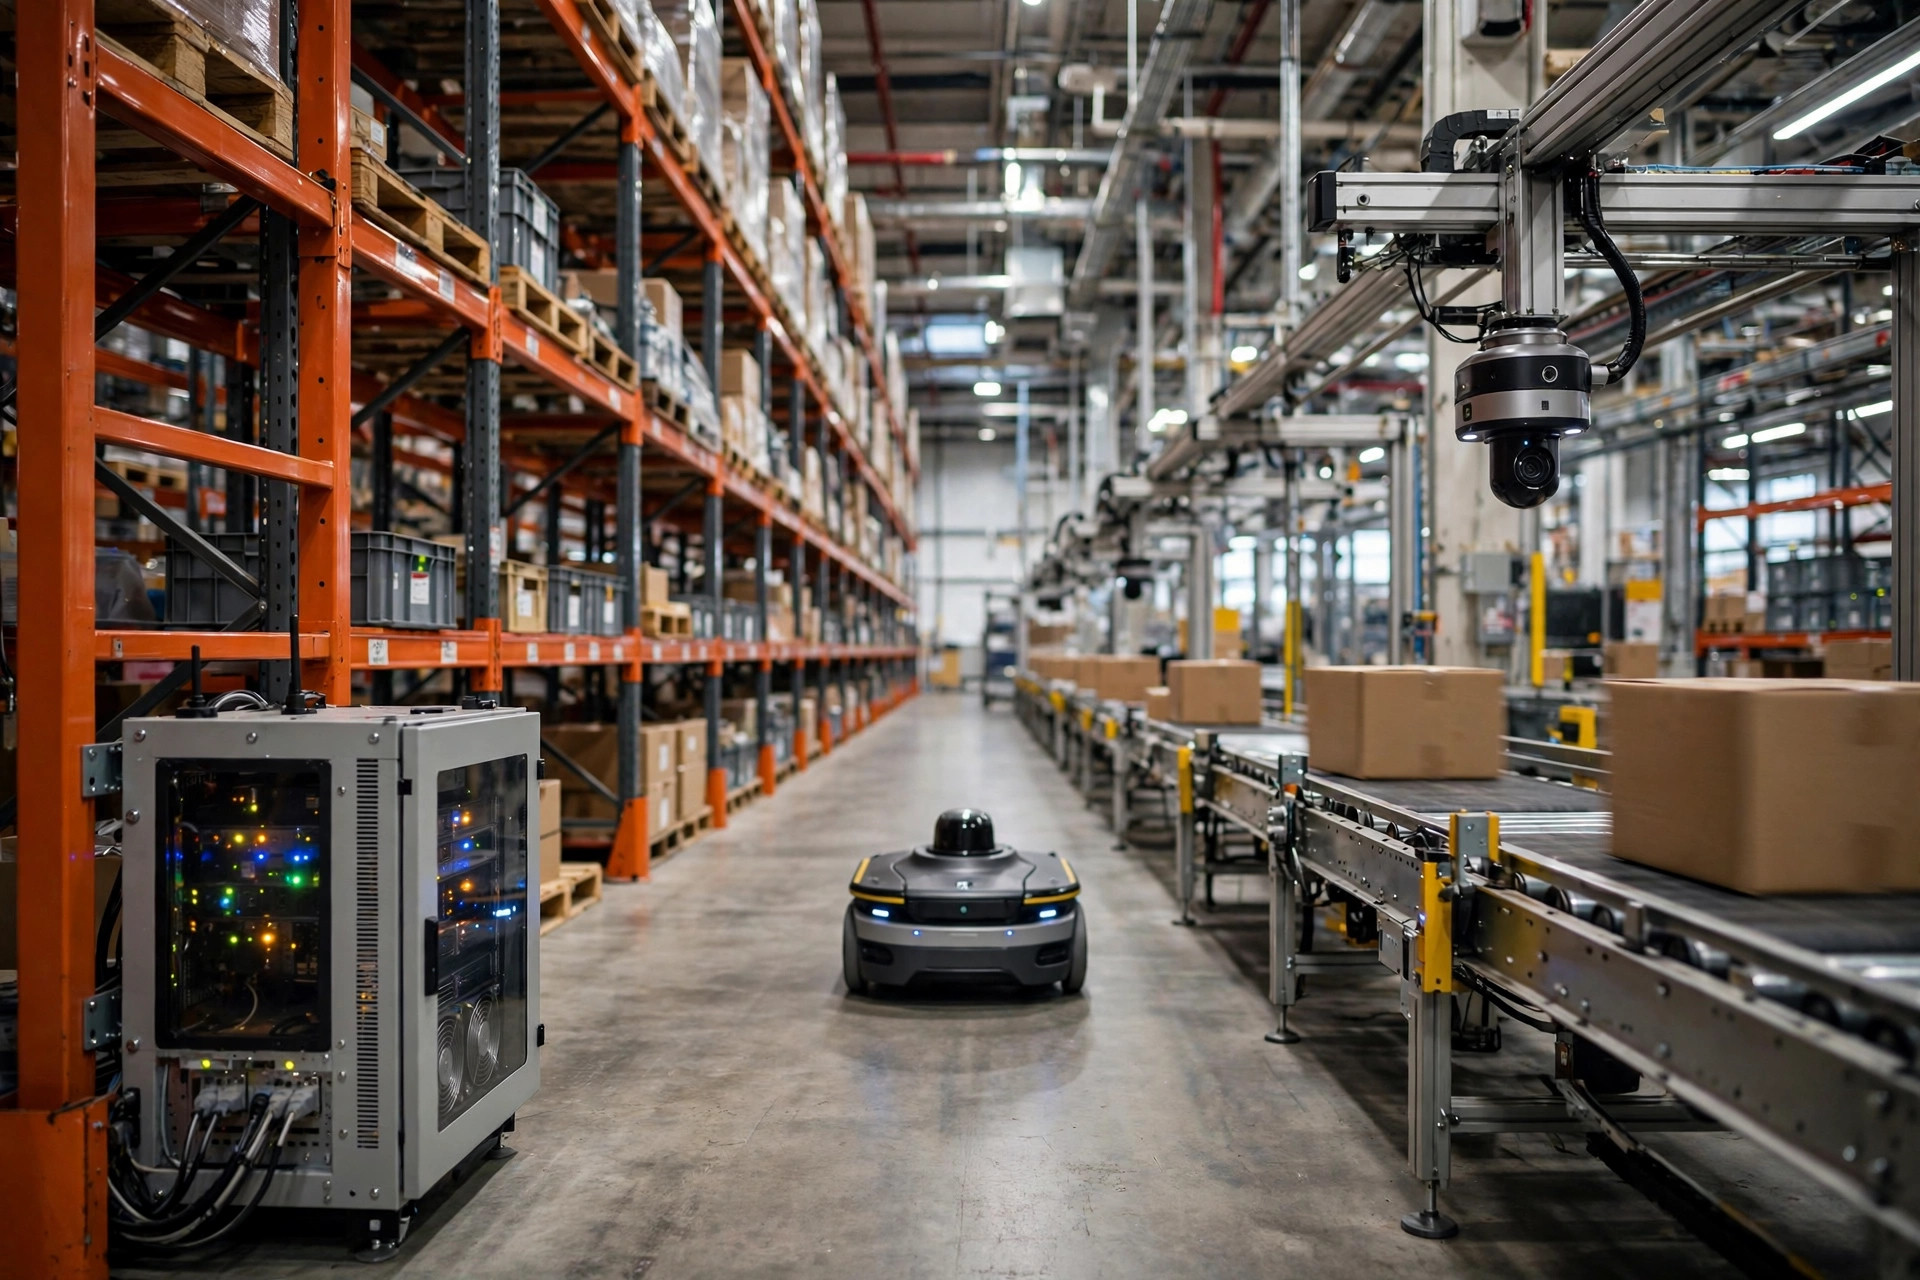
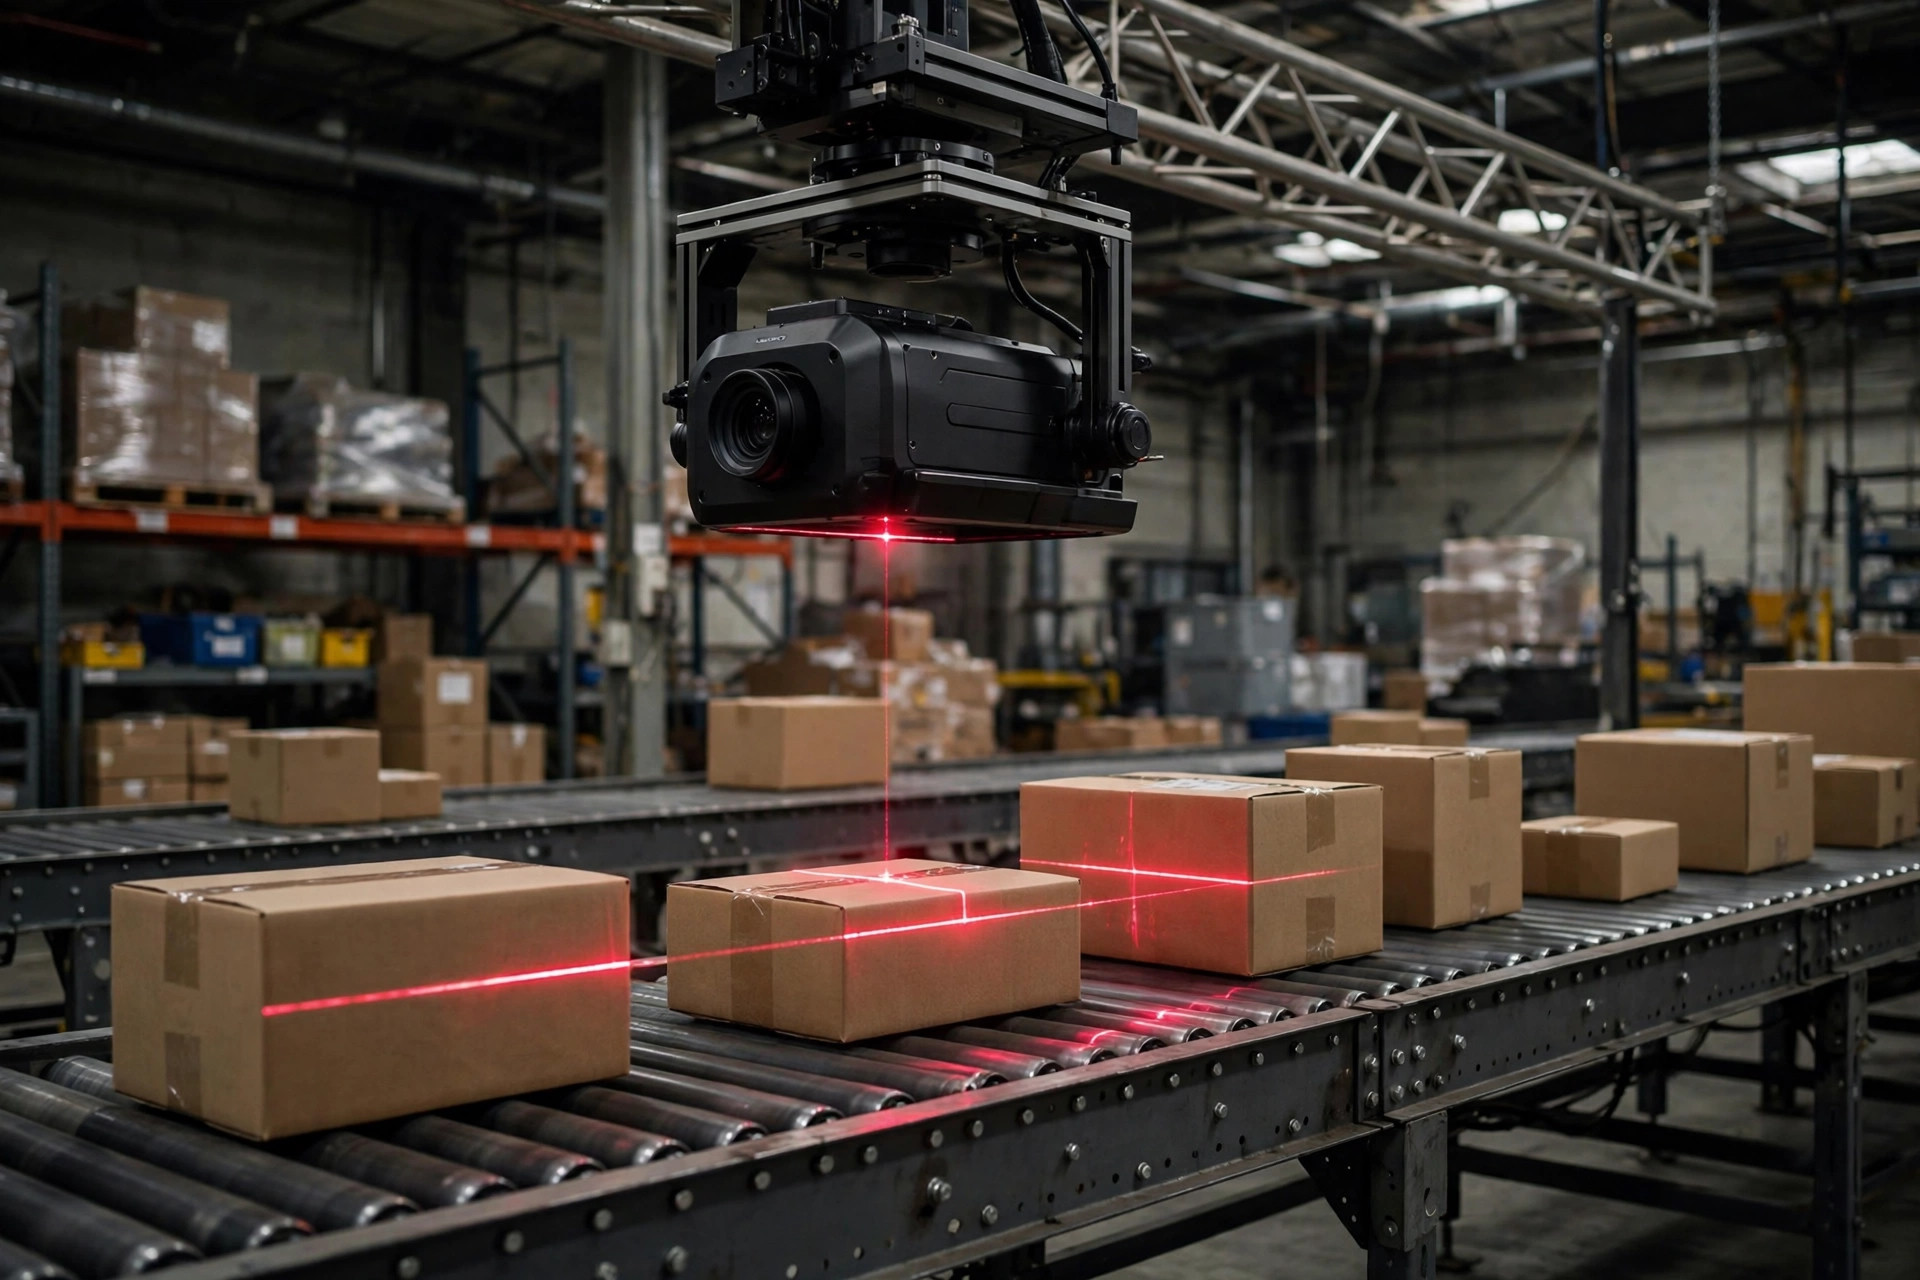
まず道路の見張りから:ビジョン検査、AMRの障害物回避、ロボットによるピックアンドプレース。共通点は、ミリ秒で測られる閉ループだ。ソートラインは1分間に100個を優に超える荷物を流す。箱がカメラの視野に入っているのは一瞬で、認識結果は数十ミリ秒で返ってこなければならない。クラウドまでの往復は軽く数百ミリ秒かかる——答えが届く頃には、箱は分岐点を過ぎてしまい、プッシャーアームの狙う先は何もない。
次に帯域幅の請求書だ。生画像を24時間ストリーミングするビジョンカメラ1台で、1日に数十ギガバイトが発生する。数ステーション分を掛け合わせれば、月額のアップリンク費用は誤差では済まなくなる。そして倉庫のネットワークはオフィスのネットワークとはまったく違う。Wi-Fiの死角、鉄製ラックに遮られる電波、ケーブルを日常的に噛み切るフォークリフト。この連鎖にリアルタイム推論を賭けるのは、ラインの稼働率を運に委ねるということだ。
逆の例を去年、カリフォルニア州オンタリオ(Ontario, California)の3PLで見た。そこのバーコードカメラはクラウドで認識を動かしていた。ある午後、ネットワークが不安定になり、ライン全体が手動の再スキャンに落ちた。メンテナンスのためのアクセスポイント交換が原因だった——わずか4時間で、スループットが3分の1近く落ちた。オーナーは後に、まったく真顔でこう言った。サーバー代で節約した1ドルは、すべて残業代に消えた、と。
AMRの障害物回避はさらに極端だ。車両が走行中、目の前に人が出てくる。ライダーとビジョンを融合した推論がローカルで完結し、数十ミリ秒でブレーキ指令を出さなければならない。その判断をクラウド待ちにしたら、車両はすでに人を通り過ぎている。真剣なAMRベンダーが回避モデルをすべて車載で動かすのはそのためだ——技術の好みではなく、物理の問題だ。
このカテゴリのルールは1行で言える。推論結果が物理的な動作を直接駆動するなら、エッジで動かす。「ネットワークが死んでもラインは止まらない」を受け入れ条件に入れること。
待てるものはクラウドの方が安い
もう一方は運勢読みだ。需要予測、補充提案、安全在庫の計算、月次の運営レポート。これらのモデルは1回動けば答えが1日か1週間有効だ——数分の遅れは何も変えない。ここでのクラウドの真の利点は安い計算資源ではない。計算資源を所有しなくて済むことだ。買うマシンなし、管理する熱なし、死んだ箱のために午前2時に電話を受けることもない。
クラウドの2つ目の利点は学習だ。学習は履歴データを食い尽くすが、倉庫の履歴はすでにクラウドにある。WMSのデータベース、受注履歴、労務記録。そこで学習して反復するのが自然だ。エッジデバイスの仕事はたった1つ。学習済みモデルをダウンロードして推論を実行し、スケジュールに従ってクラウドから新バージョンを受け取ること。
現場で機能しているのを私が見てきたハイブリッドアーキテクチャ——中小規模の倉庫なら誰にでも初期テンプレートとして渡したいもの——はこうだ。エッジはローカルキャッシュ付きでリアルタイム推論を行い、ネットワークが落ちても単独で動き続ける。クラウドは学習、モデルの配布、全体の分析を担う。分業を文書化して、どちらも相手の仕事を奪わせない。モデルの更新は段階的に出す。まず1ステーションに新バージョン、1週間クリーンに動作したら、フリート全体へ。「ワンクリック全倉庫アップグレード」は絶対にやらない——壊れたとき、倉庫全体が一緒に壊れる。
そして受け入れテストは物理的にやること。稼働日にネットワークケーブルを抜いて、何が起きるか見届ける。ラインが止まるなら、そのアーキテクチャは飾りだ。ベンダーのスライドがどんなにきれいでも。
小規模倉庫:GPUサーバーは飛ばして、産業用PCから始めよう
さてお金の話だ。「AI推論」と聞くと、数万ドルもするGPUサーバーラックを想像する人が多い。嫌われそうなことを言おう。小規模倉庫の10件中9件は、それを必要としていない。
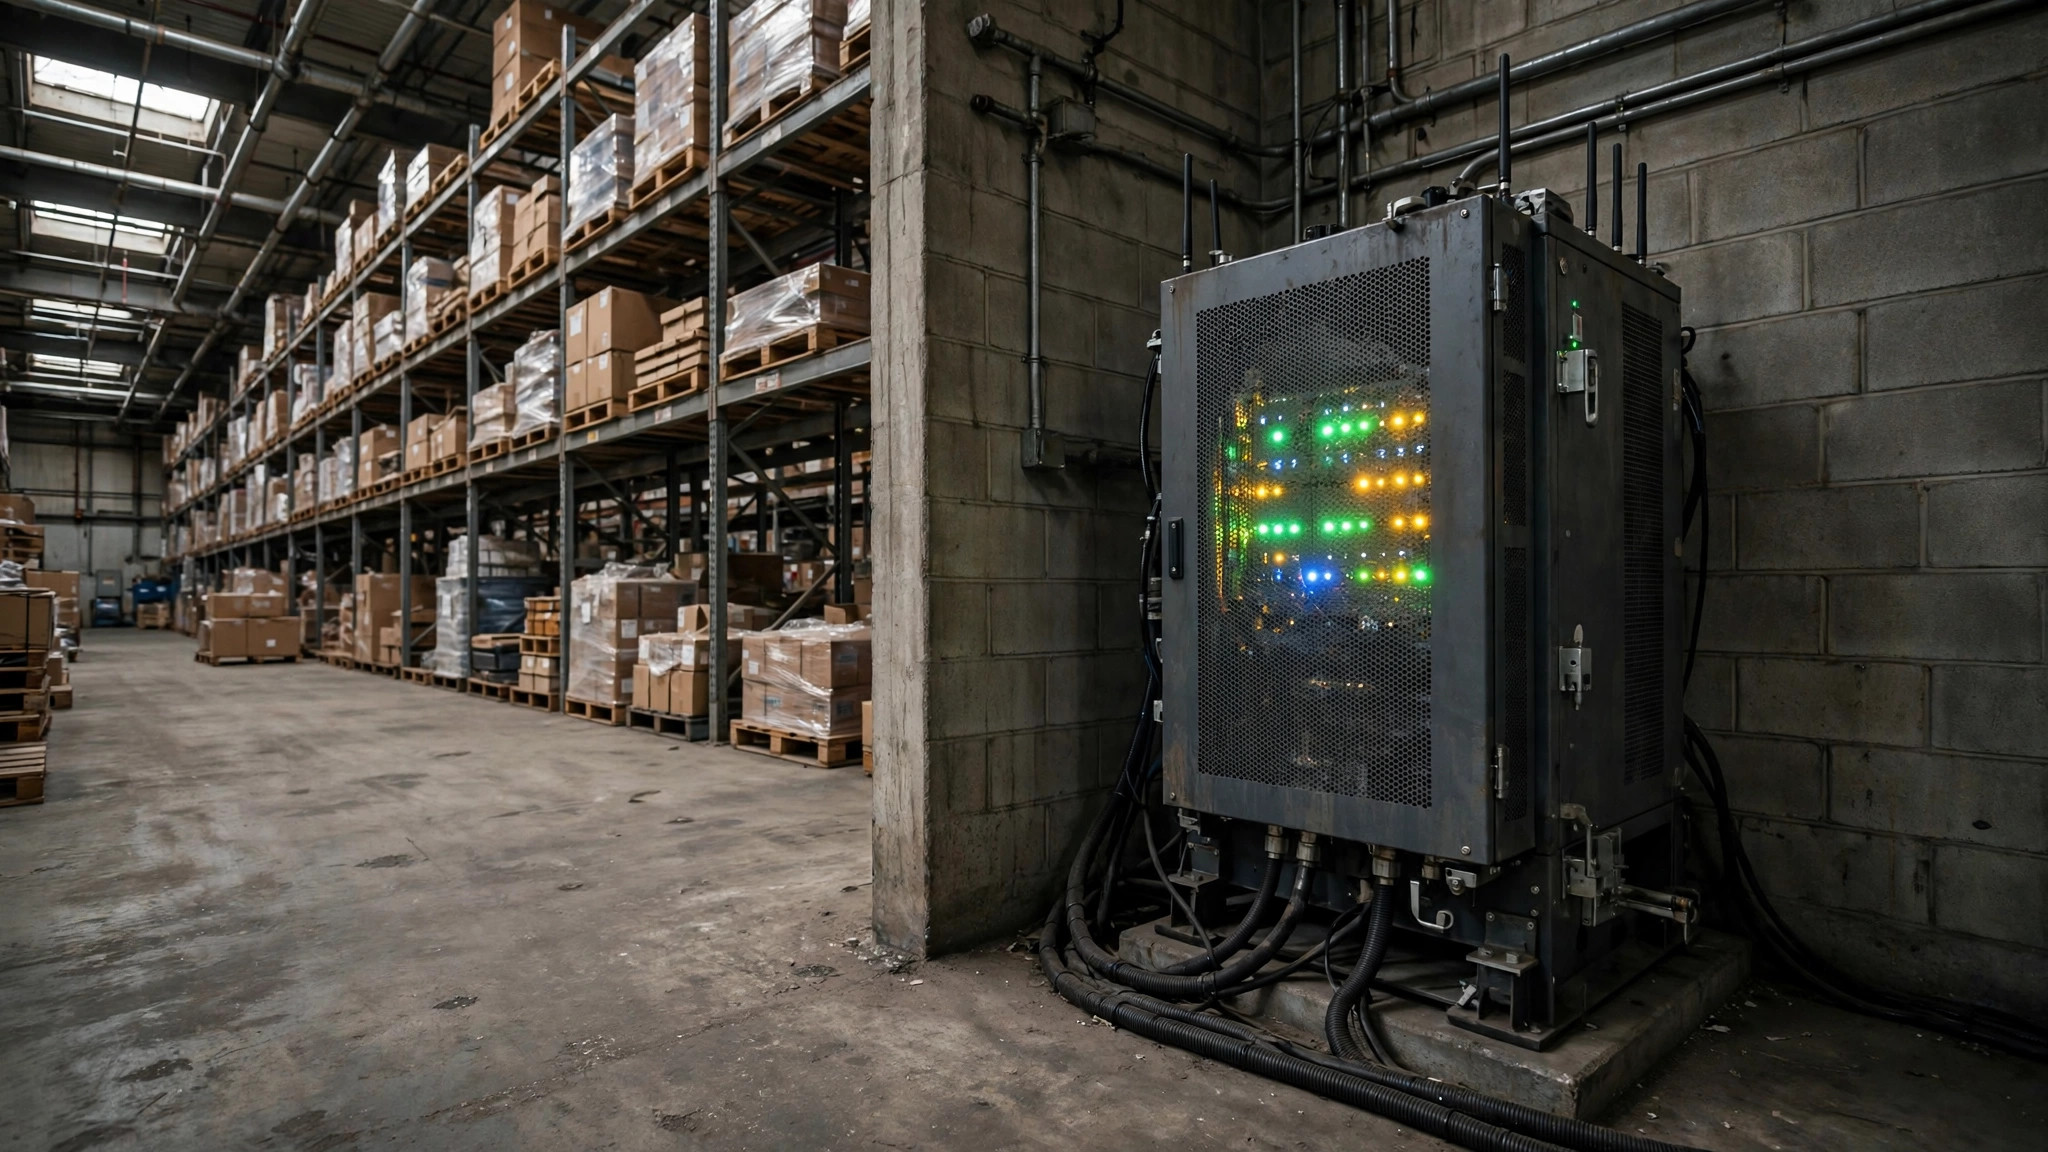
ビジョン検査ステーション1台なら、NVIDIAのJetson Orin Nanoクラスのエッジデバイスで余裕で動く——2023年に発売された8GB版、消費電力は数十ワット、電気盤の中に収まる。数千ドル台のGPU搭載産業用PCなら、2〜3ステーションをまかなえる。そこから始めよう。1〜2ステーションでROIを証明する——手動再検査の見逃し率を下げるか、ソートラインの減速停止をなくすか。計算が合ったら、次にステーションの拡張を、その次にサーバーの話をする。
常に見落とされる環境面の注意点が1つある。塵と熱だ。倉庫は夏に高温になり、塵はあらゆるところに入り込む。その環境に民生用ハードウェアを投げ込んだら、ピークシーズンを生き延びられない。エッジハードウェアを選ぶとき、広い動作温度範囲、ファンレス設計、防塵は必須条件だ——計算スペックだけで買い物をしないこと。産業用PCから始めることを勧めるもう1つの理由がこれだ。まさにこの環境のために作られている。
ではGPUサーバーは誰のためか。数十のステーションを同時に動かすオペレーション、あるいは自前でモデルを学習するチームだ。倉庫がまだそこまで行っていないのに買うということは、機械室の電気代を払い——ベンダーの営業コミッションを肩代わりすることだ。
私の結論はシンプルだ。まずユースケースを道路の見張りと運勢読みに分ける——前者はエッジ、後者はクラウド。ハードウェアは産業用PC1台から始めて、1ステーションを証明してから拡張する。次にAIベンダーが売り込みに来たら、3つ質問しよう。推論はどこで動くのか、ネットワークが死んだらラインは止まるのか、モデルの更新頻度はどれくらいか。この3つに答えられないなら、提案書は閉じて構わない。
英語版からの翻訳。内容に相違がある場合は英語版を優先します。