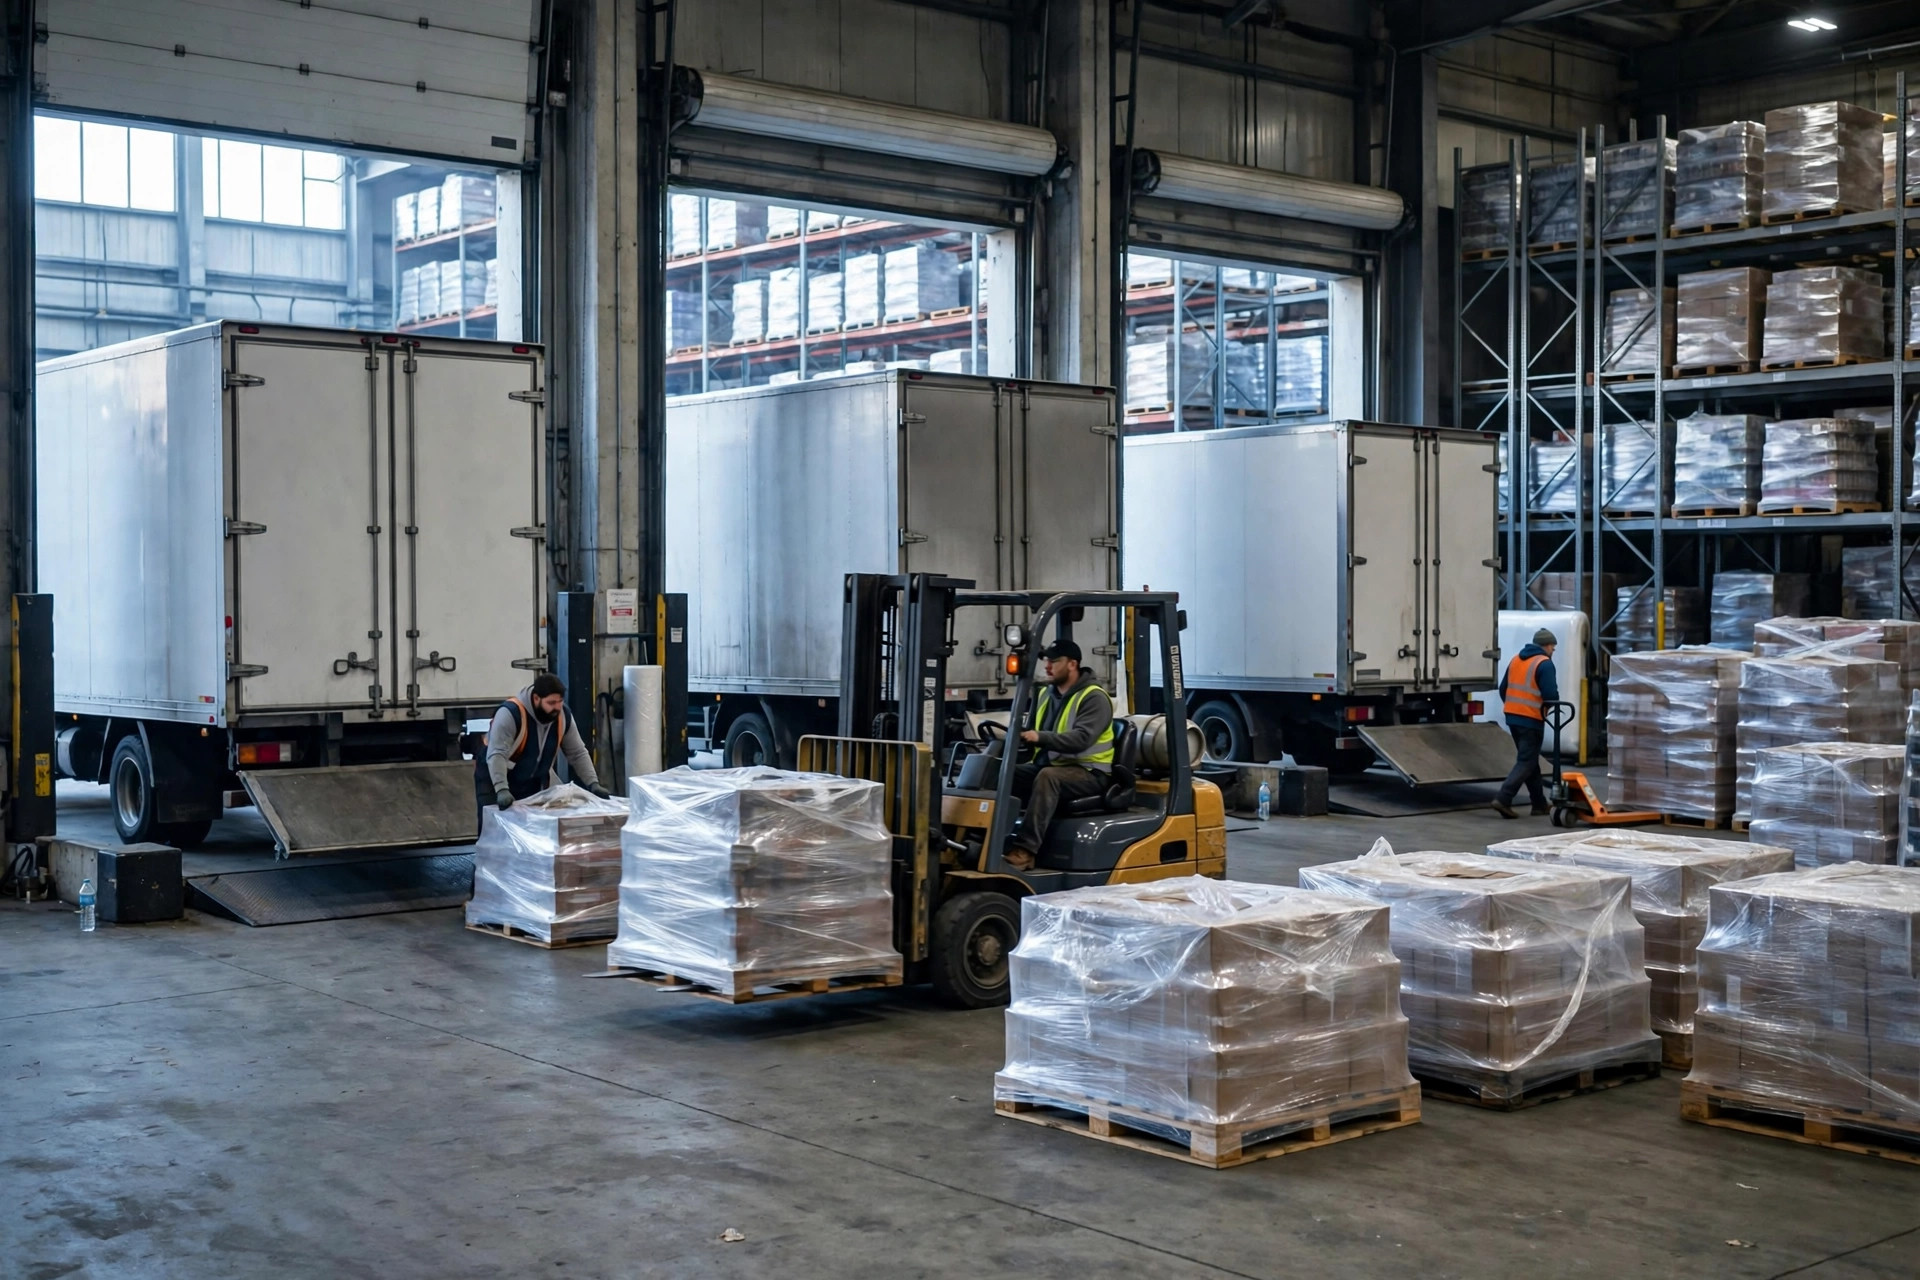
ピークシーズンを迎えるたびに、倉庫管理者は同じ問いを投げかけます。今のキャパシティは本当に持ちこたえるのか、と。AI倉庫キャパシティプランニングは、この問いに対して安心できる単一の数字を出すのではなく、受注予測、人員シフト、スロット配置、設備負荷を一つのモデルに通し、どの制約が最初に破綻するかを見て答えます。モデルそのものが興味深いわけではありません。重要なのは、かつて経験だけに頼っていたあらゆる判断を、検証可能な前提として明示させられる点です。
ここ数年の私の研究では、同じパターンを繰り返し見てきました。通常月は順調に回る倉庫が、大規模セールの期間にはあらゆる場所で同時に機能不全に陥るように見えるのです。シーズン後の振り返りでは、通常、単一の作業が突然悪化したわけではないことが分かります。むしろ、複数の制約が同時にきつくなっていたのです。受注量が倍増する一方で、臨時スタッフはまだ現場に慣れていない段階にあり、売れ筋SKUのスロットは予定より早く埋まり、梱包と出荷ドックの待ち行列は並行して長くなっていました。各指標だけを見れば許容範囲内でした。しかし合わさると、システムが吸収できる量を超えていたのです。キャパシティプランニングの目的は、建物がいっぱいになる当日にそれを発見するのではなく、この複合的な影響を事前に見ることにあります。
AI倉庫キャパシティプランニングは3本のラインから始まる
複数の倉庫事業者が公表した運用レビューによれば、ピーク時のキャパシティ見積もりは通常、3本のラインから始まります。1本目は受注ラインです。日常受注、先行販売受注、返品を分けて、商品カテゴリー別・チャネル別に予測数量を分解します。3者は作業負荷が大きく異なるからです。2本目は人員ラインです。ピッキング、格納、検品、梱包を労働時間あたりの出来高に換算し、新入社員の最初の2週間における生産性の低さを調整します。3本目はスペースと設備のラインです。売れ筋商品のスロット占有率、通路のスループット、自動化設備の時間あたり上限です。いずれか一つが限界に達すれば、新たなボトルネックが生まれます。
この3本のラインは、同じタイムライン上で読まなければなりません。総量だけを追う予測では構造変化が見えません。小口・多品種の受注の割合が上がると、ピッキングの歩行距離と検品チェックの回数は、受注件数そのものよりも速く増えます。人数だけを数える人員計画では、習熟度の問題が見えません。臨時スタッフの割合が大きくなりすぎると、エラー率の上昇に伴う手戻りが、空きシフトと同じくらい確実にキャパシティを食いつぶします。モデルは最後の1単位まで正確である必要はありません。管理者に対して、どの週に、どの工程で、残りの余裕が最初に尽きるかを示す必要があります。
2つの事例:1つのピークシーズン、異なる2つのボトルネック
説明のための運用事例を考えてみましょう。中国東部のEC倉庫では、1日の受注件数が通常週のおよそ8,000件から、11月の販促ピーク時にはおよそ26,000件へと跳ね上がりました。経営陣は予測に基づいてピッキング人員を手厚く配置していましたが、検品ステーションのスループットを同じように丁寧にモデル化していませんでした。ピッキング済みの荷物は検品できる速度より速く積み上がり、検品の待ち時間はおよそ15分から2時間以上へと伸びました。出荷サービスレベルは、ピッカーが少なかった場合よりも悪化してしまいました。ボトルネックは人員ではありませんでした。単一の下流工程であり、振り返りから得られた教訓は率直なものでした。1つの工程を欠いたキャパシティ見積もりは、他のすべての工程に組み込まれた余裕を無駄にしてしまう、ということです。
2つ目の説明事例は、複数の顧客に同時にサービスを提供する中国南部のサードパーティ・ロジスティクス倉庫のものです。9月には新学期シーズンとプラットフォームのセールが重なり、3社の顧客の売れ筋商品が同時に急増しました。売れ筋スロットは2週間以内に埋まり、補充スタッフはスペースを空けるために在庫を移動させる作業にシフトの大半を費やしました。事後にモデルを逆向きに回してみると、急増する商品を3週間前にピッキングゾーンの近くへ移動させ、補充を1日1回から1日2回に増やしていれば、通路の混雑の大部分は解消されていたことが分かりました。AI倉庫キャパシティプランニングの視点で見れば、両事例は同じ結論を示しています。ピーク時のキャパシティ問題は、めったに1つの作業の失敗が原因ではありません。見落とされた制約が最初に限界に達し、チェーンの残りを引きずり倒すことが原因なのです。
意思決定フレームワークとしてのAI倉庫キャパシティプランニング:最も短い板から直す
最終的に、モデルの出力はトレードオフの集合にならなければなりません。うまく使えば、AI倉庫キャパシティプランニングは予測を、優先順位付きの改善リストに変えます。以下の表は、業界レビューから私がまとめた意思決定フレームワークです。数値は各倉庫の実測データに置き換えるべきです。構造そのものはそのまま転用できます。
| ボトルネックの種類 | 早期警告シグナル | 最初の一手 | 最初にやってはいけないこと |
|---|---|---|---|
| 人手不足 | 臨時スタッフが30パーセント超、エラー率も並行して上昇 | 早めに採用し、バッチで研修し、経験者を新人と組ませる | 研修や検品なしに人員を増やす |
| スロット不足 | 売れ筋スロットの占有率が2週連続で上昇 | 急増商品を前方へ移動し、補充頻度を上げる | 既存スロットを有効活用する前にオーバーフロー用のスペースを借りる |
| 設備の上限 | 自動化設備が時間あたりの限界に近づく | 波を再編成して設備負荷を分散させる | ピーク直前に慌てて新設備を導入する |
| 工程の混雑 | 検品と出荷ドックの待ち行列の増大 | 波を分割し、並行する検品ステーションを増やす | ピッカーに単に速く働くよう求める |
理屈は単純です。どのラインが最初に限界に達するかを特定し、そこにリソースを集中させるのです。多くの倉庫は逆の順序で投資します。数量予測が上がるとすぐに賃借スペースや新設備の話を始めますが、実際の制約はウェーブ設計や、予測に追いついていない補充リズムだったりします。モデルが管理者の優先順位付けに役立たなければ、それは見栄えの良い予測レポートにすぎません。
ピーク前の6週間と、直感に反する判断
実務的には、ピーク前の6週間が現実的な準備期間となります。最初の2週間は予測の校正と制約の把握、中間の2週間はスロット配置とシフトの調整、最後の2週間はストレステストと小規模なリハーサルです。ストレステストは特に強調に値します。予測ピーク数量で、予測受注ミックスによる実際の波を1回回すことで、レポートでは決して見えない問題が露わになります。リハーサルで見つかったボトルネックはまだ直せます。ピーク当日に見つかったボトルネックは、耐えるしかありません。
管理者が真剣に受け止めるべき、直感に反する判断があります。ピーク前にリソースを追加することが、実効キャパシティを減らす場合があるのです。新しい臨時スタッフは経験者の指導を必要とし、新しいスロットはピッキングの移動距離を長くし、十分な試運転を経ていない新設備は、システムが最大負荷にあるまさにそのときに新たな故障ポイントを持ち込みます。キャパシティとは、利用可能なリソースの合計ではありません。制約条件下でシステムが維持できるスループットです。AIモデルの真の価値は、より大きなキャパシティ数値を出すことではなく、既存の制約の下でどの改善が全体として最大の効果をもたらすか、そしてどの投資がピーク到来前に回収できないかを、示すことにあります。
今後を見通すと、キャパシティプランニングは年に数回実施するプロジェクトから、倉庫運用の日常的な一部へと移行しつつあります。予測データがより完全になるにつれて、モデルは構造変化に対してより敏感になり、管理者の判断は、キャパシティがおおむね十分かどうかを問うものから、どの週に、どの工程が最初にきつくなるかを問うものへと変わります。それは経験を時代遅れにするものではありません。むしろ、モデルが生み出す警告の一つひとつについて、それが真の制約を反映しているのか、データの測定方法による見せかけなのかを判断するには、現場を知る人が依然として必要です。モデルが言うことと現場が知っていることの間の緊張は、今後数年の倉庫管理における最も興味深い展開の一つになるかもしれず、さまざまな事業者がそれをどう解決していくかを見る価値があります。
Dr. Chen(サプライチェーン研究者)著
英語版からの翻訳。内容に相違がある場合は英語版を優先します。