Voici le verdict d'entrée de jeu : votre plan de redondance et de basculement du WCS doit être bouclé avant le go-live — et répété au moins une fois, de bout en bout, pour de vrai. Un plan qui n'a jamais été répété, c'est comme pas de plan du tout. J'ai vu exactement ce même échec trois fois, et à chaque fois le droit d'entrée s'est payé en temps d'arrêt.
Pourquoi le WCS ne pardonne-t-il pas ? Parce que c'est le cerveau d'un entrepôt automatisé : convoyeurs, trieurs, monte-charges, dispatch AMR — tout reçoit ses ordres de lui. Quand il meurt, le système ne « ralentit » pas ; tous les équipements de l'entrepôt s'arrêtent ensemble, et les marchandises restent coincées sur les machines, là où aucune main humaine ne peut les atteindre. Si votre serveur WMS meurt, vous pouvez encore expédier à partir de listes de préparation papier. Si votre WCS meurt, vous restez là à regarder. Ce sont des pannes d'une ampleur complètement différente, et sur la check-list de la nuit du go-live, la redondance du WCS est la ligne que l'on ne rogne pas.
J'ai vu cet échec trois fois : quatre heures contre dix minutes
Fin 2024, un centre de distribution e-commerce dans le sud de la Chine nous a appelés en urgence. Le site traitait environ 80,000 commandes par jour, avec un entrepôt automatisé à grande hauteur plus un tri cross-belt — le tout tournant sur un unique serveur WCS physique. Pas de secours. Un matin, le disque a lâché et le WCS ne redémarrait plus. La scène dans l'entrepôt : les marchandises figées sur les convoyeurs, la moitié des goulottes de tri pleines, et plus de 60 opérateurs de nuit debout, sans rien à faire. De la détection de la panne, à l'attente des pièces, à la réinstallation du système d'exploitation, au rechargement de la configuration, jusqu'au rétablissement complet — quatre heures. Au rythme quotidien de ce site, quatre heures, c'est environ 13,000 commandes en retard, la semaine précédant la haute saison, avec les téléphones du service client en feu. La phrase du responsable informatique dans le post-mortem pique encore : « On a toujours pensé que le serveur était solide. Il ne nous est jamais venu à l'idée qu'il pouvait simplement mourir. »
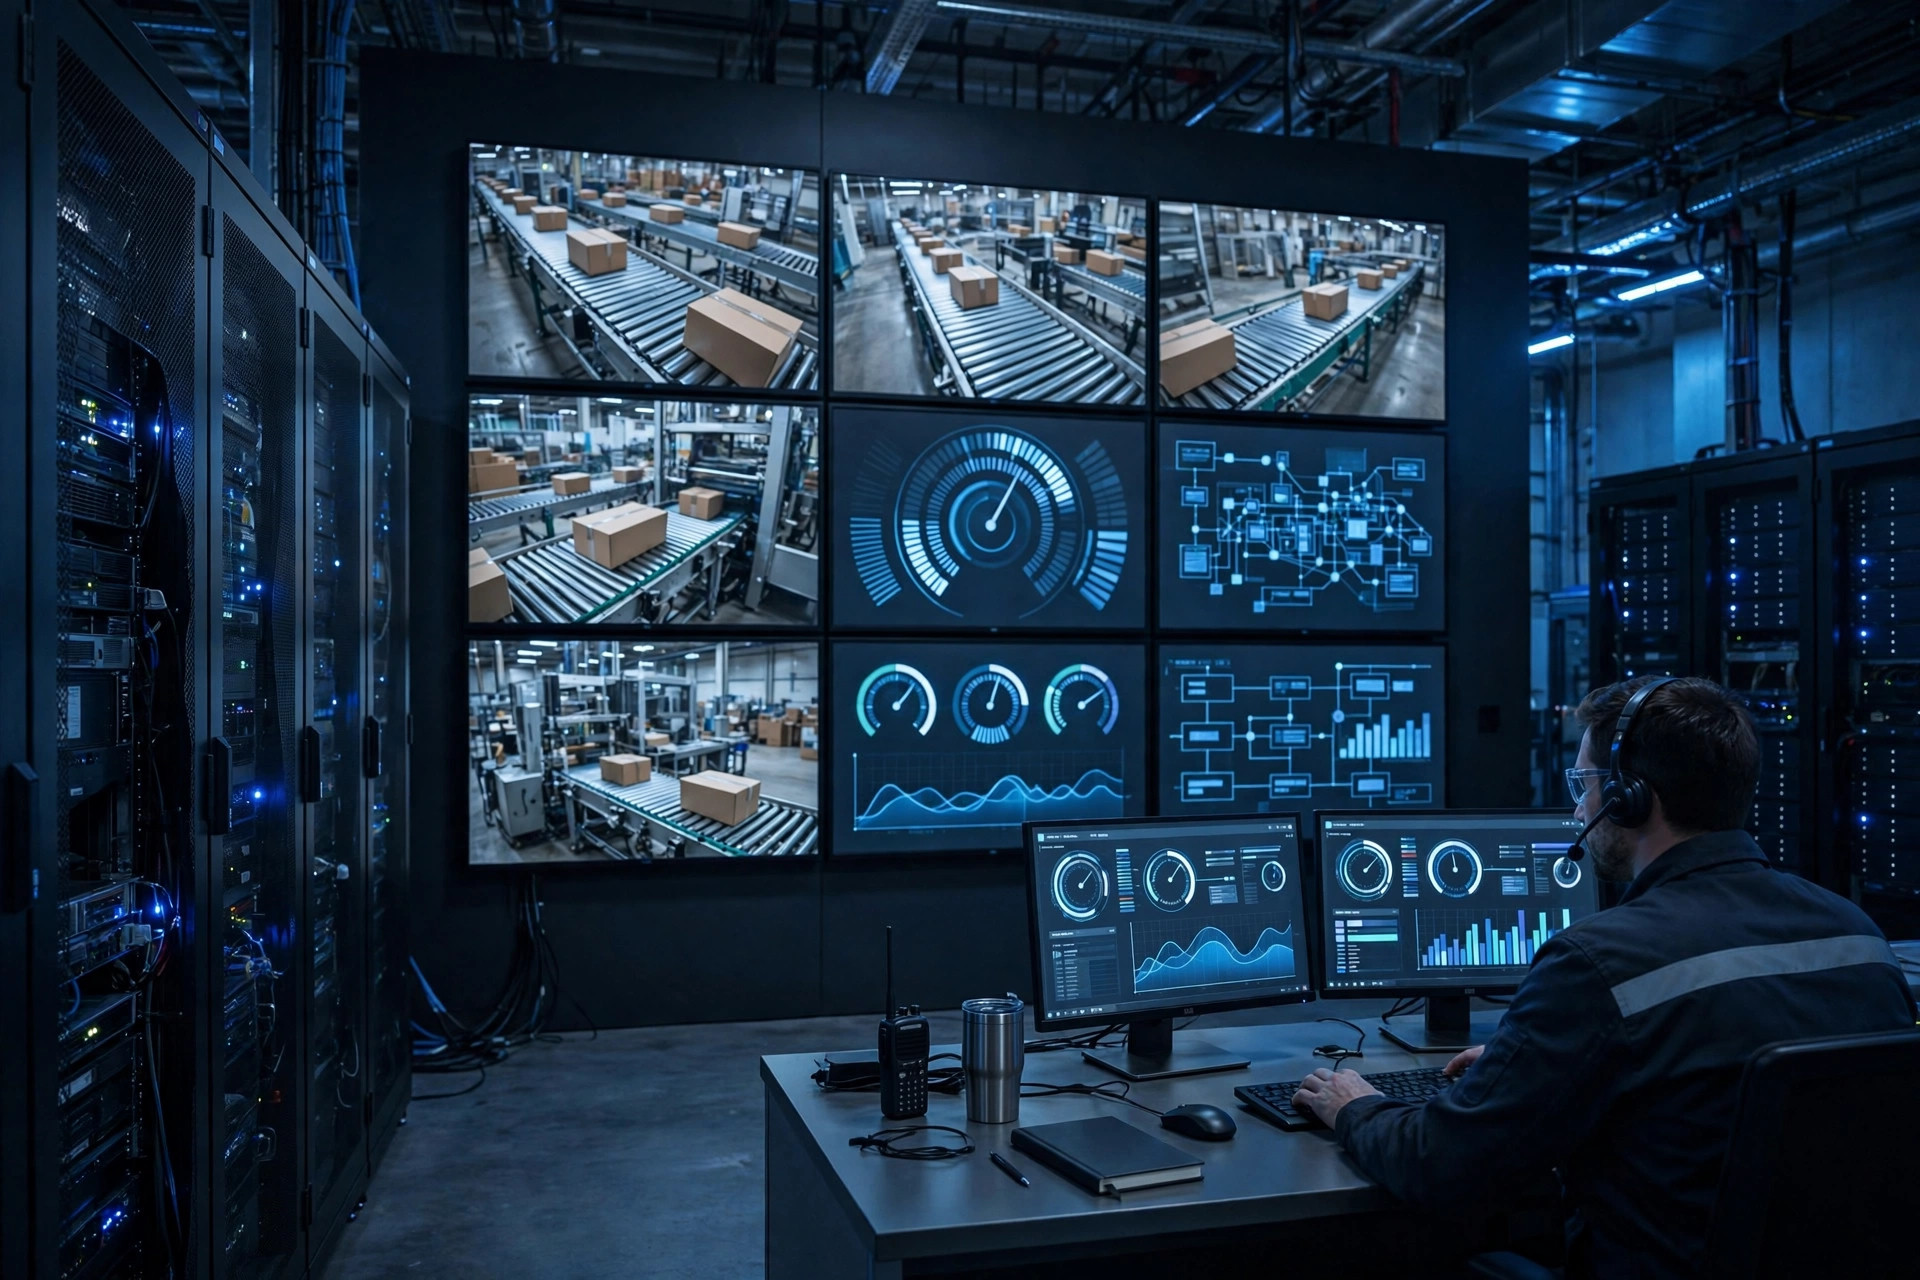
Et maintenant l'exemple positif. Au premier semestre 2025, un entrepôt automatisé 3PL dans l'est de la Chine tournait sur un schéma actif-passif de manuel : le serveur de secours répliquait la base de données du primaire en temps réel, la surveillance par battement de cœur était en place, et la procédure de basculement (SOP) était imprimée et collée au mur de la salle de contrôle. Le point critique : ils avaient réalisé deux exercices de basculement complets, en conditions réelles, avant le go-live — pas des exercices en diapositives, ceux où l'on débranche vraiment le câble réseau du primaire. Trois mois après le lancement, le module d'alimentation du serveur primaire a lâché ; l'opérateur de service a suivi la SOP, et le secours a pris le relais en dix minutes. Deux exercices, environ deux heures chacun ; ce qu'ils ont acheté, c'est dix minutes lors d'une vraie panne. Le calcul est simple.
La check-list pré-lancement : cinq étapes pour verrouiller la conception du basculement
Étape un : choisissez l'architecture, et ne surdimensionnez pas. Pour les sites de moins d'environ 100,000 commandes par jour, l'actif-passif avec réplication primaire-réplica de la base de données suffit amplement ; le double actif double la complexité — laissez-le aux méga-hubs. Et le serveur de secours doit être au moins aussi bien dimensionné que le primaire. Ne lésinez pas sur la machine de secours : basculer sur une machine qui ne peut pas porter tout l'entrepôt est pire que de ne pas avoir de secours du tout.
Étape deux : gravez les objectifs de synchronisation des données dans le marbre. Le RPO (la perte de données que vous pouvez tolérer) ne doit pas dépasser cinq minutes ; faites remonter une alerte si le retard de réplication dépasse une minute. Les états des tâches du WCS et les états des équipements doivent être dans le périmètre de la réplication. Ne répliquer que la base de données métier et pas la base d'état, c'est basculer directement dans le chaos quand même — c'est le détail que l'on oublie le plus souvent.
Étape trois : écrivez la SOP de basculement pour qu'elle puisse être exécutée à moitié endormi. Elle doit couvrir : qui est autorisé à ordonner le basculement (chef d'équipe ou au-dessus), la séquence (d'abord suspendre le dispatch des tâches, puis la prise de relais par le secours, puis la reconnexion des équipements, puis la vérification ponctuelle), et les critères d'acceptation de chaque étape (par exemple, « les trois troncs de convoyeurs font circuler les marchandises »). Imprimez deux exemplaires — un dans la salle de contrôle, un dans la salle de garde informatique. Ne la laissez pas vivre uniquement sur le portable de quelqu'un.
Étape quatre : au moins un exercice complet en conditions réelles avant le go-live. Trois exigences strictes : vous coupez un vrai lien (débranchez le câble, coupez l'alimentation — pas de bouton « simuler »), vous chronométrez tout (de la détection de la panne à la reprise de la production, à la minute près), et vous faites un post-mortem (toute étape qui a dépassé les temps donne lieu à une correction de la SOP ou de l'architecture). Après le go-live, exercice trimestriel, plus un exercice supplémentaire à chaque changement de personnel clé.
Étape cinq : surveillance et inspection de routine, sans exception. Le secours n'est pas un meuble : vérifiez automatiquement chaque jour le battement de cœur du secours et le retard de réplication, faites une vérification hebdomadaire en lecture seule sur le secours (confirmez que ses données sont fraîches), et une revue mensuelle sur table du flux de basculement. Un serveur de secours auquel personne ne s'est connecté depuis trois mois peut avoir un mot de passe expiré — l'un des trois échecs que j'ai vus, c'était exactement ça : des identifiants de secours expirés, et l'entrepôt est resté à l'arrêt quarante minutes de plus pendant que tout le monde paniquait.
Les façons habituelles dont ça tourne mal : un plan sur papier, c'est pas de plan
- Les données du secours datent de trois mois : la réplication est cassée depuis longtemps et personne n'a regardé les alertes.
- Une seule personne sait actionner l'interrupteur de basculement : cette personne est en vacances, et tout l'entrepôt attend avec elle.
- L'exercice n'a jamais eu lieu que dans PowerPoint : le premier vrai câble débranché révèle que la moitié des équipements ne se reconnectent pas au secours.
- Le secours est sous-dimensionné : des dizaines de cœurs sur le primaire, une fraction de ça sur le secours, et il s'effondre sous la charge dès qu'il prend le relais.
Le constat contre-intuitif : la haute disponibilité n'est pas chère — un plan jamais répété, si
Une dernière constatation contre-intuitive : la haute disponibilité du WCS en soi n'est pas chère. Un serveur de secours plus le logiciel de réplication coûte typiquement une fraction d'une heure d'arrêt — d'après le calcul ci-dessus, quatre heures d'arrêt ont mis en retard 13,000 commandes, et les conséquences sur le service client et les SLA éclipsent à elles seules le prix d'un serveur. Ce qui est vraiment cher, c'est le plan qui existe dans un document et qui n'a jamais été répété : il vous donne l'illusion d'une issue, et vous découvrez que la sortie est peinte sur le mur seulement quand l'incendie commence.
Voici donc trois choses que vous pouvez faire ce soir : demandez à votre équipe informatique si le WCS a un secours ; demandez si les données du secours sont fraîches ou vieilles de trois mois ; demandez quand a eu lieu le dernier exercice de basculement. Si l'une de ces questions reste sans réponse, cela appartient à l'ordre du jour maintenant — avant le go-live, pas lors d'un appel de panne à 3 a.m..
Par Lin Xiao, Consultante en implémentation WMS
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.