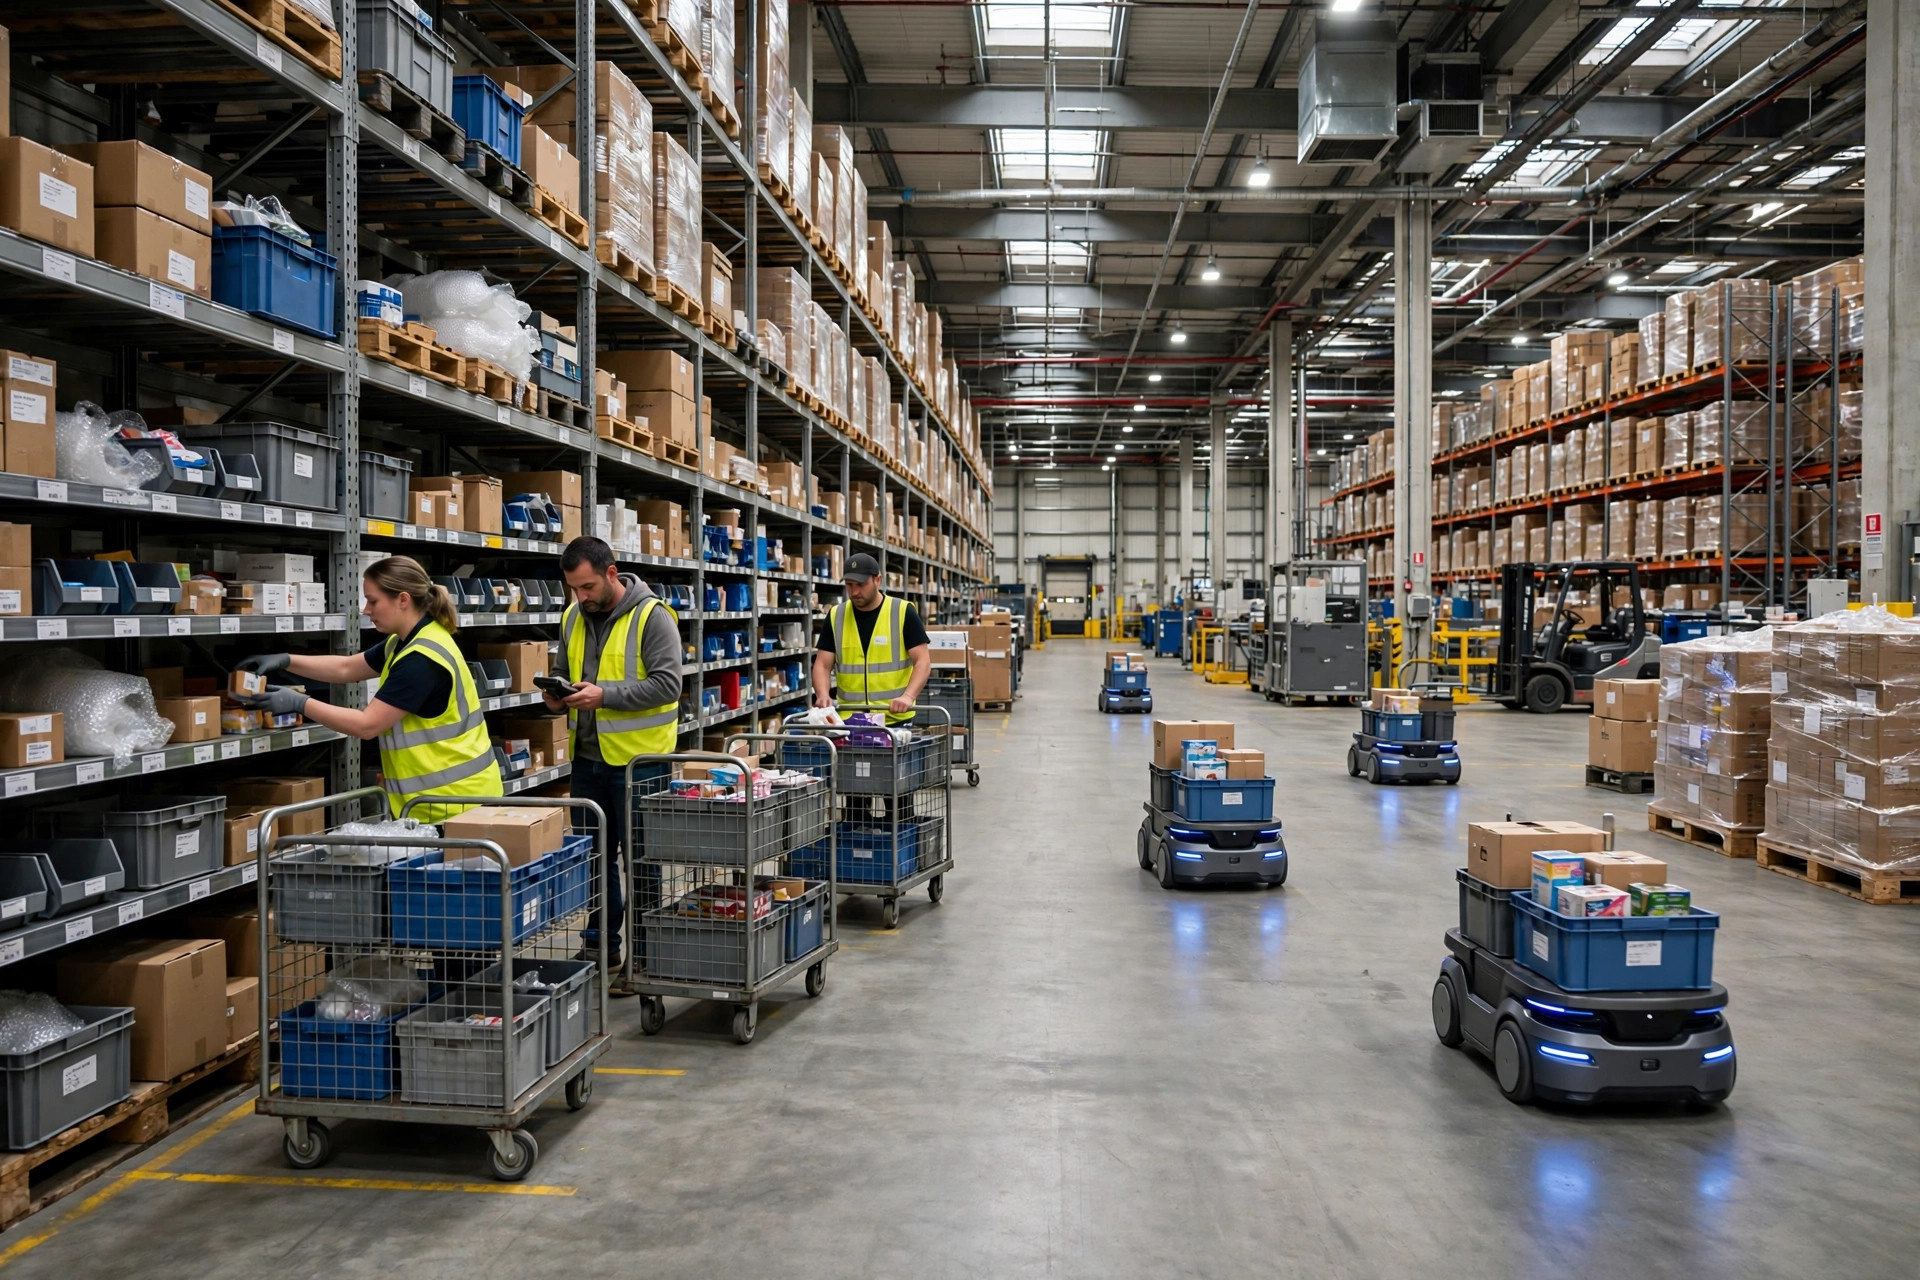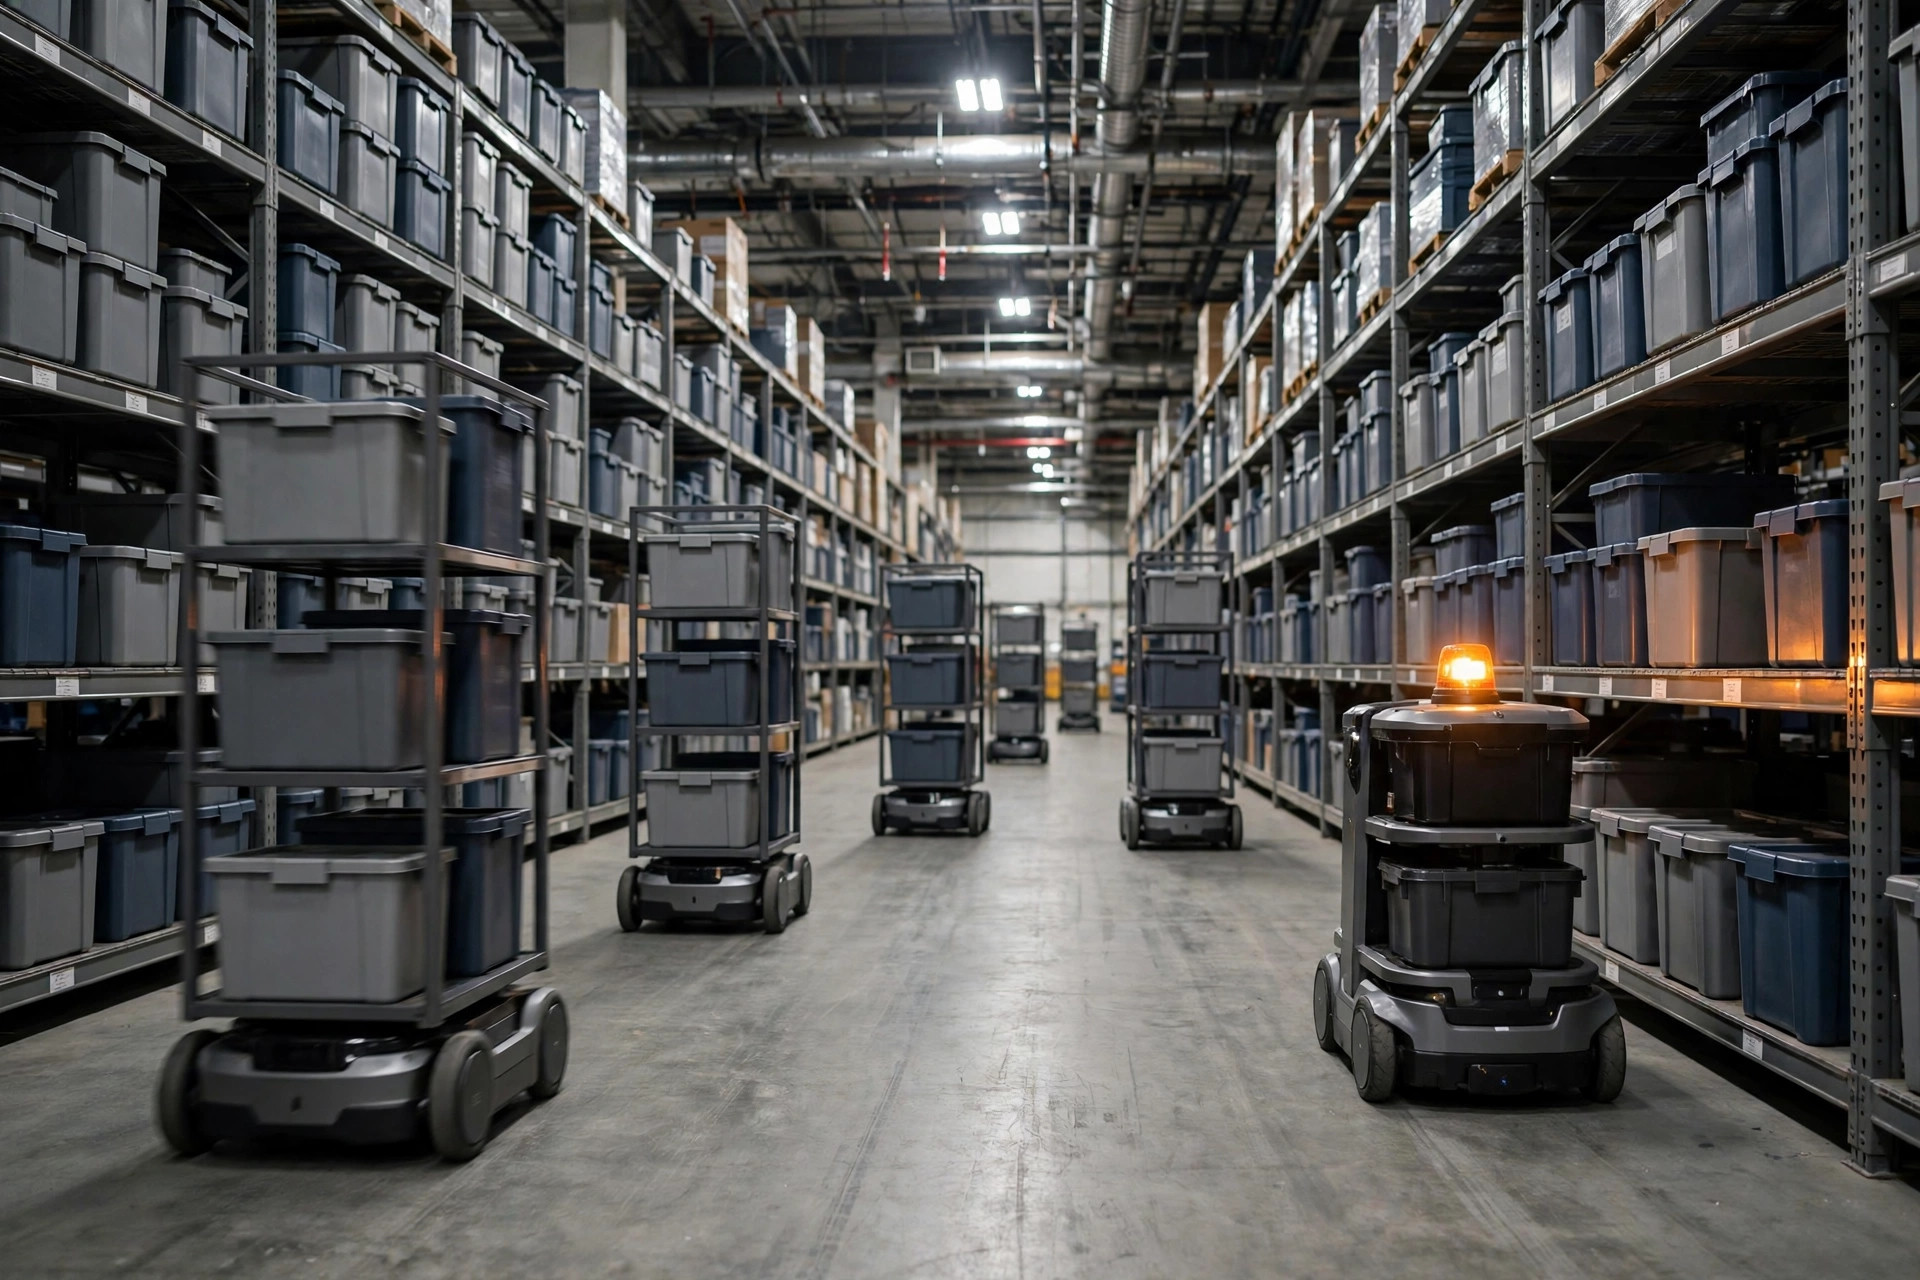
En août dernier, j'étais en visite de suivi dans un entrepôt e-commerce 3C dans l'est de la Chine — quarante AMR de transport d'étagères en pleine activité. À 10 h, la climatisation de la salle serveurs est tombée en panne et le serveur de gestion de flotte a surchauffé jusqu'à redémarrer — une panne unique en son genre, de manuel. Quinze minutes sans aucune commande émise : chaque robot a déclenché son arrêt de protection et s'est figé. La vague du matin a dérapé de près de deux heures.
L'autopsie a été salutaire : le serveur allait bien, un redémarrage a tout réparé. Mais ces quinze minutes ont exposé la vérité — dans ce système « intelligent », le point de défaillance unique se cachait à l'endroit le plus ennuyeux. Cet article découpe les pannes uniques des AMR en trois couches — où chacune se cache, comment la renforcer, où tracer la ligne — plus comment casser le système délibérément à la réception. Divulgation : les chiffres non sourcés ci-dessous sont mes estimations post-projet ; l'ordre de grandeur est bon, ne les recopiez pas dans un appel d'offres.
Où se cachent vraiment les pannes uniques des AMR
Pensez-y comme à la circulation d'une ville. La flotte d'AMR est le flux des voitures, le système de gestion de flotte (FMS) est le centre de contrôle des feux, et le réseau Wi-Fi est la radio dans la main de chaque conducteur. Ce qui paralyse une ville n'est jamais une voiture en panne — c'est l'une de ces trois choses qui tombe :
Couche un : le véhicule individuel. Un robot tombe — batterie sur-déchargée, lidar sale, débris dans une roue motrice. Le plus courant, le moins dangereux : un robot en panne représente 2.5% du débit dans une flotte de 40 robots.
Couche deux : le répartiteur. Le serveur FMS plante, le logiciel d'ordonnancement rencontre un bug, la base de données se bloque. Un serveur hoquette et toute la flotte devient sourde — cette coupure de quinze minutes, c'était cette couche. La vraie panne unique : une machine qui commande tout.
Couche trois : le réseau. Un point d'accès meurt, l'itinérance échoue, une zone morte apparaît. Les robots perdent le contact avec le dispatching et exécutent leur politique de « liaison perdue » — arrêt sur place, souvent au milieu d'une allée principale.
Des trois couches, 90% des projets versent l'argent dans la couche un — des robots plus sophistiqués, plus de capteurs — tandis que les couches deux et trois reçoivent les restes. C'est pourquoi chaque incident devient un arrêt total du plancher : l'argent est allé dans la mauvaise couche.
Les trois couches de redondance : où l'argent devrait aller
Les principes d'abord, les lignes de démarcation ensuite. Plus de sauvegarde n'est pas automatiquement mieux — il s'agit de dépenser sur la bonne couche.
La sauvegarde des véhicules, c'est des robots de rechange, pas des pièces détachées. La bonne approche, c'est N+1 : dans une flotte de 40 robots, achetez une ou deux unités supplémentaires en réserve chaude. Un robot mort est traîné dehors, un remplaçant prend le relais, le débit ne fléchit pas. La ligne de démarcation : deux équipes en continu → le N+1 est obligatoire. Un seul poste de jour → partagez un parc de réserve entre sites, ou passez ; un robot qui meurt à midi est réparé pour le soir.
Là, je dois dénoncer un pseudo-besoin. Certains fournisseurs vendent « double lidar, double batterie » et font grimper le prix du robot de 30%. C'est un don au fournisseur, pas de l'ingénierie. Les AMR industriels grand public affichent des MTBF annoncés par le fournisseur supérieurs à 5,000 heures. Dépenser une prime de 30% pour faire passer les pannes d'une unité de quelques fois par an à une ou deux fois est inutile quand un hoquet du répartiteur tue de toute façon toute la flotte. Gardez cet argent pour la couche deux.
La sauvegarde du répartiteur — serveurs actif-passif — c'est l'argent qui vous garde en vie. Deux serveurs FMS — un actif, un en attente — avec surveillance par battements de cœur et basculement automatique. Pensez à un avion bimoteur — perdez un moteur et vous continuez à voler. La ligne de démarcation, c'est le temps de basculement : il doit battre le seuil d'« arrêt de protection par liaison perdue » des robots, couramment 5 à 10 secondes selon le fournisseur (expérience de terrain — exigez ce chiffre et écrivez-le dans l'accord technique). Un basculement en 30 secondes, c'est reçu. Plus d'une minute, c'est comme n'avoir aucune sauvegarde — les robots se seront arrêtés eux-mêmes, et votre serveur de secours hérite d'un plancher de cadavres à récupérer manuellement, un par un.
La sauvegarde réseau, c'est la couverture AP chevauchante. Chaque zone doit se trouver dans le périmètre d'au moins deux points d'accès, de sorte que quand un AP meurt, son voisin absorbe la charge. La ligne de démarcation : avec un seul AP en panne, les voisins doivent couvrir au moins 90% de cette zone, avec un transfert d'itinérance de moins d'une seconde. Une « conception double AP » qui n'atteint pas ces chiffres est de la décoration.
Trois niveaux chiffrés pour une flotte typique de 40 robots (les pourcentages sont mes fourchettes d'expérience) :
| Niveau | Surcoût (% du projet) | Complexité | Temps de récupération typique | Pour qui |
|---|---|---|---|---|
| De base : un seul FMS + un seul AP + pas de robot de rechange | +0% | Faible | Récupération manuelle, 30 min – 2 h | Petit entrepôt en un poste qui peut se permettre de s'arrêter |
| Standard : FMS actif-passif + couverture AP chevauchante + 1 robot de rechange | +8%–12% | Moyenne | Basculement en 30 s, panne d'un robot couverte en 10 min | La plupart des entrepôts 24 heures |
| Haute disponibilité : FMS actif-actif + réseau double bande + 10% de parc de réserve | +20%–30% | Élevée | Basculement en quelques secondes, le débit fléchit à peine | Pharma, automobile — où une ligne arrêtée signifie des pénalités |
Vous voyez la forme ? De base à standard coûte environ 10% de plus et fait passer la récupération d'heures à minutes — le meilleur rapport qualité-prix ici. Le niveau haute disponibilité est pour les opérations où une minute d'arrêt coûte de l'argent réel. Les entrepôts e-commerce ordinaires doivent s'en tenir éloignés ; la complexité se retourne contre vous.
Isolation des pannes : traînez d'abord le robot mort hors du réseau de circulation
La sauvegarde maintient le système en vie. L'isolation des pannes empêche la partie morte d'entraîner la partie vivante. Comme une panne sur l'autoroute : la première étape est de traîner la voiture sur la bande d'arrêt d'urgence, pas de la réparer sur la voie de circulation.
Une chaîne d'isolation des pannes correcte : l'autodiagnostic du robot détecte une anomalie (batterie, perte de localisation, panne de traction) → rapport au FMS en 3 secondes → le FMS marque ce segment de voie comme zone d'exclusion temporaire → les tâches inachevées du robot mort sont réaffectées aux robots sains → un humain ou un robot de rechange le remorque. Tout automatique ; l'humain ne fait que le remorquage final.
J'ai vu le contre-exemple. En mars 2024, dans un entrepôt de pièces auto dans le nord de la Chine, le module d'alimentation d'un AP a grillé. Six robots dans sa zone ont perdu la liaison pendant plus de 5 secondes et se sont arrêtés par protection — deux d'entre eux sur une artère principale. La logique d'isolation du FMS avait un bug : les données de position de plus de 10 secondes pour un robot en liaison perdue comptaient comme périmées, donc aucun reroutage n'est sorti. Quatre robots sains ont fait la queue derrière les « cadavres ». Quarante minutes de dégagement manuel, la moitié du dispatching de l'entrepôt gelée.
Deux leçons. Premièrement, concevez l'isolation pour la pire position — supposez que le robot mort s'arrête toujours dans l'allée la plus critique. Deuxièmement, ne reroutez jamais d'après sa dernière position signalée ; tracez la zone d'exclusion à partir de « dernière position connue plus un rayon de sécurité ». Détournez trop loin plutôt que de foncer dedans.
Puis la dégradation gracieuse — la seconde moitié de l'isolation des pannes. Cas extrême : 30% de la flotte en panne d'un coup (un mauvais lot de batteries, ça arrive). Le système ne devrait pas se coucher ; il devrait se dégrader automatiquement : baisser d'un cran de vitesse, reprioriser les tâches (protéger la vague sortante, différer l'entrante), élargir la zone de picking manuel. Préconfigurez cela dans le FMS avec des seuils durs — « passer automatiquement en mode dégradé quand les robots sains descendent sous 70% ». Ne comptez pas sur l'opérateur du poste de nuit qui improvise à 3 h du matin.
Avant la réception : les exercices de panne unique à ne pas manquer
Le piège de la maintenance : de beaux documents de conception, mais personne n'ose casser le système à la réception. Exécutez chaque exercice à la main ; ne signez que si aucun n'échoue :
- Débranchez le serveur de dispatching. Chronométrez la prise de relais du serveur de secours ; vérifiez l'absence d'arrêts de protection massifs. Plus d'une minute — refusé.
- Tuez le processus de dispatching sans couper l'alimentation. Simule un plantage logiciel — vérifiez que la détection par battements de cœur attrape le « faux vivant » split-brain (processus en cours, service mort).
- Éteignez un AP. Vérifiez une itinérance fluide, sans arrêts par liaison perdue.
- Arrêt d'urgence sur un robot au hasard. Chronométrez la zone d'exclusion et la réaffectation des tâches. Plus de 3 minutes — l'isolation échoue.
- Coupez l'alimentation de toute la rangée de charge. Vérifiez que la politique de dispatching batterie faible tient — l'élément le plus négligé ici. J'ai vu deux fois des robots à batterie faible faire la queue pour charger, ne trouver aucune énergie et mourir collectivement.
- Simulez 30% de la flotte hors ligne. Vérifiez que le mode dégradé se déclenche automatiquement et que la vague sortante survit.
Enregistrez chaque exercice : heure de déclenchement, heure de récupération, intervention humaine ou non. Si le fournisseur dit « nous l'avons testé dans notre labo », la réponse est : vos robots, mon plancher, tout de suite. Une disponibilité de 99.99% testée en labo perd au moins 20% au moment où elle rencontre de vrais racks et chariots.
Bilan final. Que cet argent vaille la peine se résume à un chiffre : le coût d'une heure d'arrêt en votre haute saison. Volume horaire sortant de pointe × marge moyenne par commande, plus pénalités de retard et main-d'œuvre inactive — facilement plus de $3,000 pour un entrepôt e-commerce de taille moyenne. Le niveau standard coûte environ 10% de plus ; sur trois ans d'amortissement, cela fait des dizaines de dollars de l'heure. Des dizaines de dollars de l'heure pour couvrir des milliers de dollars de l'heure de perte — faites le calcul vous-même. Mais si votre entrepôt tourne en un poste avec un volume modeste et qu'un arrêt de deux heures ne fait que retarder un après-midi — le niveau de base suffit ; ce budget achète mieux des pièces détachées. Les dépenses de sauvegarde ne sont pas un système de croyance. C'est de l'arithmétique.
Par Da Liu, Ingénieur en automatisation
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.