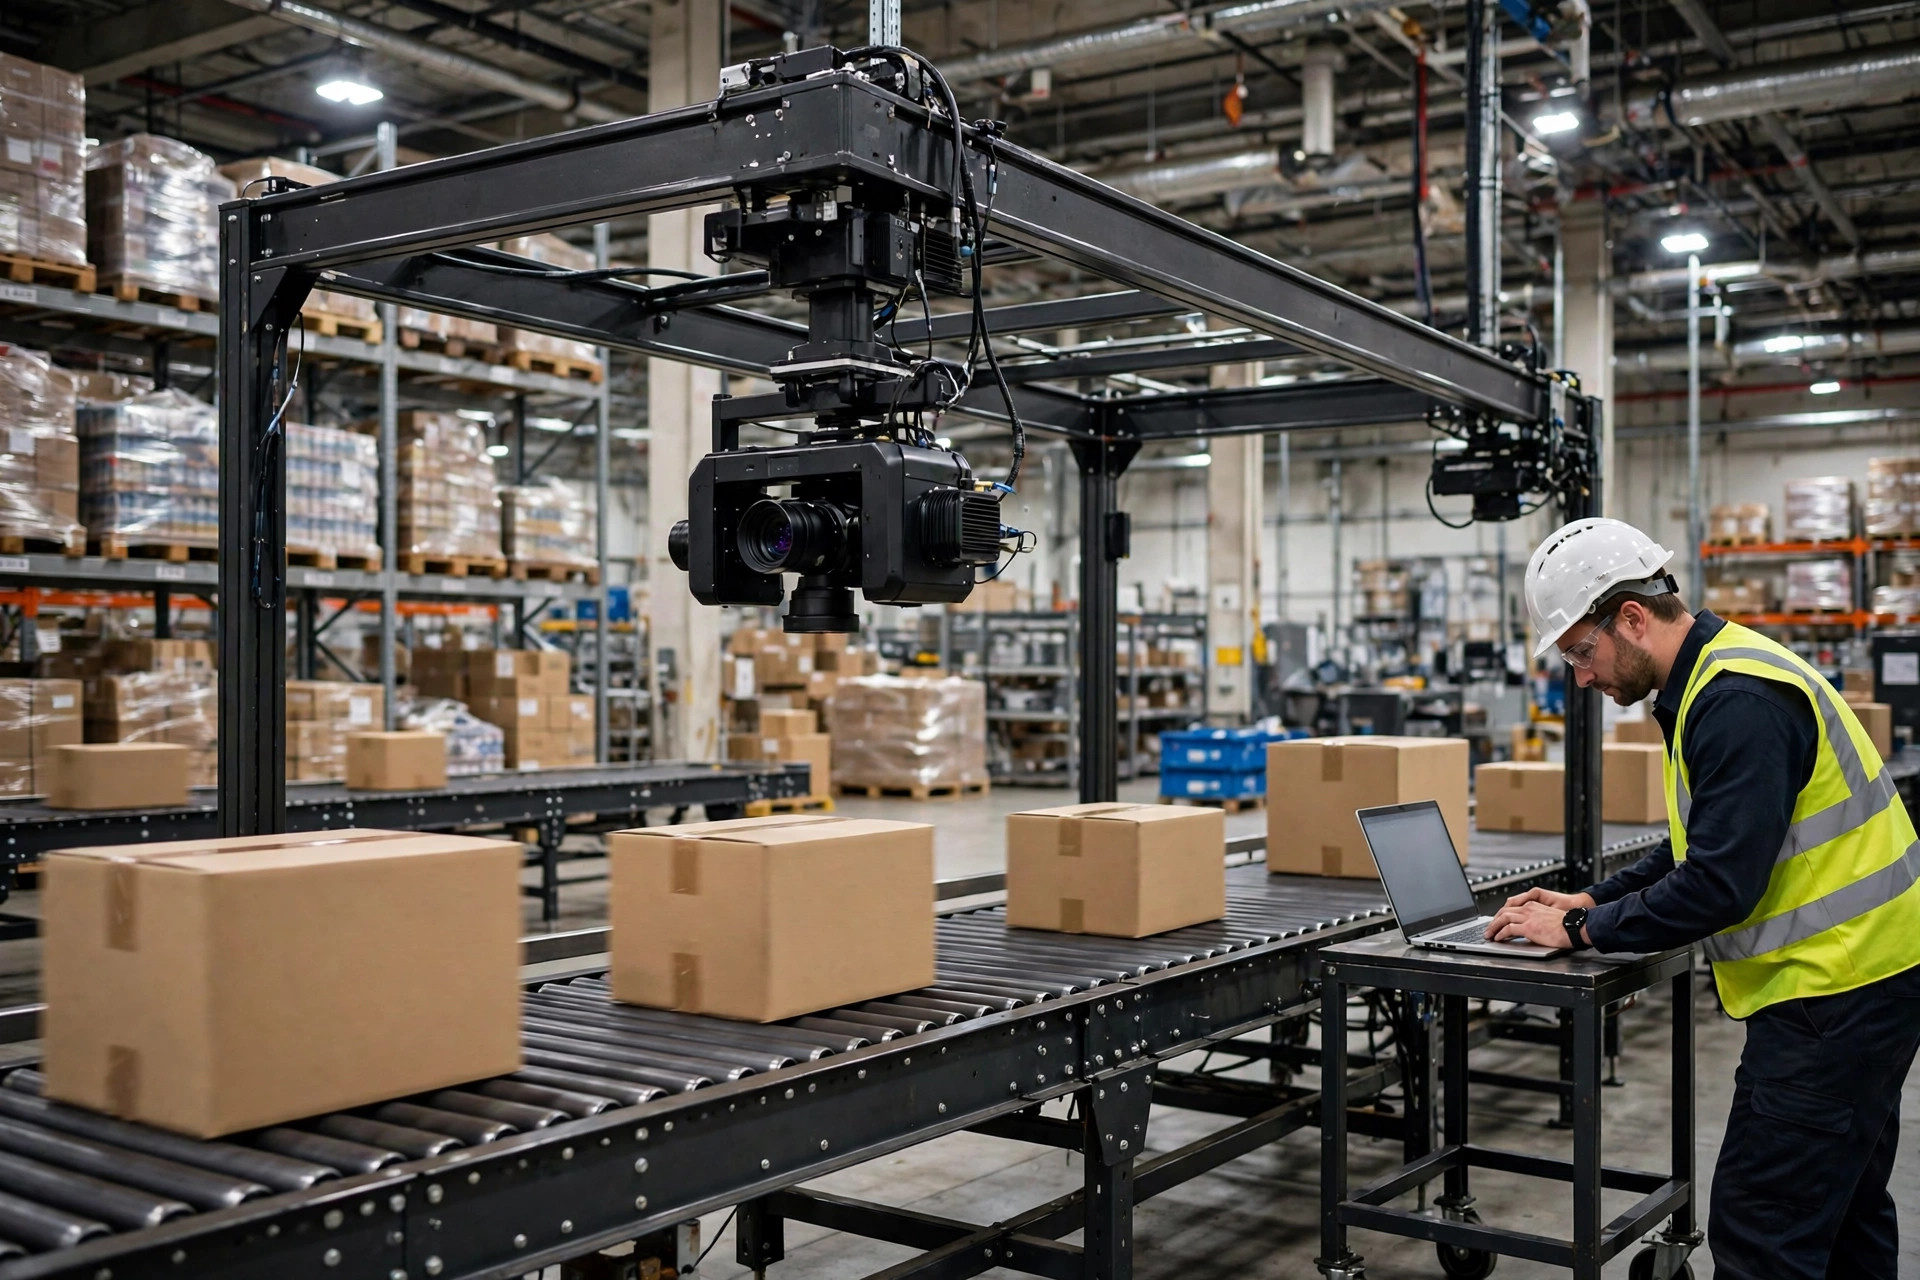
Fin 2023, un centre de tri 3PL du sud de la Chine s'est heurté à un problème étrange. Les colis volaient sur le tapis à 1.8 mètres par seconde, et la reconnaissance des colis tournait avec de l'inférence IA dans le cloud. Chaque aller-retour prenait 380 millisecondes — pendant ce temps, un colis parcourait 68 centimètres. Les goulottes de déviation ne faisaient que 60 centimètres de large. Le taux d'erreur de tri est passé de 0.3% à 4.7% : sur 80,000 colis par jour, plus de 3,700 prenaient la mauvaise goulotte. Cette nuit-là, les ingénieurs ont déplacé le modèle sur un boîtier edge installé sur place. La latence est tombée sous 60 millisecondes, et le lendemain le taux d'erreur était revenu à 0.4%.
Tout entrepôt finit par affronter la question de l'inférence IA en périphérie vs cloud. Voici le calcul, en trois parties : la latence, le coût, et ce qui se passe quand le réseau meurt.
D'abord, le principe : l'entraînement et l'inférence sont deux métiers différents
Pensez à apprendre à conduire versus conduire. On apprend à l'auto-école (le cloud : grosse puissance de calcul, pas de précipitation). Mais une fois sur la route, on réagit soi-même, en temps réel (la périphérie : des réactions en millisecondes). L'IA fonctionne pareil : entraîner un modèle dans le cloud est une évidence, mais l'endroit où tourne l'inférence dépend de la charge de travail.
Les charges de travail IA de l'entrepôt se déclinent en trois saveurs :
- Vision par ordinateur : lecture de codes-barres et re-scans, détection de dommages sur les colis, dimensionnement, détection de sécurité chariots élévateurs et piétons. Beaucoup de données (des flux vidéo qui affluent), des exigences temps réel strictes.
- Voix : préparation de commandes vocale, voix-vers-texte pour le signalement d'exceptions. Les flux audio sont en réalité minuscules — mais l'interaction est une boucle fermée, et les humains n'attendent pas.
- Prévision : prévision de la demande, suggestions de réapprovisionnement, planification de la main-d'œuvre. Des traitements par lots ; personne ne s'émeut si la réponse arrive une heure plus tard.
Et un mot franc sur les faux besoins : un propriétaire d'entrepôt m'a un jour demandé si l'IA dans le cloud pouvait compter des colis sur un convoyeur en temps réel. Je lui ai dit qu'un compteur photoélectrique coûte quelques centaines de dollars, n'a besoin d'aucun réseau et a une latence effectivement nulle. L'IA n'est pas un marteau ; arrêtez de tout traiter comme un clou. Classé sur-le-champ.
Périphérie vs cloud : le calcul de latence — combien de millisecondes un entrepôt ne peut-il pas se permettre ?
La première ligne de démarcation est le budget de latence. Latence d'inférence cloud = envoi + calcul cloud + réception. Dans une configuration typique, un aller-retour tourne entre 100–300 ms, et dépasser 500 ms lors des fluctuations du réseau n'a rien d'inhabituel. L'inférence en périphérie tourne en local, généralement résolue en 30–80 ms.
Tracez trois lignes selon le budget de latence :
| Budget de latence | Charge de travail typique | Où elle appartient |
|---|---|---|
| Boucle fermée en millisecondes (<100 ms) | Déviation du trieur, évitement d'obstacles des AMR, arrêt d'urgence de sécurité | Périphérie, sans discussion |
| Interaction en secondes (<1–2 s) | Confirmation de picking vocal, vérification de scan | Périphérie ou nœud proche |
| Minutes ou plus | Prévision de la demande, réapprovisionnement, rapports | Cloud |
Faites le calcul de latence : trieur à 1.8 m/s, aller-retour cloud de 380 ms, déplacement du colis = 1.8 × 0.38 = 68 cm. La goulotte fait 60 cm de large — quand le résultat de la reconnaissance revient, le colis a déjà dépassé sa goulotte. Ce n'est pas un problème d'algorithme, c'est de la physique. Aucune précision de modèle ne peut vous sauver.
Voici la partie contre-intuitive : beaucoup supposent que « le cloud a plus de puissance de calcul, donc la reconnaissance est plus précise ». Faux. La précision vient du modèle et de ses données d'entraînement — le même modèle tournant sur du matériel edge donne une précision identique. Le cloud est réellement meilleur en exactement deux choses : entraîner des modèles, et traiter des milliers de travaux par lots à la fois. Choisir le cloud « pour une meilleure précision », c'est payer une taxe à la bêtise.
Périphérie vs cloud : le calcul du coût — factures de bande passante contre factures de matériel
Le deuxième calcul, c'est l'argent. Le cloud facture en continu le trafic et les appels d'API ; la périphérie, c'est un investissement matériel unique plus l'électricité. Autre calcul.
Commencez par la bande passante. Une caméra 1080p, H.264, à 2 Mbps en envoi : 2 × 86,400 / 8 ≈ 21.6 GB par jour, soit environ 650 GB par mois et par caméra. Vingt caméras, c'est 13 TB de trafic montant par mois. Je ne citerai pas de prix au Go — consultez les derniers tarifs publiés de votre fournisseur de cloud — mais à l'échelle des dizaines de téraoctets, cette facture achète d'un coup plusieurs boîtiers edge.
En mars 2024, un entrepôt de vêtements de l'est de la Chine faisait du picking vocal via le cloud. Les opérateurs annonçaient une quantité et attendaient 1.2 secondes la tonalité de confirmation ; ils répétaient des quantités des centaines de fois par jour, et le débit est tombé sous le picking papier. Déplacer la reconnaissance sur un boîtier edge sur place a réduit la latence sous 300 ms. La leçon subtile : les données vocales sont minuscules, donc la bande passante n'a jamais été le goulot — la latence d'interaction, si. Faites attendre un humain une seconde et il s'énerve, répète, et tout le système ralentit. Pour les charges « petites données, interaction exigeante », le cloud, c'est payer pour souffrir.
La formule de comparaison est simple : pour la périphérie, prenez le matériel amorti sur 3 ans + l'électricité + la main-d'œuvre de maintenance, divisez par le nombre total d'inférences sur 3 ans — c'est votre coût par inférence. Pour le cloud, divisez le trafic + les frais d'API par le nombre total d'appels. Le plus petit nombre gagne. Les charges stables 24/7 s'amortissent magnifiquement en périphérie ; les charges par lots sporadiques coûtent moins cher en paiement à l'usage dans le cloud. C'est la ligne de démarcation du coût.
Quand le réseau meurt : la périphérie peut-elle rattraper ce que le cloud laisse tomber ?
Le troisième calcul est celui que tout le monde oublie : les réseaux d'entrepôt tombent en panne. J'ai vu de la fibre coupée par des travaux municipaux, des pannes d'ISP, des commutateurs centraux morts. Quand l'inférence cloud meurt, tout meurt avec elle. L'inférence en périphérie sur du matériel local continue de tourner.
En août 2024, un entrepôt du nord de la Chine a perdu sa fibre à cause de travaux routiers — six heures hors ligne. Sa vision de scan d'entrée tournait en périphérie, elle a donc traité environ 9,000 cartons pendant ces six heures avec zéro temps d'arrêt, tandis qu'un entrepôt voisin entièrement cloud a passé les mêmes six heures à enregistrer les réceptions à la main. Concevez votre mode dégradé à l'avance : la vision retombe sur les codes-barres seuls (on saute la détection de dommages), le picking vocal bascule sur la confirmation par bouton, les travaux de prévision se mettent en pause jusqu'au retour du réseau. Le mode dégradé n'est pas un compromis — c'est une partie du design.
Les pièges de la maintenance : trois choses qui rendent le matériel edge misérable
Principes couverts, lignes de démarcation tracées — maintenant les pièges de la maintenance, qui sont le vrai coût de la périphérie.
D'abord, la chaleur et la poussière. Un entrepôt qui monte à 40°C en été, c'est normal ; des boîtiers edge encrassés de poussière qui tournent à chaud verront leur MTBF nominal de 50,000 heures divisé par deux, facilement. Mettez le nettoyage trimestriel dans la procédure — n'attendez pas le ralentissement thermique pour y penser.
Ensuite, la cohérence des versions de modèle. Vingt boîtiers edge, le boîtier A en v2.3 et le B en v2.1, en désaccord sur les résultats de reconnaissance — déboguer ça vous fera pleurer. Il faut des déploiements OTA vers tous les boîtiers plus une vérification de version par boîtier après chaque déploiement, avec des alertes en cas d'écart. C'est là que les déploiements edge explosent le plus souvent.
Troisièmement, l'angle mort de la supervision. Un serveur cloud mort alerte quelqu'un en une minute ; un boîtier edge qui meurt dans un coin peut passer des jours inaperçu. Rapport de battement de cœur plus un watchdog, alerte automatique après 5 minutes hors ligne — configurez ça dès le premier jour.
Alors, l'argent en vaut-il la peine ? Regardez ce seul chiffre
Revenons à la première phrase : le coût par inférence. Dépense totale en périphérie sur trois ans divisée par le nombre total d'inférences sur trois ans ; trafic cloud plus frais d'API divisé par le nombre total d'appels. Le plus petit nombre gagne. Le budget de latence décide de ce qui est possible, le coût par inférence décide de ce qui est économique, et le plan B hors-ligne décide de ce qui est survivable. Faites les trois calculs, et la réponse périphérie-vs-cloud s'écrit toute seule.
Par Da Liu, ingénieur en automatisation
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.