Commençons par la facture.
Apprendre à un robot de picking à reconnaître les cartons prend environ 100,000 images d'entraînement. Les étiqueter à la main, et les listes de prix publiques des prestataires situent le simple dessin de boîtes englobantes entre $0.10–$0.50 par image : $10,000–$50,000 pour le seul premier passage.
Trois mois plus tard, le fournisseur d'emballage change de carton, la lumière d'hiver modifie les reflets, et le modèle cesse de reconnaître la moitié des boîtes : 20,000 images de plus, quelques milliers de dollars en plus, envolés.
Donc cet article ne parle pas de réseaux de neurones. Il parle d'argent : comment les modèles de vision IA d'entrepôt sont entraînés, ce que coûte chaque route, où sont les pièges — et un problème d'arithmétique dans lequel brancher vos propres devis.
Commençons par la facture : comment les modèles de vision IA d'entrepôt sont entraînés se résume à trois routes
Les données d'entraînement des modèles de vision ont exactement trois sources : photographiées par des humains, dessinées par des humains, ou générées par des machines.
Route 1 : photos réelles + étiquetage humain. Photographier sur le quai d'entrepôt, dessiner les boîtes à la main — « ceci est un carton, ceci est une palette, ceci est un dommage ».
Route 2 : rendu par simulation CAO. Avec des dessins CAO 3D précis, faire tomber des pièces virtuelles dans un bac virtuel, randomiser l'éclairage, la quantité, les textures et le bruit, et rendre des centaines d'images. Les étiquettes se génèrent toutes seules — le moteur sait où se trouve chaque pièce ; le temps humain sert à régler les paramètres.
Route 3 : données synthétiques par IA générative. Pas besoin de dessins. L'IA générative « peint » directement des scènes d'entrepôt annotées — y compris les états moches : cartons écrasés, poussière, film étirable. Le tableau comparatif des coûts est ci-dessous ; une route à la fois d'abord.
Route 1 : photos réelles + étiquetage humain — la plus bête, la plus chère, la plus honnête
La route la plus ancienne, encore celle que suit la plupart des projets de vision en entrepôt. Pas de magie : photographier, dessiner des boîtes, contrôle qualité, entraîner.
Les calculs, d'après les listes de prix publiques des prestataires (Basic.ai) : $0.03–$1.00 par boîte, $0.10–$0.50 par image pour le travail simple. À 4 boîtes par image et $0.30/image, 100,000 images = $30,000 — avant le contrôle qualité, où la revue en double passage est la norme et un multiplicateur de coût total de 1.5–2x est normal.
En 2024, j'en ai chiffré un vrai : un site 3PL à Kunshan, des robots de picking, plus de 2,000 SKUs, 80,000 images prises. Devis du prestataire : $0.08 par boîte, 4 boîtes par image — 80,000 × 4 × 0.08 = $25,600 sur le papier. Avec la gestion de projet et environ 15% de reprises, la facture réelle a dépassé $30,000.
Six mois après la mise en service, le fournisseur de cartons est passé du kraft au carton blanc couché. La réflectivité a changé ; la reconnaissance a chuté de 6 points. 20,000 images de plus — près de $10,000 en plus.
La vérité sur la Route 1 : les données réelles ne sont pas un achat unique, c'est un abonnement. Chaque changement d'emballage, d'éclairage ou de saison peut déclencher une nouvelle ronde d'étiquetage. Vous ne signez pas un contrat ; vous signez une facture récurrente.
Sa vertu est réelle aussi : la fidélité. Les modèles entraînés sur des données réelles ont le plus petit écart sim-to-real — l'environnement d'entraînement et l'environnement de déploiement sont le même endroit.
Route 2 : rendu par simulation CAO — la moins chère quand on a les dessins
Avec des modèles CAO 3D précis, la vie devient simple : un outil de simulation fait tomber des pièces virtuelles dans un bac virtuel, fait varier la quantité, l'éclairage, les textures et le bruit de caméra, et rend des centaines d'images. L'annotation est gratuite — le moteur sait où se trouve chaque pièce.
Un article de mai 2026 de RoboticsTomorrow l'a bien résumé : avec un modèle CAO précis, c'est « l'approche la plus fiable et la moins gourmande en ressources » — le temps de l'ingénieur sert à régler les paramètres, pas à dessiner des boîtes.
Deux défauts fatals. D'abord, sans dessins, pas de fête — les pièces héritées, les composants fournisseurs et la dérive du construit ne donnent à la simulation rien sur quoi s'appuyer. Ensuite, les rendus sortent trop propres : les images réelles portent huile, rayures, lumières qui scintillent ; les rendus, non. Les modèles entraînés sur des données immaculées s'effondrent sur le terrain.
L'appel contre-intuitif : le problème de la simulation CAO n'a jamais été « pas assez réaliste » — c'est « trop propre pour être vrai ». Les entrepôts ne sont pas des salles blanches ; les modèles ne craignent pas le laid, ils craignent la saleté invisible.
Route 3 : données synthétiques par IA générative — ce que STRIPES de Zebra résout vraiment
La Route 3 est la réponse la plus chaude de 2026 à la question de savoir comment les modèles de vision IA d'entrepôt sont entraînés. Son porte-drapeau : le dataset STRIPES de Zebra (Sim-to-Real Industrial Perception for Warehouse Scenes), publié en septembre 2026.
Les chiffres : 30,000 images, 3,000 textures et géométries de boîtes uniques, un million de boîtes étiquetées — pas une seule dessinée par un humain.
Les trois innovations de STRIPES visent exactement les points faibles de la Route 2 : création d'images par IA générative sans modèles 3D statiques, pour que la diversité des scènes échappe à votre bibliothèque de dessins ; usure simulée — cartons écrasés, bosses, poussière de surface, film étirable — les états les plus sales de l'entrepôt, et l'étape la plus précieuse du pipeline ; et encombrement physique, où la simulation de la gravité empile les boîtes en configurations naturellement denses, inclinées, imbriquées à travers trois phases réelles : stockage en rayonnage, préparation au sol et chargement de camions.
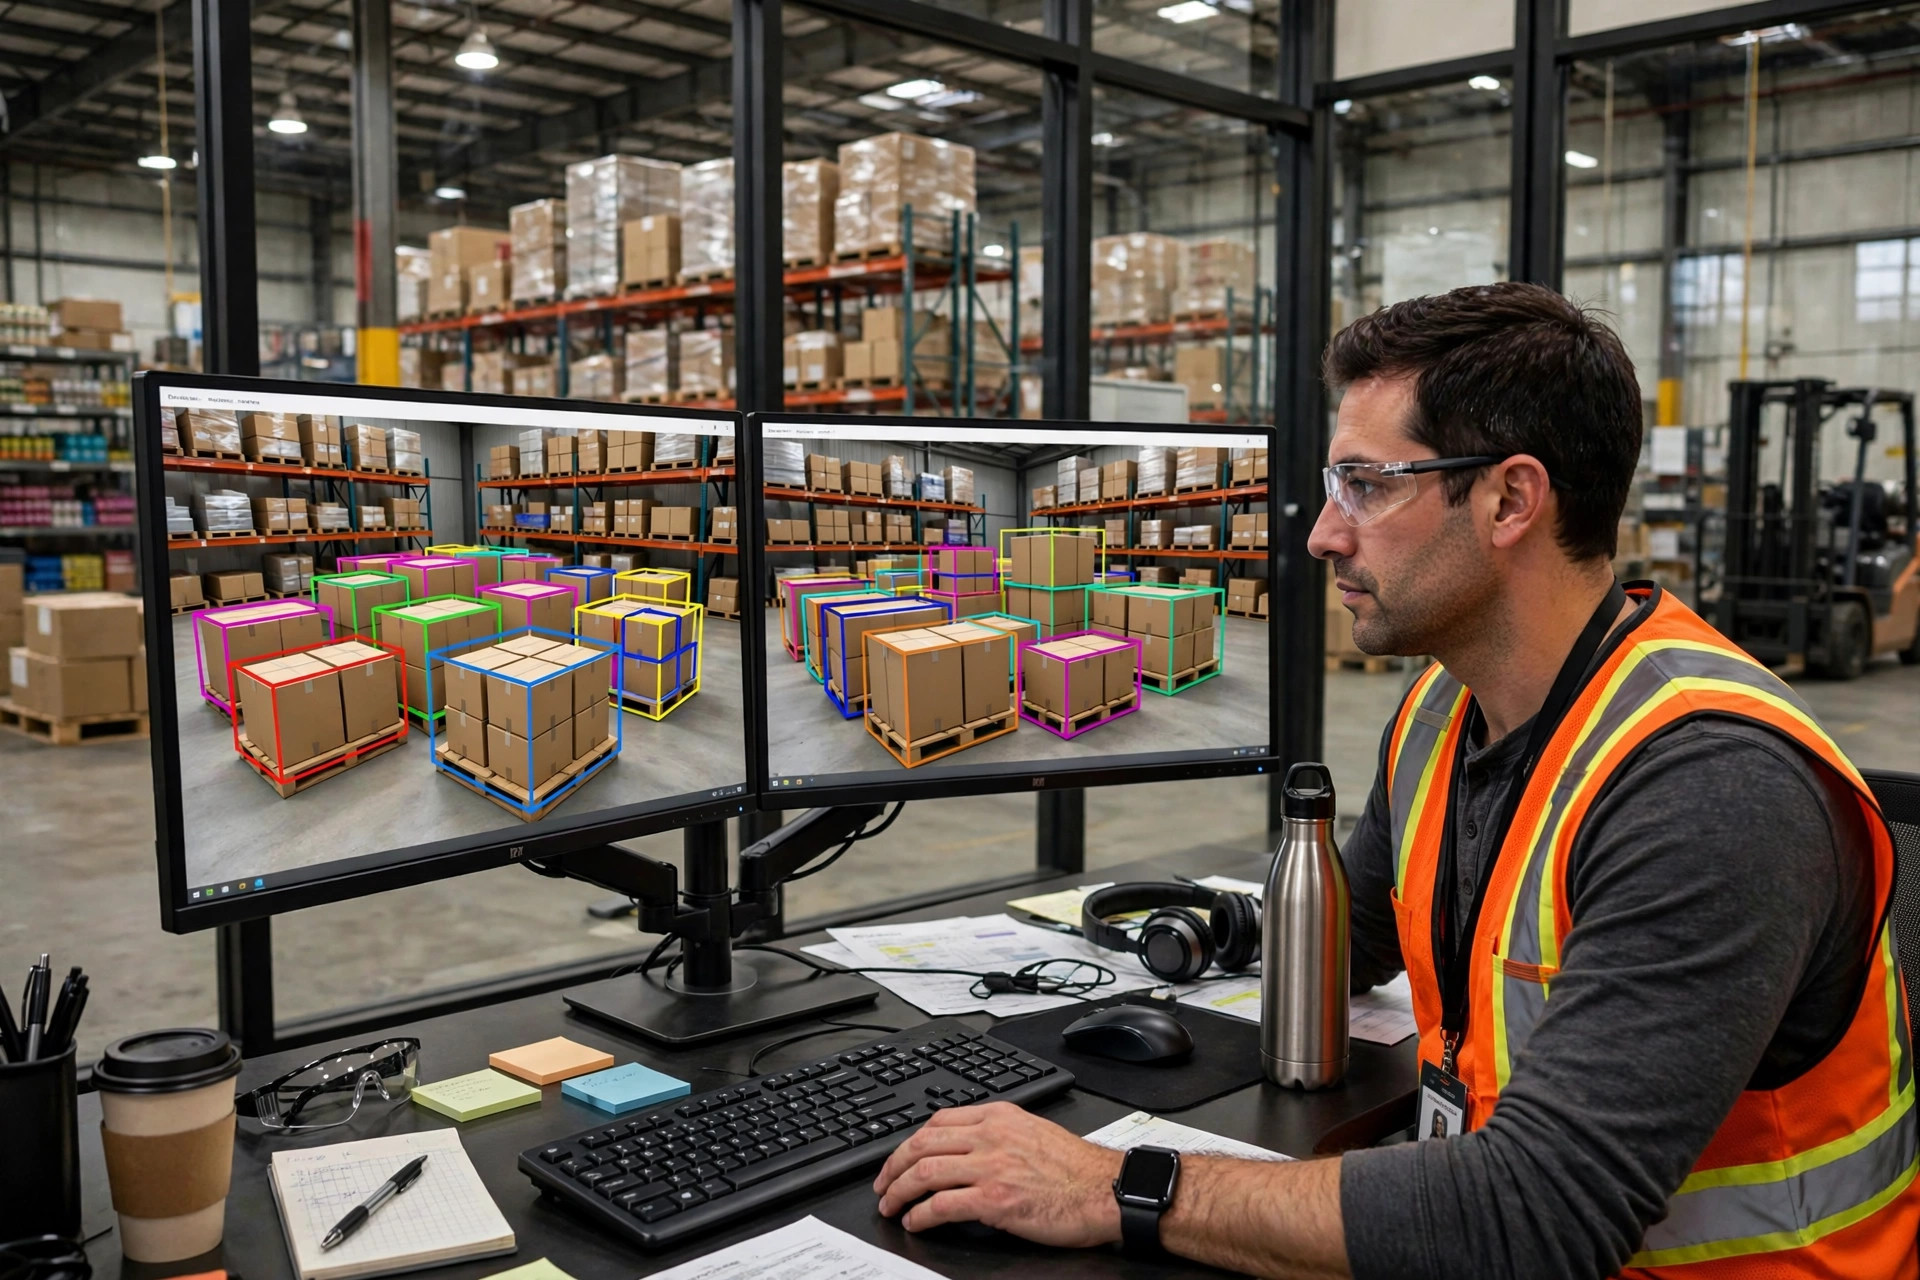
Vous voyez ? STRIPES ne résout pas « les données synthétiques ont-elles l'air réelles » mais « sont-elles assez sales ». Les données synthétiques n'ont pas besoin d'être plus jolies — elles doivent être plus sales. Un 99 en simulation ne veut rien dire ; ce qui compte, c'est combien de sortes de saleté le modèle y a vues.
Côté coût : 30,000 images et un million de boîtes, coût marginal en calcul, pas en main-d'œuvre. Mais la Route 3 exige le plus gros investissement fixe des trois — modèles génératifs, simulation physique, ingénierie du pipeline, tout d'avance. Les petits projets ne peuvent pas payer le ticket ; les gros deviennent moins chers avec l'échelle.
L'écart sim-to-real : 99 au labo, 92 sur le terrain
L'écart sim-to-real : la différence entre l'environnement d'entraînement et l'environnement de déploiement. En mai 2026, Robotics and Automation News a qualifié sa réduction de « l'un des objectifs les plus précieux de la robotique moderne ».
À quel point c'est brutal ? Septembre 2026 : Telexistence a affiné DreamZero de NVIDIA — un modèle prédisant actions et vidéo de caméra ensemble — pour le réassort en supérettes. Données de picking simulées propres : 45% de réussite. Enregistrements réels de téléopération : 0%. Cause racine : distributions conjointes et échelles d'état désalignées entre la simulation et la réalité.
45% à 0%, ce n'est pas « un peu à côté » — c'est un autre univers. L'écart n'est pas le nombre d'images ; c'est si les distributions s'alignent.
Steve Nemzer de TELUS Digital l'a bien dit en avril 2026 : utilisez les données synthétiques pour combler des écarts précis, mais ancrez l'entraînement sur des données réelles — elles ne peuvent pas apprendre à un modèle les artefacts de capteurs ni les conditions adverses de la production.
Ma traduction : les données synthétiques sont un pansement, pas la fondation. La fondation reste les données réelles ; les pansements couvrent la longue traîne qu'on ne peut pas photographier ou qu'on ne peut pas se permettre d'attendre.
Sur cette longue traîne : l'article du 7 octobre 2026 de ce site — « Échantillons d'anomalies qu'on ne peut pas photographier » — est le manuel pratique du pansement ; celui-ci est le panorama des trois routes avec la facture jointe.
Trois routes, un tableau
| Route 1 : réel + étiquetage humain | Route 2 : simulation CAO | Route 3 : synthétique génératif | |
|---|---|---|---|
| Coût marginal / image | $0.10–$0.50 (tarifs publics des prestataires) | Calcul de rendu, bien en dessous de l'humain | Calcul de génération, bien en dessous de l'humain |
| Investissement fixe | Faible (surtout main-d'œuvre de prise de vue) | Moyen (pipeline + réglage ingénieur) | Élevé (modèles génératifs + sim physique + pipeline) |
| Facture à l'échelle de 100K images | $10K–$50K, fois le multiplicateur QA de 1.5–2x | La plus basse avec dessins, coût fixe amorti | La moins chère à l'échelle ; les petits projets n'atteignent pas le seuil de rentabilité |
| Fidélité | La plus haute, plus petit écart | Moyenne — craint le « trop propre » | Moyenne-haute — STRIPES répare « la saleté » |
| Défaut fatal | Ne peut pas capturer la longue traîne ; ré-étiquetage à chaque changement de SKU / d'environnement — le coût est un abonnement | Morte sans dessins | Gros investissement initial ; non rentable à petite échelle |
Deux autres appels contre-intuitifs :
Premièrement, l'industrie de l'étiquetage de données est en train d'être dévorée par les modèles qu'elle entraîne. La pré-annotation par IA plus la revue humaine est désormais le manuel standard des prestataires ; le dessin manuel pur de boîtes se termine, et les prix unitaires continuent de baisser. Un grand contrat long terme en manuel pur aujourd'hui signifie probablement acheter au sommet.
Deuxièmement, les données les plus chères ne sont pas les frais d'étiquetage — ce sont les données qu'on ne peut pas capturer. Le coût marginal d'un échantillon d'anomalie de longue traîne tend vers l'infini : attendez trois mois et vous n'obtiendrez jamais une photo standard de « le chariot élévateur a démoli la palette ». Le vrai pouvoir de tarification des données synthétiques n'est pas le bon marché — c'est l'inachetable.
Le verdict de Lao Zhou : « comment les modèles de vision IA d'entrepôt sont entraînés » est un problème d'arithmétique
Quelle route ? Pas d'instinct — calculez. Total de la Route 1 ≈ N × p × q (N : images nécessaires ; p : devis par image, fourchette publique $0.10–$0.50 ; q : multiplicateur QA, 1.5–2). Total de la Route 3 ≈ F + N × m (F : investissement fixe du pipeline ; m : coût marginal par image, bien en dessous de p). Seuil de rentabilité N* = F ÷ (p × q − m) : passé N*, le synthétique gagne.
Exemple résolu (données illustratives — branchez vos propres devis) : F = $30,000, p = $0.30/image, q = 1.5, m ≈ $0.05/image. N* = 30,000 ÷ (0.45 − 0.05) = 75,000 images.
Le verdict : au-delà d'environ 75,000 images — ou avec une rotation rapide des SKUs et des environnements changeants poussant N toujours plus haut — la route synthétique paie. Sinon, restez sur l'étiquetage humain ; ne payez pas plus cher pour « plus avancé ».
Que l'argent ait été bien dépensé, la formule décide.
Par Lao Zhou, analyste des coûts logistiques
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.