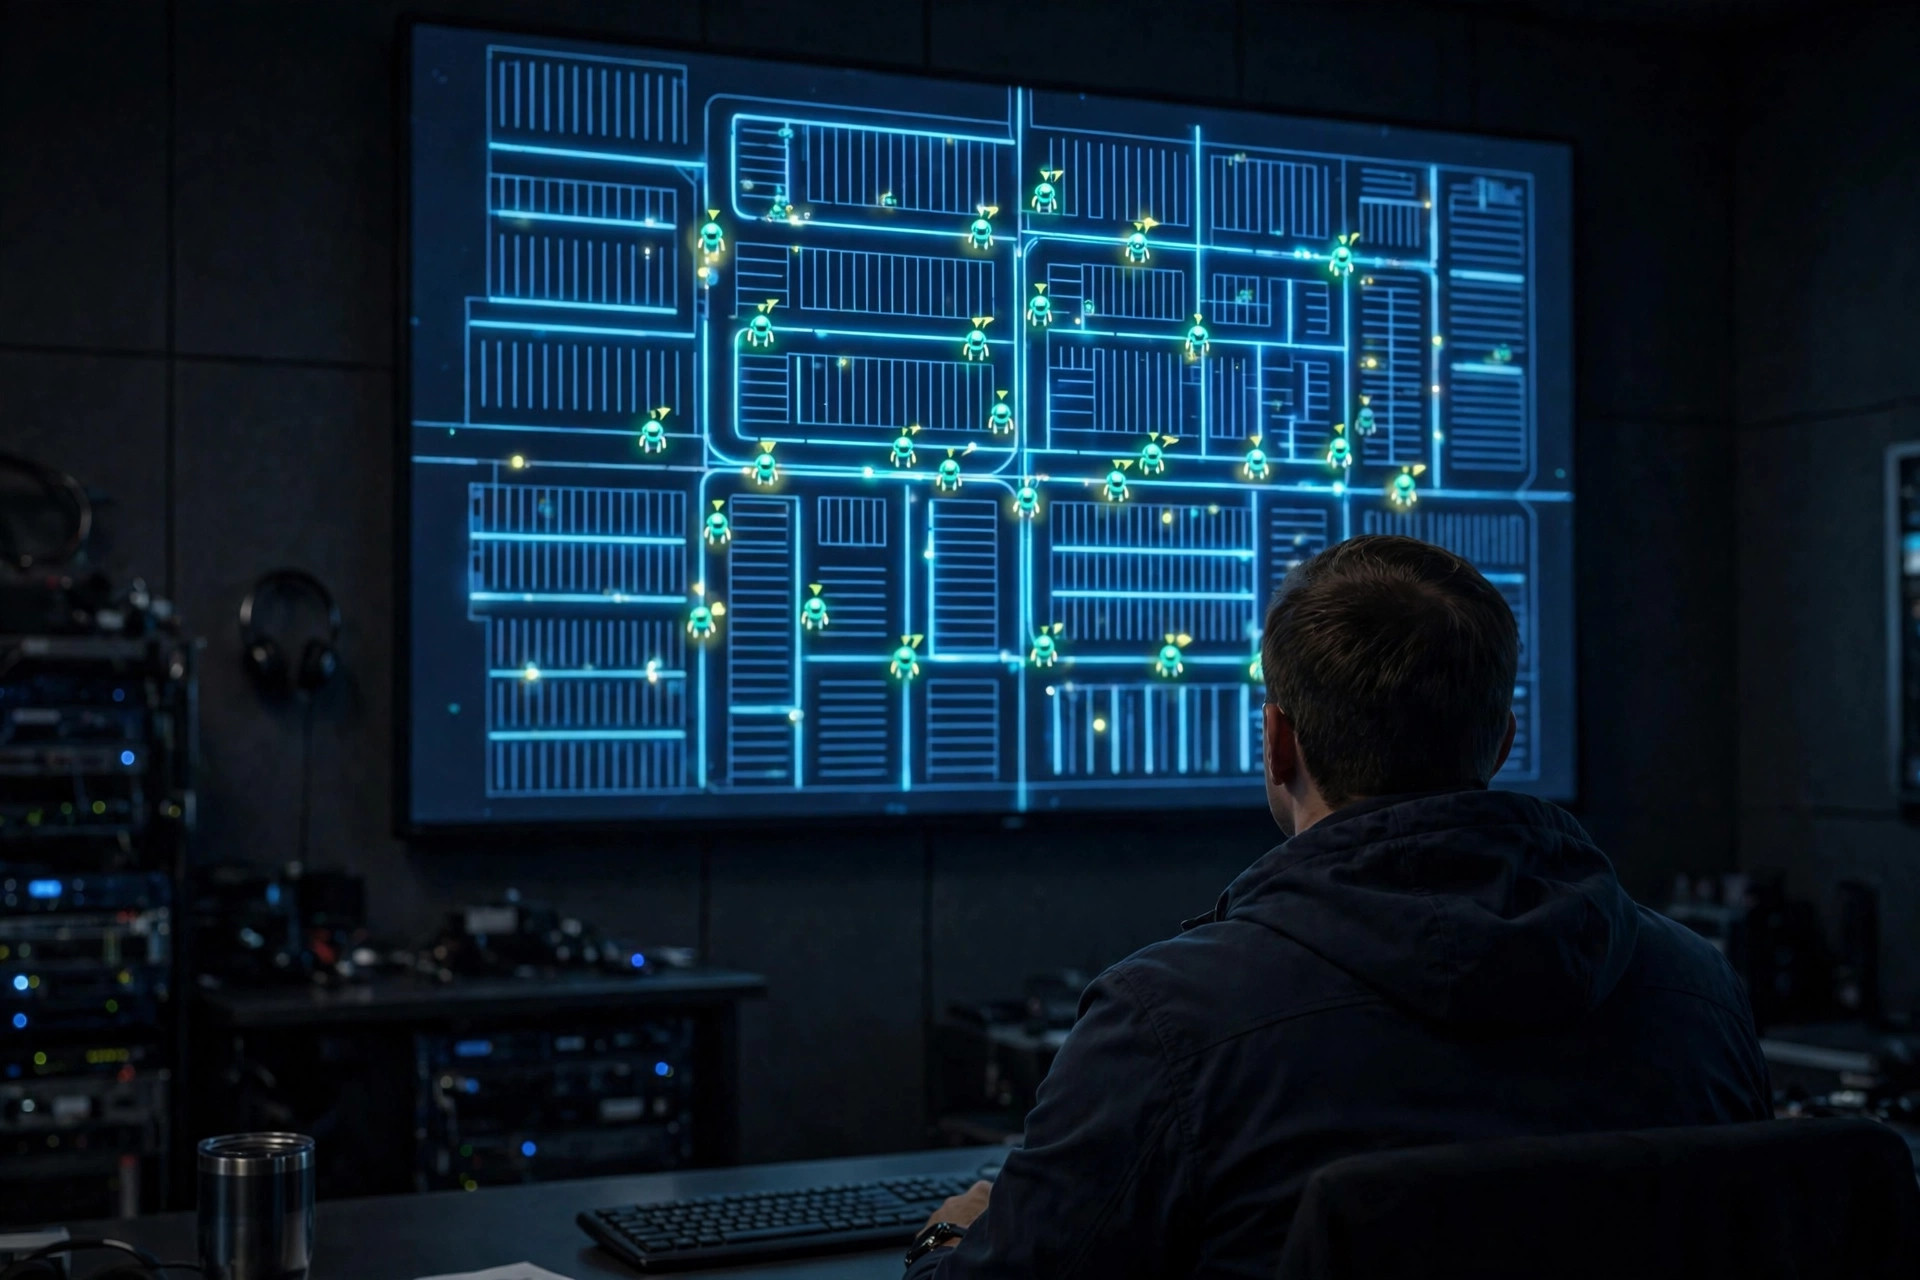
Demandez à n'importe quel fournisseur d'AMR ce qui se passe quand le réseau tombe, et regardez la salle se taire. La démo montre toujours le chemin heureux : des robots qui glissent, des tâches qui se distribuent, le tableau de bord qui brille en vert. Personne ne fait la démo de l'appel téléphonique de 2 h du matin. Mais j'ai reçu cet appel, et la différence entre une mauvaise nuit et un désastre n'a jamais été les robots — c'étaient trois réglages auxquels personne n'avait pensé.
L'hiver dernier, un centre de distribution près de Chicago a perdu son RCS pendant une quinzaine de minutes lors d'un redémarrage de routine d'un commutateur. Une vingtaine de robots se sont figés au milieu de l'allée. L'équipe de nuit a fait ce que font les gens non formés : elle a commencé à redémarrer les robots un par un, ce qui n'a fait qu'embrouiller davantage les états des tâches. Quand le réseau est revenu, la moitié de la flotte affichait "offline" et l'autre moitié "task exception", et il a fallu près de deux heures pour démêler tout ça. Les robots allaient bien. C'est le plan qui manquait.
Voici la vérité qui dérange : le lien robot-RCS est le lien cerveau-corps, et chaque fournisseur livre des valeurs par défaut différentes pour ce que fait le corps quand le cerveau se tait. Si ces valeurs ne sont pas dans votre contrat, vous achetez une surprise.
Personne ne teste le réseau avant qu'il meure
Le premier réglage, c'est le comportement en cas de perte de liaison : combien de temps sans battement de cœur avant que le robot déclare le réseau mort, et ce qu'il fait ensuite. Un délai trop court et chaque microcoupure Wi-Fi déclenche un arrêt d'urgence sur tout l'étage. Un délai trop long et un réseau vraiment mort laisse les robots rouler sur des instructions périmées.
Après le délai, les fournisseurs proposent généralement deux philosophies. La conservatrice : s'arrêter où l'on est et attendre. Elle convient aux bâtiments avec un trafic mixte humains-robots et des allées complexes. L'agressive : passer en mode local, terminer la tâche en cours à partir du cache de carte embarqué, puis se garer quelque part à l'écart. Ça semble plus malin, mais il y a un piège — la carte locale doit être à jour. Si le RCS venait d'émettre une zone d'exclusion temporaire et que le robot ne l'avait pas synchronisée avant la coupure, le mode local le conduira droit dans une allée bloquée.
Mon avis : les bâtiments à trafic mixte doivent s'arrêter sur place ; les lignes de production fermées à itinéraire fixe peuvent envisager la poursuite en local. Dans tous les cas, la vitesse réduite n'est pas négociable — un robot qui roule à l'aveugle doit rouler plus lentement que d'habitude. Mettez-le par écrit dans vos critères d'acceptation.
Et un mot sur le réseau lui-même : la plupart des "pannes" ne sont pas des réseaux morts, ce sont des zones mortes. Un robot qui se déplace entre deux points d'accès rate le transfert, le battement de cœur s'interrompt quelques secondes, et le RCS le déclare perdu. Câblez les serveurs RCS — ne les obligez pas à se battre avec les robots pour le Wi-Fi. Ajoutez de la redondance à la couverture des AP, et vérifiez les coins et l'arrière des grands racks. Avant la mise en service, faites circuler la flotte dans tout le bâtiment pour un test d'itinérance et corrigez d'abord les points faibles. Ça bat de loin le réglage des délais après coup.
Les trois réglages enfouis dans votre contrat
Le deuxième réglage, c'est la file de tâches : ce que le robot retient, et qui gagne la dispute quand le réseau revient. À bord, un robot met généralement en cache sa tâche en cours plus une ou deux tâches en file — la profondeur du cache varie selon le fournisseur. Un cache peu profond signifie qu'une coupure de plus de quelques minutes efface la liste des tâches, et le RCS doit tout redistribuer après la reprise. Un cache profond signifie que le robot continue à travailler de mémoire un peu plus longtemps.
Le vrai piège, c'est le moment des retrouvailles. Le RCS se réveille en se souvenant du monde tel qu'il était avant la coupure ; les robots conservent le travail accompli pendant la coupure. Certains systèmes réconcilient côté robot — le robot rapporte, le RCS accepte, les tâches reprennent où elles se sont arrêtées. D'autres réconcilient côté RCS — tout ce qui vient de la fenêtre de panne est annulé et redistribué. Dans cette seconde conception, la palette qu'un robot a déjà livrée à la ligne apparaît comme "not delivered", et le système en envoie une autre. Double livraison, deux palettes à la ligne, et une dispute sur la faute de qui.
Donc avant de signer : quand le réseau se rétablit, quel état de tâche l'emporte, et comment les exécutions en double sont-elles dédupliquées ? Faites figurer les deux réponses dans une annexe du contrat. Pendant la sélection, ne vous contentez pas de regarder la démo du chemin heureux — demandez au fournisseur de faire la démo d'une coupure réseau de cinq minutes et de la reprise, et regardez si la logique de réconciliation tient la route. L'hésitation lors de cette démo dit tout.
Le troisième réglage, c'est la prise de contrôle manuelle : qui est autorisé à passer un robot en manuel, comment, et ce qui se passe après. Quand la panne s'éternise, quelqu'un sur le terrain pensera toujours "je vais juste le conduire moi-même". Sans règle, vous avez trois équipes qui font trois choses différentes — pousser les robots, les redémarrer, arracher les batteries. J'ai vu exactement ça une fois : après la reprise, personne ne pouvait dire quels robots étaient en pleine tâche et lesquels étaient simplement perdus, parce que des humains avaient touché la moitié de la flotte.
La solution est ennuyeuse et essentielle : nommez un commandant de panne par équipe, généralement le chef d'équipe. Personne d'autre ne touche un robot — ni déplacements manuels, ni cycles d'alimentation. Après la reprise, le commandant parcourt une liste de contrôle, confirme l'état de chaque robot, et alors seulement donne l'ordre de reprise. Écrivez-le dans le manuel d'exploitation et enseignez-le à l'intégration. Et gardez le privilège restreint : l'autorité du mode manuel revient aux chefs, pas à tout le monde. Les opérateurs ont besoin de visibilité sur le statut, pas des clés.
Ce qui m'amène au test d'acceptation qui compte le plus. Pendant la semaine de mise en service, débranchez pour de vrai — pas un diaporama, pas une démo de laboratoire, mais le vrai câble réseau, dans votre vrai bâtiment, pendant la vraie production. Observez chaque robot : combien de secondes pour déclarer la perte, s'arrêter ou continuer, jusqu'où il va, si les tâches se réconcilient à la reprise, si quelque chose est redistribué en double. Notez tout. Ce document est la première ébauche de votre manuel de panne.
Puis refaites-le chaque trimestre, comme un exercice d'incendie. Le matériel réseau vieillit, le RCS est mis à jour, le firmware des robots change — n'importe lequel peut silencieusement inverser une valeur par défaut. Choisissez une fenêtre de faible production, débranchez le câble pendant dix minutes, et confirmez que le manuel fonctionne toujours.
Une panne n'est pas le désastre. Découvrir votre plan de secours pour la première fois en pleine haute saison, si. Répétez-le avant d'en avoir besoin, et les appels de 2 h du matin deviennent beaucoup plus courts.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.