
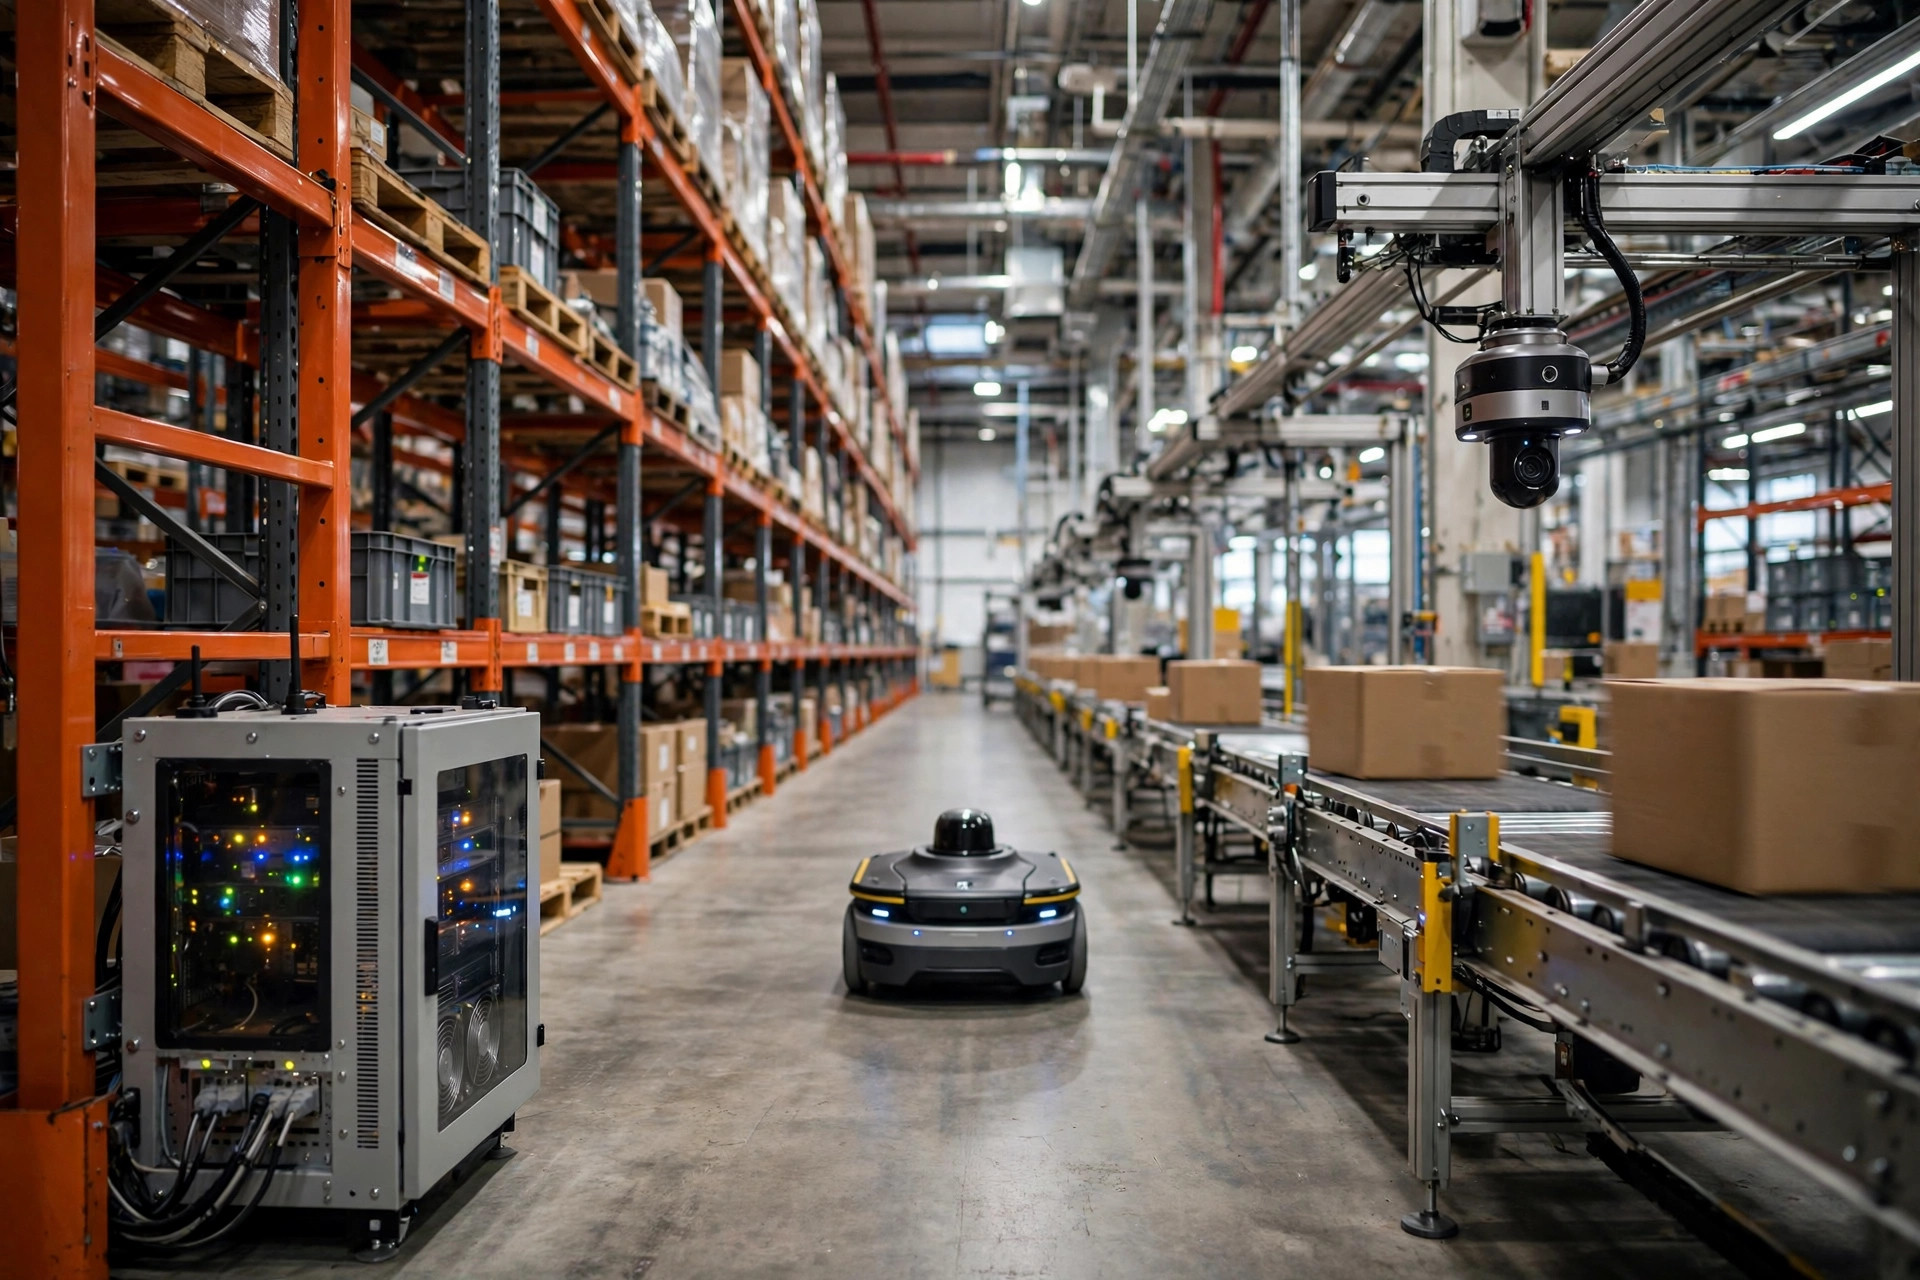
L'année dernière, j'ai visité un entrepôt de commerce électronique à Riverside qui venait d'installer un système d'inspection par vision : six caméras au-dessus du convoyeur, vérifiant les étiquettes des colis pour détecter dommages et mauvaise application. L'installation exécutait l'inférence dans le cloud : les flux vidéo poussés vers un cloud public, traités par GPU, les résultats renvoyés. Dès la première semaine d'exploitation, ça a lâché : aux heures de pointe, les résultats arrivaient avec un temps de retard, les vérins pneumatiques de rejet n'ont jamais reçu le signal, et une douzaine de colis problématiques sont partis tout droit dans les goulottes de tri. Le responsable informatique m'a dit : « Personne n'a mentionné la latence avant la signature du contrat ».
Mon verdict d'abord : pour l'IA dans un entrepôt, l'écart entre 10 ms et 300 ms n'est pas un problème d'expérience utilisateur, c'est un problème de savoir si ça peut fonctionner du tout. L'endroit où vous déployez l'inférence décide si votre IA est un actif de production ou un ornement coûteux.
Les maths de la latence
La caméra capture une image, l'envoie au cloud, l'inférence tourne, le résultat revient : typiquement 100–300 ms aller-retour, et c'est un bon jour. Vous savez ce que valent les réseaux d'entrepôt : les rayonnages métalliques sont un bloqueur de signal naturel, les zones mortes Wi-Fi sont partout, et la congestion de la haute saison peut doubler la latence.
Déploiement en edge ? Un boîtier edge robuste avec calcul GPU posé dans une armoire près de la ligne exécute l'inférence en 10–50 ms. De la caméra au boîtier via le réseau local, parfois en connexion directe.
Trois règles strictes pour quand l'edge est obligatoire :
Premièrement, le contrôle en boucle fermée. Rejet, tri, évitement d'obstacles des AMR : tout ce où « l'IA termine et la machine doit bouger tout de suite ». À une vitesse de bande de 2 m/s, 300 ms de latence signifient que le colis a déjà avancé de 0.6 m. Vous avez raté le point de déviation.
Deuxièmement, tout ce qui touche à la sécurité. Dans les zones mixtes piétons-véhicules, faire passer l'évitement par vision des AMR par le cloud, c'est confier vos freins à la gigue du réseau. Mon verdict : edge, sans discussion.
Troisièmement, l'inférence haute fréquence. Une caméra à 30 fps, 16 heures par jour : la facturation cloud à l'appel API ou à l'heure GPU devient vite effrayante. Un boîtier edge est un investissement unique dont le coût par inférence baisse à mesure qu'on l'utilise.
À quoi le cloud sert-il vraiment ? L'entraînement, l'itération des modèles, les tableaux de bord, l'analytique multi-sites. Des tâches sans pression temporelle qui ont besoin de calcul élastique. C'est le terrain de jeu du cloud.
Bande passante et argent : les lignes oubliées
La plupart des gens chiffrent la ligne GPU et oublient la bande passante. Une caméra 1080p en encodage H.264 pousse environ 4–8 Mbps en montant. Cinquante caméras : 200–400 Mbps de montée en continu. Vous savez ce que coûte par mois une ligne dédiée d'entrepôt. Pire encore, la fiabilité : une coupure de circuit et l'inférence de toutes les caméras tombe en même temps.
Les besoins en bande passante de l'edge sont proches de zéro : la vidéo ne quitte jamais le bâtiment, seuls montent les résultats d'inférence (quelques Ko de JSON) et les captures d'alerte. Si internet tombe, la ligne continue de tourner ; au pire, les alertes arrivent en retard.
Voici comment je décompose l'argent. Le cloud, c'est du paiement à l'usage, bien pour les charges petites ou irrégulières ; l'edge, c'est un investissement fixe plus amortissement, bien pour du 24/7 en continu. La ligne de partage est facile à calculer : listez votre facture annuelle d'inférence cloud (GPU + bande passante + transfert de données) et comparez-la à l'achat de boîtiers edge, l'amortissement sur trois ans, l'énergie et la maintenance. Ma règle de pouce : au-dessus de 20 flux caméra en inférence continue, l'edge gagne presque toujours. En dessous de 10 flux avec un faible taux d'utilisation (quelques heures de contrôle qualité par jour), le cloud est le choix sans tracas.
Un piège : les fournisseurs cloud ont plus de lignes de facturation qu'on ne l'imagine : heures GPU, stockage, appels API, sortie de données. Obtenez des devis écrits pour les quatre avant de signer. En cas de doute, faites confirmer par écrit par e-mail. Ne croyez pas le « à peu près » du commercial.
Mon guide de déploiement : trois niveaux
Pas de solution unique pour tout. Je divise les déploiements en trois niveaux :
Niveau un, edge pur : tri par vision, rejet, navigation et évitement d'obstacles des AMR, vérification en temps réel pour le pick-to-light. Ceux-ci reçoivent des boîtiers edge qui continuent de tourner si le réseau meurt. Côté matériel : attention à la chaleur et à la poussière : les entrepôts dépassent couramment les 35°C en été, et les GPU grand public n'y survivront pas. Prenez du matériel industriel ou au moins à large plage de température.
Niveau deux, inférence en edge plus entraînement cloud : c'est le modèle dominant. L'edge exécute l'inférence ; les échantillons difficiles repartent vers le cloud ; le cloud réentraîne et redistribue les modèles mis à jour. Stratégie d'envoi : n'envoyez jamais tout. N'envoyez que les échantillons dont le modèle n'était pas sûr (faible confiance) et vous réduisez la bande passante de plus de 90%.
Niveau trois, cloud pur : prévision de la demande, suggestions de réapprovisionnement, tableaux de bord d'exploitation, reporting multi-entrepôts. Aucune exigence temps réel, et le calcul élastique du cloud avec ses outils de données prêts à l'emploi sont de vrais atouts.
Un détail d'exploitation : une fois qu'on a plus d'une poignée de boîtiers edge, la gestion des versions de modèles devient chaotique. Exigez des mises à jour OTA à distance et le retour en arrière. N'envoyez pas des ingénieurs faire le tour avec des clés USB. J'ai vu un entrepôt avec 12 boîtiers edge tournant sur 4 versions de modèle différentes ; le dépannage a pris une semaine.
Séquence de déploiement : ne couvrez pas tout le bâtiment le premier jour
La plus grosse erreur que je vois dans les premiers déploiements de vision IA, c'est de tout miser sur l'ensemble du site. Mon déploiement en trois étapes :
Étape un, pilote sur un seul point. Choisissez votre ligne la plus douloureuse — contrôle qualité des retours ou inspection des étiquettes — avec juste 2–4 caméras et un boîtier edge. Faites tourner le pilote 4–6 semaines. L'objectif n'est pas encore d'économiser de l'argent ; c'est de produire trois tableaux : latence, précision et taux de faux positifs. Si les faux positifs dépassent 5%, le personnel au sol commence à ignorer les alertes — surveillez ce chiffre comme un faucon.
Étape deux, fermez la boucle d'itération du modèle. Une fois le pilote stable, branchez le pipeline de remontée inférence en edge plus entraînement cloud. Côté travail d'étiquetage : les échantillons difficiles peuvent atteindre des centaines par jour, et quelqu'un doit les étiqueter. Mon approche : le personnel de contrôle qualité étiquette au fil de l'eau — le système pousse les captures de faible confiance sur une tablette, l'opérateur touche « juste/faux », et l'étiquetage ne coûte pratiquement rien.
Étape trois, répliquez. N'étendez aux autres lignes que lorsque la précision est stable au-dessus de 98% et les faux positifs sous les 3%. À ce moment-là, vous achetez les boîtiers edge en volume, ce qui réduit typiquement le coût unitaire de 15–20% supplémentaires.
Une dernière note pratique : la modernisation du réseau dans les bâtiments anciens. L'edge est indulgent avec les réseaux, pas dispensé d'eux : tirez des connexions câblées des caméras au boîtier edge ; ne faites pas d'économies de bout de chandelle sur le Wi-Fi pour tout. Quelques milliers de dollars de câblage par ligne, ce n'est rien à côté d'une année de bande passante cloud.
Une action que vous pouvez prendre dès demain : listez chaque scénario IA en cours (ou prévu) dans votre entrepôt et notez chacun sur trois colonnes : exigence de latence, fréquence d'inférence, nombre de caméras. Tout ce qui a besoin de <100 ms va en edge. Faible fréquence, peu de caméras va au cloud. Le milieu reçoit l'hybride : inférence en edge plus entraînement cloud. Une fois ce tableau fait, aucun fournisseur ne pourra vous enfumer sur l'architecture.
Votre IA d'entrepôt tourne-t-elle en edge ou dans le cloud ? La latence vous a-t-elle déjà brûlé ? Dites-le-moi en commentaires.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.





