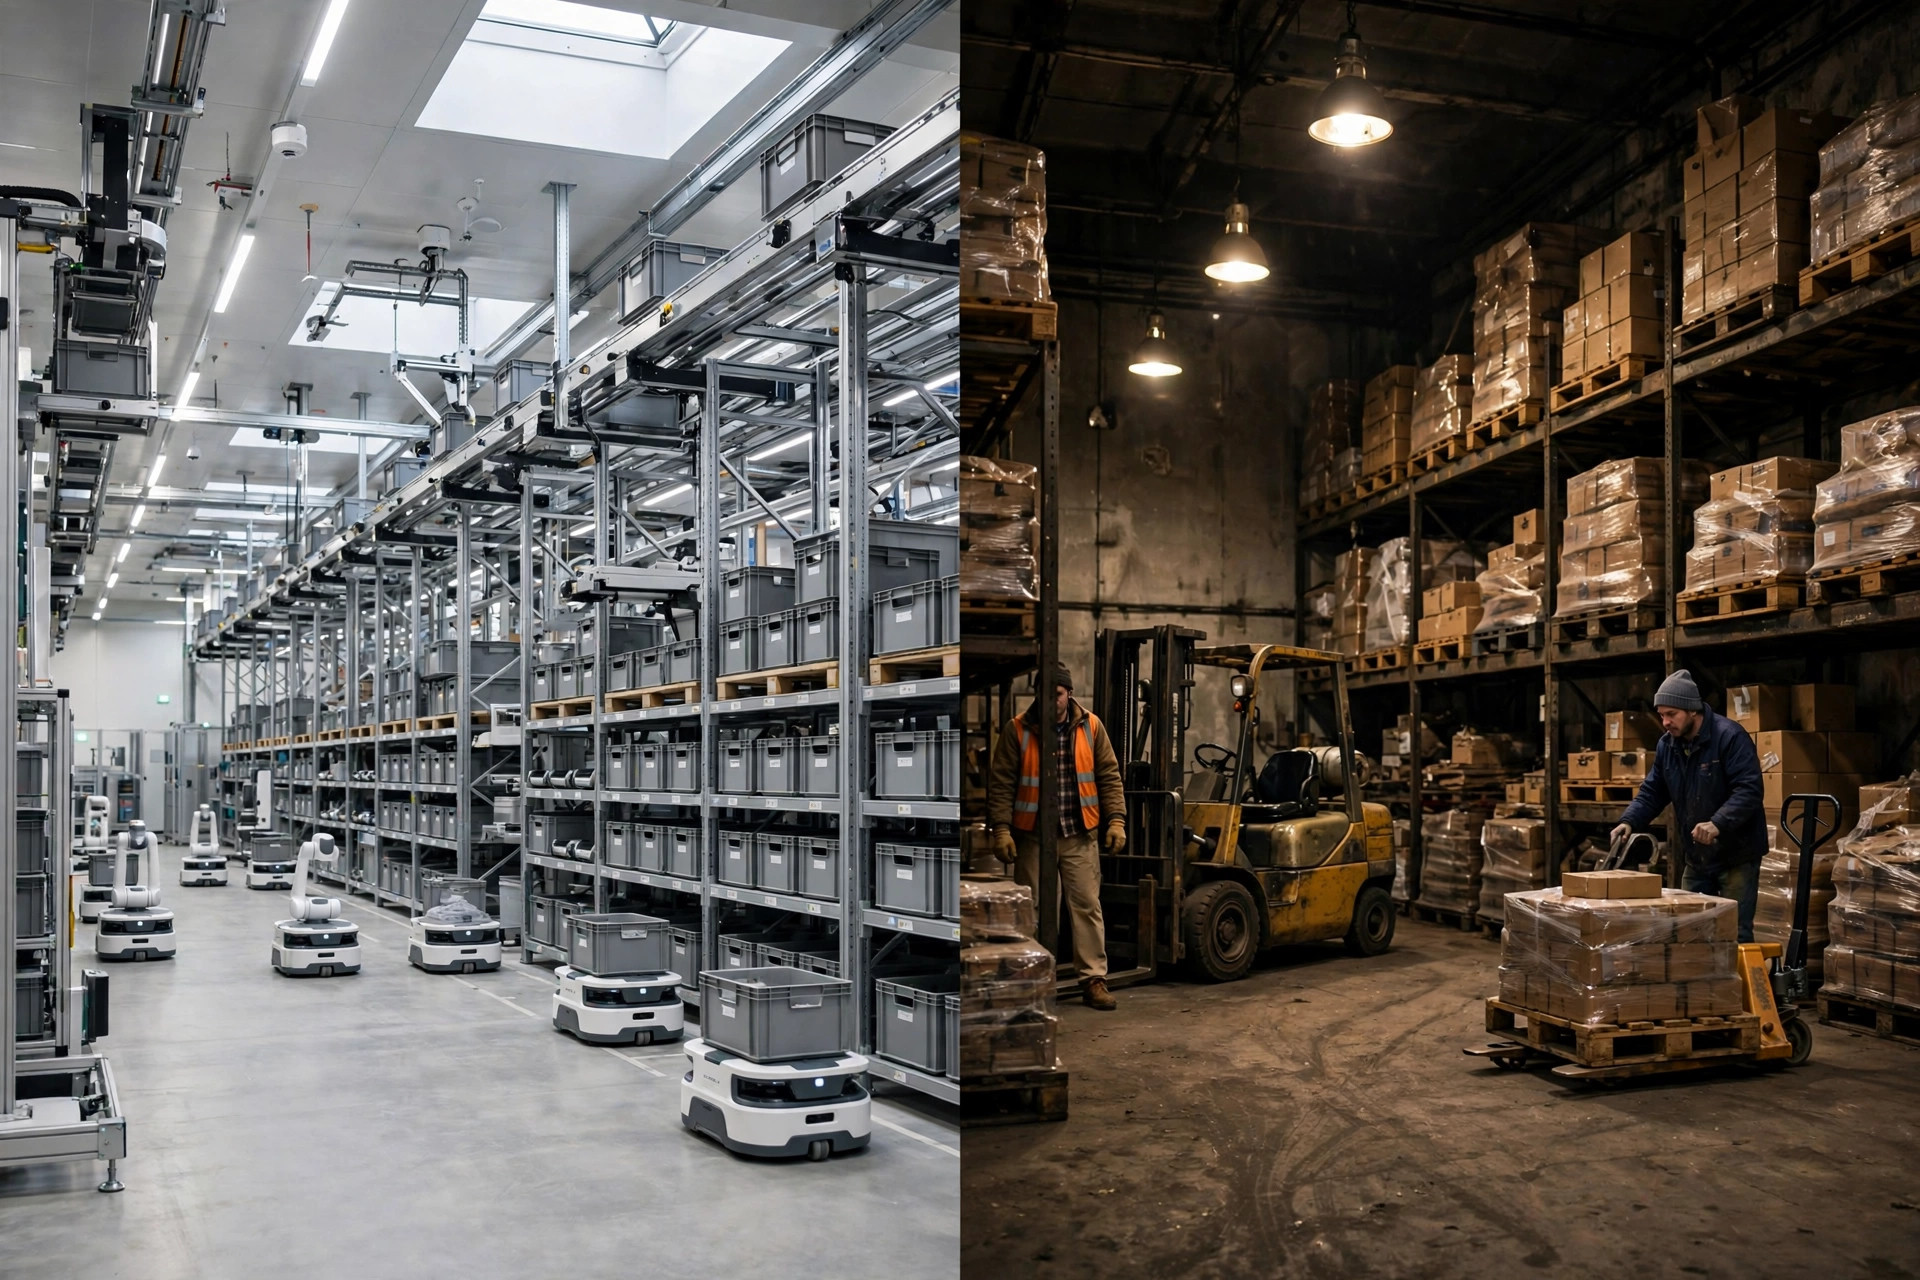
Au cours des deux dernières années, lors d'entretiens avec plus d'une vingtaine d'entreprises d'entreposage et de distribution qui ont mené des pilotes d'IA, j'ai remarqué un schéma d'une régularité frappante : le pilote atterrit presque toujours dans la meilleure installation de l'entreprise — le centre de distribution phare avec le réseau le plus stable, les données de base SKU les plus propres, les processus les plus standardisés, la main-d'œuvre la plus coopérative et la direction la plus favorable. La logique semble impeccable : placer le pilote là où le succès est le plus probable, démontrer le concept, puis le répliquer. Pourtant, six à douze mois plus tard, lorsque ces entreprises déploient la solution sur leurs deuxième et troisième sites, un phénomène tout aussi régulier apparaît : les chiffres impressionnants du pilote se réduisent dramatiquement, et certains projets sont discrètement mis de côté pendant le déploiement. Le pilote a "réussi", mais le déploiement a échoué. Ce paradoxe mérite un examen plus attentif.
Les chiffres : un fossé entre le pilotage et la mise à l'échelle
Selon le rapport du MIT Project NANDA "The GenAI Divide: State of AI in Business 2025", publié en août 2025, environ 95% des pilotes d'IA générative en entreprise n'ont produit aucun retour mesurable sur le compte de résultat ; seulement environ 5% des organisations ont capturé une valeur réelle à l'échelle. Une remarque sur la méthodologie s'impose ici : le chiffre de 95% utilise toutes les organisations interrogées comme dénominateur, tandis que parmi les organisations qui ont réellement mené des pilotes, environ une sur quatre a fini par atteindre l'échelle de production. Quoi qu'il en soit, la conclusion tient — un large fossé sépare le pilotage de la mise à l'échelle, et la plupart des organisations ne le franchissent jamais. Mon observation est que la première marche de ce fossé est souvent posée au moment où le site du pilote est choisi : la sélection du site est en elle-même une forme d'échantillonnage, et piloter dans votre meilleur entrepôt est, en termes statistiques, un échantillon biaisé.
Pourquoi le meilleur entrepôt est le pire échantillon de pilote
Trois mécanismes expliquent le paradoxe.
Premièrement, la confusion des dotations. Les avantages inhérents au site phare — données propres, processus standardisés, réseaux stables, équipe coopérative — font paraître toute solution plus efficace qu'elle ne l'est. Les statisticiens appellent cela le biais de sélection : vous croyez mesurer l'effet de l'IA, mais vous mesurez en réalité l'effet combiné d'"un grand entrepôt plus l'IA", et vous attribuez le tout à l'IA. Une part significative du ROI du pilote est payée par la dotation de l'entrepôt, et non par l'algorithme.
Deuxièmement, la distorsion des ressources. Une période de pilote est inhabituellement dorlotée : des ingénieurs du fournisseur stationnés sur place, des chefs de projet du siège qui font le suivi quotidiennement, les meilleures personnes de l'entrepôt réaffectées pour soutenir les tests. Ces apports cachés n'apparaissent jamais au dénominateur des coûts du pilote, mais ils sont réels, et ils gonflent véritablement la performance du pilote. Lorsque les ressources sont retirées pendant le déploiement, la performance régresse — non parce que l'IA est tombée en panne, mais parce que les conditions de serre ont disparu.
Troisièmement, le biais de survie dans le récit. Les pilotes aux beaux chiffres deviennent des études de cas racontées et re-racontées ; les pilotes médiocres sont discrètement fermés et plus jamais mentionnés. Les chiffres de "ROI du pilote" qui circulent dans l'industrie proviennent d'un échantillon filtré qui surestime systématiquement la réalité — et renforce à son tour l'instinct apparemment évident de piloter dans le meilleur entrepôt.
Considérons le premier cas. Au second semestre 2024, un 3PL a lancé un pilote d'audit basé sur la vision par IA dans son entrepôt phare près de Suzhou. Après trois mois, la précision des audits est passée de 99.2% à 99.6%, les interceptions d'exceptions ont presque doublé, et l'équipe du projet a estimé des économies de main-d'œuvre annualisées d'environ RMB 400,000. Le pilote a été noté comme un "succès au-delà des attentes". Début 2025, le même équipement et la même version de l'algorithme ont été déployés dans des entrepôts régionaux à Wuxi et Hefei — la précision s'est améliorée de moins de 0.1 point de pourcentage, essentiellement du bruit. L'autopsie a révélé la différence clé : les stations d'audit du phare avaient été rénovées en 2023, avec un éclairage uniforme et des palettes et bacs entièrement standardisés, tandis que les sites régionaux avaient un éclairage vieillissant et un mélange désordonné de tailles de cartons. Ce que le modèle de vision avait "appris" pendant le pilote, c'était la signature visuelle d'un environnement standardisé. En d'autres termes, le pilote n'a pas mesuré la capacité de généralisation de l'algorithme, mais l'amabilité de l'environnement du pilote.
Le deuxième cas vient du premier trimestre 2025, lorsqu'une chaîne de distribution américaine a piloté une IA de prévision de la demande dans son centre de distribution phare près de Dallas, desservant environ 120 magasins, avec une exhaustivité des données de base SKU de 98%. Six mois plus tard, l'erreur de prévision (MAPE) avait baissé d'environ 4 points de pourcentage et les taux de rupture de 1.2 point ; le verdict était "succès, déploiement recommandé". Répliqué dans deux centres de distribution du Midwest — où l'exhaustivité des données de base dépassait à peine 80% et les enregistrements de promotions étaient lacunaires — le modèle n'a livré qu'environ 30% des gains du pilote. L'équipe a alors relancé le pilote dans un entrepôt délibérément "moyen" : lacunes de données, exceptions de processus, coopération tiède. Les chiffres étaient moins flatteurs que ceux du premier pilote, mais la liste de contrôle de gouvernance des données et le manuel de déploiement construits à partir de ce deuxième pilote ont atterri avec succès dans les quatre entrepôts suivants du premier coup. Le chef de projet l'a dit simplement : le premier pilote a prouvé que l'IA pouvait fonctionner dans des conditions idéales ; le deuxième a prouvé qu'elle pouvait fonctionner dans nos conditions réelles. La direction n'avait jamais besoin que de la deuxième preuve.
Voici l'inférence inconfortable : un pilote dont le ROI dépasse les attentes mérite un examen minutieux supplémentaire, et non une célébration, car la surperformance peut devoir moins à l'IA qu'au fait que le site du pilote était inhabituellement bon. Un pilote mené dans un entrepôt en dessous de la moyenne, avec des chiffres 20-30% plus laids, mesure le plancher de la solution ; un pilote mené dans le phare ne mesure que son plafond. Ce que la direction veut réellement n'a jamais été le "succès du pilote" mais le "succès du déploiement" — et la logique de sélection du site pour ces deux objectifs pointe dans des directions opposées : la première recherche la sécurité, la seconde recherche la vérité.
Trois lignes pour la sélection du site du pilote
| Type de site | Profil typique | Stratégie de pilote |
|---|---|---|
| Phare (meilleures conditions) | Données propres, processus standardisés, biais de ressources | Valider uniquement la faisabilité technique ; ne prendre aucun engagement de ROI ; étiqueter les conclusions comme une "référence de plafond" |
| Site représentatif de niveau intermédiaire (recommandé) | Échelle, mix de SKU et main-d'œuvre proches de la moyenne de l'entreprise | La scène principale de la mesure du ROI ; les conclusions peuvent directement soutenir les décisions de déploiement |
| Site archétypal problématique | Un point douloureux réel représentatif, p. ex. erreurs d'audit élevées ou ruptures chroniques | Valide si la solution corrige de vrais problèmes ; attribution la plus propre de la cause à l'effet |
| À éviter : sites nouveaux, en déménagement ou sous stress de pic | Lignes de base instables, trop de variables | Inadaptés aux pilotes ; les résultats ne peuvent pas être attribués |
Un élément de plus mérite d'être ajouté : un contrôle. Si possible, désignez un "contrôle fantôme" — un site comparable dans la même région qui ne reçoit pas l'IA mais enregistre les données de base sur la même période — ou menez des comparaisons par catégorie ou par période au sein du même entrepôt. Un ROI de pilote sans groupe de contrôle est, en toute rigueur, un chiffre infalsifiable ; son pouvoir de persuasion n'existe que dans la présentation de diapositives.
Un changement déjà en cours
Alors que les dépenses d'IA des entreprises passent de la phase d'expérimentation à la phase de mise à l'échelle, la méthodologie des pilotes change. La logique initiale était "d'abord le faire fonctionner", avec la sélection du site optimisée pour la sécurité et la vitesse. La logique émergente est "d'abord le rendre réplicable", avec la sélection du site optimisée pour la vérité et la représentativité. Mon attente : d'ici environ 2027, l'évaluation de la représentativité du site du pilote deviendra une étape standard de la gouvernance de l'IA en entreprise — non parce que l'industrie est soudainement devenue rigoureuse, mais parce qu'assez d'entreprises ont maintenant payé les frais de scolarité. Celui qui corrige d'abord la sélection du site paiera les frais de scolarité les plus bas dans la phase de déploiement.
Enfin, une question à emporter. Si une solution d'IA ne produit de beaux chiffres que dans votre meilleur entrepôt et échoue partout ailleurs, devrions-nous demander "est-ce que l'IA fonctionne" — ou "nos entrepôts sont-ils dignes de cette IA" ? Et plus loin : quand le choix du site du pilote peut largement déterminer le résultat du pilote, combien des célèbres "histoires de succès de l'IA" de l'industrie des deux dernières années ont mesuré la technologie, et combien ont simplement mesuré le bon goût dans la sélection du site ? Il n'y a pas de réponse standard. Mais toute entreprise sur le point de lancer un pilote ferait bien de se poser cette question une fois — avant de signer.
Par Dr. Chen, Chercheur en chaîne d'approvisionnement
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.