Resumen
Una caída del WCS no tiene por qué paralizar tu almacén. Si tu equipo ha ensayado el cambio, diez minutos de corte del sistema de control son un simulacro, no un desastre. He estado en planta en este mismo fallo tres veces, y la lección fue idéntica en todas: un plan de contingencia que nadie ha ensayado es lo mismo que no tener ningún plan.
Así se ve: 1:00 AM, la tarjeta de red del servidor WCS muere, y la cinta transportadora, los clasificadores y los elevadores se paran a la vez. El supervisor se queda congelado cinco minutos. Primer instinto: llamar al proveedor. Segundo instinto: esperar a que el sistema vuelva. El primer instinto correcto: pasar a modo manual en tres minutos, poner a la gente en movimiento, y dejar que el equipo espere.
Esto es un manual de campo para operaciones manuales con WCS: una lista de verificación de cambio en 3 minutos, un manual en 7 pasos, siete errores que evitar, y las cuentas de operar en manual frente a quedarse quieto.
Por qué una caída del WCS pega tan fuerte
Aclaremos el concepto: un WCS no es un WMS. El WMS te dice qué mercancía mover; el WCS le dice al equipo cómo moverla — enrutado de cintas, asignación de rampas del clasificador, programación de elevadores, despacho de shuttles. Cuando muere, el equipo, la mercancía y la gente siguen ahí, pero nadie dirige. La zona automatizada pasa del piloto automático a un montón de piezas sueltas en segundos.
Las caídas vienen en tres sabores, cada uno exige una respuesta distinta. Diagnosticas mal y todo lo que sigue es trabajo perdido:
- Fallo de la aplicación WCS (servicio o servidor caído): los PLC siguen funcionando en local, pero no se despachan nuevas tareas. Las cajas terminan su ruta actual y se paran.
- Desconexión de red (fallo de switch, o un montacargas cortando un cable — esa la he visto tres veces): el WCS está bien, pero se pierde el latido (heartbeat) con los PLC. El equipo se detiene por seguridad; las cintas hacen parada de emergencia.
- Fallo de la base de datos o la cola de mensajes del WCS: tareas a medio despachar, estado del equipo y registros del sistema en desacuerdo. La más traicionera — la reconciliación tras la recuperación lleva bastante tiempo.
Primera regla: diagnostica el tipo antes de tocar nada. La mayoría reinicia primero el servicio WCS. Si es una desconexión de red, diez reinicios no compran nada y queman veinte minutos.
Contingencia ante caídas del WCS: los primeros 3 minutos
Esta lista es un punto fijo de la lista de verificación de la víspera de puesta en marcha que repaso con cada cliente. Imprímela, pégala con cinta en la pared de la sala de control, marca las casillas cuando ocurra.
Paso 1: Minutos 0–3 — Confirma el alcance del daño
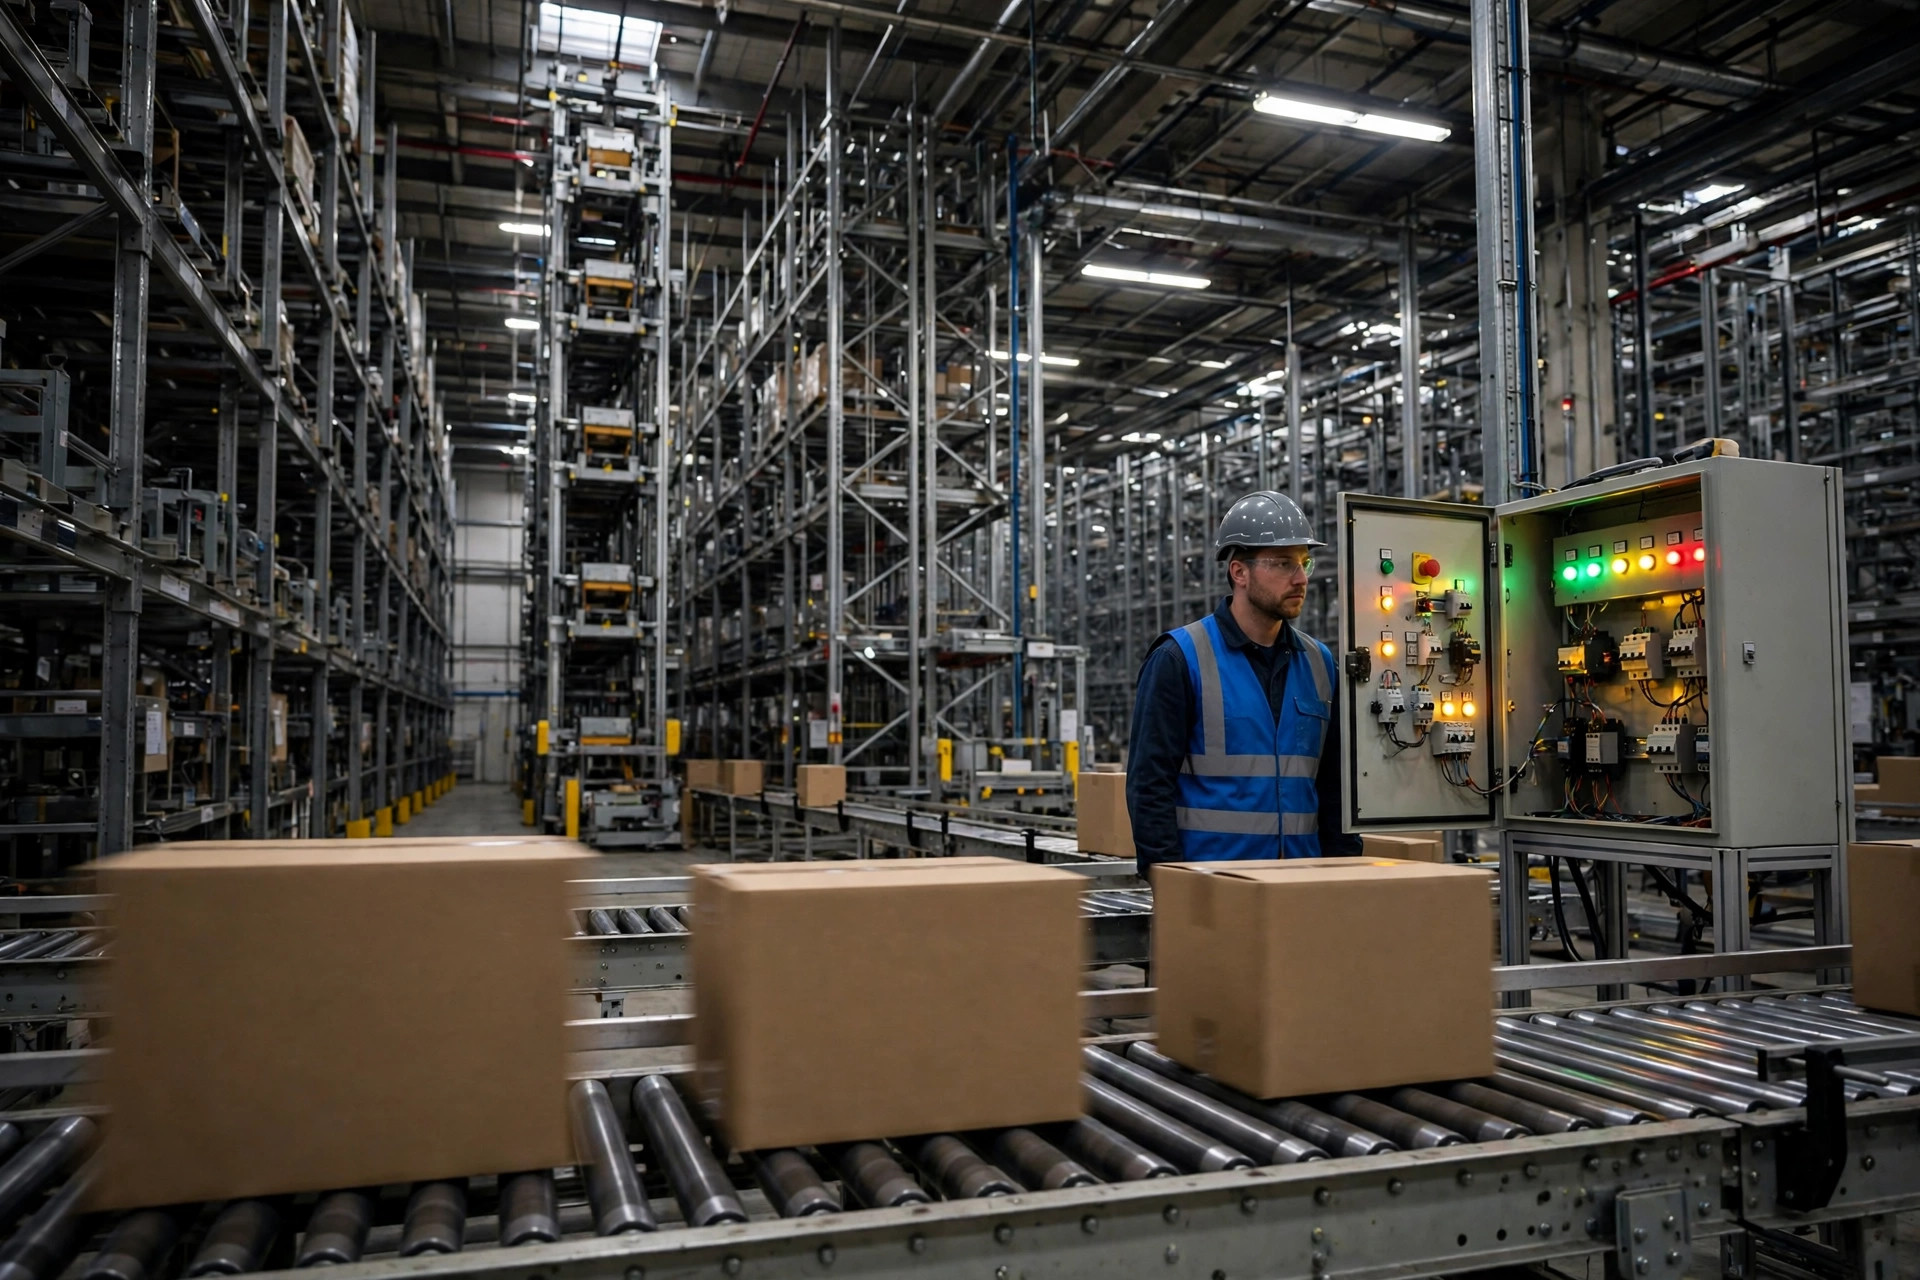
- Panel de control: ¿todo en rojo o parcialmente en rojo? Todo en rojo suele significar que la aplicación WCS o el switch principal está caído; rojo parcial apunta a un PLC o una línea.
- Que IT haga ping al servidor WCS y al switch principal en paralelo — ¿problema de aplicación o de red?
- Anúncialo ya: "WCS caído, pasamos a modo manual," tres veces por radio. No por el chat grupal — todos están en planta, y la radio es lo más rápido.
- Movimiento crítico: congela las tareas nuevas. Dile al lado del WMS que pause los lanzamientos de olas, o crearás tareas fantasma que el sistema cree despachadas pero el equipo nunca recibió.
Paso 2: Minutos 3–10 — Cambia a manual
- Cintas: en el panel HMI del PLC de cada sección, cambia a modo manual/local y avanza las cintas por pulsos para despejar las cajas al desvío más cercano. Una persona por sección, reasignada temporalmente de empaque.
- Clasificadores: la asignación de rampas se acabó — clasifica a mano. Haz funcionar el clasificador como una cinta tonta; los operarios desvían por etiqueta de envío en cada rampa. El rendimiento baja, pero la mercancía fluye.
- Elevadores y shuttles: el modo manual aquí es de alto riesgo. Bloquéalos; mueve la mercancía a mano o con transpaleta. No apuestes con personas junto al equipo automatizado para ahorrar minutos — línea dura de seguridad.
- Etiquetas: si el sistema de etiquetas sigue arriba, sigue imprimiendo. Si está caído, escribe a mano en blancos preimpresos. La lista de la víspera de puesta en marcha debe incluir una caja de etiquetas preimpresas — una lección pagada con sangre.
Paso 3: Después del minuto 10 — Mantén el ritmo manual
- Un comandante del modo manual — normalmente el supervisor de turno — a mitad de planta con una radio, asignando mano de obra y gestionando excepciones.
- Cuenta el progreso cada 15 minutos: cajas procesadas, cajas en backlog. Pizarra, no memoria.
- Registra cada acción manual para cargarla al sistema después. Prepara hojas de papel por adelantado (ID de caja, acción, hora, operario); tecléalas tras la recuperación. El paso que más equipos se saltan — y los registros saltados significan que el inventario nunca cuadra.
Paso 4: Recuperación — Reconciliación antes del reinicio
- No pases directo a automático. Primero: (1) confirma que el latido PLC–WCS esté estable durante cinco minutos; (2) verifica por muestreo las cajas de línea contra los registros en papel; (3) haz una prueba de 10 minutos a bajo volumen.
- He visto este error tres veces: a automático total en cuanto vuelve el WCS, una caja de tarea fantasma se clasifica en la rampa equivocada — dos horas de retrabajo.
Los 7 errores (he visto cada uno tres veces)
- Escrito pero nunca ensayado. Un plan en papel no es un plan. La lista de la víspera de puesta en marcha necesita un simulacro real de desconexión.
- Nadie sabe la contraseña del panel del PLC. Está en el teléfono del ingeniero del proveedor — ¿contestará a las 2 AM? Guárdala accesible en la sala de control.
- Las instrucciones del modo manual están en inglés; el equipo de planta no puede leerlas. Tradúcelas, añade fotos, pégalas al equipo.
- Radios muertas. Lista de suministros de emergencia: revisa la carga de las radios cada mes.
- Sin etiquetas preimpresas. El sistema de etiquetas suele morir con todo lo demás — sin etiquetas, no hay movimiento de mercancía.
- Lado WMS no congelado. Las olas siguen lanzándose; las tareas fantasma inundan el sistema al recuperarse.
- Reinicio total, sin reconciliación. Ver Paso 4 — la zona de desastre del retrabajo.
Dos incidentes reales
Junio de 2024, un centro de distribución de e-commerce en temporada alta en el este de China. 1:17 AM: la tarjeta de red del servidor WCS falla, la capa de aplicación cae, cintas, clasificadores y tres elevadores se paran con ~8,000 pedidos esperando. El supervisor ejecuta la lista ensayada — anuncio más congelación de olas del WMS en tres minutos, cintas a manual y clasificación a mano en diez. Sistema de vuelta tras 47 minutos, 20 minutos de reconciliación, luego automático total. Backlog despejado antes de las 11 PM; el cutoff de la temporada alta se mantuvo. Post-mortem: dos ensayos previos, el tercero "a fuego real" — nadie entró en pánico.
Noviembre de 2023, un almacén 3PL en el sur de China. 3 PM: una actualización de firmware del switch principal falla; el latido del sistema de control a los PLC cae durante 12 minutos. Nunca ensayado. 8 minutos de caos — alguien reinicia el WCS (inútil, es un problema de red), alguien llama al proveedor (no contesta). Un veterano pone las cintas en manual de memoria y salva la línea de atascarse. 12 minutos de corte, 40 minutos de parada: los 28 minutos extra fueron puro "nadie sabía qué hacer". El valor del plan más el ensayo equivale a cada minuto desperdiciado más allá del propio corte.
Las cuentas: operar en manual frente a quedarse quieto
Un centro de e-commerce de 5,000 pedidos al día, corte de una hora:
| Quedarse quieto y esperar | Pasar a manual | |
|---|---|---|
| Rendimiento esa hora | 0 pedidos | ~800–1,200 pedidos (manual ≈ 30–40% del ritmo automatizado, por las plantas que he visto) |
| Backlog | Los 5,000 pedidos se retrasan | ~1,000 menos en backlog |
| Rampa tras recuperación | 2–3 horas | ~1 hora |
| Costo de mano de obra | 0 (horas extra después) | ~15 personas durante 1 hora |
| Riesgo | Incumplimiento del SLA de cutoff | Tasa de error algo mayor — añade verificación |
Conclusión sin rodeos: una hora manual recupera una o dos horas de rampa. Para un DC con cutoffs duros de expedición, esa es la diferencia entre "enviado a tiempo" y "retrasos masivos".
La verdad incómoda
La opinión contraria: el plan de contingencia más aterrador no es el que nunca se escribió — es el que se escribió y nunca se ensayó.
He visto un plan de 40 páginas que nadie pudo abrir lo bastante rápido, y una lista de una página A4 que funcionó porque el equipo la ensayó tres veces y todos conocían su puesto. El valor de un plan es la memoria muscular, no el número de páginas.
Mi recomendación: pon el simulacro de operaciones manuales en tu lista de verificación de la víspera de puesta en marcha y repítelo cada trimestre. La gente rota; un nuevo contratado sin ensayar es un plan caducado. Un simulacro cuesta dos horas de baja demanda. Un corte sin preparación puede triplicar tu tiempo de parada (incidente dos: 12 minutos de corte, 40 de parada).
La próxima vez que el sistema de control se caiga, ¿quieres el incidente uno o el incidente dos en tu planta? La respuesta está en cuántas veces lo has ensayado.
Por Lin Xiao, consultor de implementación WMS
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.