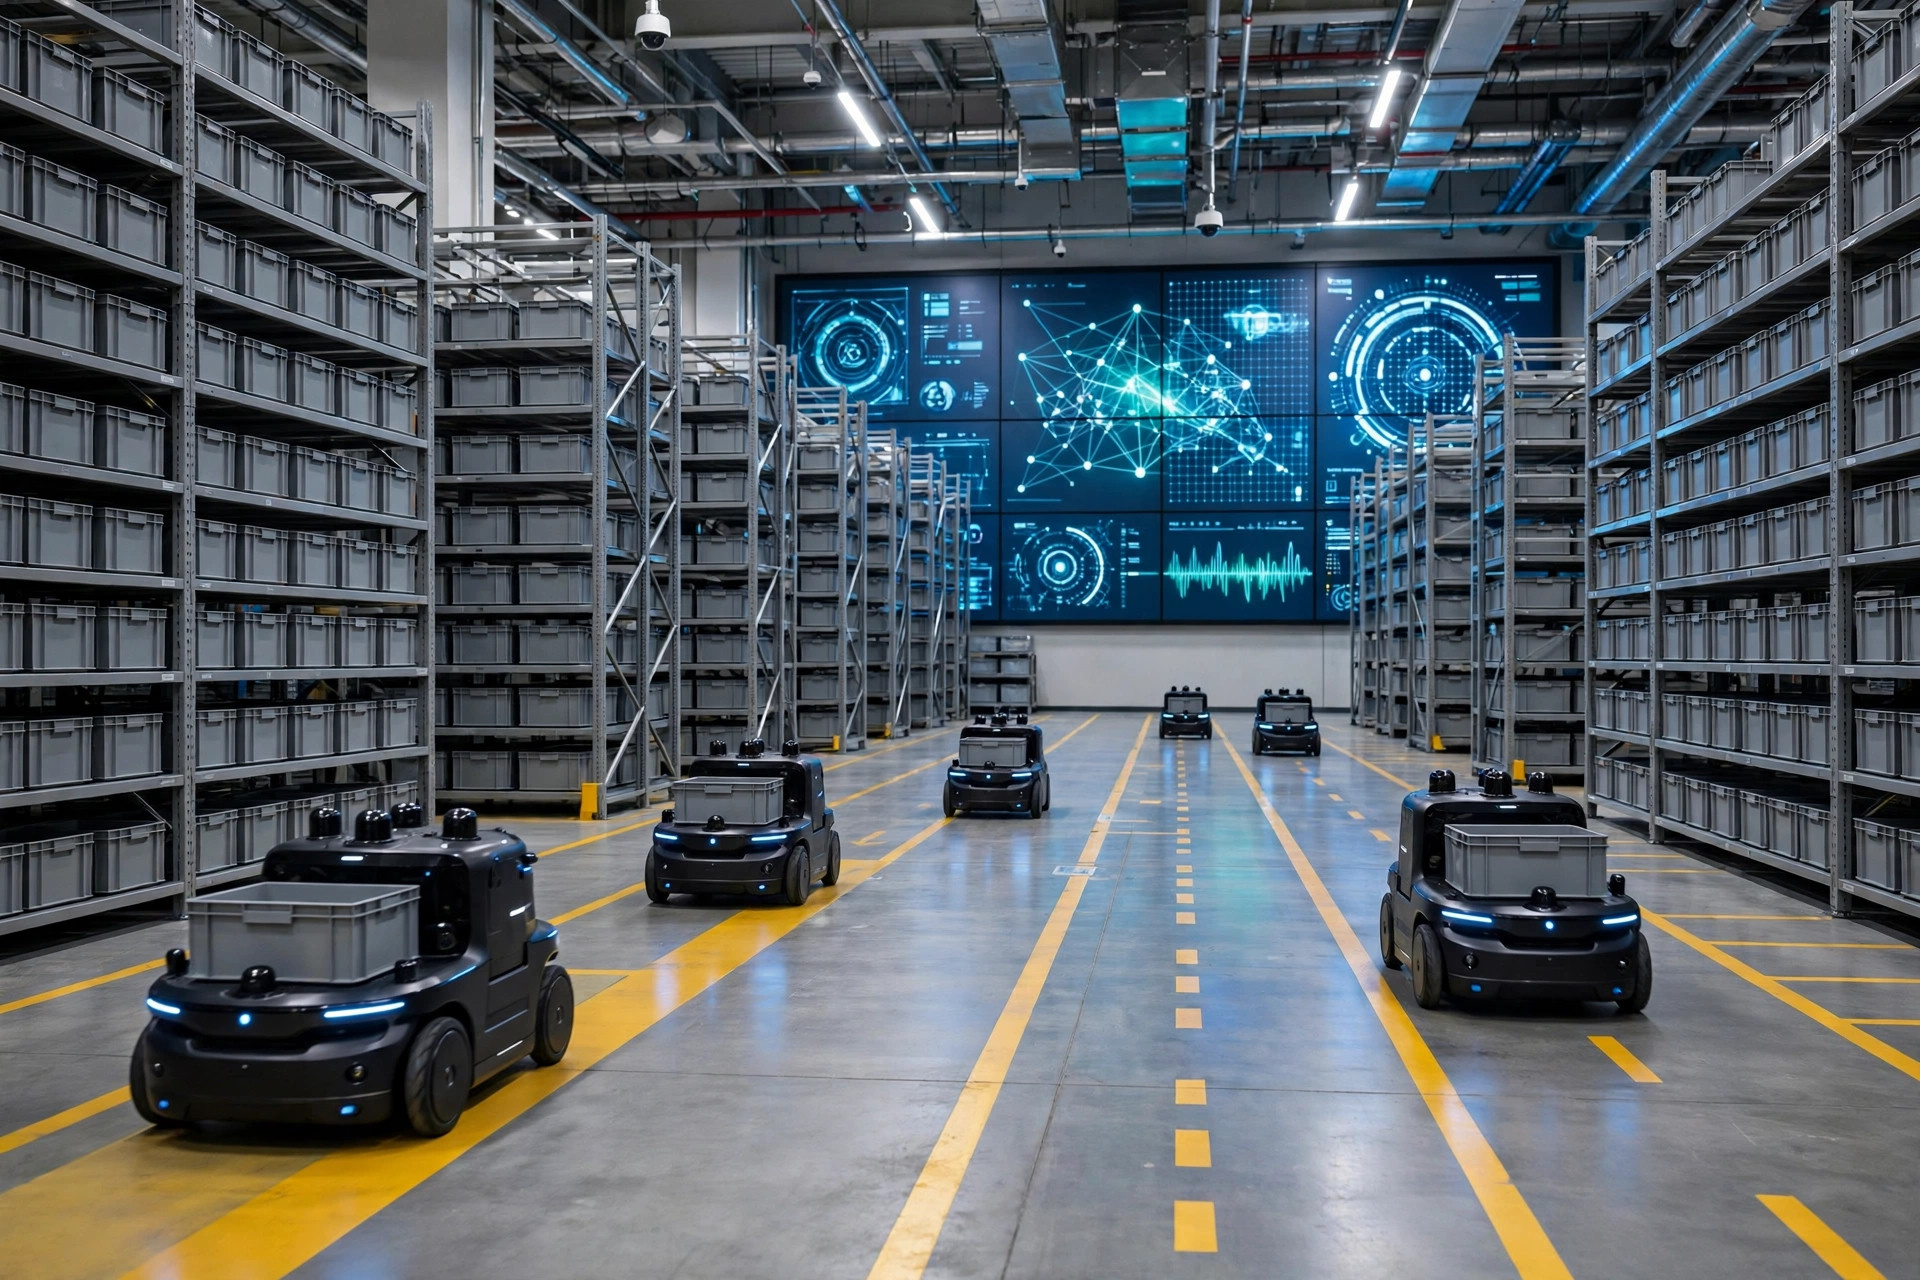
El "ciclo virtuoso de datos de la IA en almacenes" (data flywheel) ha aparecido con creciente frecuencia en los círculos de la cadena de suministro: cuanto más se utiliza un sistema de IA en el almacén, más datos recopila y más precisos se vuelven sus modelos; cuanto más precisos son, más personas dependen de ellos; y esa mayor dependencia devuelve aún más datos al ciclo. Pero según mi seguimiento de los despliegues de IA en almacenes, este ciclo no gira ni de lejos con la suavidad que la leyenda sugiere: existe de verdad en algunos escenarios, y en otros está más cerca de ser una visión. Para acertar, primero miramos los datos, y solo después la atribución.
Dónde gira realmente el ciclo virtuoso de datos en los almacenes
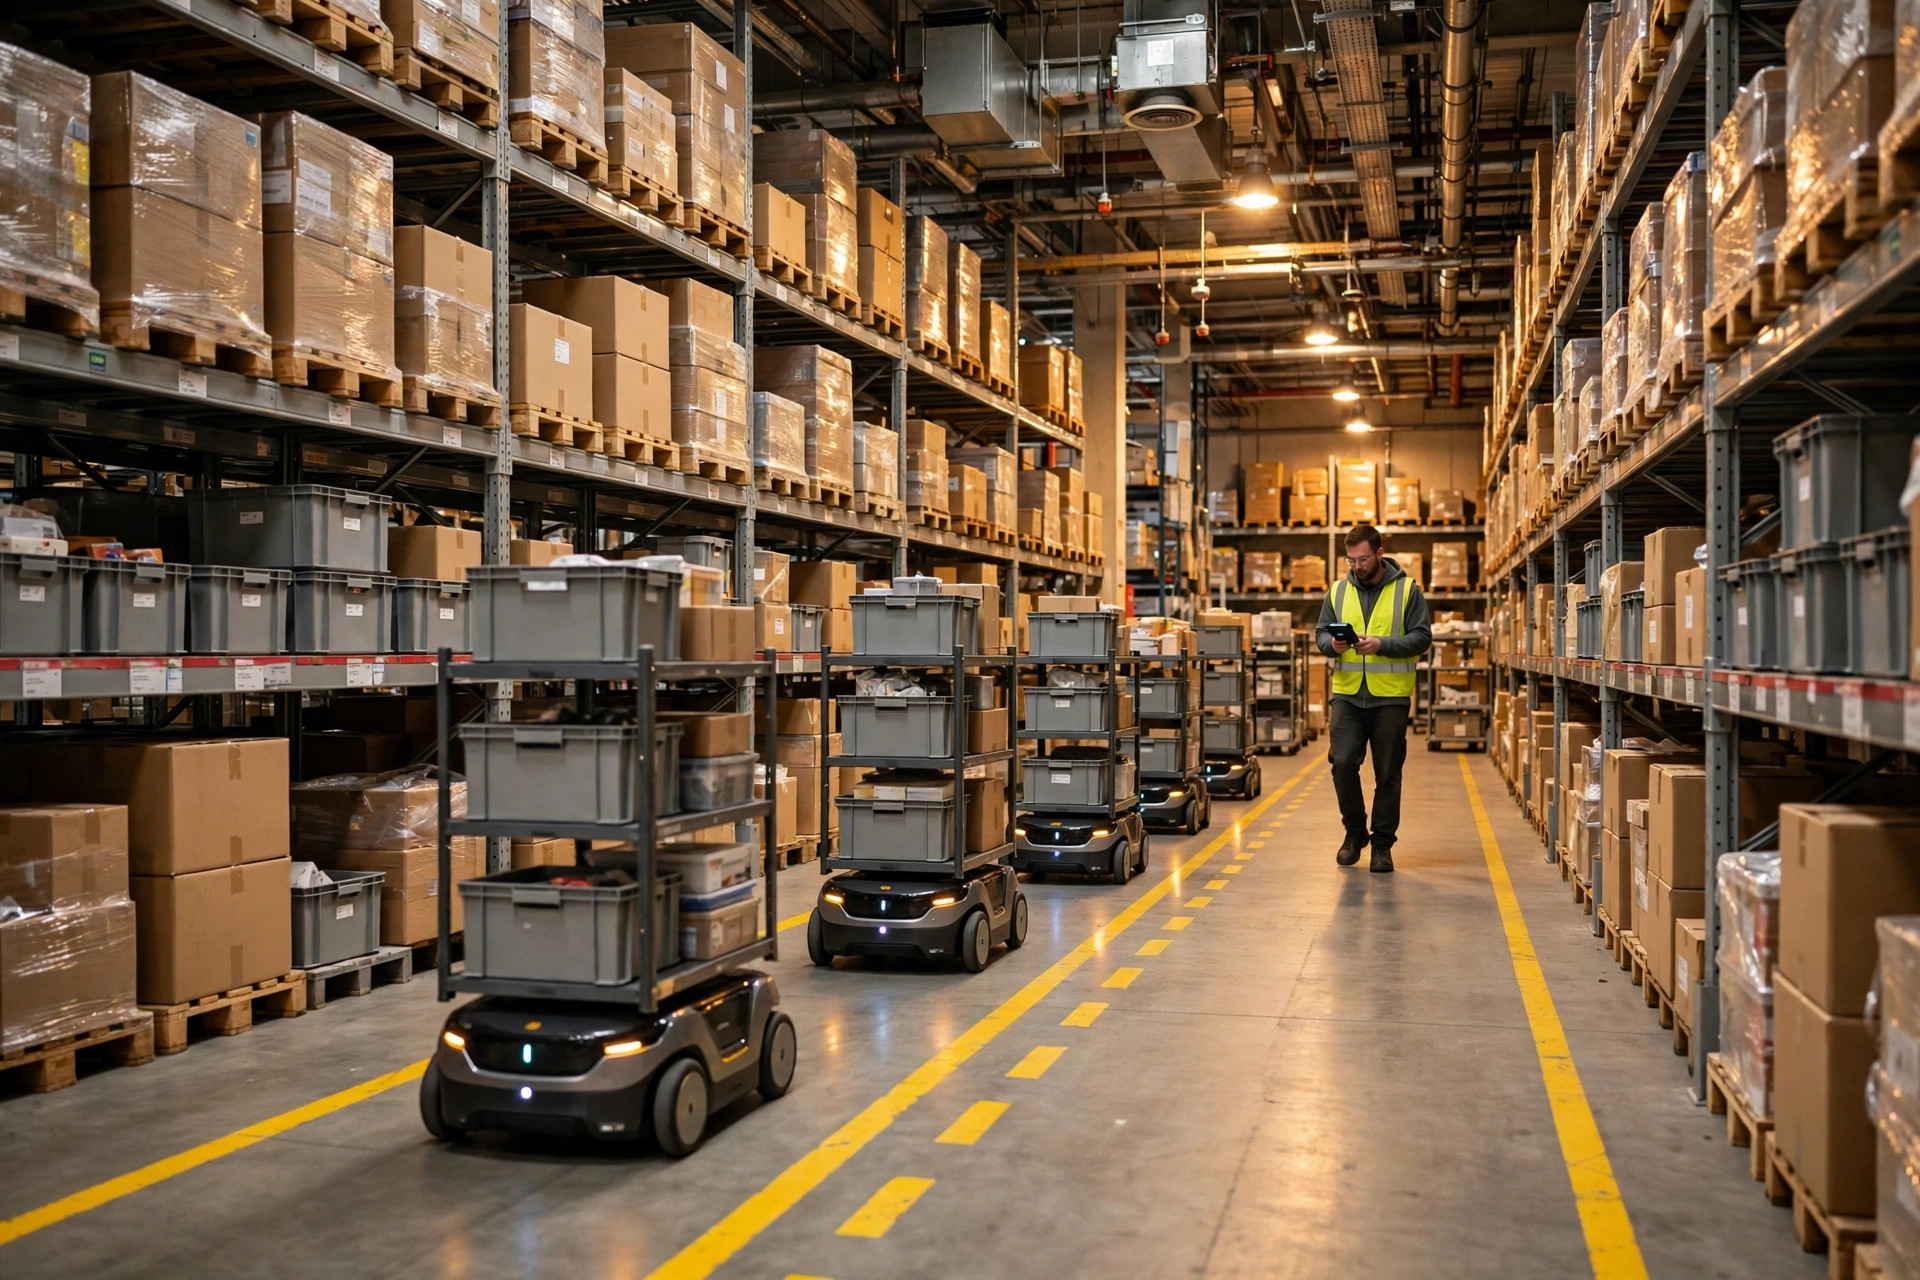
En los almacenes, el ciclo virtuoso de datos no es un eslogan: tiene tres formas concretas y verificables. Primera, previsión de la demanda y reposición: los pedidos históricos y el inventario alimentan el modelo, el modelo genera pronósticos a nivel de SKU, los pronósticos guían la reposición y el slotting, y las ventas reales se convierten en nuevos datos de entrenamiento. Segunda, inspección por visión: controles de entrada, detección de daños, recuentos — cada revisión manual funciona a la vez como una anotación gratuita. Tercera, asignación de tareas a robots: cada movimiento de un AMR registra un tiempo de desplazamiento, cada agarre registra un éxito o un fallo — datos que nacen ya etiquetados, sin necesidad de procesamiento secundario.
Para observar la verdadera velocidad de rotación de un ciclo se necesita una línea de tiempo suficientemente larga, y la red de robótica de almacenes de Amazon es la mejor muestra pública: Kiva Systems, adquirida en 2012, robots goods-to-person a gran escala; el brazo Sparrow, presentado en 2022, que según se dice maneja cerca del 65% de los productos de su inventario; más de 750.000 robots móviles anunciados en 2024. Doce años — cada picking, cada agarre, cada fallo se convirtieron en datos de entrenamiento incrementales.
La evolución de Sparrow ilustra el mecanismo: los primeros brazos solo manejaban artículos de forma regular en posiciones fijas; a medida que se acumulaban los datos de agarre, las tasas de éxito en artículos irregulares y de embalaje blando mejoraron, lo que permitió a Amazon desplegarlo en más categorías — frontera de capacidad → incremento de datos → frontera de capacidad. La clave no es la sofisticación algorítmica — los marcos de planificación de agarre son públicos en el mundo académico desde hace tiempo — sino que Amazon posee datos de agarre con etiquetas reales de fallo que nadie más puede obtener.
Una segunda muestra es la previsión de la demanda. Entre finales de 2024 y principios de 2025 estudié dos grandes centros de fulfillment de comercio electrónico — uno en el este de China, otro en el sur de China — cada uno procesando entre 80.000 y 120.000 pedidos al día, ambos ejecutando desde alrededor de 2023 previsiones de ventas a nivel de SKU con ML. Un año después del lanzamiento, las tasas de ruptura de stock en ambos habían caído de alrededor del 6% a cerca del 4%, y el tiempo de permanencia del inventario de lenta rotación se había acortado alrededor de un 20%. Ambos directores de cadena de suministro dijeron casi lo mismo: "Al lanzar, el modelo era peor que la intuición de nuestros planificadores; solo después de seis meses de acumulación de datos tomó la delantera." El primer medio giro del ciclo funciona a pérdida — el punto que los rezagados más subestiman.
Por qué los pioneros giran más rápido
La atribución se reduce a tres mecanismos. Primero, la composición de activos etiquetados: en los almacenes, las acciones del negocio son anotaciones en sí mismas — una revisión manual, una excepción gestionada, una diferencia de inventario, cada una lleva su propia etiqueta. Los pioneros empezaron antes, así que esas "anotaciones gratuitas" comenzaron a componerse antes. Un rezagado puede comprar el mismo algoritmo, pero no puede comprar esos años de activos etiquetados. Segundo, la velocidad del bucle de retroalimentación: la velocidad de rotación no la determina el volumen de datos, sino cuánto tarda un ciclo completo — datos → modelo → decisión → nuevos datos. En la red de fulfillment de Amazon ese ciclo se mide en horas; en la previsión de la demanda, en días. Cuanto más corto es el ciclo, más rápido se amplía la ventaja del pionero. Tercero, la amplitud de la cobertura de la cola larga: cómo agarrar artículos irregulares, cómo cortar oleadas de pedidos en temporada alta, cómo gestionar excepciones. Un modelo entrenado por un rezagado con conjuntos de datos públicos rinde de forma comparable en escenarios estándar, pero la brecha se abre de inmediato en la cola larga — y el almacén está lleno de escenarios de cola larga.
La incómoda verdad: los ciclos no giran solos
Hasta aquí, suena como una historia destinada a pertenecer a los pioneros. Pero primero hay tres juicios contraintuitivos — son los que determinan si el ciclo gira siquiera.
Primero, el ciclo tiene un umbral de arranque en frío, y no es bajo. "Cuanto más se usa, más preciso se vuelve" solo se cumple si el sistema ya es lo bastante preciso como para que la gente esté dispuesta a usarlo. Si la precisión inicial va por detrás del rendimiento humano, la operación lo rodeará y el flujo de datos se secará. Los dos almacenes de arriba sobrevivieron a sus primeros seis meses no gracias a la tecnología, sino gracias a un mandato de la dirección: la salida de la previsión debe impulsar la reposición. Sin un bucle cerrado impuesto por la organización, el primer giro nunca ocurre. Muchos proyectos de IA en almacenes mueren justo aquí: los datos existen, el modelo existe, pero el proceso no reserva ningún puesto por el que el modelo "deba pasar".
Segundo, los datos se deprecian. Los datos del almacén tienen un enemigo oculto: el desplazamiento de la distribución (distribution shift). Una reforma importante del mix de SKU, una reubicación, un cambio de productos estándar a no estándar — y los datos antiguos decaen rápido. Un modelo de visión entrenado durante tres años en textil puede perder la mitad de su precisión de la noche a la mañana en un almacén de repuestos de automóvil. Un foso de datos tiene una fecha de caducidad fijada por la estabilidad del escenario: cuanto más estable el escenario, más profundo el foso; cuanto más rápido cambian las cosas, más rápido se evapora.
Tercero, el ciclo amplifica el sesgo inicial: mala calidad de anotación inicial o reglas de etiquetado sistemáticamente sesgadas, y cuanto más rápido gira, más rápido se amplifica el sesgo. Una vez vi un proyecto de detección de anomalías en clasificación donde el "embalaje ligeramente arrugado" se etiquetó masivamente como "dañado" al principio; tras el lanzamiento, el modelo se volvió cada vez más estricto, la tasa de interceptaciones falsas no dejó de subir, y la operación acabó apagando la interceptación automática. Un ciclo no tiene sentido de la dirección — solo acelera.
Estos tres juicios forman un marco para juzgar si un escenario merece apostar por el ciclo:
| Dimensión | Escenario favorable al ciclo | Escenario hostil al ciclo |
|---|---|---|
| Densidad de datos | Acciones repetitivas de alta frecuencia, p. ej., picking | Acciones de cola larga de baja frecuencia, p. ej., recuentos cíclicos |
| Velocidad del bucle de retroalimentación | Verificable en minutos u horas, p. ej., éxito del agarre | Resultados conocidos solo tras meses, p. ej., tendencias de demanda |
| Costo de etiquetado | Producido de forma natural por el proceso, p. ej., revisiones manuales | Requiere anotadores dedicados fuera de línea |
| Estabilidad del escenario | SKU y procesos estables a largo plazo | Cambios frecuentes de surtido y reubicaciones |
| Escala inicial de datos | Años de datos históricos acumulados | Arranque en frío desde cero |
Si un escenario cae en la columna derecha en tres o más de estas cinco dimensiones, "cuanto más se usa, más preciso se vuelve" es muy probablemente solo una visión — resuelva el arranque en frío y el diseño del bucle cerrado antes de invertir.
Tres vías de recuperación para los rezagados
El foso del pionero no significa que los rezagados no tengan camino. Veo tres vías viables. Primera, modelos preentrenados más ajuste fino ligero. Los grandes modelos de visión están cambiando el juego: la detección de daños que antes requería cientos de miles de imágenes etiquetadas ahora puede alcanzar una precisión utilizable con un ajuste fino sobre unos pocos miles de imágenes del propio almacén del operador. Pero esto ayuda poco en la previsión de la demanda, que necesita la profundidad del historial propio del sitio. Segunda, alianzas de datos. Un almacén mediano por sí solo no puede sostener un ciclo, pero decenas compartiendo datos operativos desidentificados pueden armar un conjunto de entrenamiento significativo. Algunos 3PL europeos ya experimentan así: los datos nunca salen de los sistemas de cada empresa; solo se comparten los gradientes del modelo o características desidentificadas. La dificultad no es técnica, sino de confianza y reparto de beneficios. Es un problema de negocio, no de IA. Tercera, competencia asimétrica: elegir escenarios donde los ciclos no pueden girar. Almacenes de productos no estándar, almacenes que sirven a fabricación personalizada, almacenes de fast fashion con alta rotación — los datos se deprecian tan rápido allí que la ventaja histórica de los pioneros se evapora en gran medida. Los rezagados que empiezan aquí parten de la misma línea de salida. Un foso solo existe donde un foso puede cavarse.
Una línea de tiempo para los próximos tres a cinco años
Mis juicios a continuación se apoyan en la pendiente histórica de las curvas de capacidad de los modelos, el costo decreciente de la anotación y el ritmo de penetración de la automatización de almacenes en los últimos cinco años — juicios falsables, con marca temporal, que pueden revisitar dentro de unos años.
De 2026 a 2028: los modelos preentrenados para la IA de visión en almacenes se convierten en equipamiento estándar; los operadores medianos compran inspección por visión "de ochenta puntos" a costo moderado, y la ventaja del pionero aquí se diluye visiblemente. Mientras tanto, la ventaja en previsión de la demanda sigue ampliándose — la decide la profundidad acumulada durante años en los datos propios del sitio, donde los modelos preentrenados no pueden ayudar.
De 2028 a 2030: emergen alianzas de datos regionales o por categoría, y los 3PL líderes empiezan a comerciar "datos por servicios de algoritmos". Los algoritmos siguen convirtiéndose en commodity, y la prima sube para los equipos de "ingeniería de datos más operaciones de bucle cerrado" — las personas por las que valdrá la pena pagar ya no serán las que saben ajustar modelos, sino las que saben poner el ciclo en marcha.
Cierro con una pregunta abierta: si los datos son realmente el foso, ¿su agua pertenece a quien lo cavó, o a cada parcela por la que fluye? A medida que tanto las alianzas de datos como la regulación entran en escena, ¿cuánto seguirán valiendo dentro de cinco años las cartas de los pioneros de hoy? No existe una respuesta estándar — pero quien apueste por la IA en almacenes debería tener primero resuelta la suya.
Por Dr. Chen, investigador de cadena de suministro
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.