Empecemos por la factura.
Enseñar a un robot de picking a reconocer cajas de cartón requiere unas 100,000 imágenes de entrenamiento. Etiquetarlas a mano, y las listas públicas de precios de los proveedores sitúan el simple dibujo de cajas delimitadoras en $0.10–$0.50 por imagen: $10,000–$50,000 solo por la primera pasada.
Tres meses después, el proveedor de embalaje cambia el cartón, la luz de invierno cambia los reflejos, y el modelo deja de reconocer la mitad de las cajas: otras 20,000 imágenes, unos miles de dólares más, desaparecidos.
Así que este artículo no trata de redes neuronales. Trata de dinero: cómo se entrenan los modelos de visión de IA para almacenes, cuánto cuesta cada ruta, dónde están las trampas — y un problema de aritmética en el que puede introducir sus propias cotizaciones.
Empecemos por la factura: cómo se entrenan los modelos de visión de IA para almacenes se reduce a tres rutas
Los datos de entrenamiento para modelos de visión tienen exactamente tres fuentes: fotografiados por humanos, dibujados por humanos o generados por máquinas.
Ruta 1: fotos reales + etiquetado humano. Fotografíe en el almacén, dibuje las cajas a mano — "esto es una caja de cartón, esto es un pallet, esto es un daño".
Ruta 2: renderizado por simulación CAD. Con dibujos CAD 3D precisos, deje caer piezas virtuales en un contenedor virtual, aleatorice la iluminación, la cantidad, las texturas y el ruido, y renderice cientos de imágenes. Las etiquetas se generan solas — el motor sabe dónde está cada pieza; el tiempo humano se dedica a ajustar parámetros.
Ruta 3: datos sintéticos por IA generativa. No se necesitan dibujos. La IA generativa "pinta" escenas de almacén anotadas directamente — incluidos los estados feos: cartones aplastados, polvo, film estirable. La tabla comparativa de costos está más abajo; primero, una ruta a la vez.
Ruta 1: fotos reales + etiquetado humano — la más tonta, la más cara, la más honesta
La ruta más antigua, y todavía la que siguen la mayoría de los proyectos de visión en almacenes. Sin magia: fotografiar, dibujar cajas, control de calidad, entrenar.
Las cuentas, de las listas públicas de precios de proveedores (Basic.ai): $0.03–$1.00 por caja, $0.10–$0.50 por imagen para trabajo simple. Con 4 cajas por imagen y $0.30/imagen, 100,000 imágenes = $30,000 — antes del control de calidad, donde la revisión de doble pasada es lo estándar y un multiplicador de costo total de 1.5–2x es lo normal.
En 2024 calculé uno real: una planta 3PL en Kunshan, robots de picking, más de 2,000 SKUs, 80,000 imágenes tomadas. Cotización del proveedor: $0.08 por caja, 4 cajas por imagen — 80,000 × 4 × 0.08 = $25,600 sobre el papel. Con gestión de proyecto y alrededor de un 15% de retrabajo, el cheque real superó los $30,000.
Seis meses después de la puesta en marcha, el proveedor de cartón cambió de kraft a cartón blanco estucado. La reflectividad cambió; el reconocimiento cayó 6 puntos. Otras 20,000 imágenes — casi $10,000 más.
La verdad sobre la Ruta 1: los datos reales no son una compra única, son una suscripción. Cada cambio de embalaje, iluminación o estación puede disparar otra ronda de etiquetado. No firma un contrato; firma una factura recurrente.
Su virtud también es real: la fidelidad. Los modelos entrenados con datos reales tienen la menor brecha sim-to-real — el entorno de entrenamiento y el de despliegue son el mismo lugar.
Ruta 2: renderizado por simulación CAD — la más barata cuando tiene los dibujos
Con modelos CAD 3D precisos, la vida se simplifica: una herramienta de simulación deja caer piezas virtuales en un contenedor virtual, varía la cantidad, la iluminación, las texturas y el ruido de cámara, y renderiza cientos de imágenes. La anotación es gratis — el motor sabe dónde está cada pieza.
Un artículo de mayo de 2026 en RoboticsTomorrow lo clavó: con un modelo CAD preciso, este es "el enfoque más fiable y que menos recursos consume" — el tiempo del ingeniero se dedica a ajustar parámetros, no a dibujar cajas.
Dos fallas fatales. Primera: sin dibujos no hay fiesta — piezas heredadas, componentes de proveedores y la deriva de lo construido dan a la simulación nada sobre lo que apoyarse. Segunda: los renders salen demasiado limpios: las imágenes reales traen aceite, arañazos, luces parpadeantes; los renders no. Los modelos entrenados con datos prístinos se desmoronan en el piso.
La conclusión contraintuitiva: el problema de la simulación CAD nunca fue "no lo suficientemente realista" — es "demasiado ordenado para ser verdad". Los almacenes no son salas limpias; los modelos no temen lo feo, temen la suciedad no vista.
Ruta 3: datos sintéticos por IA generativa — lo que STRIPES de Zebra está resolviendo en realidad
La Ruta 3 es la respuesta más caliente de 2026 a cómo se entrenan los modelos de visión de IA para almacenes. Su insignia: el dataset STRIPES de Zebra (Sim-to-Real Industrial Perception for Warehouse Scenes), publicado en septiembre de 2026.
Los números: 30,000 imágenes, 3,000 texturas y geometrías de cajas únicas, un millón de cajas etiquetadas — ni una dibujada por un humano.
Las tres innovaciones de STRIPES apuntan exactamente a los puntos débiles de la Ruta 2: creación de imágenes por IA generativa sin modelos 3D estáticos, para que la diversidad de escenas escape de su biblioteca de dibujos; desgaste simulado — cartones aplastados, abolladuras, polvo superficial, film estirable — los estados más sucios del almacén, y el paso más valioso del pipeline; y desorden con física, donde la simulación de gravedad apila las cajas en configuraciones naturalmente densas, inclinadas e interbloqueadas a través de tres fases reales: almacenamiento en estantería, preparación en piso y carga de camiones.
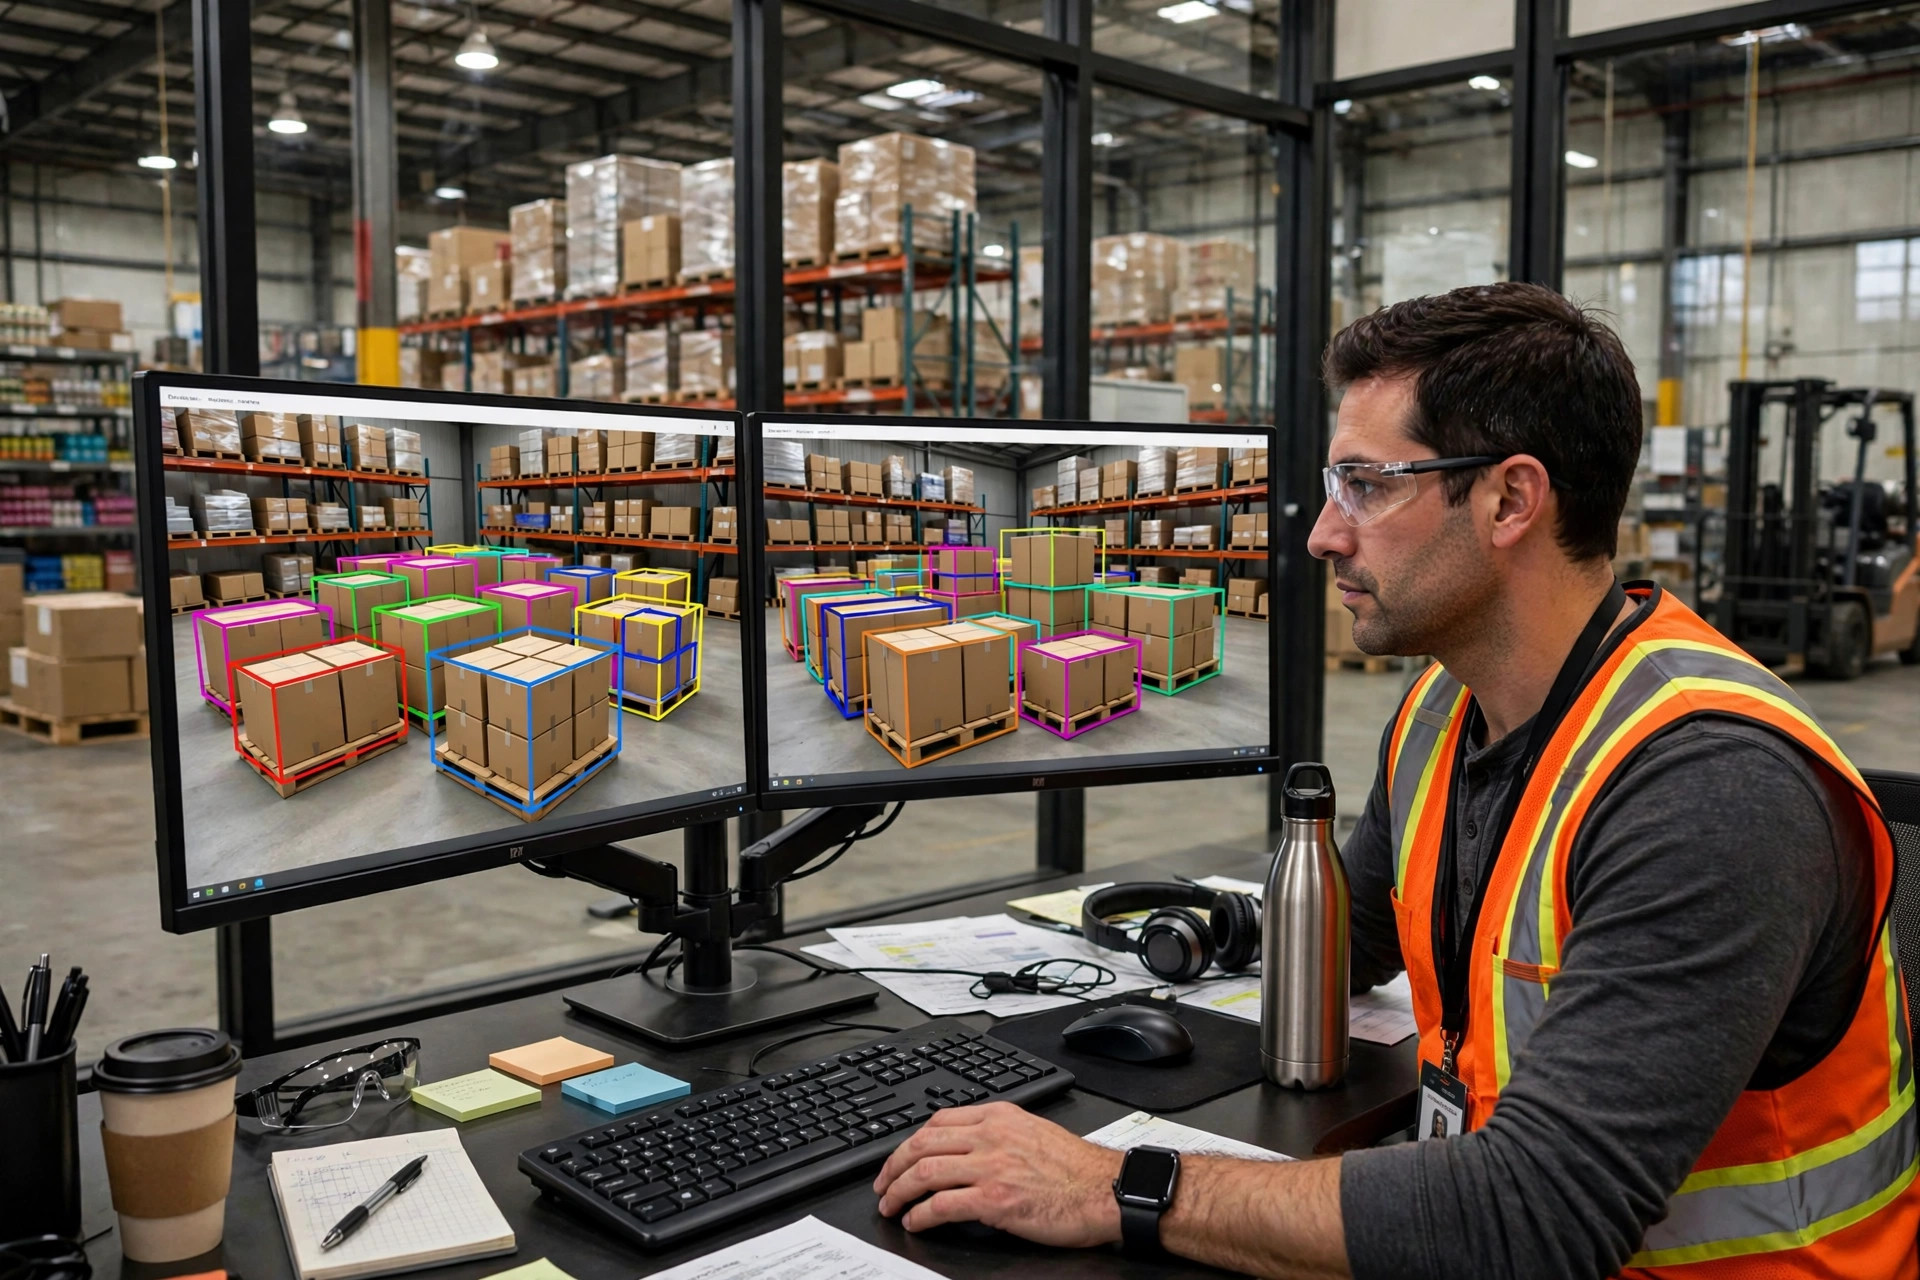
¿Lo ve? STRIPES no está resolviendo "si los datos sintéticos se ven reales" sino "si son lo suficientemente sucios". Los datos sintéticos no necesitan ser más bonitos — necesitan ser más sucios. Un 99 en simulación no significa nada; lo que importa es cuántos tipos de suciedad ha visto el modelo allí.
Sobre el costo: 30,000 imágenes y un millón de cajas, costo marginal en cómputo, no en mano de obra. Pero la Ruta 3 exige la mayor inversión fija de las tres — modelos generativos, simulación física, ingeniería del pipeline, todo por adelantado. Los proyectos pequeños no pueden pagar la entrada; los grandes se abaratan con la escala.
La brecha sim-to-real: 99 en el laboratorio, 92 en el piso
La brecha sim-to-real: la diferencia entre el entorno de entrenamiento y el entorno de despliegue. En mayo de 2026, Robotics and Automation News la llamó cerrar "uno de los objetivos de mayor valor en la robótica moderna".
¿Qué tan brutal? Septiembre de 2026: Telexistence afinó DreamZero de NVIDIA — un modelo que predice acciones y video de cámara juntos — para reabastecimiento en tiendas de conveniencia. Datos simulados limpios de picking: 45% de éxito. Grabaciones reales de teleoperación: 0%. Causa raíz: distribuciones conjuntas y escalas de estado desalineadas entre la simulación y la realidad.
45% a 0% no es "un poco desviado" — es otro universo. La brecha no es el número de imágenes; es si las distribuciones se alinean.
Steve Nemzer de TELUS Digital lo dijo bien en abril de 2026: use datos sintéticos para llenar brechas específicas, pero ancle el entrenamiento en datos del mundo real — no pueden enseñar a un modelo sobre artefactos de sensores o las condiciones adversariales de producción.
Mi traducción: los datos sintéticos son un parche, no la base. La base sigue siendo datos reales; los parches cubren la cola larga que no puede fotografiar o no puede permitirse esperar.
Sobre esa cola larga: el artículo del 7 de octubre de 2026 de este sitio — "Muestras de anomalías que no puede fotografiar" — es el manual práctico de parcheo; este es el panorama de las tres rutas con la factura adjunta.
Tres rutas, una tabla
| Ruta 1: real + etiquetado humano | Ruta 2: simulación CAD | Ruta 3: sintético generativo | |
|---|---|---|---|
| Costo marginal / imagen | $0.10–$0.50 (tarifas públicas de proveedores) | Cómputo de render, muy por debajo del humano | Cómputo de generación, muy por debajo del humano |
| Inversión fija | Baja (mayormente mano de obra de fotografía) | Media (pipeline + ajuste de ingeniero) | Alta (modelos generativos + sim física + pipeline) |
| Factura a escala de 100K imágenes | $10K–$50K, por multiplicador de QA de 1.5–2x | La más baja con dibujos, costo fijo amortizado | La más barata a escala; los proyectos pequeños no llegan al punto de equilibrio |
| Fidelidad | La más alta, menor brecha | Media — teme "demasiado limpio" | Media-alta — STRIPES está arreglando "la suciedad" |
| Falla fatal | No puede capturar la cola larga; re-etiquetado en cada cambio de SKU / entorno — el costo es una suscripción | Muerta sin dibujos | Mucha inversión inicial; antieconómico a pequeña escala |
Dos conclusiones más contraintuitivas:
Primera, la industria del etiquetado de datos está siendo devorada por los modelos que entrena. La pre-anotación por IA más revisión humana es ahora el manual estándar de los proveedores; el dibujo manual puro de cajas se está acabando, y los precios unitarios siguen cayendo. Un gran contrato a largo plazo de manual puro hoy probablemente significa comprar en el techo.
Segunda, los datos más caros no son la tarifa de etiquetado — son los datos que no puede capturar. El costo marginal de una muestra de anomalía de cola larga tiende al infinito: espere tres meses y nunca obtendrá una foto estándar de "el montacargas destrozó el pallet". El verdadero poder de precios de los datos sintéticos no es lo barato — es lo incomprable.
El veredicto de Lao Zhou: "cómo se entrenan los modelos de visión de IA para almacenes" es un problema de aritmética
¿Qué ruta? Sin intuición — calcule. Total de la Ruta 1 ≈ N × p × q (N: imágenes necesarias; p: cotización por imagen, rango público $0.10–$0.50; q: multiplicador de QA, 1.5–2). Total de la Ruta 3 ≈ F + N × m (F: inversión fija del pipeline; m: costo marginal por imagen, muy por debajo de p). Punto de equilibrio N* = F ÷ (p × q − m): pasado N*, gana lo sintético.
Ejemplo resuelto (datos ilustrativos — introduzca sus propias cotizaciones): F = $30,000, p = $0.30/imagen, q = 1.5, m ≈ $0.05/imagen. N* = 30,000 ÷ (0.45 − 0.05) = 75,000 imágenes.
El veredicto: pasadas unas 75,000 imágenes — o con rápida rotación de SKUs y entornos cambiantes empujando N siempre hacia arriba — la ruta sintética paga. De lo contrario, quédese con el etiquetado humano; no pague extra por "más avanzado".
Si el dinero estuvo bien gastado, la fórmula decide.
Por Lao Zhou, analista de costos logísticos
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.