Me quedo con el edge en esta — con una condición. Hay que separar la IA en dos tipos: la que "vigila el camino" y la que "lee la suerte".
La que vigila el camino no puede esperar ni un milisegundo. La que lee la suerte puede tardar una hora y no muere nadie. Esa línea es exactamente donde se dividen el edge y la nube. En los últimos dos años he visto a almacenes quemar dinero en ambos lados: metiendo todo en la nube y luego viendo cómo toda la línea de clasificación se detiene en cuanto la red falla; o comprando un servidor GPU el primer día para ejecutar un modelo de informes que solo necesita ejecutarse una vez al día.
Dónde desplegar la inferencia se reduce a tres fuerzas en conflicto: latencia, ancho de banda y costo. El caso de uso más sensible a cualquiera de ellas decide dónde debe vivir la inferencia.
Todo lo que se mide en milisegundos pertenece al edge
Empecemos con los vigilantes del camino: inspección visual, evitación de obstáculos de AMR, pick-and-place robótico. El hilo común es un ciclo cerrado medido en milisegundos. Una línea de clasificación mueve más de cien paquetes por minuto; una caja está en el campo de visión de la cámara un parpadeo, y el resultado del reconocimiento tiene que volver en decenas de milisegundos. Un viaje de ida y vuelta a la nube fácilmente toma cientos de milisegundos: para cuando llega la respuesta, la caja ya pasó el punto de desvío y el brazo empujador no tiene a qué apuntar.
Luego está la factura del ancho de banda. Una sola cámara de visión transmitiendo imágenes sin procesar las 24 horas genera decenas de gigabytes al día. Multiplícalo por unas cuantas estaciones y tus costos mensuales de enlace dejan de ser un error de redondeo. Y las redes de almacén no se parecen en nada a las de oficina: puntos muertos de Wi-Fi, señal bloqueada por estanterías de acero, montacargas cortando cables como evento diario. Apostar la inferencia en tiempo real a esa cadena es entregar el uptime de tu línea a la suerte.
Vi el contraejemplo en un 3PL en Ontario, California, el año pasado: sus cámaras de códigos de barras ejecutaban el reconocimiento en la nube. Una tarde la red se puso inestable y toda la línea bajó a reescaneos manuales. Era solo un cambio de punto de acceso por mantenimiento: cuatro horas con el rendimiento caído casi un tercio. El dueño me dijo después, con total sinceridad, que cada dólar ahorrado en servidores fue directo a pagar horas extra.
La evitación de obstáculos de los AMR es aún más extrema. El vehículo se mueve, una persona aparece delante, y la inferencia fusionada de lidar más visión tiene que completarse localmente y emitir un comando de frenado en decenas de milisegundos. Si esa decisión esperara a la nube, el vehículo ya habría pasado sobre la persona. Por eso todo proveedor serio de AMR ejecuta los modelos de evitación a bordo: no es una preferencia tecnológica, es física.
La regla para esta categoría es de una línea: si el resultado de la inferencia acciona directamente una acción física, se ejecuta en el edge. Y "la línea sigue funcionando cuando la red muere" entra en los criterios de aceptación.
Lo que puede esperar sale más barato en la nube
La otra categoría son los lectores de la suerte: pronóstico de demanda, sugerencias de reposición, cálculos de stock de seguridad, informes operativos mensuales. Estos modelos se ejecutan una vez y sus respuestas siguen válidas un día o una semana: unos minutos de retraso no cambian nada. La verdadera ventaja de la nube aquí no es la computación barata; es que no tienes que poseer computación alguna. No hay máquinas que comprar, no hay calor que gestionar, no hay llamadas a las 2 a. m. por una caja muerta.
La segunda ventaja de la nube es el entrenamiento. Entrenar devora datos históricos, y la historia del almacén ya vive en la nube: la base de datos del WMS, el historial de pedidos, los registros de mano de obra. Entrenar e iterar ahí arriba es lo natural. El dispositivo edge tiene exactamente un trabajo: descargar el modelo entrenado, ejecutar la inferencia y recoger nuevas versiones de la nube según un calendario.
La arquitectura híbrida que veo funcionar en campo — y la que entregaría a cualquier almacén pequeño o mediano como plantilla inicial — es esta: el edge hace inferencia en tiempo real con caché local para operar de forma autónoma cuando la red cae; la nube hace el entrenamiento, la distribución de modelos y el análisis global. Escriban la división del trabajo y no dejen que ningún lado tome el trabajo del otro. Desplieguen las actualizaciones de modelo por etapas: la nueva versión a una estación primero, una semana de funcionamiento limpio, y luego a toda la flota. Nunca hagan una "actualización de todo el almacén con un clic": cuando falla, todo el almacén falla junto.
Y hagan la prueba de aceptación física: el día del lanzamiento, desconecten el cable de red y miren qué pasa. Si la línea se detiene, la arquitectura es decoración, por bonitas que fueran las diapositivas del proveedor.
Almacenes pequeños: olvídense del servidor GPU, empiecen con un PC industrial
Ahora el dinero. La gente escucha "inferencia de IA" y se imagina un rack de servidores GPU que cuesta decenas de miles de dólares. Voy a decir algo impopular: nueve de cada diez almacenes pequeños no necesitan uno.
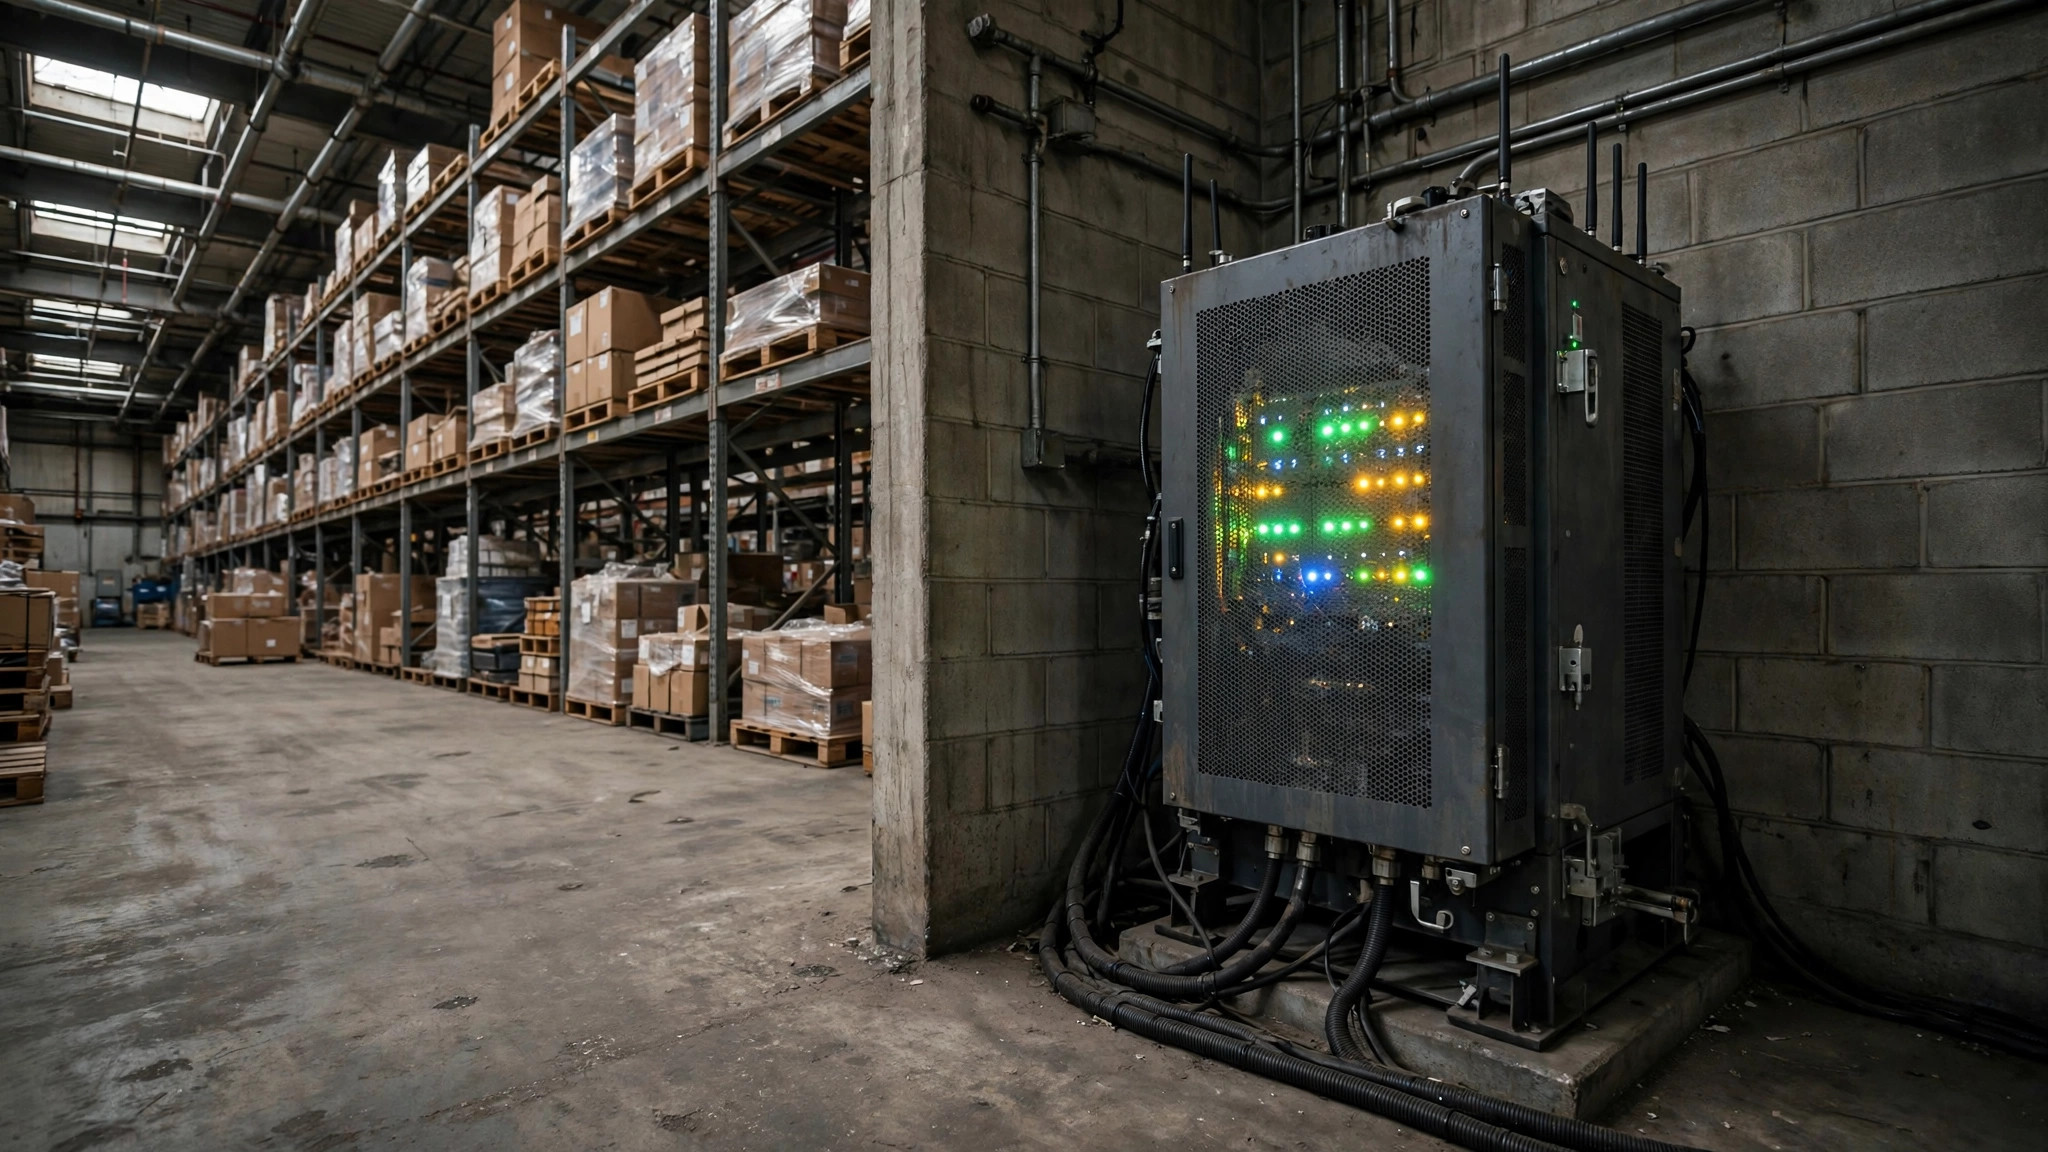
Una sola estación de inspección visual funciona cómodamente en un dispositivo edge de la clase del Jetson Orin Nano de NVIDIA — la versión de 8GB lanzada en 2023, decenas de vatios de consumo, cabe dentro de un gabinete eléctrico. Un PC industrial con GPU, de unos pocos miles de dólares, puede servir a dos o tres estaciones. Empiecen ahí: demuestren el ROI en una o dos estaciones — reduzcan la tasa de fallos de las re-inspecciones manuales, o eliminen los paros por ralentización en la línea de clasificación. Una vez que las cuentas cuadren, entonces hablen de expandir estaciones, y luego de servidores.
Un detalle ambiental que se pasa por alto constantemente: polvo y calor. Los almacenes alcanzan altas temperaturas en verano y el polvo llega a todas partes; hardware de consumo tirado a ese entorno no sobrevive una temporada pico. Al elegir hardware edge, el amplio rango de temperatura operativa, el diseño sin ventilador y la resistencia al polvo son requisitos duros: no compren solo por las especificaciones de cómputo. Esa es otra razón por la que recomiendo empezar con un PC industrial: está construido para exactamente este entorno.
¿Para quién son realmente los servidores GPU? Operaciones que ejecutan decenas de estaciones a la vez, o equipos que entrenan sus propios modelos. Si su almacén aún no está ahí, comprar uno significa pagar la factura eléctrica de una sala de máquinas — y financiar la comisión de ventas del proveedor.
Mi veredicto es directo: separen sus casos de uso en vigilantes del camino y lectores de la suerte primero — edge para los primeros, nube para los segundos. Empiecen el hardware con un solo PC industrial, demuestren una estación, y luego expandan. La próxima vez que un proveedor de IA les presente su propuesta, hagan tres preguntas: ¿dónde se ejecuta la inferencia?, ¿la línea se detiene cuando la red muere?, ¿y con qué frecuencia se actualizan los modelos? Si no pueden responder esas tres, pueden cerrar la presentación.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.