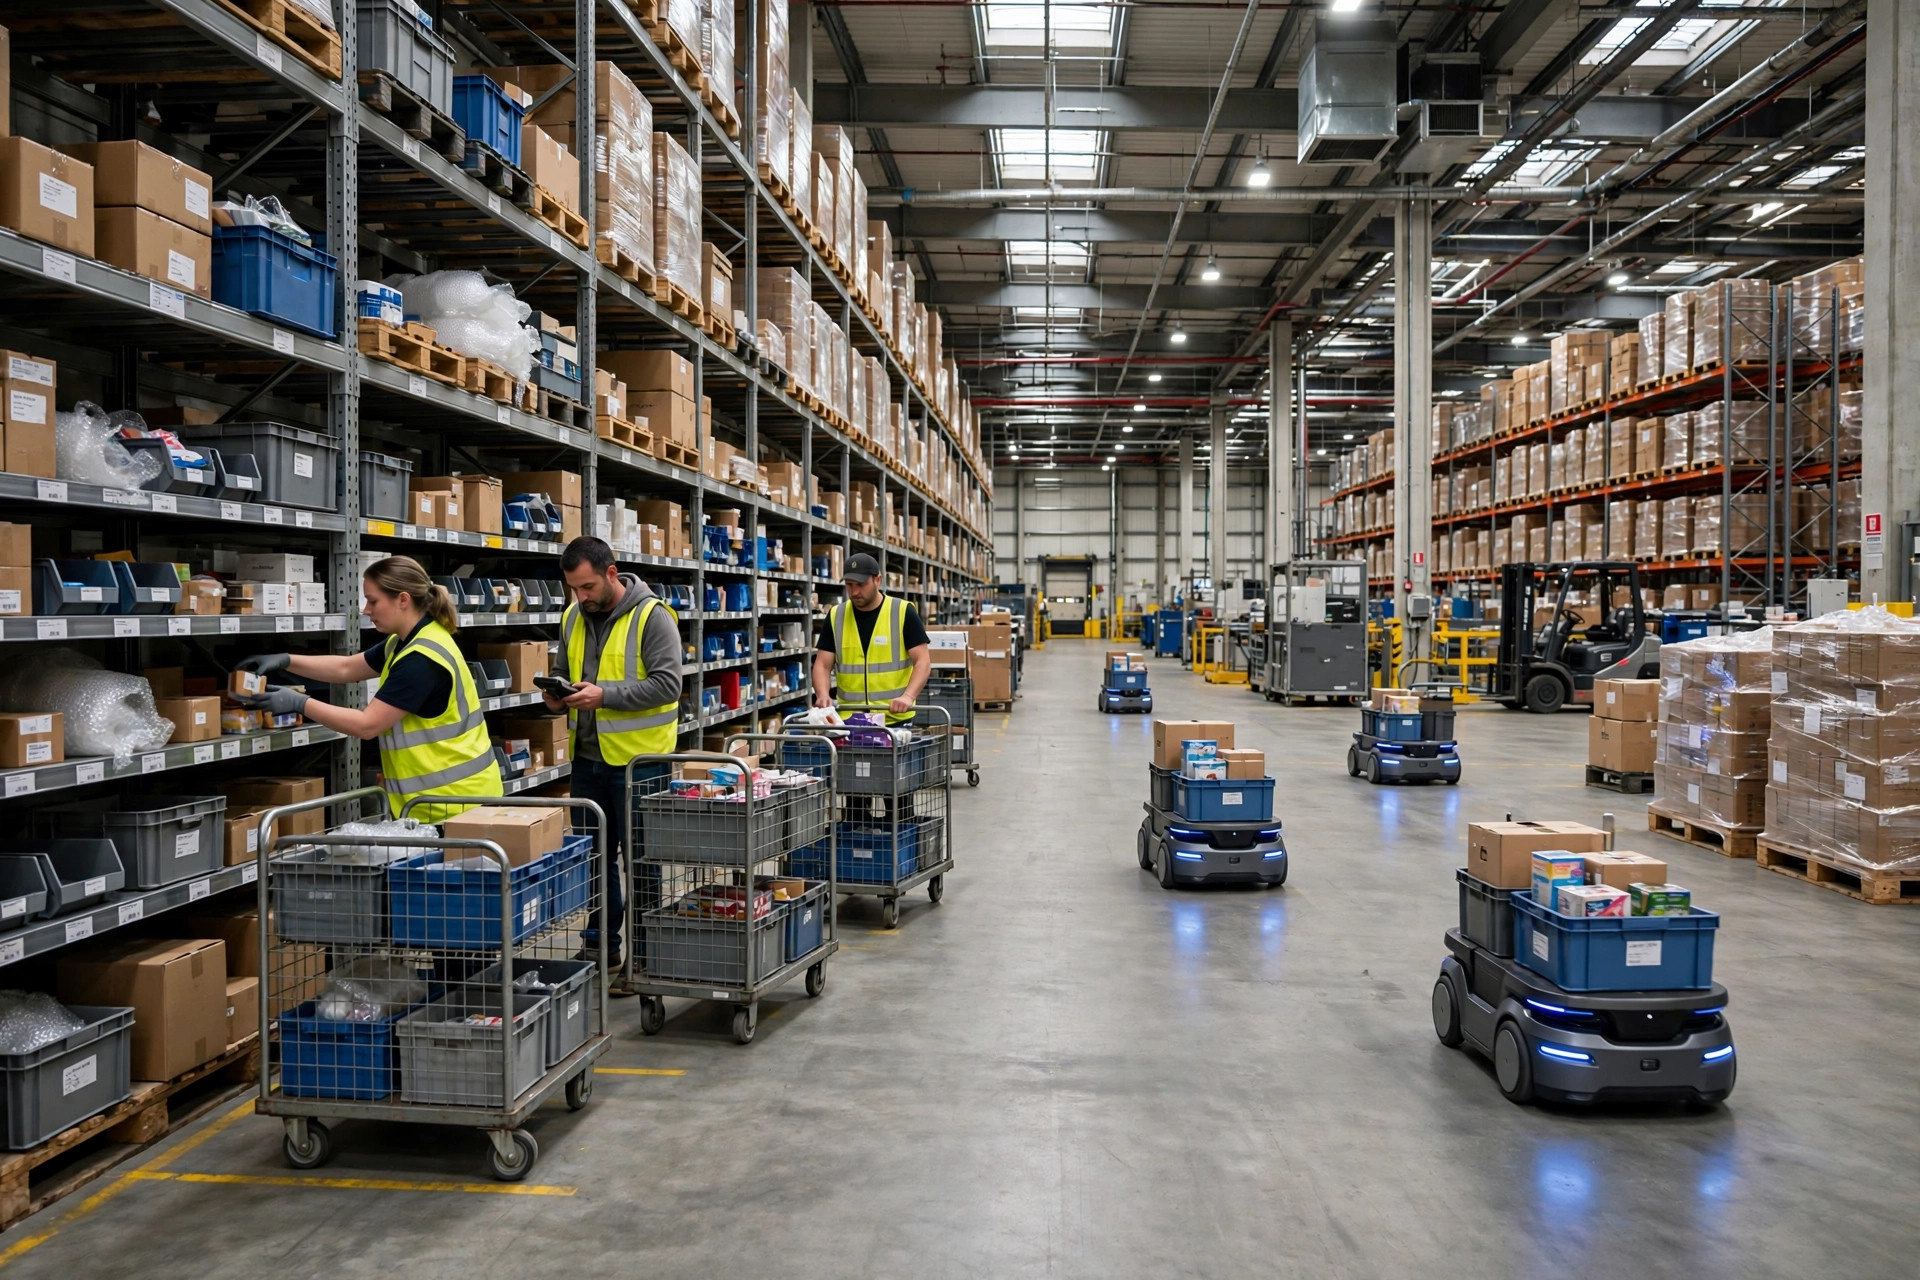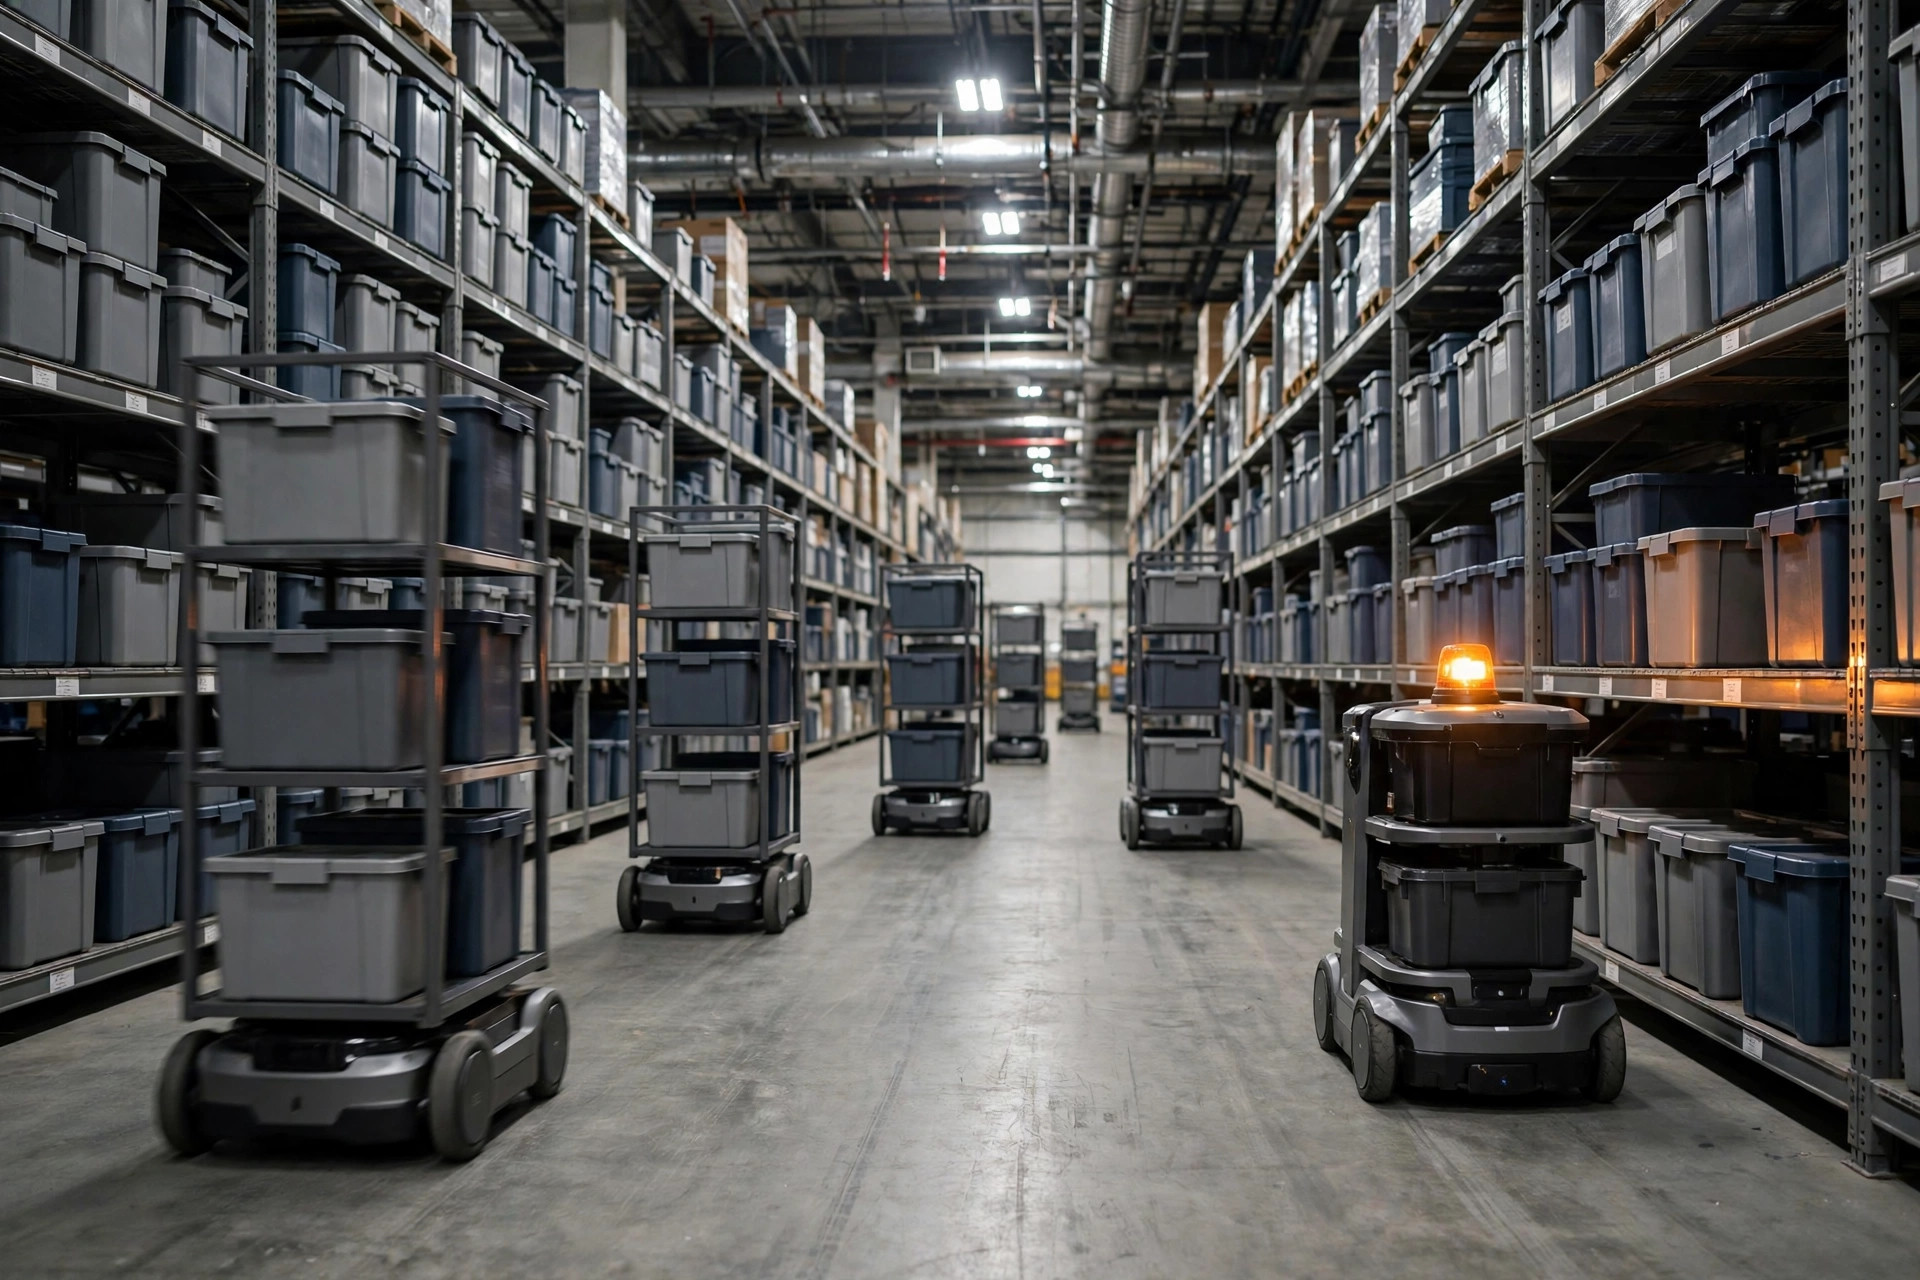
En agosto pasado estaba de visita de seguimiento en un almacén de comercio electrónico 3C en el este de China — cuarenta AMR de transporte de estanterías trabajando sin parar. A las 10 a.m. murió el aire acondicionado de la sala de servidores y el servidor de gestión de flotas se sobrecalentó hasta reiniciarse — una falla de punto único de manual. Quince minutos sin emitir ni una orden: cada robot activó su parada protectora y se quedó congelado. La ola de la mañana se retrasó casi dos horas.
La autopsia fue aleccionadora: el servidor estaba bien, un reinicio lo solucionó. Pero esos quince minutos expusieron la verdad — en este sistema "inteligente", el punto único de falla se escondía en el lugar más aburrido. Este artículo divide las fallas de punto único de los AMR en tres capas — dónde se esconde cada una, cómo reforzarla, dónde trazar la línea — además de cómo romper el sistema a propósito en la aceptación. Aviso: las cifras sin fuente son mis estimaciones posteriores al proyecto; el orden de magnitud es correcto, no las copie en una licitación.
Dónde se esconden realmente las fallas de punto único en los AMR
Piénselo como el tráfico de una ciudad. La flota de AMR es el flujo de autos, el sistema de gestión de flotas (FMS) es el centro de control de semáforos, y la red Wi-Fi es la radio en la mano de cada conductor. Lo que paraliza una ciudad nunca es un auto averiado — es que falle una de estas tres cosas:
Capa uno: el vehículo individual. Un robot se cae — batería sobredescargada, lidar sucio, escombros en una rueda motriz. Lo más común, lo menos peligroso: un robot caído es el 2.5% del rendimiento en una flota de 40 robots.
Capa dos: el despachador. El servidor FMS se cae, el software de programación tiene un error, la base de datos se bloquea. Un servidor tropieza y toda la flota se queda sorda — ese corte de quince minutos fue esta capa. La verdadera falla de punto único: una máquina comandando todo.
Capa tres: la red. Muere un punto de acceso, falla el roaming, aparece una zona muerta. Los robots pierden contacto con el despacho y ejecutan su política de "enlace perdido" — detenerse donde están, con frecuencia en medio de un pasillo principal.
De las tres capas, el 90% de los proyectos vuelca el dinero en la capa uno — robots más sofisticados, más sensores — mientras las capas dos y tres reciben las sobras. Por eso cada incidente se convierte en un apagón total del piso: el dinero fue a la capa equivocada.
Las tres capas de redundancia: dónde debería ir el dinero
Primero los principios, después las líneas divisorias. Más respaldo no es automáticamente mejor — se trata de gastar en la capa correcta.
Respaldo de vehículos significa robots de repuesto, no repuestos. El enfoque correcto es N+1: en una flota de 40 robots, compre una o dos unidades extra como repuestos en caliente. Un robot muerto se arrastra fuera, un repuesto toma su lugar, el rendimiento no baja. La línea divisoria: dos turnos las 24 horas → N+1 es obligatorio. Un solo turno diurno → comparta una flota de repuestos entre sitios, o omítala; un robot que muere al mediodía se repara por la noche.
Ahora tengo que denunciar un pseudo-requerimiento. Algunos proveedores venden "lidar dual, batería dual" y suben el precio del robot un 30%. Eso es una donación al proveedor, no ingeniería. Los AMR industriales convencionales traen cifras de MTBF declaradas por el proveedor superiores a 5,000 horas. Gastar un 30% extra para reducir las fallas de una unidad de unas pocas veces al año a una o dos es inútil cuando un tropiezo del despachador de todos modos mata a toda la flota. Guarde ese dinero para la capa dos.
El respaldo del despachador — servidores activo-pasivo — es el dinero que lo mantiene vivo. Dos servidores FMS — uno activo, uno en espera — con monitoreo por latidos y conmutación automática por error. Piense en un avión bimotor — pierde un motor y sigue volando. La línea divisoria es el tiempo de conmutación: debe ser menor que el umbral de "parada protectora por enlace perdido" de los robots, comúnmente de 5 a 10 segundos según el proveedor (experiencia de campo — exija este número y escríbalo en el acuerdo técnico). Conmutar dentro de 30 segundos cuenta como aprobado. Más de un minuto es lo mismo que no tener respaldo — los robots ya se habrán detenido solos, y su servidor de reserva hereda un piso de cadáveres que necesitan recuperación manual, uno por uno.
El respaldo de red significa cobertura de AP superpuesta. Cada zona debe estar dentro del alcance de al menos dos puntos de acceso, de modo que cuando un AP muera su vecino absorba la carga. La línea divisoria: con un solo AP caído, los vecinos deben cubrir al menos el 90% de esa zona, con traspaso de roaming menor a un segundo. Un "diseño de doble AP" que no alcance estos números es decoración.
Tres niveles costeados para una flota típica de 40 robots (los porcentajes son mis rangos de experiencia):
| Nivel | Costo extra (% del proyecto) | Complejidad | Tiempo típico de recuperación | Para quién es |
|---|---|---|---|---|
| Básico: un solo FMS + un solo AP + sin robot de repuesto | +0% | Baja | Recuperación manual, 30 min – 2 hrs | Almacén pequeño de un turno que puede permitirse detenerse |
| Estándar: FMS activo-pasivo + cobertura de AP superpuesta + 1 robot de repuesto | +8%–12% | Media | Conmutación en 30 seg, falla de un robot cubierta en 10 min | La mayoría de los almacenes 24 horas |
| Alta disponibilidad: FMS activo-activo + red de doble banda + 10% de flota de repuesto | +20%–30% | Alta | Conmutación en segundos, el rendimiento apenas baja | Farmacia, automoción — donde una línea detenida significa penalizaciones |
¿Ve la forma? De básico a estándar cuesta aproximadamente un 10% más y arrastra la recuperación de horas a minutos — el mejor valor por dólar aquí. El nivel de alta disponibilidad es para operaciones donde un minuto detenido cuesta dinero real. Los almacenes de comercio electrónico ordinarios deberían mantenerse alejados; la complejidad se vuelve en contra.
Aislamiento de fallas: saque primero al robot muerto de la red de tráfico
El respaldo mantiene vivo el sistema. El aislamiento de fallas evita que la parte muerta arrastre a la parte viva. Como una avería en la autopista: el primer paso es arrastrar el auto al arcén, no arreglarlo en el carril de circulación.
Una cadena de aislamiento de fallas adecuada: el autodiagnóstico del robot detecta una anomalía (batería, pérdida de localización, falla de tracción) → informa al FMS en 3 segundos → el FMS marca ese segmento de vía como zona de exclusión temporal → las tareas sin terminar del robot muerto se reasignan a robots sanos → un humano o un robot de repuesto lo remolca. Todo automático; el humano solo hace el remolque final.
He visto el contraejemplo. En marzo de 2024, en un almacén de autopartes en el norte de China, se quemó el módulo de alimentación de un AP. Seis robots en su zona perdieron el enlace por más de 5 segundos y se detuvieron por protección — dos de ellos en una arteria principal. La lógica de aislamiento del FMS tenía un error: los datos de posición con más de 10 segundos de antigüedad de un robot con enlace perdido se contaban como obsoletos, así que no salió ningún desvío. Cuatro robots sanos quedaron en cola detrás de los "cadáveres". Cuarenta minutos de despeje manual, la mitad del despacho del almacén congelado.
Dos lecciones. Primera, diseñe el aislamiento para la peor posición — asuma que el robot muerto siempre se detiene en el pasillo más crítico. Segunda, nunca desvíe según su última posición reportada; trace la zona de exclusión desde "última posición conocida más un radio de seguridad". Desvíese de más en lugar de meterse dentro.
Luego la degradación elegante — la segunda mitad del aislamiento de fallas. Caso extremo: el 30% de la flota caída a la vez (un lote malo de baterías ocurre). El sistema no debería acostarse; debería degradarse automáticamente: baje un grado de velocidad, repriorice las tareas (proteja la ola de salida, difiera la entrada), amplíe la zona de picking manual. Preconfigure esto en el FMS con umbrales duros — "entre en modo degradado automáticamente cuando los robots sanos bajen del 70%". No cuente con que el operador del turno de noche improvise a las 3 a.m.
Antes de la aceptación: simulacros de falla de punto único que no puede omitir
La trampa del mantenimiento: documentos de diseño hermosos, pero nadie se atreve a romper el sistema en la aceptación. Ejecute cada simulacro a mano; no firme si alguno falla:
- Desconecte el servidor de despacho. Cronometre la toma del servidor de reserva; verifique que no haya paradas protectoras masivas. Más de un minuto — rechazado.
- Mate el proceso de despacho sin cortar la energía. Simula un fallo de software — verifique que la detección por latidos atrape el "falso vivo" de cerebro dividido (proceso en ejecución, servicio muerto).
- Apague un AP. Verifique un roaming suave, sin paradas por enlace perdido.
- Pare de emergencia un robot aleatorio. Cronometre la zona de exclusión y la reasignación de tareas. Más de 3 minutos — el aislamiento falla.
- Corte la energía de toda la fila de carga. Verifique que la política de despacho de batería baja se sostenga — el punto más pasado por alto aquí. He visto dos veces robots con batería baja hacer cola para cargar, no encontrar energía y morir colectivamente.
- Simule el 30% de la flota fuera de línea. Verifique que el modo degradado se active automáticamente y que la ola de salida sobreviva.
Registre cada simulacro: hora de activación, hora de recuperación, intervención humana o no. Si el proveedor dice "lo probamos en nuestro laboratorio", la respuesta es: sus robots, mi piso, ahora mismo. Una disponibilidad del 99.99% probada en laboratorio pierde al menos un 20% en el momento en que se encuentra con racks y montacargas reales.
Balance final. Si este dinero vale la pena gastarlo se reduce a un número: el costo de una hora detenida en su temporada pico. Volumen pico de salida por hora × margen promedio por pedido, más penalizaciones por retraso y mano de obra ociosa — fácilmente más de $3,000 para un almacén de comercio electrónico mediano. El nivel estándar cuesta alrededor de un 10% extra; en tres años de depreciación eso son decenas de dólares por hora. Decenas de dólares por hora para cubrir miles de dólares por hora de pérdida — haga la cuenta usted mismo. Pero si su almacén opera un turno con volumen modesto y una parada de dos horas solo retrasa una tarde — el nivel básico es suficiente; ese presupuesto compra mejor repuestos. El gasto en respaldo no es un sistema de creencias. Es aritmética.
Por Da Liu, Ingeniero de Automatización
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.